AI에게 보고서를 쓰라고 한 번에 요청하는 것과, 조사·분석·작성을 나눠 맡기는 것은 무엇이 다를까. 여러 에이전트를 붙였다고 자동으로 더 좋은 결과가 나오지는 않는다. 누가 어떤 도구를 쓰고, 무엇을 만들어 다음 작업에 넘길지 정해야 분업이 의미를 갖는다.
CampusX의 CrewAI 마스터클래스는 에이전트의 기초부터 멀티에이전트 프로젝트까지 다루는 긴 입문 강의다. 이 글은 강의와 공개 예제를 바탕으로 Agent·Task·Crew를 구분하는 방법, 보고서와 블로그를 만드는 기본 구조, 시장조사 프로젝트의 확장 방식을 정리한다. 설치 절차는 현재 공식 문서와 대조해 영상 당시의 파일 구조와 구분했다.
CrewAI는 무엇을 대신 정리해 주는가
CrewAI는 여러 AI 에이전트가 역할을 나눠 작업하도록 구성하는 Python 기반 프레임워크다. 모델 자체라기보다, 모델과 도구를 사용해 과업을 수행하는 에이전트들을 연결하는 실행 체계에 가깝다.
하나의 큰 프롬프트에 조사·판단·작성 지시를 모두 넣을 수도 있다. 하지만 작업이 복잡해지면 어느 단계에서 근거가 빠졌는지, 어떤 역할의 출력을 수정해야 하는지 보기 어려워진다. CrewAI에서는 역할과 과업을 분리하고 실행 순서나 전달할 문맥을 명시할 수 있다.
그렇다고 모든 업무를 여러 에이전트로 나눌 필요는 없다. 단순한 요약이나 짧은 문장 수정이라면 하나의 모델 호출이 더 간단할 수 있다. 역할마다 필요한 도구·정보·판단 기준이 실제로 달라질 때 분업을 검토하는 편이 낫다.
입문자가 먼저 구분할 세 가지: Agent·Task·Crew
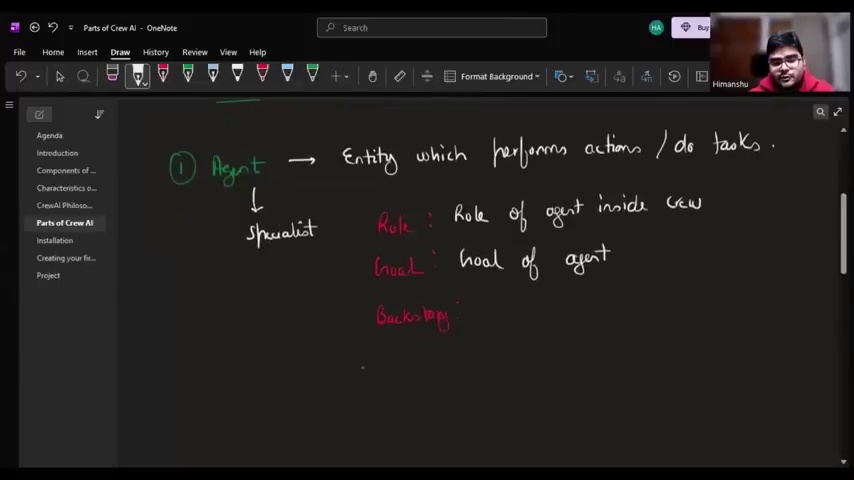
Agent는 ‘누가 하는가’다
Agent에는 역할(role), 목표(goal), 배경 설명(backstory) 등을 정의한다. 필요에 따라 모델과 사용할 도구도 지정한다. 조사 담당자라면 검색·자료 수집이, 작성 담당자라면 독자에 맞는 설명과 구성에 초점을 둘 수 있다.
배경 설명에 전문가 경력을 적는 것은 역할을 유도하는 설정이다. 실제로 해당 경력을 가진 전문가가 검토했다는 의미가 아니며, 결과의 사실성을 보증하지도 않는다.
Task는 ‘무엇을 완료해야 하는가’다
Task에는 작업 설명(description)과 기대 산출물(expected_output)을 적는다. 담당 에이전트, 참고할 이전 작업 결과, 출력 파일 등을 연결할 수도 있다.
‘잘 조사하라’는 요청보다 조사 범위·기준 시점·필요 항목·출처·불확실성을 구체적으로 정하는 편이 후속 검토에 유리하다. 기대 산출물을 적는 것은 완료 조건을 명확히 하는 일이지, 모델이 반드시 그 조건을 충족한다는 보장은 아니다.
Crew는 ‘어떤 체계로 함께 실행하는가’다
Crew는 에이전트와 Task를 묶고 실행 방식을 정한다. 순서가 명확한 작업은 순차 실행(sequential)으로 시작할 수 있다. 관리자 역할이 조정하는 계층형(hierarchical) 구성도 있지만, 별도 판단과 위임 과정이 들어간다.
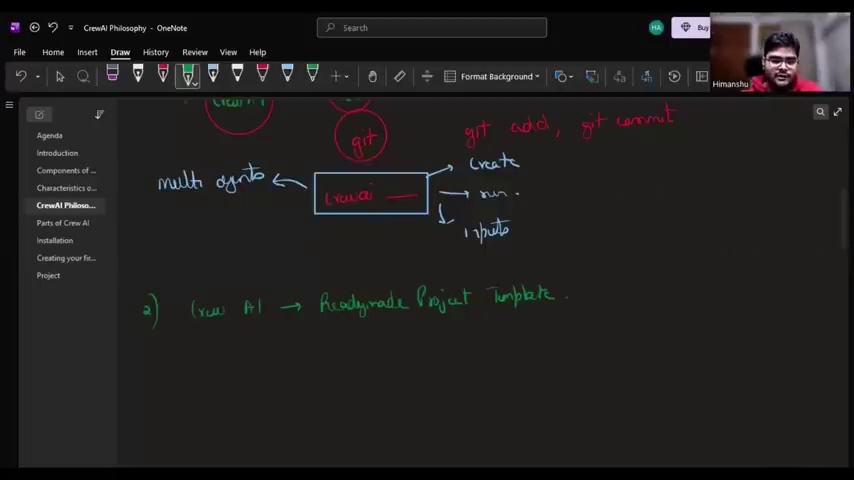
입문 단계에서는 직함을 많이 만드는 것보다, 입력 → 담당 역할 → 산출물 → 다음 작업의 연결을 종이에 먼저 그려보는 것이 도움이 된다.
첫 예제: 보고서 작성과 블로그 작성을 분리한다
공개 저장소의 research_and_blog_crew는 두 역할로 구성된다. 보고서 작성 에이전트가 주제에 관한 자료를 정리하고, 블로그 작성 에이전트가 이를 읽기 쉬운 글로 바꾼다.
YAML 설정에는 보고서 약 2,000단어, 블로그 약 500단어라는 목표가 들어 있다. 이는 요청한 분량이지, 길이와 내용의 정확성을 자동 검증했다는 뜻은 아니다. Python 코드에서는 Process.sequential로 작업을 실행하고, 블로그 결과를 blogs/blog.md에 저장하도록 구성한다.
여기서 놓치기 쉬운 점이 있다. 이 기본 예제의 에이전트에는 웹 검색 도구가 연결돼 있지 않다. 프롬프트에 ‘최신 사실’을 포함하라고 적었다고 해서 실제로 웹에서 최신 자료를 수집한 것은 아니다. 검색이 필요한 업무라면 도구와 접근 권한을 별도로 구성해야 한다.
또한 파일에 글이 저장됐다는 것과 공개 게시가 완료됐다는 것은 다르다. 이 예제의 출력 파일 설정 자체가 WordPress 발행까지 수행하는 것은 아니다. 외부 공개가 필요하다면 검토·승인·게시 단계를 따로 설계해야 한다.
이 예제를 업무에 적용한다면 다음처럼 산출물 계약을 보강할 수 있다. 아래 항목은 강의 코드를 그대로 재현한 설정이 아니라 실무 적용을 위한 제안이다.
- 보고서에는 확인한 사실, 원문 출처, 기준 시점, 아직 확인하지 못한 항목을 구분한다.
- 블로그 작성자는 보고서에 없는 수치나 사례를 임의로 덧붙이지 않는다.
- 최종 검토에서는 인용과 링크, 주장·근거의 일치 여부를 확인한다.
- 외부 게시 권한은 초안 생성과 분리하고 승인 뒤에만 사용한다.
확장 예제: 시장조사를 다섯 역할로 나눈다
공개 저장소의 market_research_crew는 더 복잡한 분업을 보여준다.
- 시장조사 담당: 시장 규모와 성장 흐름, 산업 환경을 조사한다.
- 경쟁정보 분석 담당: 경쟁사와 대안, 차별화 가능성을 살펴본다.
- 고객 인사이트 담당: 고객군의 문제와 필요, 구매 관련 가설을 정리한다.
- 제품전략 담당: 앞선 결과를 바탕으로 기능 우선순위와 개발 방향을 제안한다.
- 사업분석 담당: 조사 결과를 통합해 사업 보고서로 정리한다.
영상의 최종 실습에서는 ‘유튜브 영상을 요약해 여러 소셜 플랫폼에 게시하는 도구’라는 제품 아이디어를 입력하고, 관련 사업 보고서를 생성해 살펴본다. 여기서 만들어진 것은 그 제품의 시장·사업성 분석 보고서이지, 실제로 영상을 요약하거나 SNS에 게시하는 서비스 자체는 아니다.
코드에서는 뒤의 Task가 앞선 결과를 context로 참조하도록 연결한다. 예를 들어 제품전략 Task는 시장·경쟁·고객 조사 결과를 받는다. 마지막 사업분석 Task는 여러 결과를 모아 reports/report.md에 저장한다.
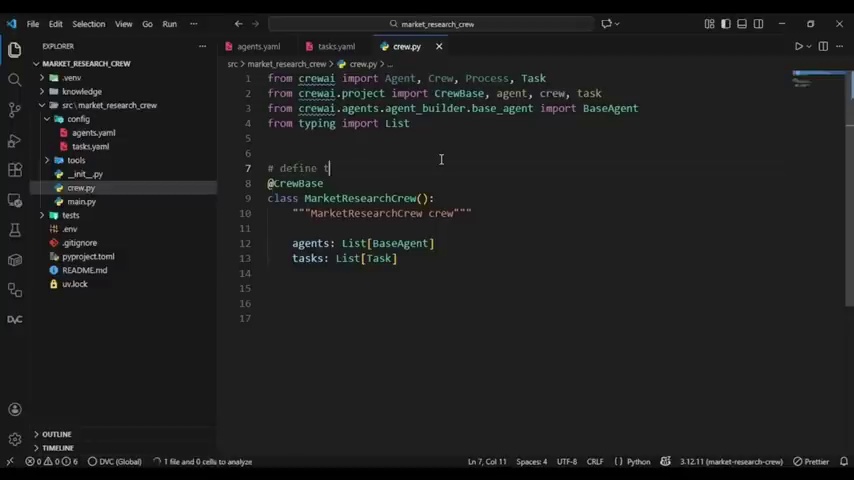
이 예제에는 검색과 웹페이지 수집 도구가 연결돼 있다. 기본 보고서·블로그 예제와 달리, 에이전트가 외부 정보를 찾을 수 있는 구성이라는 차이가 있다. 다만 검색 결과를 확보했다고 해서 시장 수치나 사업 전망의 타당성이 자동으로 보장되지는 않는다.
특히 AI가 작성한 고객 페르소나는 실제 고객 인터뷰가 아니다. 조사에서 확인한 관찰과 모델이 만든 가설을 분리해야 한다. 같은 모델의 결과를 다음 에이전트가 다시 요약하는 것만으로 독립적인 검증을 했다고 볼 수도 없다.
설치 전에 확인할 차이: 현재 기본 구조와 강의의 YAML 구조
강의 예제는 crew.py, config/agents.yaml, config/tasks.yaml로 역할과 과업을 구성한다. 그러나 이 글 작성 시 확인한 공식 설치 문서는 기본 프로젝트가 JSON 중심으로 생성된다고 안내한다. 에이전트는 agents/*.jsonc, 작업과 Crew 설정은 crew.jsonc에 들어간다.
따라서 현재 설치한 CLI에서 영상과 파일 구성이 다르게 보이는 것이 반드시 설치 실패를 뜻하지는 않는다. 영상의 Python/YAML 구조로 학습하려면 공식 문서가 안내하는 --classic 옵션을 확인한다.
uv를 사용할 수 있는 환경에서의 생성 절차는 다음과 같다. 설치 명령은 공식 문서를 따른 학습용 예시이며, 사용할 CrewAI 버전과 모델 공급자 설정에 따라 환경을 확인해야 한다.
uv tool install crewai
crewai create crew research_and_blog --classic
cd research_and_blog
생성된 프로젝트의 설명을 읽고 사용할 모델과 도구를 설정한다. API 키 등 비밀값은 환경변수나 .env로 관리하고 저장소에 올리지 않는다. 설정을 마친 뒤 프로젝트 루트에서 의존성을 설치하고 실행한다.
crewai install
crewai run
무료 강의라는 표현과 실행 비용도 구분해야 한다. 강의를 무료로 볼 수 있어도, 선택한 모델·검색 API·외부 서비스에는 비용이나 이용 한도가 있을 수 있다. 학습 전에는 키 발급, 과금 방식, 요청 제한을 확인하는 것이 좋다.
순차 실행·계층형·Flow는 같은 선택지가 아니다
순차 실행은 이미 정한 Task의 순서를 따르는 방식이다. 조사 뒤 작성처럼 선후 관계가 명확할 때 구조를 이해하고 추적하기 쉽다.
계층형은 관리자 역할이 작업을 조정하는 방식이다. 상황에 따른 위임이 필요할 때 검토할 수 있지만, 관리자의 판단에도 모델 호출과 오류 가능성이 생긴다. 에이전트를 많이 두거나 관리자를 추가하는 것 자체가 성능 향상을 증명하지는 않는다.
Flow는 여러 처리 단계와 상태, 조건 분기를 코드로 연결하는 데 쓰는 별도 개념이다. 예를 들어 입력을 검사한 뒤 조사 Crew를 실행하고, 자료가 부족하면 보완 경로로 보내는 구조를 만들 수 있다. 이 예시는 공식 문서의 개념을 업무에 적용한 설명이며, 강의의 시장조사 프로젝트가 그런 분기까지 구현했다는 뜻은 아니다.
처음에는 작은 순차 Crew → 산출물 검증 → 필요한 분기 추가 순서가 이해하기 쉽다. 동적으로 판단할 필요가 없는 부분까지 에이전트에게 맡기기보다, 명확한 규칙은 일반 코드로 처리할 수 있다.
에이전트 수보다 먼저 정할 운영 기준
멀티에이전트 시스템을 업무에 쓰려면 역할 이름 외에 운영 조건도 필요하다. 다음은 입문 예제를 실제 업무로 옮길 때 점검할 항목이다.
- 도구와 권한: 읽기·검색·파일 저장·외부 전송 중 어디까지 허용할지 구분한다.
- 전달 정보: 다음 Task가 받아야 할 근거·출처·미확인 항목을 정한다.
- 검증: 필요한 필드와 형식, 인용 근거를 각각 확인한다. 형식 검사를 통과해도 사실이 맞는 것은 아니다.
- 재시도와 비용: 무제한 반복 대신 실패 시 중단·재시도 기준과 비용 한도를 둔다.
- 공개 승인: 자동 생성·저장과 고객 발송·공개 게시를 분리한다.
역할 설정에 전문가라는 이름을 붙이는 것보다 중요한 것은 이 경계다. 어떤 Task가 잘못됐는지 추적하고, 확인하지 못한 결과를 그대로 다음 단계로 넘기지 않게 해야 한다.
입문자의 첫 목표는 작은 Crew를 설명할 수 있는 것이다
CrewAI를 처음 배울 때는 큰 조직도를 만드는 것보다 두 역할의 작은 작업부터 시작하는 편이 좋다. 같은 입력을 주었을 때 어떤 자료를 받고, 어느 단계에서 틀릴 수 있으며, 무엇을 최종 산출물로 남기는지 확인한다.
CampusX 강의의 가치는 에이전트의 기초와 역할 분담을 실제 프로젝트 구조로 연결해 볼 수 있다는 데 있다. 다만 예제가 실행됐다는 사실과 업무에 바로 투입할 품질을 확보했다는 것은 구분해야 한다. 이 글은 강의·공개 코드·공식 문서를 대조한 해설이며, 예제 Crew를 별도로 실행해 같은 산출물을 재현했다는 뜻은 아니다.
CrewAI 입문의 핵심은 도구 이름을 외우는 일이 아니다. 누가, 무엇을, 어떤 근거로 수행하고, 누가 결과를 확인하는지를 분명히 하는 것이다.
함께 읽으면 좋은 글
FAQ
CrewAI를 쓰려면 Python을 알아야 하나요?
이 강의는 Python 코드와 YAML 설정을 함께 다룬다. 에이전트의 개념만 이해하는 것과 예제를 수정·실행하는 것은 다르므로, 코드 구조와 패키지·환경변수의 기초를 익혀두는 것이 도움이 된다.
강의와 생성된 프로젝트의 파일 구조가 다른 이유는 무엇인가요?
현재 공식 설치 문서는 JSON 중심 프로젝트를 기본으로 안내한다. 영상의 Python/YAML 구조를 따라가려면 crewai create crew 프로젝트명 --classic 옵션을 확인한다. 설치한 버전에 따라 해당 버전의 문서도 함께 살펴봐야 한다.
CrewAI가 최신 정보를 자동으로 검색하나요?
항상 그렇지는 않다. 공개된 기본 보고서·블로그 예제에는 검색 도구가 연결돼 있지 않다. 최신 외부 자료가 필요하다면 검색·수집 도구와 인증, 결과 검증을 따로 구성해야 한다.
에이전트를 많이 만들면 더 정확해지나요?
에이전트 수만으로 정확성을 보장할 수 없다. 역할 간 차이가 불분명하면 전달 비용과 복잡성만 늘 수 있다. 분업이 필요한 이유, 필요한 도구, 검증할 산출물이 먼저 명확해야 한다.
참고자료
- CampusX, CrewAI 입문 마스터클래스 원본 영상
- CampusX 공식 강의 자료와 예제 저장소
- CrewAI 공식 설치 문서
- CrewAI 공식 Crew 개념 문서
- CrewAI 공식 Task 개념 문서
- CrewAI 공식 Flow 개념 문서
본문 이미지는 개념과 프로젝트 구조를 설명하기 위해 인용한 원본 강의 캡처다. 영상의 설명, 공개 코드에서 확인한 구성, 공식 문서의 현재 안내와 실무 적용 제안을 구분했다.