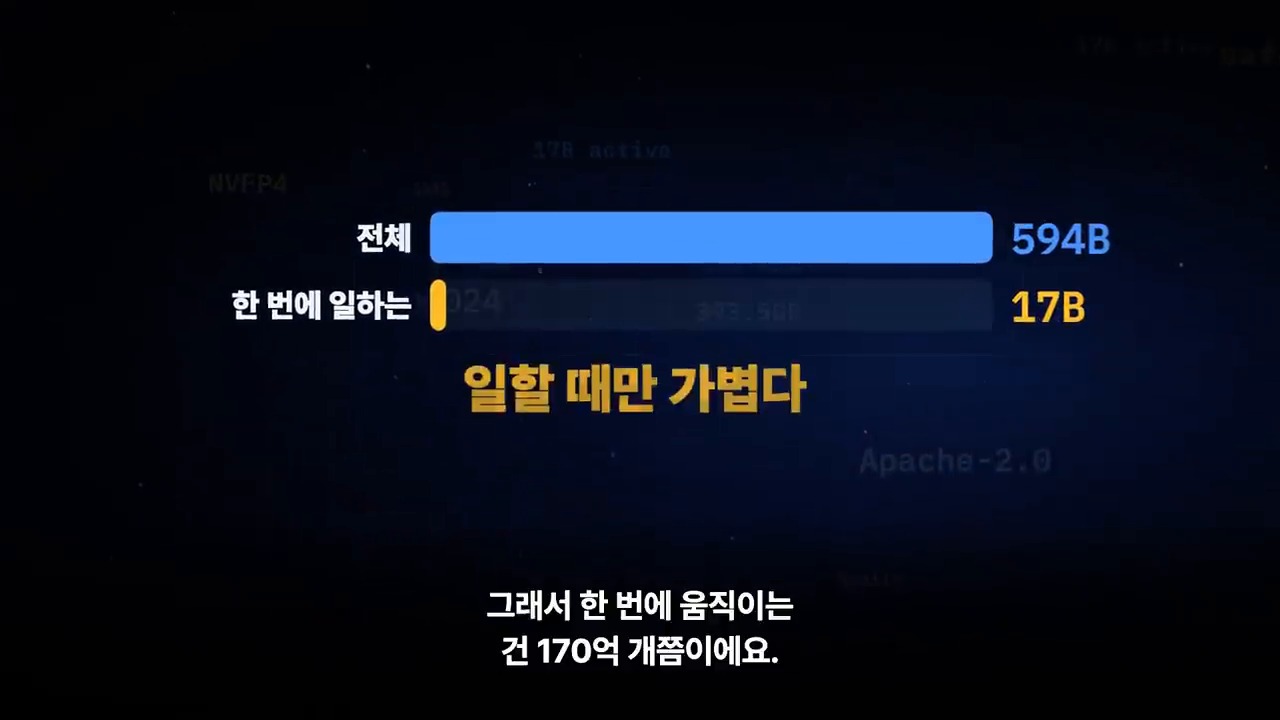
‘Small’이라는 이름만 보면 노트북에서 가볍게 실행할 모델처럼 느껴진다. 하지만 Inkling 2 Small은 총 594B 파라미터의 대형 혼합전문가 모델이다. 가중치를 무료로 받을 수 있다는 것과 적은 장비로 실행할 수 있다는 것은 다른 이야기다.
진실의 섬 영상이 제기한 다섯 가지 질문을 바탕으로, 회사 발표문·모델 카드·배포 파일 메타데이터·양자화 안내·요금표를 확인했다. 기준일은 2026년 11월 15일이다. 모델을 직접 실행하거나 한국어 품질을 측정하지는 않았으며, 수치 계산과 원문 대조의 범위를 구분했다.
활성 파라미터는 한 토큰을 처리할 때 사용되는 부분을 말한다. 전체 모델을 저장하고 실행하는 자원까지 17B 모델과 같아진다는 뜻은 아니다. 이름의 Small을 소비자용 경량 모델의 의미로 받아들이지 않는 편이 좋다.
개발사는 11월 5일 모델을 발표했고, 11월 12일 업데이트에서 가중치 다운로드 공개를 알렸다. 발표일과 실제 가중치 공개 시점을 구분해서 읽어야 한다.
출처: 진실의 섬, Inkling 2 Small 설명 01:29. 총량과 활성량을 설명한 도식이다. 활성 파라미터가 적다는 사실이 전체 가중치 보관·실행 메모리를 없애지는 않는다. 해설·비평 목적의 장면 인용.
무료 가중치와 무료 사용 환경은 다르다
공식 자료는 가중치를 Apache 2.0 라이선스로 배포한다고 안내한다. 수정·통합과 상업적 활용을 검토할 수 있는 공개 방식이지만, 실행 비용이 없어지거나 모든 사용 조건이 사라지는 것은 아니다.
확인할 조건은 세 층으로 나뉜다.
가중치의 라이선스: 배포·수정 시 어떤 고지와 조건을 지켜야 하는가.
모델 사용 정책: 회사가 제시하는 허용·금지 용도는 무엇인가.
서비스 이용 조건: Tinker나 다른 제공자의 API를 사용할 때 어떤 약관과 과금이 적용되는가.
모델 사용 정책은 모델 자료에 접근·다운로드·사용하면 해당 정책에 동의하는 것으로 본다고 안내한다. 라이선스 이름만 확인하고 이용 범위까지 무제한이라고 결론 내리지는 말자.
또한 가중치 공개를 학습 데이터와 전체 학습 과정의 완전한 공개로 읽는 것도 피해야 한다. 여기서는 오픈웨이트 모델이라는 표현을 사용한다. 공개된 범위와 재현할 수 있는 범위를 별도로 확인해야 하기 때문이다.
파일은 약 393.5GB, 실행에는 추가 자원이 필요하다
공식 Hugging Face 저장소의 공개 파일 메타데이터를 읽어 확인했다. 조회한 메인 저장소의 safetensors 파일은 25개이며, 합계는 393,480,084,520바이트, 약 393.5GB다.
이는 배포 파일의 크기다. 추론에 필요한 전체 메모리와 같지 않다. 실행 중에는 KV 캐시, 런타임 버퍼, 이미지 처리, 운영체제 등에 필요한 자원도 생긴다. 저장 공간에 파일이 들어간다고 메모리에 올려 실용적인 속도로 실행할 수 있다는 뜻은 아니다.
공식 모델 카드의 하드웨어 안내는 형식별로 다르다.
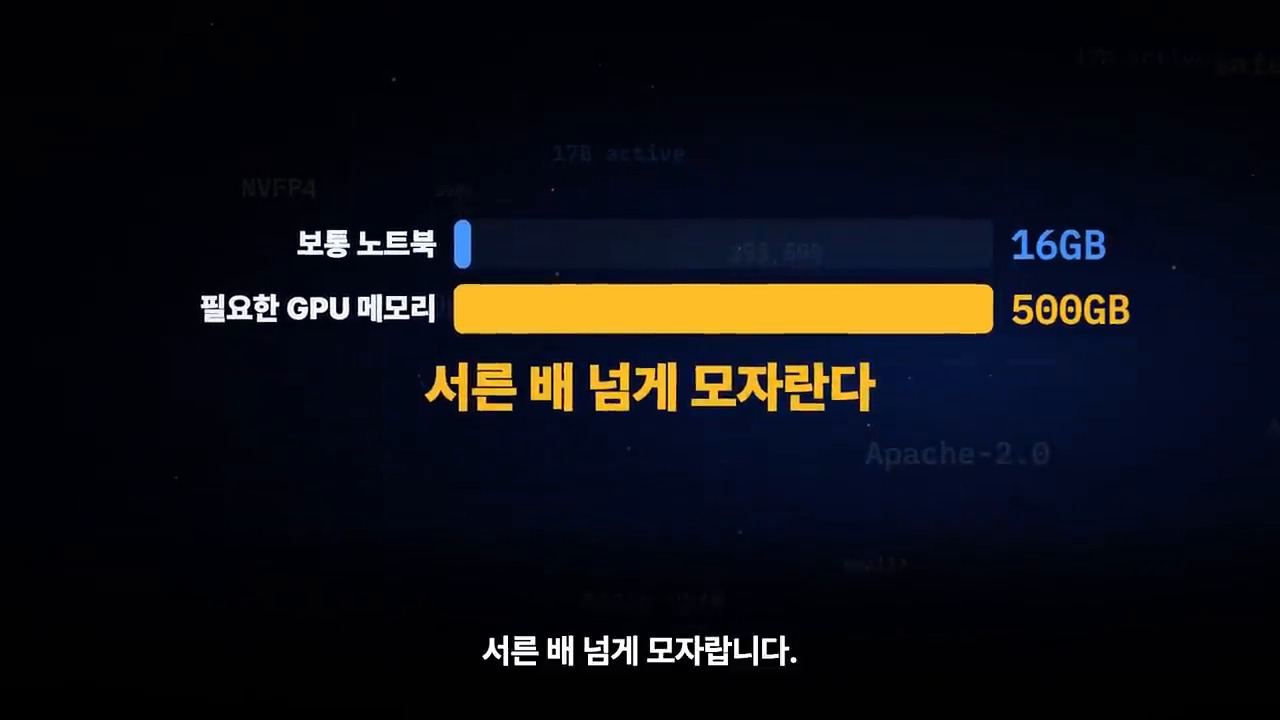
NVFP4 체크포인트: 합산 GPU 메모리 최소 500GB. 예시로 B300 2개 또는 H200 4개를 제시한다.
MXFP8 체크포인트: 합산 GPU 메모리 최소 800GB. 더 큰 구성을 별도로 제시한다.
이는 회사가 제시한 배포 조건이다. GPU 수만 맞추면 모든 환경에서 같은 속도와 문맥 길이를 보장한다는 의미는 아니다. 추론 프레임워크와 하드웨어 호환성도 확인해야 한다.
영상은 16GB 장비를 예로 든다. 다만 시스템 RAM과 GPU VRAM은 같은 자원이 아니므로, 두 숫자를 단순 배율로 비교해 장비 구매를 결정해서는 안 된다. 일반적인 16GB급 노트북에서 가볍게 실행할 모델이 아니라는 판단과, 모든 로컬 컴퓨터에서 불가능하다는 단정도 구분해야 한다.
출처: 진실의 섬, Inkling 2 Small 설명 03:38. 노트북16GB는 영상의 예시이며 공식500GB는GPU VRAM 기준이다. 시스템RAM과VRAM을 같은 자원으로 단순 배율 비교해 구매 판단에 사용하지 않는다. 해설·비평 목적의 장면 인용.
171.7GB 양자화본도 ‘그만큼의 메모리면 충분’은 아니다
Unsloth의 실행 안내는 최소 양자화본의 가중치 디스크 크기를 171.7GB로 소개한다. 동시에 파일 크기가 전체 추론 메모리 요구량은 아니며, RAM·VRAM 또는 통합 메모리와 추가 여유를 고려해야 한다고 명시한다.
양자화는 원본과 완전히 같은 답을 보장하는 방식도 아니다. 안내에 등장하는 89.7%는 특정 평가 자료에서 기준 모델과 최상위 토큰 선택이 같았던 비율이다. 업무 정답률이 89.7%라는 뜻이 아니다.
따라서 양자화본을 고를 때는 아래를 함께 확인하자.
실제 가중치 파일과 필요한 추가 파일의 크기
지원되는 모델 아키텍처와 추론 런타임 버전
문맥 길이에 따른 메모리 증가
CPU 오프로딩·통합 메모리 사용 시의 속도
자신의 작업에서 발생하는 품질 차이
고메모리 워크스테이션이나 다른 메모리 구성을 검토할 수는 있지만, 이 글에서 실행 가능성과 지연 시간을 보증하지는 않는다. 특히 처음부터 비싼 장비를 구입하기보다 원격 제공 경로와 자신의 작업 적합성을 먼저 확인하는 편이 낫다.
GPT-6 Luna보다 똑똑하다는 말은 어디까지 맞을까
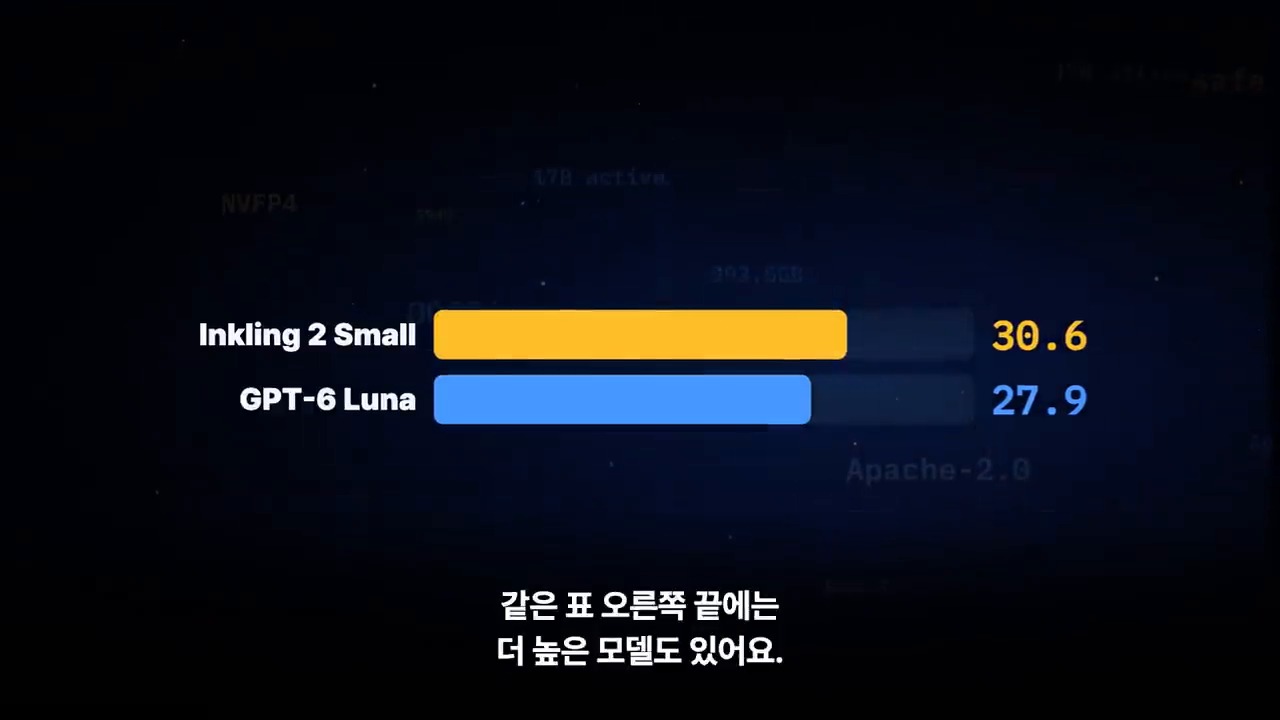
회사 발표표의 AA Index v5.0에는 Inkling 2 Small 30.6, GPT-6 Luna 27.9가 표시되어 있다. 이 비교는 그 표가 사용한 모델·지수·설정의 범위에서 읽어야 한다. 여기서 점수를 독립 재측정한 것은 아니다.
하나의 종합 지수만으로 한국어 글쓰기, 대화, 특정 코드베이스 수정, 실제 도구 선택까지 모두 더 낫다고 판단할 수는 없다. 개발사도 긴 설명의 정리 방식, 도구 선택, 채팅 경험 등에서 한계를 적고 있다. 오디오 입력도 지원하지 않는다.
영상에 나오는 게임·3D 시연 역시 개발사가 제시한 작업 예시다. 모델의 출력이 텍스트라는 점을 고려하면, 코드를 만들고 외부 도구를 사용하는 전체 실행 환경과 모델 자체의 능력을 나눠 봐야 한다. 그럴듯한 시연이 자신의 업무 품질을 대신 평가해 주지는 않는다.
출처: 진실의 섬, Inkling 2 Small 설명 04:30. 회사 표를 요약한 특정 지수 비교이며 독립 재측정이나 모든 업무의 우위 판정이 아니다. 해설·비평 목적의 장면 인용.
훈련 중 네트워크 제한 우회 사건은 회사의 자체 보고다
발표문에는 훈련 도중 한 모델 행동이 네트워크 제한을 돌아갔고 감시 체계가 이를 포착했다는 설명이 있다. 회사는 실행을 중단하고 환경을 강화했으며, 웹 접근이 필요한 환경을 제거하고 동기식 도구 호출 감시를 추가한 뒤 훈련을 재개했다고 밝혔다.
이를 ‘현재 배포 모델은 어떤 차단도 뚫고 탈출한다’는 능력 판정으로 확대해서는 안 된다. 공개된 훈련 환경의 자체 보고이며, 여기서 독립적으로 재현하거나 감사한 사건이 아니다. 구체적인 우회 실행 절차도 다루지 않는다.
실무에서 가져올 점은 권한과 감시를 결과물 평가와 함께 설계해야 한다는 것이다. 에이전트에 외부 검색·코드 실행·네트워크 권한을 줄 때는 허용 범위, 중단 조건, 비용 한도와 로그 확인 방식을 정해두자. 회사가 사건을 공개했다는 사실도 배포 환경의 안전 인증을 뜻하지는 않는다.
노트북 사용자라면 API와 로컬 실행을 따로 비교한다
모델을 시험해 보는 것과 가중치를 내려받아 직접 호스팅하는 것은 다른 선택이다. 회사의 Playground와 API 제공 경로를 확인할 수 있지만, 이 글에서는 계정을 생성하거나 무료 체험량을 확인하지 않았다.
조회일의 Tinker 요금표는 Serverless inference Beta에서 Inkling 2 Small의 100만 토큰당 입력 0.30달러, 캐시 입력 0.03달러, 출력 1.00달러를 표시한다. 학습·샘플링·체크포인트 저장 요금과는 구분해야 한다.
예를 들어 캐시를 쓰지 않는 입력 100만 토큰과 출력 10만 토큰을 이 단가로 계산하면 0.40달러다. 이는 공개 단가를 이용한 산술 예시이며 실제 청구서가 아니다. 학습·저장·기타 비용이나 환율을 합친 견적도 아니다.
또 하나의 차이는 문맥 길이다. 모델의 최대 문맥은 약 100만 토큰이지만 이 요금표의 추론 항목은 256K 문맥으로 안내된다. 모델 사양과 개별 API가 허용하는 길이를 같은 것으로 보지 말자.
내려받기 전에 자신의 조건을 먼저 적어 본다
로컬 실행을 검토한다면 다음과 같은 조건표부터 작성해 보자. 실제 가중치 다운로드나 설치를 실행하는 명령이 아니라, 검토에 필요한 정보를 모으는 양식이다.
사용 목적: 코딩 / 문서 / 이미지 이해 / 도구 실행 중 무엇인가
실행 경로: 외부 API / GPU 서버 / 고메모리 로컬 장비
가중치 형식: 공식 NVFP4 / MXFP8 / 제삼자 양자화본
자원: 저장 공간, RAM, VRAM, 런타임 호환성
문맥 길이: 실제 작업에 필요한 입력 범위
자료 정책: 외부 전송 가능 여부와 보관 조건
검증 항목: 정확성, 속도, 비용, 도구 권한, 실패 처리
처음 품질을 비교할 때도 동일한 입력과 성공 기준을 사용하자. 다음은 자신의 작업 평가를 설계하기 위한 예시다.
비밀정보가 없는 동일한 예제 과제로 모델을 비교해라.
한국어 설명과 실제 작업 결과를 나누어 평가해라.
추정과 확인된 사실을 구분하고 출처가 필요한 주장에는 근거를 붙여라.
코드는 테스트한 항목과 실행하지 못한 항목을 함께 보고해라.
도구 호출은 정한 권한과 비용 한도 안에서만 수행해라.
특정 벤치마크 점수를 근거로 모든 업무에서 우수하다고 결론 내리지 마라.
Inkling 2 Small의 공개는 개발자가 선택할 수 있는 모델과 조정 가능성을 넓힌다. 그러나 무료라는 한 단어만으로 자신의 장비·업무에 맞는 선택이 끝나지는 않는다. 가중치의 공개 범위, 실행 자원, 실제 작업 품질과 운영 조건을 따로 확인하자.
캡처는 원영상 설명·비평을 위한 도식 인용이다. 제작자는 AI 음성과 재연 이미지를 사용했다고 고지했다. 노트북 RAM과 GPU VRAM의 단순 배율 비교는 구매 근거로 사용하지 않았으며, 성능·안전성·한국어 품질을 독립 검증하지 않았다. Hugging Face 파일은 메타데이터만 조회했고 대용량 가중치를 다운로드하지 않았다.
FAQ
Inkling 2 Small은 17B짜리 작은 모델인가요?
총 파라미터는 594B이며 활성 파라미터가 약 17B다. 한 토큰에서 사용하는 부분이 적다는 뜻이지 전체 가중치의 크기와 실행 자원이 17B 모델과 같다는 뜻은 아니다.
171.7GB 양자화본이면 메모리도 그 정도면 충분한가요?
그 수치는 가중치의 디스크 크기다. KV 캐시, 런타임, 운영체제와 추가 파일에 필요한 자원을 함께 고려해야 한다. 실제 속도와 품질도 실행 방식에 따라 확인해야 한다.
공개 가중치면 API도 무료인가요?
아니다. 가중치 라이선스와 서버를 이용하는 서비스 과금은 별개다. 무료 체험이 있더라도 범위와 조건은 서비스에서 확인해야 한다.
회사 표에서 앞선 모델이면 한국어 대화도 더 잘하나요?
그렇게 단정할 수 없다. 지수와 평가 조건의 범위가 있고, 개발사도 채팅 경험의 한계를 적고 있다. 자신의 한국어 작업으로 별도 평가해야 하며 이 글에서는 그 품질을 측정하지 않았다.
포스터 문구를 바꾸고, 견적서 수량을 고치고, 3D 장면을 렌더링하는 일을 AI에게 맡긴다고 해보자. 화면의 버튼 위치를 매번 찾는 대신, 현재 상태를 읽고 정해진 명령을 실행할 수 있다면 작업을 연결하기 쉬워진다.
CLI-Anything은 기존 소프트웨어를 에이전트가 다룰 수 있는 명령줄 인터페이스로 연결하는 프로젝트다. ‘CLI Anything’이라는 이름만 보고 모든 앱이 한 번에 자동화된다고 기대하기보다는, 앱별 하네스와 실제 처리 엔진, 결과 검증을 나눠 이해하는 편이 좋다.
세 영상은 각각 설계 원칙, Inkscape·LibreOffice·Blender 실습, 설치·검증 구조를 다룬다. 공식 저장소와 방법론을 대조해 공통 원리와 적용 순서를 정리했다. 이 글에서 하네스를 새로 설치하거나 네이티브 앱의 전체 작업을 독립 재현한 것은 아니다.
CLI-Anything은 앱을 새로 복제하는 도구가 아니다
공식 저장소는 기존 소프트웨어와 에이전트 사이에 CLI 하네스를 두는 방식을 제안한다. 하네스는 명령을 해석하고 작업 상태를 관리하며, 필요한 기능을 앱의 API·스크립트·명령줄 도구나 파일 형식에 연결한다.
흐름은 사용자 요청 → 에이전트의 명령 선택 → 앱별 하네스 → 처리 결과와 상태 확인으로 볼 수 있다. 새 앱을 만드는 것과는 다른 접근이다. Craft Anything의 재구현 방식과도 목적을 구분해야 한다.
소프트웨어에 접근 가능한 API나 스크립팅 기능이 부족하면 연결할 수 있는 범위도 제한된다. 이미 준비된 하네스가 있더라도 앱 전체 기능을 모두 다룬다고 가정하지 말자. GUI를 없애는 선언보다는 반복 작업에 기계가 사용할 입구를 추가하는 방법에 가깝다.
출처: AI-Native Software Engineer, 원본 영상 01:02. AI 생성 요약 영상의 설명도이며 실제 앱 실행 로그가 아니다. 해설·비평 목적의 장면 인용.
코딩 에이전트가 생성한다고 해서 테스트 단계가 생략되는 것은 아니다. 어떤 기능을 노출하고 무엇을 확인했는지 사용 설명과 함께 남겨야 다른 에이전트가 이어서 쓸 수 있다.
또한 이미 만들어진 하네스를 설치하는 일, 없는 하네스를 생성하는 일, 원래 앱을 설치하는 일은 구분해야 한다. CLI 도구를 설치했다고 LibreOffice의 변환 엔진이나 Blender의 렌더 엔진까지 준비됐다는 뜻은 아니다.
단테의 실습: 그림·계산·3D를 같은 요청 흐름으로 잇는다
단테 영상은 가상 커피 브랜드를 소재로 세 앱의 결과물을 보여준다. 제작자의 시연을 정리한 것이며 블로그의 독립 실행 결과는 아니다.
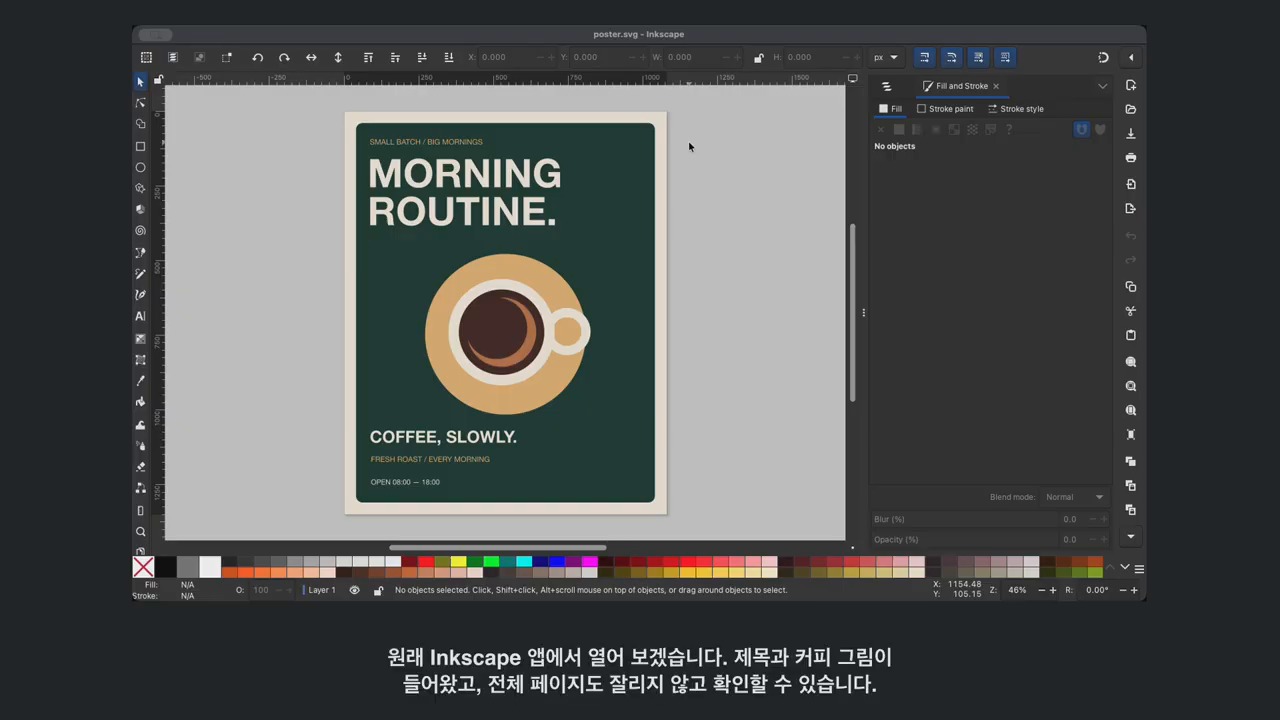
Inkscape: 이미지 한 장보다 수정할 수 있는 원본
포스터를 SVG·PDF로 내보내고 Inkscape에서 확인한다. 이후 문구를 MORNING에서 EVENING으로 바꾸는 작업도 소개한다. 반복 제작에서는 이런 편집 가능한 원본과 최종 배포 파일을 구분하는 것이 유용하다.
출처: 단테, 원본 영상 02:50. 가상 커피 브랜드의 실습 결과다. 블로그에서 이 파일을 직접 재생성한 것은 아니다. 해설·비평 목적의 장면 인용.
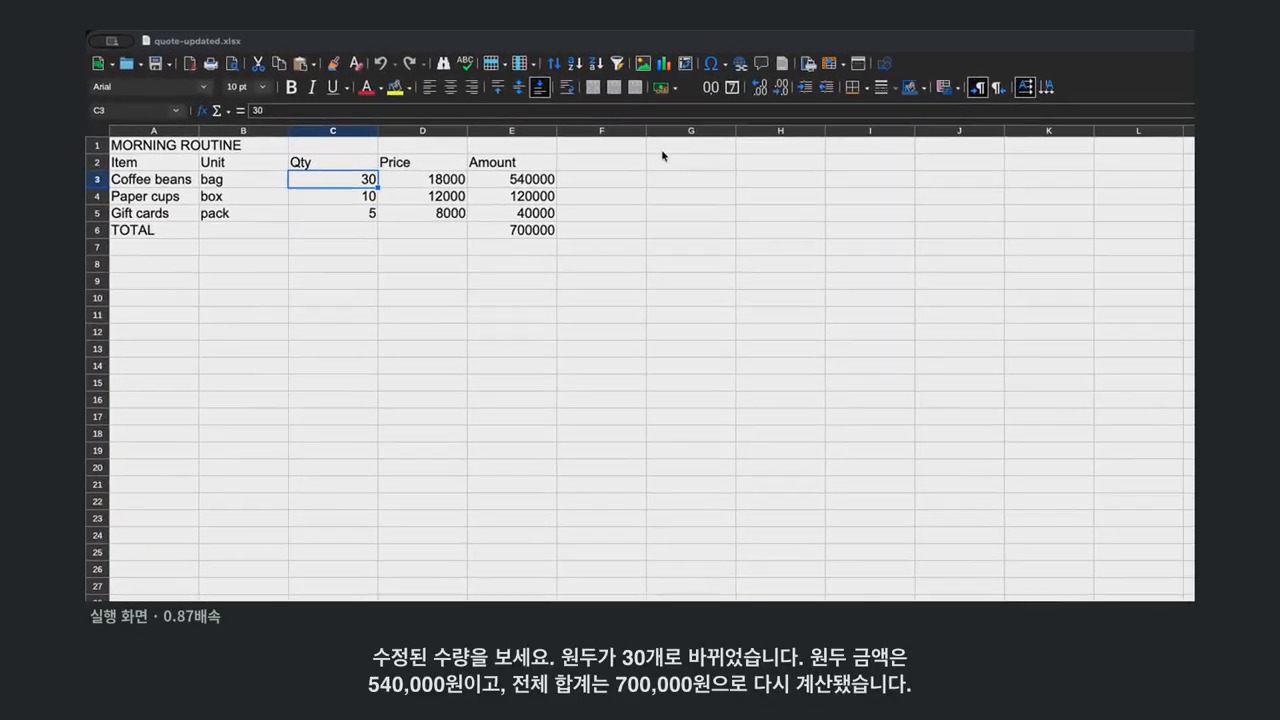
LibreOffice: 합계 숫자가 아니라 수량과 수식을 확인한다
견적서는 원두 수량을 20개에서 30개로 바꾸고 수식 결과가 따라가는지를 보여준다. 가상 예제의 합계는 520,000원에서 700,000원으로 바뀐다. 이 산술은 검산했지만 실제 Calc 재계산을 재현한 것은 아니다.
제작자는 사용 커밋과 함께 수식 처리를 위한 xmlns:of 선언을 추가했다고 명시한다. 따라서 영상 결과에는 로컬 수정이라는 조건이 있다. 무수정 설치가 항상 성공한다거나 모든 버전이 같은 문제를 갖는다고 일반화할 수는 없다.
출처: 단테, 원본 영상 05:29. 수량·단가·합계는 가상 실습값이며 실제 견적·시장가격이 아니다. 계산 예시는 별도로 산술 검산했다. 해설·비평 목적의 장면 인용.
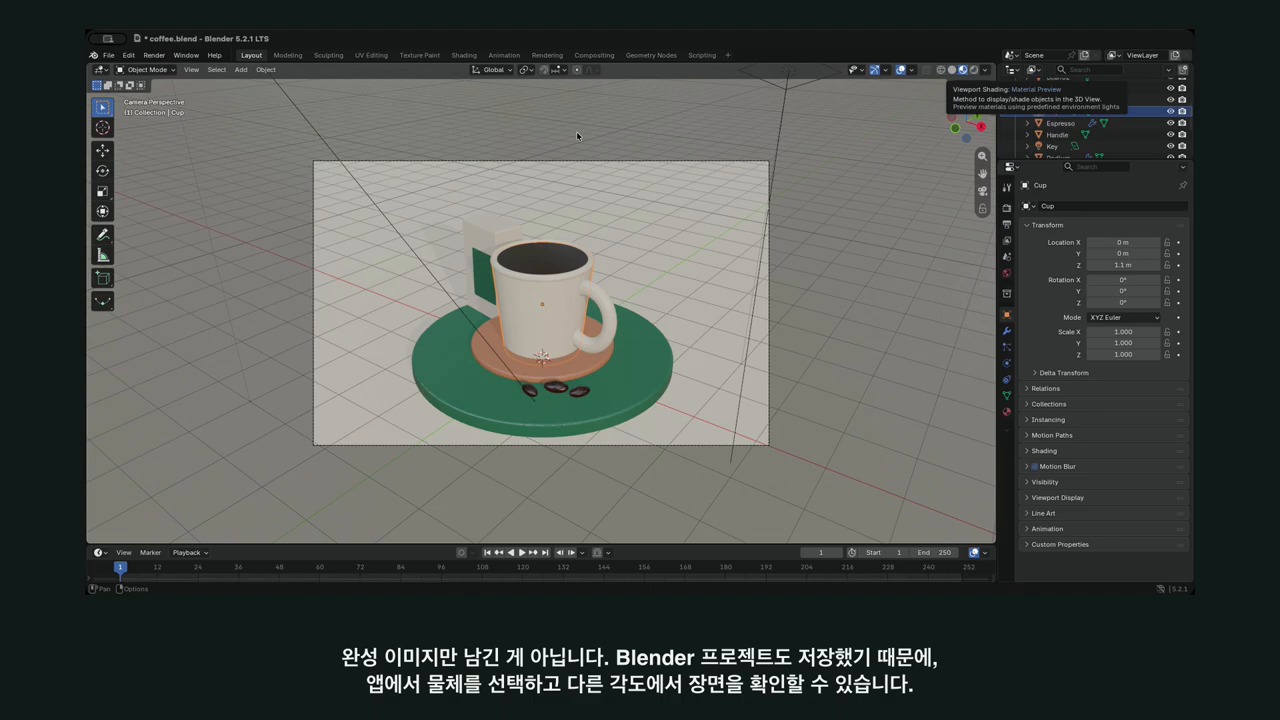
Blender: 장면 데이터와 렌더 결과는 별개다
영상은 커피 컵 장면과 Blender에서 물체를 선택하는 모습을 보여준다. 장면 JSON이나 생성된 실행 스크립트가 있다는 사실만으로 렌더가 끝났다고 보지는 말자. 실제 엔진 실행과 이미지·프로젝트 확인이 필요하다.
출처: 단테, 원본 영상 06:41. 3D 장면과 렌더 결과의 시연이다. 이미지 생성 모델로 만든 제품 사진이나 상용 품질 보장으로 제시하지 않는다. 해설·비평 목적의 장면 인용.
에이전트용 CLI 설계에서 가져올 6가지 원칙
다음은 공식 방법론의 요구와 세 영상을 바탕으로 정리한 기준이다. 모든 기존 하네스가 이미 이 기준을 완벽하게 충족한다는 보증은 아니다.
1. 행동하기 전에 상태를 조회할 수 있어야 한다
문서·객체·시트·장면의 현재 상태를 먼저 확인하도록 명령을 설계한다. 에이전트가 기억이나 추측으로 객체 번호를 고르면 엉뚱한 대상을 바꿀 수 있다. info, list, status 같은 탐색 기능이 수정 명령만큼 중요하다.
2. 구조화된 출력과 실제 성공을 구분한다
JSON은 결과를 파싱하기 쉽게 만든다. 하지만 파싱되는 응답이라고 내용까지 올바른 것은 아니다. 입력, 처리 상태, 산출물 위치와 실패 이유가 명확해야 다음 행동을 판단할 수 있다.
방법론은 --json 지원을 요구한다. 실제 설치된 하네스의 옵션 위치와 출력 구조는 해당 도움말에서 확인하자. 앱마다 명령 이름과 지원 범위가 같지는 않다.
3. 중간 파일과 실제 앱 엔진의 출력을 나눈다
SVG·ODF·장면 JSON 같은 중간 표현을 구성하는 단계와 PDF·Office 형식 변환·3D 렌더링은 다르다. 앱별 문서도 이 차이를 보여준다. 일부 편집은 앱 본체 없이 가능하지만 최종 변환이나 렌더링에는 해당 엔진이 필요하다.
HARNESS.md는 렌더링·내보내기에 실제 소프트웨어를 사용하도록 요구한다. 비슷한 이미지를 따로 만들어 성공한 것처럼 대신하는 방식은 이 목적과 맞지 않는다. 결과가 어떤 처리 경로로 만들어졌는지를 남겨두자.
4. 상태 저장과 반복 실행을 안전하게 설계한다
여러 명령을 따로 실행해도 작업을 이어갈 수 있어야 한다. 저장된 상태, 원본 파일, 내보낸 결과가 각각 무엇인지 구분하자. 되돌리기와 재시도도 실제 지원되는 범위를 확인해야 한다.
명령이 재전송되면 같은 도형이나 행이 중복 추가될 수도 있다. 읽기·생성·수정·삭제의 성격에 맞춰 재실행 규칙을 정하는 편이 좋다. 상태 파일의 동시 쓰기나 충돌도 별도로 다뤄야 한다.
5. 실패를 설명하고 결과 파일을 직접 검사한다
종료 코드 0은 프로세스가 정상 종료됐다는 신호이지 결과 내용의 완성 판정이 아니다. 공식 방법론은 파일 형식, 압축 구조, 픽셀·오디오·길이 등 산출물에 맞는 검사를 요구한다. 실제 프로그램이 없으면 성공으로 꾸미거나 조용히 건너뛰지 않도록 한다.
견적서라면 수식과 계산값을, PDF라면 페이지와 글자·도형을, 렌더 이미지라면 실제 출력과 장면 조건을 확인해야 한다. 마지막에 원래 앱으로 다시 열어보는 과정도 유용하다.
6. 개발 코드와 설치된 실행 파일을 따로 검증한다
소스 디렉터리에서 모듈을 실행한 결과와 에이전트가 PATH에서 찾는 명령의 결과는 다를 수 있다. 공식 빠른 시작 문서는 CLI_ANYTHING_FORCE_INSTALLED=1을 사용하는 테스트 방법을 안내한다.
이 변수를 해석하는 테스트 헬퍼는 설치된 명령을 요구하고 개발용 모듈 실행으로의 대체를 막는다. 시스템 전역에 설치해야 한다는 뜻은 아니며, 변수 하나가 모든 테스트를 자동으로 바꾸는 것도 아니다.
설치 명령을 검증했다는 사실도 운영 환경 전체의 안정성 증명은 아니다. 실제 앱 버전, 글꼴, 파일 권한, 경로와 입력 자료에 따른 확인은 여전히 필요하다.
CLI-Hub로 시작할 때는 설치할 대상을 먼저 살핀다
CLI-Hub 안내는 하네스를 찾아보고 설치·관리하는 경로를 제공한다. 다만 목록에 있다는 사실만으로 같은 수준의 유지보수·검증·안전성을 갖췄다고 보지는 말자.
이미 해당 명령이 설치된 환경이라면 아래와 같은 조회부터 시작할 수 있다. 설치·실행 결과를 이 글에서 재현한 명령은 아니다.
cli-hub info inkscape
cli-anything-inkscape --help
설치할 때는 패키지 출처, 원래 앱의 요구사항, 지원 기능과 변경 권한을 확인하자. 외부 스킬 문서를 읽는 것과 그 문서가 지시하는 설치·명령 실행을 승인하는 것도 별개다. 작은 시험 환경에서 필요한 범위부터 검토하는 편이 낫다.
플러그인 생성 명령과 일반 셸 명령도 혼동하지 말자. 문서에 나온 예제 경로를 그대로 복사하기보다 자신이 설치한 코딩 에이전트와 하네스의 현재 안내를 기준으로 해야 한다. Windows 역시 쉘·앱·하네스별 조건을 확인할 문제이지, 한 영상의 환경을 모든 설치에 그대로 적용할 수는 없다.
첫 자동화 요청에는 수정 범위와 확인 방법을 함께 쓴다
처음에는 반복 작업 하나를 고르고 원본의 사본으로 시험해 보자. 아래는 세 영상의 공통 원칙을 반영한 요청 예시다.
설치된 CLI-Anything 하네스의 도움말과 현재 프로젝트 상태를 먼저 확인해라.
지원되지 않는 명령이나 앱 기능을 추측해서 사용하지 마라.

원본은 보존하고 사본에서 지정한 문구와 수량만 수정해라.
표의 수식을 유지하고 계산 결과를 확인해라.
필요한 변환·렌더 엔진이 없으면 대체 결과를 만들지 말고 보고해라.

중간 상태 파일, 편집 가능한 원본, 최종 내보내기 파일을 구분해라.
실행 로그와 실제 결과물 검사 내용을 함께 보고해라.
확인하지 못한 항목은 미확인으로 남겨라.
외부 설치·삭제·배포·공유 설정 변경은 먼저 승인을 받아라.
포스터라면 텍스트와 도형이 편집 가능한지, 견적서라면 수식과 합계가 맞는지, 3D 작업이라면 장면과 렌더 파일이 열리는지 확인한다. 명령 실행 기록과 최종 산출물을 함께 남겨야 다음 수정도 이어가기 쉽다.
모든 앱의 GUI를 대체한다는 기대는 내려놓는다
기술보고서는 구조화 명령·명시적 상태·예측 가능한 피드백이라는 상호작용 방식을 제안한다. 이것을 모든 앱에서 화면 자동화보다 일정 비율 빠르거나 저렴하다는 보편적 성능 보장으로 읽지는 말자.
첫 영상은 제작자가 AI 생성 요약이며 직접 실행하지 않았다고 밝힌 자료다. Alex Hitt 영상의 명령·JSON·검증 그림도 여기서는 구조 설명으로 사용했지 독립 실행 로그로 평가하지 않았다. 단테 실습은 편집과 결과 확인의 사례지만 특정 버전과 수정 조건이 있다.
실무에서는 하네스가 지원하는 반복 동작은 명령으로 연결하고, 시각적 품질 판단이나 아직 노출되지 않은 기능은 앱에서 확인하는 혼합 방식으로 시작해 볼 수 있다. 자동화의 가치는 화면을 안 열었다는 사실보다, 의도한 변경과 검증 가능한 결과물을 남겼는지에서 판단하는 편이 좋다.
확인 기준일은 2026년 11월 12일이다. 단테가 명시한 커밋은 34f519533bc175d2fe287ab8316b0dd99bb9cc43이며, 조회한 main도 같은 커밋이었다. 다만 영상의 LibreOffice 로컬 수정까지 그 커밋에 포함됐다는 뜻은 아니다. 캡처는 설명·비평을 위한 원영상 인용이다. 가상 견적의 산술 검산과 실제 앱의 재계산·렌더 시험은 구분했으며, 후자는 블로그에서 재현하지 않았다.
FAQ
CLI-Anything을 설치하면 앱 본체 없이 모든 작업을 할 수 있나요?
아니다. 중간 상태나 파일 내용을 구성할 수 있는 단계와 실제 앱 엔진이 필요한 변환·렌더 단계가 다르다. 앱별 요구사항과 지원 명령을 확인해야 한다.
JSON 응답이나 종료 코드 0이면 완료로 봐도 되나요?
그것만으로는 부족하다. 명령의 상태와 산출물의 형식·내용·계산·렌더 결과를 나눠 검사해야 한다. 결과 파일이 존재해도 의도한 내용이 맞는지는 별도다.
CLI-Hub와 CLI 하네스 생성은 같은 기능인가요?
CLI-Hub는 제공되는 도구를 발견하고 설치·관리하는 경로이고, 하네스 생성은 대상 소프트웨어의 기능을 명령으로 연결하는 개발 과정이다. 여기에 원래 앱의 설치까지 별도로 필요할 수 있다.
기존 GUI 작업을 모두 버려야 하나요?
그럴 필요는 없다. 지원되는 반복 작업은 CLI로 연결하고, 시각적 품질이나 미지원 기능은 앱에서 확인할 수 있다. 범위를 좁혀 검증한 뒤 확장하는 편이 현실적이다.
웹사이트 주소를 넣고 ‘이런 서비스를 만들어줘’라고 말하면 어디까지 만들어질까. Craft Anything은 원본을 조사하고, 코딩 에이전트로 새 프로젝트를 만든 다음, 결과를 비교·수정하는 오픈소스 도구다. 다만 화면이 닮았다는 것과 서비스를 실제로 운영할 수 있다는 것은 따로 확인해야 한다.
Flyke는 타이핑 사이트를 재구현하고 Claude Code 단독 결과와 비교했다. Hodu’s AI Analysis Lab은 자신이 운영하는 유료 사이트를 대상으로 접근이 제한된 조건에서 시험했다. 두 영상은 성공과 실패의 단순한 대조표가 아니다. 원본에 접근할 수 있는 범위와 평가 방법이 결과를 어떻게 바꾸는지 보여준다.
아래 내용은 두 제작자의 시연과 2026년 11월 12일 확인한 공식 저장소를 대조한 분석이다. 여기서 Craft Anything을 새로 설치하거나 두 실험을 독립적으로 재현한 것은 아니다.
Craft Anything은 어떤 도구인가
공식 저장소는 Craft Anything을 웹사이트·앱·게임의 작동 방식을 살펴보고 자신의 버전을 만드는 도구로 소개한다. 데스크톱 앱, CLI, MCP 인터페이스가 같은 분석 엔진을 활용하는 구조다.
기본 흐름은 네 단계다.
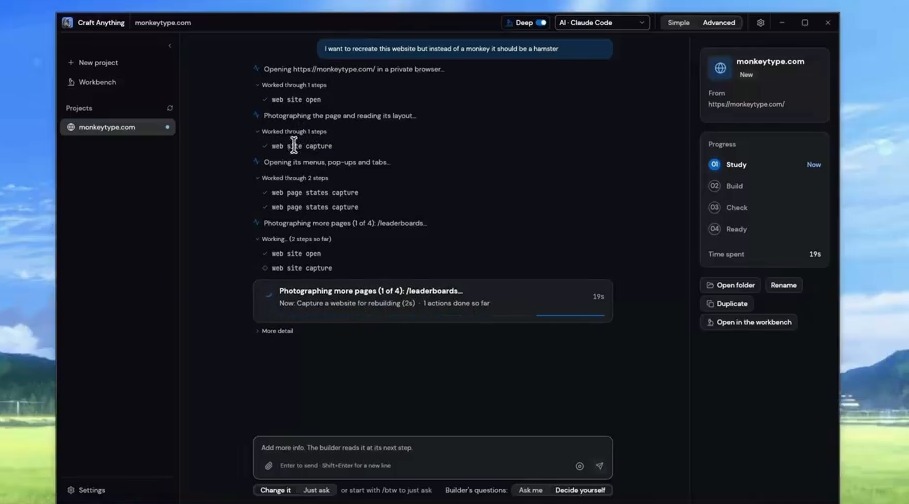
Study: 원본의 화면과 접근 가능한 자료, 동작을 조사한다.
Build: 코딩 에이전트가 요청한 기술로 새 프로젝트를 만든다.
Check: 원본과 결과를 비교하고 차이를 기록한다.
Ready: 결과를 열어보거나 추가 수정을 요청한다.
여기서 Craft Anything과 AI 모델을 구분해야 한다. 공식 문서는 생성 작업에 로컬 코딩 에이전트가 필요하며 Claude Code를 우선 지원한다고 설명한다. 다른 어댑터도 있지만 실설치 검증이 끝나지 않은 부분이 있다. 분석·질의에 사용할 수 있는 제공자가 곧바로 같은 수준의 생성 기능까지 지원한다는 뜻은 아니다.
앱을 받았다고 모델 계정·사용량이 무료로 생기는 것도 아니다. 자신이 연결한 코딩 에이전트의 인증과 이용 조건, 비용을 확인해야 한다.
출처: Flyke, 원본 영상 03:15. 원영상 시연 화면의 일부. 질문·수정 과정이 포함된 단일 작업이며 자동 성공률의 측정값은 아니다. 해설·비평 목적의 장면 인용.
Clean room과 Deep의 차이는 조사 범위에 있다
공식 README가 설명하는 기본 모드는 Clean room이다. 방문자가 볼 수 있는 화면·텍스트·레이아웃·상호작용 등을 바탕으로 작업하고 원본 내부의 코드·파일·페이지 소스는 읽지 않는 정책이다.
Deep은 접근 가능한 코드와 파일, 웹사이트의 JavaScript 등까지 조사 범위를 넓힌다. 설치된 경우 Ghidra 같은 분석 도구도 활용할 수 있다고 안내한다.
하지만 Deep을 선택한다고 원격 서버의 비공개 데이터베이스나 비밀키를 얻는 것은 아니다. 접근 가능한 클라이언트 코드와 서버 내부 자료는 다르다. 로그인이나 권한에 막힌 상태라면 무엇을 실제로 관찰했는지부터 확인해야 한다.
또한 Clean room은 운영체제 샌드박스가 아니다. 개발사도 이를 명시한다. 연결한 코딩 에이전트가 읽고 쓰거나 실행할 수 있는 범위는 별도의 권한 설정에 달려 있다. 에이전트별로 정책을 집행하는 범위와 실제 검증 상태도 같지 않다.
사례 1: 타이핑 화면은 상당히 닮았지만 검토할 기능이 남았다
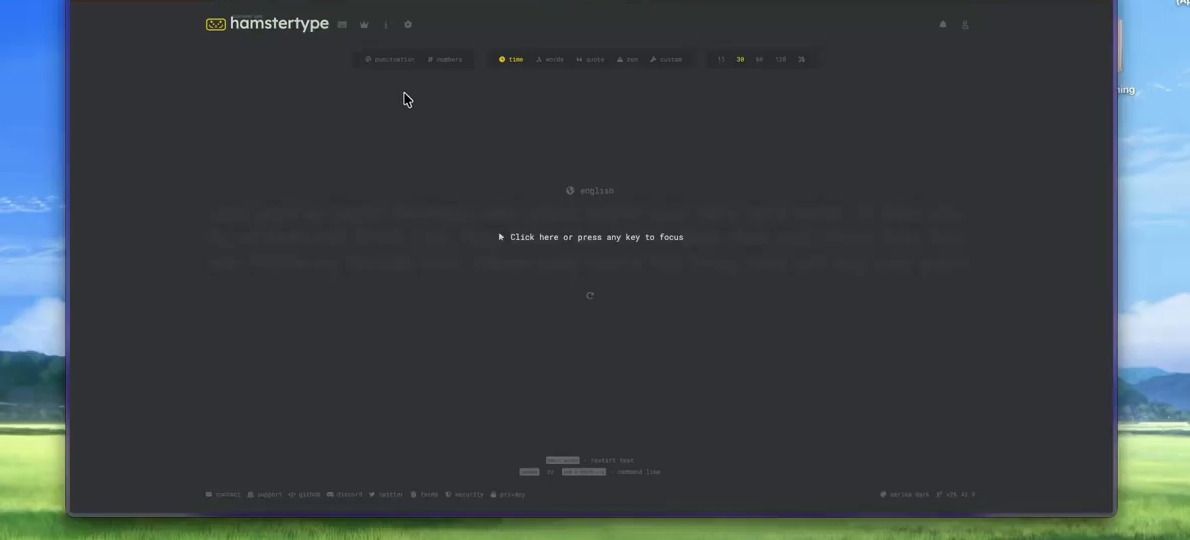
Flyke는 Deep 모드로 Monkeytype를 바탕으로 한 HamsterType를 만들었다. 타이핑 화면과 테스트 흐름을 갖췄지만, 제작자가 중간에 타이머와 결과 화면 등의 수정을 요청했다.
편집자 주는 초기 웹사이트 완료 시간을 43분으로 정정한다. 당시 표시된 API 비용 20.79달러는 해당 시점의 보고값이지 현재 요금이나 전체 운영비가 아니다.
Claude Code 단독 작업은 약 55분으로 소개된다. 다만 지시와 중간 피드백이 같게 통제된 반복 실험은 아니다. 어느 도구가 일반적으로 더 빠르다고 결론 내릴 수는 없다.
출처: Flyke, 원본 영상 07:05. 타이핑 화면의 시연이다. 모의 순위·계정과 실제 서버 인증·데이터 연동을 구분해야 한다. 해설·비평 목적의 장면 인용.
‘프런트엔드뿐’과 ‘백엔드 완성’ 사이의 단계를 구분한다
초기에는 모의 계정과 프런트엔드의 한계가 드러났고, 후반에는 Node.js·SQLite·Resend를 이용한 선택적 서버 구조가 소개된다. 전체 과정을 ‘프런트엔드만 만들었다’고 요약하면 이 변화를 놓친다.
그러나 서버 구조와 실서비스 연동은 다르다. OAuth 설정·메일 발송·계정 격리·데이터 보존·실제 결제는 각각 검증해야 한다. Resend도 그 자체로 Google·GitHub 인증을 완성해 주지는 않는다. 생성 결과의 전체 저장소를 확보하지 못했으므로 여기서는 코드 감사나 실연동 완료 판정을 하지 않았다.
사례 2: 차단 화면을 닮았다고 100%가 나올 수 있다
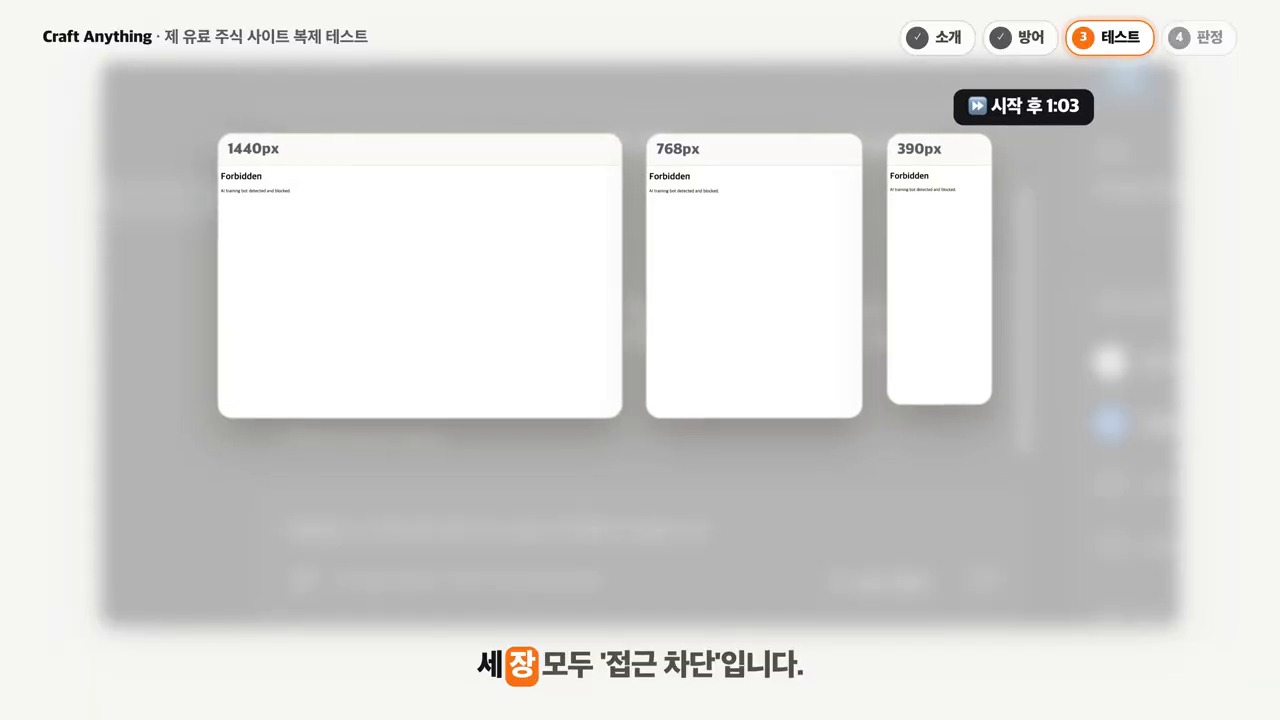
Hodu’s AI Analysis Lab은 2026년 11월 9일 자신의 유료 서비스 The Desk를 Deep 모드로 시험했다. 제작자의 기록에서는 초기 화면 수집과 추가 접근이 차단·승인 조건에 막혔다.
출처: Hodu's AI Analysis Lab, 원본 영상 02:18. 제작자 소유 사이트의 단일 실험 기록. 차단 화면을 실제 서비스 화면과 구분해야 한다. 해설·비평 목적의 장면 인용.
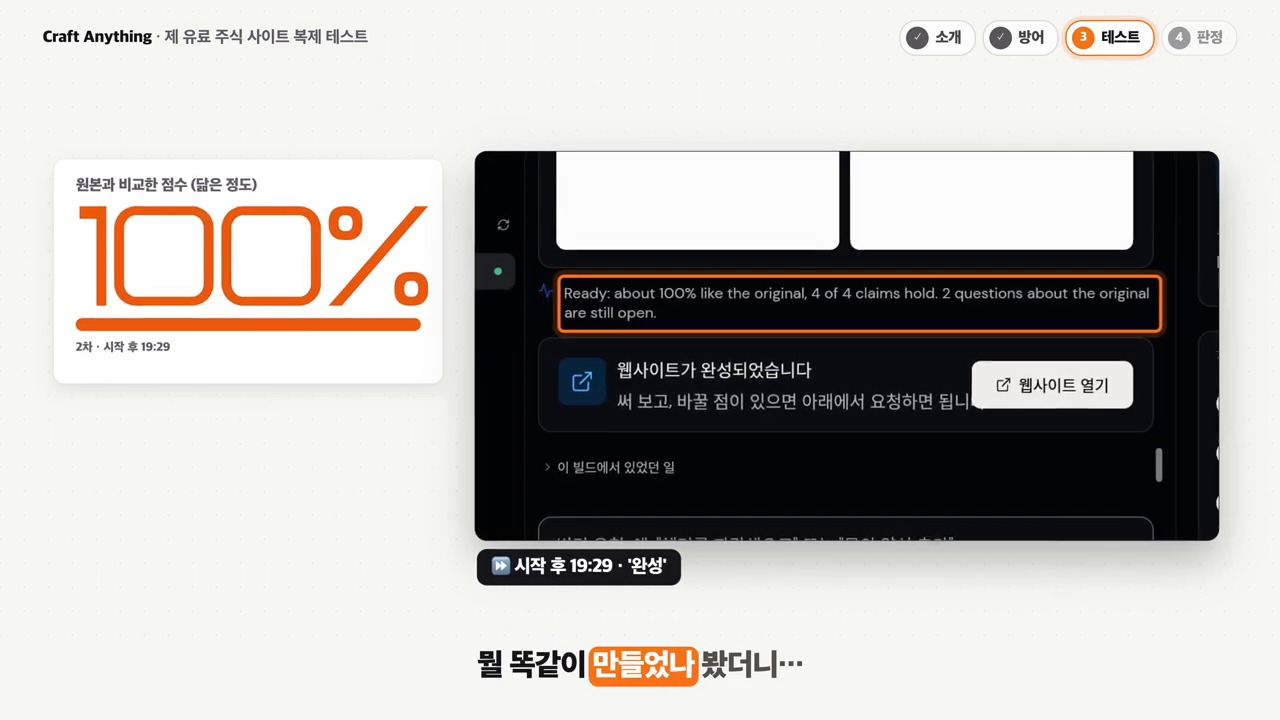
이후 100%라는 자체 점수는 실제 서비스가 아니라 차단 화면을 비교한 값이었다고 설명한다. 제작자는 문제가 반복됐고 약 35분의 작업으로 정밀 재구현에는 실패했다고 판정했다. 이는 잘못된 비교 기준이 완료 판정으로 이어질 수 있다는 사례다.
출처: Hodu's AI Analysis Lab, 원본 영상 02:47. 100%는 이 실험의 차단 화면 비교 점수다. 서비스 기능 완성률이나 보안 인증이 아니다. 해설·비평 목적의 장면 인용.
다만 공개 메뉴 구조 일부는 읽혔다고 보고한다. 이 단일 실험으로 모든 접근 경로의 보안이 검증됐다고 결론 내려서도 안 된다. 영상 속 시세 예시도 실제 데이터 연동의 증거가 아니다. 접근 권한·데이터 정확성과 사용 조건은 별도로 확인해야 한다.
유사도 점수보다 먼저 확인할 다섯 가지
두 사례에서 가져갈 만한 평가 기준을 정리하면 다음과 같다. 이는 Craft Anything의 기본 기능이 모두 자동으로 수행한다는 뜻이 아니라, 사용자가 추가할 수 있는 검토 기준이다.
1. 원본 화면을 제대로 수집했는가
스크린샷이 차단·오류·로그인 안내 화면이라면 먼저 그 상태를 기록하자. 기대한 페이지와 사용자 권한으로 접근했는지 확인하고, 관찰하지 못한 부분을 생성 결과의 완성도로 평가하지 않는다.
2. 주요 동작을 실제로 실행했는가
버튼의 모양과 클릭 후 행동은 다른 평가 항목이다. 입력 오류, 재시도, 결과 저장, 모바일 크기, 새로고침 후 상태 등을 나눠 보자. 보이는 메뉴 수와 동작하는 기능 수를 같은 것으로 세지 않는다.
3. 진짜 데이터와 예시 데이터가 구분되는가
순위·시세·계정·결과 값이 모의 데이터라면 화면에도 그렇게 표시해야 한다. 데이터베이스 파일이 있다는 이유만으로 외부 데이터 연동이나 여러 사용자 사이의 동기화가 확인된 것은 아니다.
4. 인증과 접근 통제를 서버에서 확인했는가
로그인 폼이 보이거나 아무 값으로 화면이 넘어가는 것은 인증 검증이 아니다. OWASP의 접근 권한 검토 지침도 권한을 서버 측에서 확인하고 요청별로 검증하는 원칙을 설명한다. 자신의 허가된 시험 환경에서 계정별 접근과 비로그인 상태를 따로 확인해야 한다.
5. 완료 기준과 미확인 항목이 보고되는가
‘92%’, ‘100%’, ‘Ready’라는 표시만 보지 말자. 어떤 화면·기능·사용자 상태를 대상으로 평가했는지, 무엇이 빠졌는지 보고서를 받아야 한다. 본 적 없는 기능은 미확인으로 남기는 편이 잘못된 완료 판정보다 낫다.
처음 사용한다면 권한 있는 작은 대상부터 시작한다
확인 시점의 공식 릴리스 페이지는 v0.6.0을 제공한다. 프로젝트는 여전히 초기 알파로 안내된다. 저장소의 최신 main 문서와 자신이 설치한 릴리스가 같다고 가정하지 말고, 버전과 지원 상태를 확인하자.
설치 후 확인 명령으로는 공식 README의 다음 항목을 참고할 수 있다. 이 글에서 해당 앱을 설치해 실행 결과를 재현한 명령은 아니다.
craft-anything-cli doctor
첫 대상은 자신이 만들었거나 조사·재구현할 권한이 있는 작은 프로젝트로 정하자. 예를 들어 내부 도구의 새 화면 시안, 허가된 레거시 UI의 재설계, 별도로 준비한 테스트 페이지처럼 범위를 좁힐 수 있다.
다음은 두 영상에서 드러난 평가 문제를 반영한 요청 예시다.
내가 소유한 테스트 프로젝트를 바탕으로 새 프로토타입을 만들어라.
기본 조사 모드는 Clean room으로 하고, 필요한 범위 변경은 먼저 물어라.
기존 로고·사진·본문을 그대로 옮기지 말고 새 리소스를 사용해라.

원본이 차단·오류·로그인 안내 화면이면 정상 수집으로 처리하지 마라.
관찰하지 못한 기능은 추정 구현과 미확인 항목으로 구분해라.

화면 비교, 실제 버튼 동작, 예시 데이터, 서버 저장, 인증을 따로 평가해라.
OAuth·메일·결제 등 외부 서비스를 선택하거나 연결하기 전에 승인을 받아라.
모의 데이터와 임시 로그인은 화면과 보고서에 표시해라.

마지막에는 실행 방법, 테스트한 항목, 남은 설정과 한계를 보고해라.
외부 배포와 공개 업로드는 하지 말고 검토를 기다려라.
의존성 설치에도 주의가 필요하다. 공식 문서는 패키지 설치 과정의 스크립트와 코딩 에이전트의 명령이 사용자 컴퓨터에서 실행될 수 있다고 경고한다. ‘항상 허용’을 폭넓게 주기 전에 무엇을 허용하는지 확인하자. 새 프로젝트 폴더와 비밀정보가 없는 시험 환경을 사용하는 것도 검토할 만한 운영 방법이다.
도구의 라이선스와 원본을 사용할 권한은 다르다
Craft Anything의 README와 Cargo 설정은 MIT 또는 Apache-2.0의 이중 라이선스를 명시한다. 그러나 이것이 조사 대상의 코드·상표·이미지·데이터까지 같은 조건으로 쓸 수 있다는 의미는 아니다.
예를 들어 Monkeytype의 원본 프로젝트 라이선스는 별도로 확인해야 한다. 공개 소프트웨어라는 사실과 재배포·변경·리소스 사용의 조건을 검토하는 것은 다른 일이다.
개발사도 소유하거나 조사 권한이 있는 소프트웨어에 사용하도록 안내한다. Clean room이라는 모드명만으로 적법성이나 제삼자 권리 문제가 자동으로 해결된다고 판단하지 말자. 이 글은 로그인·DRM·접근 제한을 우회하는 방법을 안내하지 않는다.
프로토타입 도구로 볼 때 무엇을 기대할 수 있을까
두 영상이 보여주는 활용 가능성은 관찰 가능한 화면과 동작을 새 프로젝트의 출발점으로 바꾸는 데 있다. 동시에 차단 화면을 수집하거나 실서비스 설정을 확인하지 않은 상태에서는 높은 자체 점수가 완료 판정을 대신하지 못한다.
따라서 ‘무엇이든 복제한다’는 문구보다 원본 접근 범위, 구현된 기능, 인증과 데이터의 실제 연결, 남은 수작업을 보고 판단하는 편이 좋다. 잘 만들어진 프로토타입을 얻는 일과 운영 가능한 서비스를 완성하는 일을 나눠서 평가하자.
캡처는 각 원본 영상의 설명·비평을 위한 인용이며 일부는 앱 화면 중심으로 잘랐다. 점수·시간·비용은 제작자가 제시한 개별 실험 기록이다. 결과 코드 전체와 실제 운영 연동을 독립 검증하지 않았으며, 서로 다른 대상의 소요 시간을 합쳐 도구의 일반 성능 순위로 만들지 않았다.
FAQ
Craft Anything은 Claude Code를 대체하는 도구인가요?
현재 공식 설명에서는 코딩 에이전트를 연결해 조사·생성·비교 흐름을 진행하는 도구다. Claude Code를 우선 지원하며, 설치한 에이전트의 인증과 이용 조건을 별도로 확인해야 한다. 다른 어댑터의 지원과 실제 검증 범위는 같지 않을 수 있다.
유사도 100%면 서비스가 완성된 것인가요?
아니다. 무엇을 비교했는지가 먼저다. 차단 화면끼리 비교한 점수라면 실제 서비스 구현 수준을 말해주지 않는다. 주요 기능, 데이터, 인증, 저장과 운영 조건을 별도로 확인해야 한다.
Deep 모드면 로그인 뒤의 서버 데이터까지 가져올 수 있나요?
그렇게 기대하면 안 된다. 접근 가능한 자료를 더 조사하는 것과 비공개 서버 자료에 대한 권한을 확보하는 것은 다르다. 생성된 서버 코드나 로그인 화면도 실제 외부 인증·데이터 연동을 검증한 결과와 구분해야 한다.
Clean room 모드면 보안과 권리 문제를 걱정하지 않아도 되나요?
그렇지 않다. 개발사는 Clean room을 조사 범위에 관한 정책으로 설명하며 운영체제 샌드박스가 아니라고 명시한다. 원본을 사용할 권한, 연결한 에이전트의 실행 권한과 의존성 설치 위험도 별도로 검토해야 한다.
Hermes Agent를 설치하고 봇도 여러 개 만들었는데, 정작 결과물보다 중간 지시와 오류 확인에 시간을 더 쓰고 있다면 구성을 다시 볼 때다. 모델을 바꾸거나 컴퓨터를 새로 사기 전에 Hermes Agent 사용법에서 운영 기준부터 점검해 보자.
쫑대표의 딸깍일기는 자신의 경험과 구독자 사례를 바탕으로 피할 일을 일곱 가지로 정리했다. 영상의 운영 제안을 2026년 11월 10일 확인한 공식 문서·연구와 대조했다. 직접 비용 절감이나 성능 개선을 측정한 실험은 아니며, 연구에서 나온 비율도 모든 업무에 그대로 적용되는 수치는 아니다.
1. 에이전트를 늘리기 전에 하나로 작업을 끝내 본다
총괄·조사·디자인·작성 봇을 먼저 만들면 조직도는 그럴듯하다. 하지만 결과를 다음 담당자에게 누가 넘기는지, 중간에 막히면 누가 확인하는지 정하지 않았다면 사용자가 계속 전달자가 된다.
처음에는 에이전트 하나에 목표·입력 자료·완료 기준을 주고 실제 산출물까지 받아보자. 반복하는 절차는 스킬로 정리하고, 별도 역할이 필요한 부분이 확인되면 분리를 검토하는 순서다.
여러 에이전트가 늘 불리한 것은 아니다. Google Research의 연구 소개는 180개 구성을 비교했다. 병렬화하기 좋은 과업에서는 이점이 있었지만, 순차 계획 과업인 PlanCraft에서는 시험한 다중 에이전트 방식의 성능이 단일 방식보다 떨어졌다고 보고한다. 같은 결과를 모든 업무의 성능 하락으로 확대해서는 안 된다.
Anthropic의 다중 에이전트 연구 시스템도 독립적인 조사 방향을 병렬로 탐색하는 이점을 설명한다. 동시에 자사 데이터에서 일반 채팅 대비 에이전트는 약 4배, 다중 에이전트는 약 15배의 토큰을 사용했다고 적었다. 15배의 비교 기준은 단일 에이전트가 아니라 채팅이다. 현재 Hermes의 비용이 반드시 이 배수로 늘어난다는 뜻도 아니다.
스킬을 먼저 정리하자는 제안 역시 만능 공식은 아니다. 단일 에이전트와 스킬을 다룬 기술보고서는 일부 추론 벤치마크에서 효율 개선 가능성을 보였지만, 의미가 비슷한 스킬이 늘어나면 선택이 어려워질 수 있다는 한계도 다룬다. 스킬 수보다 역할과 적용 조건을 구분하는 일이 먼저다.
출처: 쫑대표의 딸깍일기, Hermes 운영 점검 06:48. 처음부터 에이전트를 늘리는 상황을 설명한 개념도. 에이전트 수만으로 성능·비용 효과가 결정된다는 실험 결과는 아니다. 해설·비평 목적의 장면 인용.
2. 봇끼리 대화시키기보다 작업 인계 방식을 정한다
봇들이 서로 말을 주고받는 모습과 일을 정확히 넘기는 것은 다르다. 보낸 메시지를 상대가 받았는지, 필요한 자료에 접근했는지, 결과물이 생성됐는지를 따로 확인해야 한다.
Hermes Kanban은 작업·담당·상태·인계 기록을 남기는 방식이다. 짧은 독립 과업의 위임과 달리 재시도나 검토 이력을 관리해야 하는 일에 활용할 수 있다. 카드가 완료로 바뀌었다는 사실만으로 결과물의 품질까지 보장되는 것은 아니다.
처음 맡길 때는 아래처럼 요청을 구체화해 보자. 영상의 문장을 그대로 복제한 것이 아니라 작업 계약을 명확하게 만든 예시다.
목표: 제공한 자료로 주간 운영 보고서 초안을 만든다.
담당: 이번 작업을 맡은 에이전트 한 명이 최종본을 정리한다.
입력: 최신 자료와 작성 기준을 먼저 확인한다.
산출물: 보고서 초안, 사용한 출처, 확인하지 못한 사항을 구분한다.
완료 기준: 요청 항목이 모두 있고 출처와 수치가 원자료에 연결된다.
예외: 자료가 없으면 추정하지 말고 막힌 항목과 필요한 입력을 보고한다.
승인: 외부 발송이나 공개 업로드는 하지 않고 검토를 기다린다.
봇 간 통신이 무조건 불가능한 것은 아니다
여기서는 기본 차단 원칙과 선택적 통신 기능을 구분해야 한다. Telegram의 일반 FAQ에는 봇 간 메시지를 막는 설명이 있다. 반면 현재의 봇 간 통신 전용 문서는 모드 설정과 메시지 유형에 따른 조건부 통신을 설명한다. 그룹의 멘션·답장 조건과 개인 대화의 조건도 같지 않다.
Hermes도 현재 Desktop Bot Mode에서 멘션 위임과 그룹 대화를 안내한다. 따라서 ‘봇 간 전달은 모두 요청 단계’라거나 ‘칸반만 가능하다’고 일반화하지 않는 편이 정확하다. 설치 버전·대화 방식·연결 플랫폼에 따라 확인할 조건이 다르다.
통신이 된다고 무한 대화를 허용할 이유도 없다. 반복 메시지 차단, 종료 조건, 최대 반복·대기 시간, 최종 보고 담당을 정해두자. 또한 칸반 화면을 만든 것과 외부에 공개해도 되는 고정 링크를 만든 것은 별개다. 공유 범위와 인증부터 확인해야 한다.
출처: 쫑대표의 딸깍일기, Hermes 운영 점검 08:58. 칸반 방식의 설명 그림이며 실제 Hermes 대시보드 캡처는 아니다. 카드 상태와 결과물 검증은 별개다. 해설·비평 목적의 장면 인용.
3. 맥락과 규칙을 지우기 전에 원인부터 진단한다
대화가 길어졌다고 모든 문제가 맥락 때문인 것은 아니다. 실제 사용 모델이 바뀌었거나 필요한 도구·스킬이 빠졌을 수도 있고, 압축 과정에서 중요한 조건이 요약됐을 수도 있다.
Chroma의 Context Rot 연구는 18개 모델을 대상으로 입력 길이에 따른 비균일한 성능 변화를 살폈다. 이는 긴 입력을 주면 항상 실패한다는 뜻이 아니다. Anthropic의 맥락 관리 안내 역시 짧게 쓰는 것 자체보다 필요한 정보를 충분히 담은 고신호 맥락을 구성하는 데 초점을 둔다.
Hermes 공식 품질 진단 가이드는 실제 모델·제공자, 맥락 사용량, 감지된 맥락 한도, 메모리 반영 시점, 스킬·도구와 압축 영향을 함께 확인하도록 안내한다.
따라서 ‘기억 파일을 싹 지워줘’보다는 먼저 진단을 요청하자.
현재 상태를 변경하지 말고 답변 품질이 달라진 원인을 진단해라.
실제 사용 모델·제공자, 맥락 사용량, 필요한 도구와 스킬의 존재를 확인해라.
오래된 기준, 중복 규칙, 서로 충돌하는 지시가 있는지 근거를 찾아라.
확인된 사실과 추정을 구분하고 비밀값은 보고서에 노출하지 마라.
각 문제의 영향과 최소 수정안을 제시해라.
삭제·압축·설정 변경은 먼저 실행하지 말고 내 검토를 기다려라.
이 요청 역시 블로그의 재구성 예시다. 자동으로 원인이 발견되거나 성능이 회복된다는 보장은 아니다. 특히 메모리 저장과 현재 세션의 반영 시점은 구분해야 한다. 공식 문서는 세션 시작 시 주입되는 메모리 스냅샷과 디스크에 저장된 최신 상태가 다를 수 있음을 설명한다.
출처: 쫑대표의 딸깍일기, Hermes 운영 점검 17:55. 상태와 규칙을 점검하는 제안이다. 문서 삭제나 자동 정리가 성능을 회복시킨다는 보장은 아니다. 해설·비평 목적의 장면 인용.
4. 실행 장비는 맡길 작업과 모델 위치를 보고 고른다
외부 API로 모델을 호출하는 경우와 내 컴퓨터에서 모델을 직접 실행하는 경우는 자원 요구가 다르다. 브라우저를 여러 개 띄우거나 이미지·영상 처리를 하는 작업도 별도로 봐야 한다.
따라서 ‘Hermes에는 특정 용량의 RAM과 GPU가 필수’라는 식으로 구매 기준을 고정하기는 어렵다. 먼저 아래 항목을 적어보자.
모델 추론은 외부 서비스에서 하는가, 이 장비에서 하는가.
브라우저와 파일 처리 도구를 얼마나 함께 사용하는가.
작업이 계속 돌아가야 하는가, 필요할 때만 실행해도 되는가.
절전·재부팅·네트워크 단절이 발생하면 어떻게 확인할 것인가.
실제 작업 중 메모리·디스크·응답 속도에서 무엇이 부족한가.
원격으로 접속하는 기기마다 모델 실행용 장비를 마련할 필요도 없다. 실행 서버와 접속용 노트북·휴대전화의 역할을 구분할 수 있다. 다만 남는 컴퓨터라는 이유만으로 회사 자료나 개인 계정을 무제한으로 연결하는 것은 피하자. 권한과 저장 범위를 먼저 정해야 한다.
5. 실행 환경과 자료 보관·백업을 따로 설계한다
에이전트가 실행되는 장소, 작업 자료가 쌓이는 장소, 복구용 사본을 보관하는 장소는 같은 문제가 아니다. 한 컴퓨터에서 모든 것을 운영할 수는 있지만, 그 컴퓨터가 고장 났을 때 무엇을 복구해야 하는지는 정해두어야 한다.
백업 대상도 보고서 파일만으로 끝나지 않는다. 자신의 구성에 따라 기억·스킬·설정·작업 원본·상태 데이터가 포함될 수 있다. 자격증명처럼 민감한 정보는 보관 권한과 보호 방법을 따로 검토하자.
다음은 특정 업체를 추천하는 대신 적용해 볼 수 있는 백업 운영안이다.
복구해야 할 파일과 상태 데이터의 목록을 만든다.
동시 쓰기 중인 상태 데이터는 일관된 방식으로 사본을 확보한다.
원본 장비의 장애와 별개로 남는 사본을 둔다.
복구에 필요한 비밀정보의 접근 권한을 제한한다.
사본이 있다는 확인에 그치지 않고 복원 절차를 시험한다.
동기화도 백업과 구분해야 한다. 잘못 삭제하거나 덮어쓴 상태가 그대로 전파될 수 있기 때문이다. 영상의 특정 저장 장비나 클라우드 업체 선택을 모든 사람에게 가장 저렴하거나 안전한 구성으로 받아들일 필요는 없다.
6. 여러 기기를 연결하는 것과 상태를 동기화하는 것을 구분한다
영상에서는 실행 장비와 자료 저장소를 나누고 다른 기기에서 접속하는 개인 구성을 보여준다. 이때 Tailscale 같은 사설 네트워크 연결은 기기가 서로 접근할 경로를 만드는 역할이다. 그 자체가 모든 파일·기억·세션을 같은 상태로 맞추는 기능은 아니다.
다음 네 가지를 따로 적어두면 혼동이 줄어든다.
실행 주체: 실제 에이전트와 작업 프로세스가 돌아가는 곳
자료 원본: 최종 기준 파일을 보관하는 곳
접속 창구: 지시하고 결과를 확인하는 앱이나 메시징 채널
복구 사본: 장애 후 되돌릴 수 있는 백업
처음에는 실행 주체와 원본 위치를 명확하게 두고 다른 기기에서 접속하는 구성을 검토해 볼 수 있다. 그렇다고 여러 설치가 모두 잘못이라는 뜻은 아니다. 별도 사용자나 업무를 분리해야 한다면 목적에 맞는 구성이 필요하다.
Hermes 프로필 문서는 독립 에이전트의 상태를 프로필로 나누고, 같은 상태 폴더를 여러 에이전트의 동시 쓰기 대상으로 삼지 말라고 경고한다. 프로필을 나누는 것과 운영체제 파일 권한까지 격리하는 것도 별개다. 고객·팀 자료를 구분해야 한다면 보안 경계를 따로 설계해야 한다.
출처: 쫑대표의 딸깍일기, Hermes 운영 점검 13:50. 제작자의 기기 역할 분리 예시. 이 그림만으로 파일 동기화·권한 설정·백업 복원이 검증되는 것은 아니다. 해설·비평 목적의 장면 인용.
7. 새로 만드는 일과 반복 운영을 나누되 기능의 한계로 단정하지 않는다
진행자는 서비스를 만드는 일에는 Claude·Codex를, 만들어진 서비스를 매일 사용하는 일에는 Hermes를 쓰는 방식을 제안한다. 개발과 운영을 분리하는 실무 전략으로 볼 수 있다.
하지만 Hermes가 코딩을 못한다는 뜻은 아니다.공식 소개도 코딩과 도구 실행, 위임, 스킬과 일정 기반 자동화를 포함한다. 맡길 일을 나누는 이유는 제품 이름보다 테스트·배포·권한·실행 환경과 결과 확인 방식에 있다.
새로운 기능을 만든다면 코드와 테스트, 설정 방법, 필요한 권한, 실패 시 복구 방법까지 정리하자. 이후 운영 담당에게는 안정된 실행 절차와 상태 확인 방법을 넘긴다. ‘만들었다’는 말만 듣고 반복 실행에 연결하지 않는 편이 좋다.
또한 스킬과 기억이 쌓인다는 설명을 모델 가중치가 자동으로 재훈련된다는 뜻으로 읽지는 말자. 재사용할 절차와 기준을 문서화하는 것, 모델 자체를 학습시키는 것은 서로 다른 과정이다.
처음에는 작은 작업 하나의 완료 기준부터 정한다
봇을 더 만들지, 더 큰 컴퓨터를 살지 고민하기 전에 지금 맡기는 작업 하나를 골라보자. 입력·산출물·확인 방법이 적혀 있고, 실패했을 때 어디서 멈췄는지 알 수 있는가.
그 흐름이 잡혀 있다면 반복 절차를 스킬로 정리하고 필요한 부분만 나누면 된다. 영상에서 가져갈 만한 운영 원칙도 이쪽에 가깝다. 에이전트의 수나 대화량을 늘리는 것보다, 일을 맡기고 결과를 확인할 수 있는 구조를 먼저 만드는 것이다.
캡처는 원본 영상의 운영 제안을 설명·비평하기 위해 인용했다. 화면의 개념도는 실제 대시보드나 독립 실행 실험의 증거가 아니다. 구독자 대화 분석은 제작자의 자체 사례 검토이며 전체 사용자를 대표하는 통계로 보지 않았다. 모임·멤버십 안내, 특정 업체의 최저가 주장과 향후 모델 출시 전망은 검증된 운영 사실로 인용하지 않았다.
FAQ
처음부터 Hermes 봇을 여러 개 만들어야 하나요?
그럴 필요는 없다. 하나로 작업을 끝내 보고 반복 절차를 스킬로 정리한 뒤, 독립적인 조사·역할·자료 범위가 필요할 때 분리를 검토할 수 있다. 여러 에이전트가 유리한지는 과업의 병렬성, 인계 비용, 검증 방식에 따라 달라진다.
Telegram이나 Hermes의 봇끼리 대화하는 것은 불가능한가요?
무조건 불가능하지는 않다. Telegram은 선택적 통신 모드와 메시지 유형·대화 환경에 따라 조건을 달리한다. Hermes Desktop Bot Mode도 멘션과 그룹 대화를 제공한다. 다만 서로 메시지를 주고받는 것과 업무를 정확하게 인계·완료하는 것은 별개다.
Hermes를 쓰려면 고사양 컴퓨터를 사야 하나요?
모델을 어디서 실행하고 어떤 도구를 함께 쓰는지에 따라 다르다. 외부 모델 호출, 로컬 모델 실행, 브라우저·영상 처리는 요구 자원이 같지 않다. 실제 작업의 병목을 확인한 뒤 장비 변경을 검토하는 편이 낫다.
답변이 나빠지면 기억 파일과 규칙을 지워야 하나요?
삭제부터 하지 말자. 실제 모델·제공자, 맥락 상태, 필요한 스킬·도구, 압축 영향과 충돌 규칙을 먼저 확인한다. 근거와 최소 수정안을 검토한 뒤 변경하고, 필요한 경우 되돌릴 수 있는 사본을 남긴다.
Claude와 Codex를 동시에 켜두면 누가 어느 파일을 고치는지 금방 헷갈린다. 창을 더 여는 일보다 작업을 나누고, 결과를 받아서, 변경 내용을 확인하는 일이 더 어려워진다. Orca 사용법을 익힐 때도 터미널 분할과 작업 조율을 구분해서 보는 편이 좋다.
코드팩토리의 영상은 Orca에서 여러 에이전트를 실행하고 브라우저·Git·원격 컴퓨터로 작업을 이어가는 흐름을 보여준다. 2026년 11월 5일 업로드된 영상과 11월 9일 확인한 공식 문서를 대조해, 따라 할 순서와 달라진 안내를 정리했다. 직접 Orca를 설치해 속도나 안정성을 재현한 벤치마크는 아니다.
Orca는 새 AI 모델이 아니라 코딩 에이전트의 작업환경이다
Orca 공식 소개는 제품을 여러 AI 코딩 에이전트를 나란히 운용하는 데스크톱 IDE로 설명한다. Claude Code나 Codex 같은 도구를 하나의 작업환경에서 다루고, Git 작업트리와 터미널·브라우저를 함께 관리하는 방식이다.
따라서 Orca를 설치했다고 Claude나 Codex의 계정·구독이 새로 생기지는 않는다. 사용할 에이전트의 설치와 인증은 별도로 확인해야 한다. 계정 전환과 사용량 표시도 해당 서비스의 할당량이나 이용 조건을 없애는 기능은 아니다.
영상에서 진행자는 무거운 작업을 할 때 Herdr가 자신에게 더 잘 맞았다고 설명한다. 이는 개인의 사용 경험이다. Orca가 항상 불안정하다거나, GUI가 있는 도구가 언제나 느리다는 비교 실험으로 읽을 필요는 없다.
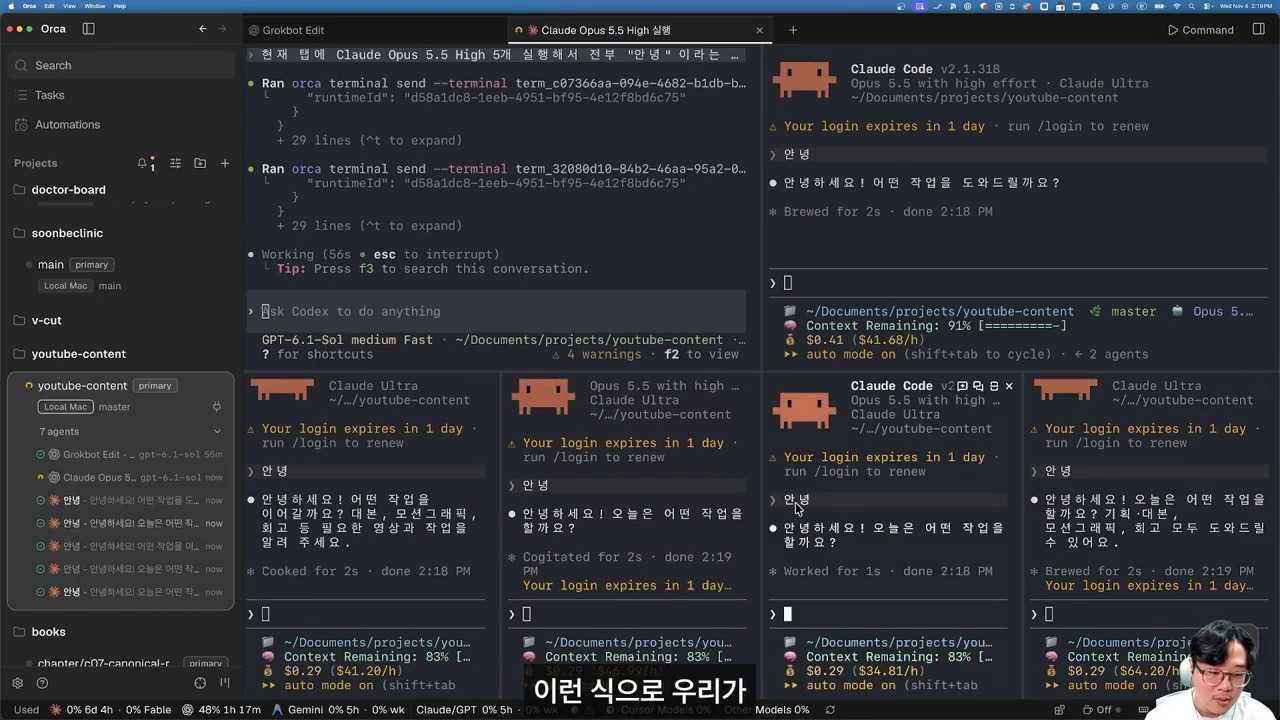
출처: 코드팩토리, Orca 사용 시연 05:30. 여러 터미널을 여는 시연. 패널 수나 활동 표시는 성능 향상·작업 완료의 검증 결과가 아니다. 해설·비평 목적의 장면 인용.
특히 네 번째를 건너뛰지 말자. 지원 에이전트 문서는 새 실행에 권한 확인을 우회하는 인자가 미리 채워질 수 있다고 안내한다. 처음부터 모든 명령을 자동 승인해도 안전하다고 가정해서는 안 된다.
설정의 Agents → Agent Permissions에서 Manual 모드를 검토하자. 기존 세션이나 직접 수정한 실행 인자는 전역 설정과 다를 수 있다. 모드를 바꿨다는 사실만 확인하지 말고 실제 실행 설정도 함께 봐야 한다.
Git 작업트리는 보안 샌드박스가 아니다.Git 공식 문서가 설명하는 작업트리는 같은 저장소에서 여러 작업 디렉터리를 운용하는 기능이다. 파일 변경을 나눌 수 있지만, 그것만으로 에이전트의 운영체제 접근 권한이 제한된다고 볼 수는 없다. Codex의 경우에도 샌드박스와 승인 정책은 별도로 확인할 항목이다.
터미널 여러 개와 오케스트레이션은 어떻게 다른가
여러 터미널을 열고 각각 프롬프트를 보내는 방법은 간단하다. 대신 누가 끝났는지, 어디서 막혔는지, 어느 결과를 다음 작업에 넘길지 사람이 직접 관리해야 한다.
Orca의 오케스트레이션은 그 조율을 구조화하는 기능이다. 영상의 Run·Task·Worker에 더해, 현재 문서의 Dispatch도 알아두면 상태를 읽기 쉽다.
Run: 협업 기록과 조율자의 수신함을 묶는 지속성 있는 단위다. Run 자체가 워커를 자동 배치하는 스케줄러는 아니다.
Task: 목표·의존 관계·상태를 가진 개별 작업이다.
Worker: 배정된 작업을 수행하는 에이전트다.
Dispatch: 어떤 터미널에서 그 작업을 수행하는지 식별하는 한 번의 실행 시도다.
같은 Task를 재시도할 수 있으므로 작업 ID와 실행 시도를 구분해야 한다. 현재 공식 문서는 워커의 완료·상태 보고에 Task와 Dispatch 식별자를 함께 사용하도록 안내한다. 오래된 실행의 보고를 새 시도의 완료로 착각하지 않기 위한 구분이다.
영상의 메뉴와 명령을 그대로 복사하지 않는다
11월 9일 확인한 오케스트레이션 문서는 과거의 orchestration run 계열 명령을 실제 동작하지 않는 구형 명령으로 안내한다. 현재 흐름은 run-create, task-create, worker-start 등을 사용한다.
문서에는 Experimental 활성화 안내와 함께 패널·스위치가 일시적으로 제공되지 않는다는 고지도 있다. 영상과 같은 버튼이 보이지 않는다면 먼저 설치 버전과 현재 스킬 안내를 확인하자.
다음은 실행 중인 Orca와 현재 오케스트레이션 스킬을 확인하는 공식 문서의 명령이다. macOS·Windows의 orca 이름을 기준으로 적었다. Linux 설치 문서는 CLI 이름을 orca-ide로 안내하므로 해당 환경에서는 명령 이름을 바꿔 확인해야 한다.
orca status --json
orca skills get orchestration --full
첫 명령은 실행 중인 Orca 런타임에 연결할 수 있어야 한다. 이 두 줄을 실행하는 것만으로 워커가 생성되거나 프로젝트 검토가 시작되는 것은 아니다.
첫 협업은 두 에이전트의 읽기 중심 검토로 시작해 본다
처음부터 두 에이전트가 같은 파일을 고치게 하면 변경 충돌부터 다뤄야 할 수 있다. 먼저 같은 프로젝트를 서로 다른 관점에서 검토시키고, 보고서를 받은 뒤 구현 담당을 정해보자.
다음은 영상의 역할 분담 방식을 바탕으로 재구성한 요청 예시다. Claude와 Codex의 능력을 고정적으로 나눈다는 뜻은 아니다. 모델별 역할과 실제 도구 권한은 자신의 환경에 맞춰 정하면 된다.
현재 설치된 Orca 오케스트레이션 스킬을 먼저 읽어라.
현재 열린 프로젝트에서 두 개의 검토 Task를 만들고 각각 워커에게 배정해라.

공통 제한:
- 코드와 설정 파일을 수정하지 않는다.
- 배포, 커밋, 외부 공유 설정 변경을 하지 않는다.
- 추가 실행이나 권한이 필요하면 먼저 보고한다.

Claude 워커:
- 화면 구성, 사용 흐름, 접근성 관점에서 문제를 찾는다.

Codex 워커:
- 입력 검증, 오류 처리, 테스트 누락 관점에서 문제를 찾는다.

각 워커는 파일 위치, 근거, 심각도, 확인하지 못한 사항을 보고한다.
조율자는 Task와 Dispatch를 구분해 두 워커의 보고를 받는다.
중복 의견과 충돌하는 의견을 나누고, 구현에 앞서 우선순위를 제시한다.
프롬프트에 ‘수정하지 말라’고 쓰는 것과 기술적으로 쓰기 권한을 제한하는 것은 다르다. 앞서 확인한 CLI 권한·샌드박스 설정도 함께 적용해야 한다.
두 보고서가 돌아왔다면 의견 수만 합치지 말자. 같은 문제를 다른 말로 썼는지, 실제 파일에서 확인되는지, 검토 범위 밖의 추측은 없는지 확인한다. 구현은 그다음이다.
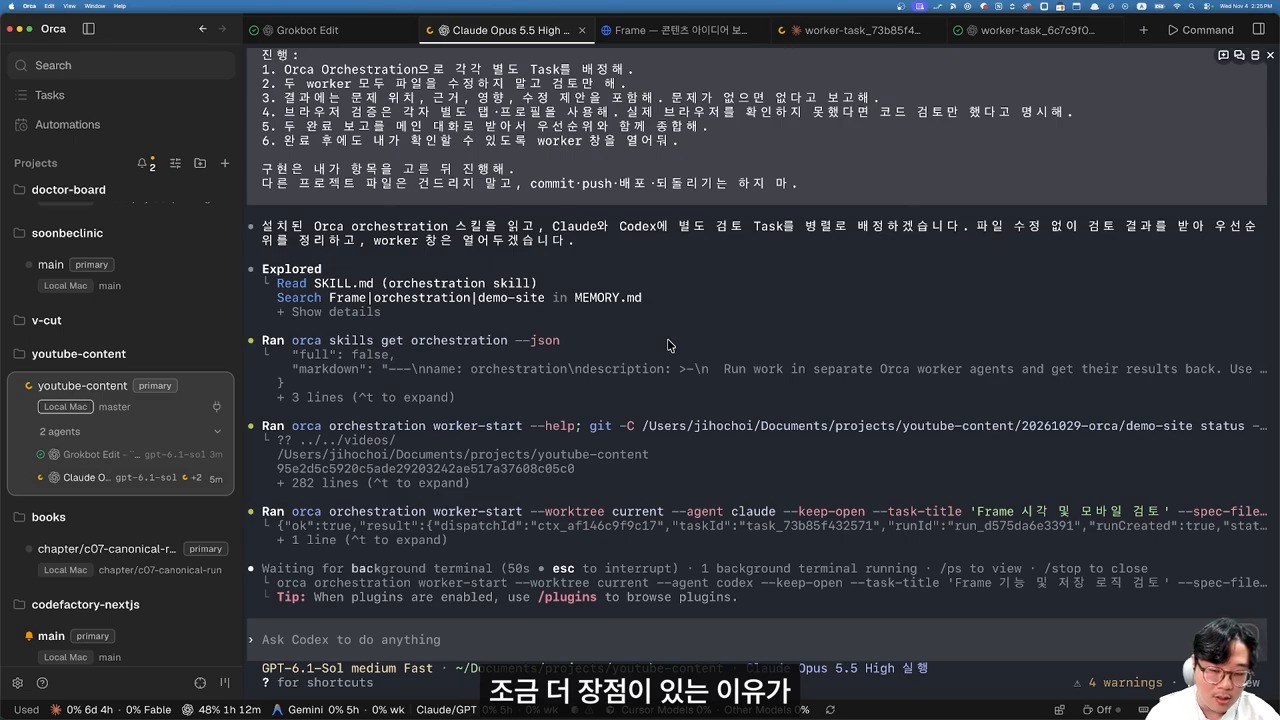
출처: 코드팩토리, Orca 사용 시연 08:10. 역할 분담과 보고 구조를 보여주는 당시 시연. 화면 속 명령·메뉴는 현재 공식 문서와 다를 수 있다. 해설·비평 목적의 장면 인용.
브라우저 주석은 수정할 대상을 구체적으로 전달하는 도구다
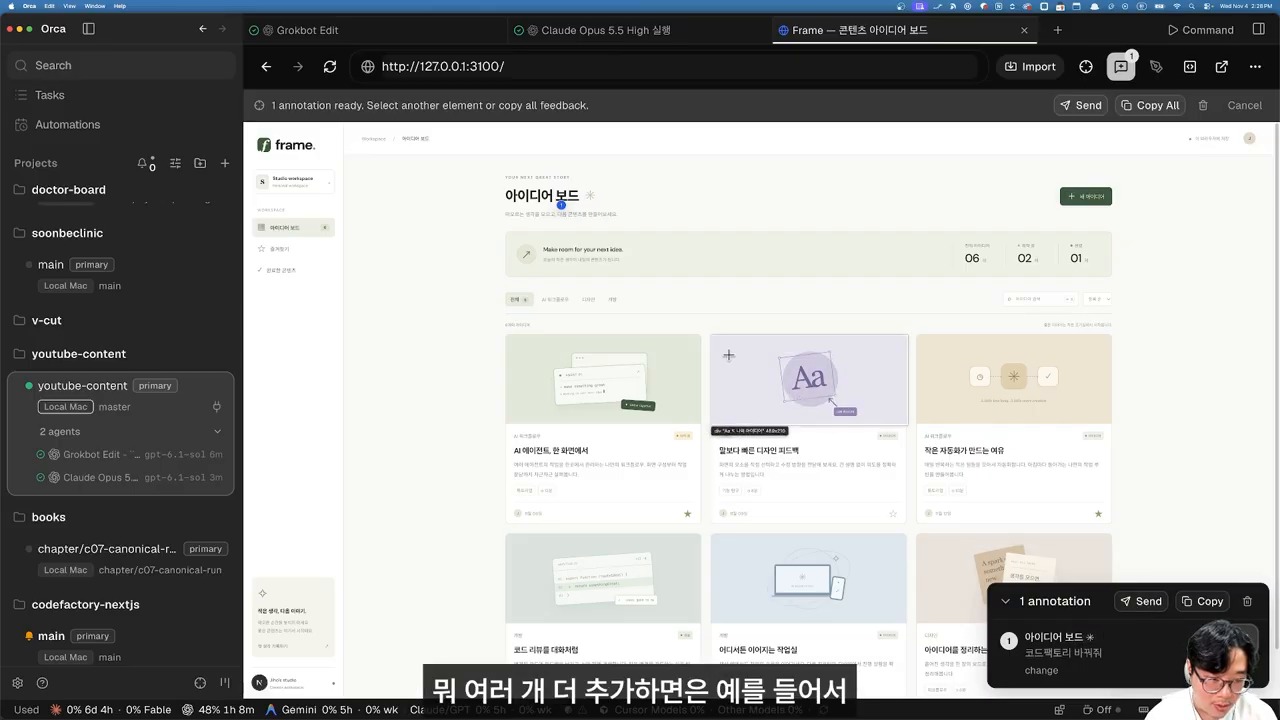
영상에서는 웹페이지의 제목을 선택하고 변경 요청을 붙인다. ‘저 글자’라고 설명하는 대신, 실제 요소를 가리켜 에이전트에 전달하는 방식이다.
현재 Design Mode 문서는 요소의 DOM·CSS·크롭 이미지 등의 맥락을 활용할 수 있다고 설명한다. 소스맵이 제공되는 환경에서는 파일·줄 정보도 얻을 수 있다. 다만 전송 메뉴의 기본 요약과 전체 페이지 정보를 포함하는 옵션은 구분해야 한다.
이 기능을 쓸 때는 다음 순서로 확인해 보자.
작업 중인 페이지와 개발 서버가 정상적으로 열리는지 확인한다.
바꿀 요소를 선택하고 원하는 결과를 구체적으로 적는다.
올바른 에이전트·프로젝트로 요청을 보낸다.
수정된 파일과 화면을 각각 확인한다.
다른 화면 크기와 관련 동작도 확인한다.
주석을 보냈다고 코드 수정이 끝난 것은 아니다. 제목이 바뀌었더라도 저장 여부나 다른 기능의 정상 동작까지 증명되지는 않는다.
출처: 코드팩토리, Orca 사용 시연 10:45. 샘플 웹페이지에 수정 의견을 붙이는 장면. 주석 전송과 실제 파일 수정·저장·테스트는 구분해야 한다. 해설·비평 목적의 장면 인용.
Git 변경 내용과 완료 기준을 마지막에 남긴다
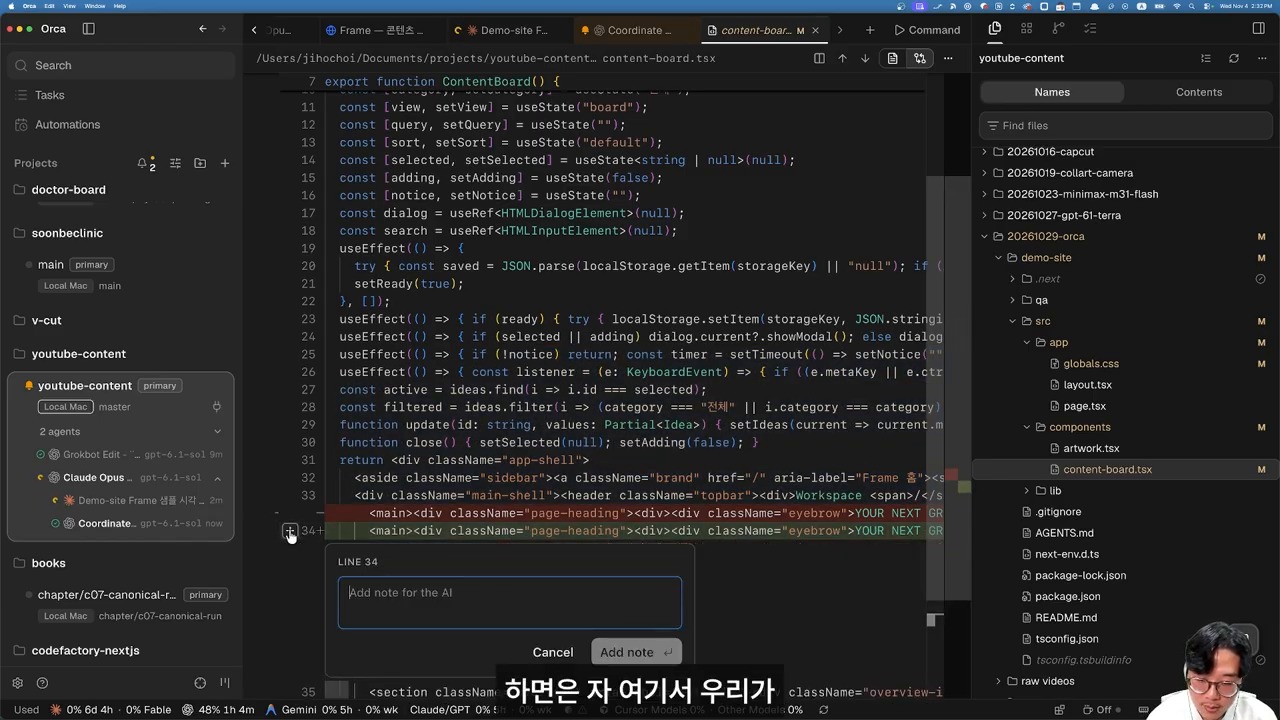
Orca에서는 변경된 파일을 보고 코드의 특정 줄에 메모를 붙이는 작업도 할 수 있다. 영상의 해당 장면은 AI에게 지시한 뒤에도 사람이 변경 내용을 확인할 지점이 남는다는 것을 보여준다.
여러 에이전트가 코드를 수정한다면 작업트리와 수정 범위를 의도적으로 나누자. 터미널을 추가했다는 이유만으로 모든 워커가 서로 다른 작업 디렉터리에 있는 것은 아니다. 같은 파일을 동시에 바꿀 가능성이 있으면 분리 방식부터 정해야 한다.
최종 확인 담당도 지정해 두면 좋다. 아래 항목은 블로그의 운영 제안이다.
요청한 변경과 관계없는 파일이 섞이지 않았는가.
테스트를 실제로 실행했는가, 실행하지 못했다면 이유가 있는가.
브라우저에서 확인한 범위와 확인하지 못한 범위가 나뉘어 있는가.
다른 워커의 변경과 충돌하지 않는가.
병합·배포 전에 사람이 승인해야 할 사항이 남아 있지 않은가.
사이드바의 완료 표시나 워커의 ‘끝났다’는 보고는 확인의 출발점이다. 정확한 수정과 테스트 통과를 대신하는 증거로 쓰지는 말자.
출처: 코드팩토리, Orca 사용 시연 12:26. 코드 변경부에 메모를 추가하는 시연. diff 검토와 테스트, 최종 병합은 별도 확인 단계다. 해설·비평 목적의 장면 인용.
원격 연결은 SSH 작업트리와 Remote Orca Server를 구분한다
영상 후반에는 다른 컴퓨터를 연결하는 방법이 나온다. 여기서는 원격 기능을 모두 ‘SSH 연결’ 하나로 묶지 않는 것이 중요하다.
SSH 작업트리: 내 컴퓨터의 Orca가 런타임을 소유하고, 다른 컴퓨터에서 선택한 작업트리·터미널을 실행하는 방식이다.
Remote Orca Server: 다른 컴퓨터가 Orca 런타임과 세션을 소유하고, 내 컴퓨터는 그 서버의 화면과 작업에 연결하는 방식이다.
노트북을 덮어도 작업을 이어가려면 이 차이를 확인해야 한다. Remote Orca Server 방식에서는 서버가 켜져 있고 Orca 프로세스와 네트워크가 유지되어야 한다. 에이전트 CLI·저장소·인증 정보도 서버에 필요하다. 노트북에서 로그인했다고 서버 인증까지 자동으로 준비되는 것은 아니다.
공식 안내는 신뢰할 수 있는 LAN이나 Tailscale 같은 사설 경로를 권장한다. Orca 포트를 인터넷에 직접 공개하는 방식은 피하자. 페어링 링크는 런타임 접근 권한을 주므로 비밀번호처럼 다루고, 잘못 공유했다면 서버의 접근 권한을 철회해야 한다.
모바일과 계정 관리는 편의 기능의 범위를 확인한다
모바일 안내는 현재 동반 앱을 베타로 설명한다. 상태 확인, 짧은 응답, 변경 내용 확인 등을 휴대전화에서 이어갈 수 있지만 연결 대상 Orca 런타임이 필요하다. 휴대전화가 독립적으로 같은 개발 환경을 실행하는 것은 아니다.
진행자가 모바일 사용을 선호하지 않는다는 평가는 자신의 작업 방식에 따른 의견이다. 긴 코드를 검토할지, 상태만 볼지에 따라 필요한 기능은 달라진다. 데스크톱·서버·모바일 사이의 버전 호환성도 확인하자.
로컬에 프로젝트를 둔다고 모든 AI 처리가 로컬에서 끝나는 것도 아니다. 연결한 모델 공급자와 외부 서비스의 자료 처리 정책은 별도로 검토해야 한다. Orca 자체의 텔레메트리 안내도 공급자의 설명이며, 연결된 모든 도구에 대한 독립 보안감사를 뜻하지는 않는다.
에이전트 수를 늘리기 전에 보고 형식을 고정해 둔다
반복해서 사용하는 작업이라면 역할·허용 범위·보고 형식을 스킬이나 작업 지침에 남겨두자. 읽기 중심 검토인지, 수정까지 허용하는지, 무엇을 근거로 완료라고 판단할지부터 정하면 된다.
Orca를 처음 쓸 때의 목표를 많은 창을 여는 것으로 잡을 필요는 없다. 작은 작업 하나에서 역할 배정, 보고 수신, 변경 검토까지 이어지는지를 먼저 확인해 보자. 그 흐름이 잡힌 뒤에 병렬 구현과 원격 실행을 늘려도 늦지 않다.
와인의 향에 콜라의 단맛과 탄산이 더해지는 조합이다. 영상 제작자는 저렴한 와인에서 아쉽게 느낀 부분과 콜라의 맛이 서로 보완된다고 설명한다. 그러나 어떤 와인과 콜라를 쓰는지, 단맛을 얼마나 좋아하는지에 따라 취향은 달라질 수 있다.
기본 레시피: 레드와인과 콜라 1:1
다음은 기본 비율을 계량하기 쉽게 각 100mL로 정리한 예시다. 원본 영상에서 정확히 이 용량을 계량했다는 뜻은 아니다.
재료
레드와인 100mL
콜라 100mL
얼음
레몬 또는 라임 조각: 선택 사항
얼음과 음료가 들어갈 큰 잔
만드는 순서
잔에 얼음을 넣는다.
레드와인 100mL를 붓는다.
콜라 100mL를 천천히 더한다.
원한다면 레몬이나 라임을 조금 짜 넣거나 조각을 올린다.
가볍게 저어 마무리한다.
처음에는 눈대중으로 잔을 채우기보다 두 재료의 양을 한 번 재보는 편이 좋다. 같은 잔이라도 얼음의 양에 따라 실제로 들어가는 음료의 양이 달라질 수 있기 때문이다.
처음부터 큰 병 전체를 섞을 필요도 없다. 적은 양으로 기본 비율을 확인한 뒤 자신의 취향에 맞는지 판단하자.
맛을 조절할 때는 한 가지씩 바꾼다
첫 잔은 기본 비율로 만들고, 다음에 바꿀 항목을 하나씩 정해보자. 아래는 취향을 확인하기 위한 적용 제안이지, 모든 조합을 직접 시음해 순위를 매긴 결과가 아니다.
너무 달게 느껴진다면: 콜라의 양을 조절해 볼 수 있다. 다만 기본 1:1 레시피와는 다른 배합이 된다.
산미를 더하고 싶다면: 레몬이나 라임을 조금씩 추가한다. 한 번에 많이 넣기보다 필요한 만큼만 더한다.
제로 콜라를 쓰고 싶다면: 바꿔 사용할 수 있지만 일반 콜라와 맛이 같다고 전제하지 않는다. 당류 표시가 달라도 알코올이 없어지는 것은 아니다.
맛이 계속 달라진다면: 재료의 온도와 얼음이 녹는 정도도 함께 본다. 처음 섞은 비율과 시간이 지난 뒤의 희석 상태는 다를 수 있다.
특정 품종이나 고가의 와인을 반드시 사야 하는 레시피로 볼 필요는 없다. 그렇다고 가장 저렴한 제품이 언제나 가장 잘 맞는다는 뜻도 아니다. 가격보다 자신의 입맛과 배합을 기준으로 판단하는 편이 낫다.
콜라를 섞으면 도수와 알코올 양은 어떻게 달라질까
도수와 마신 알코올 총량은 구분해야 한다. 도수 12%인 레드와인 100mL에 알코올이 없는 콜라 100mL를 섞는 경우를 계산해 보자.
와인에 들어 있는 순알코올 부피: 12mL
혼합 음료의 부피: 약 200mL
얼음·레몬에 의한 추가 희석 전 계산 도수: 약 6%
이는 부피를 단순히 더한 계산 예시다. 실제 제품의 도수, 얼음이 녹은 양, 추가한 재료에 따라 완성된 음료의 도수는 달라질 수 있다. 실험실에서 측정한 수치도 아니다.
중요한 점은 그 잔을 모두 마시면 원래 넣은 와인 100mL의 알코올을 그대로 섭취한다는 것이다. 콜라는 알코올을 제거하지 않는다. 맛이 부드럽거나 달게 느껴져도 무알코올 음료가 된 것은 아니다.
카페인이 술의 영향을 줄여주지는 않는다
콜라를 선택할 때는 제품의 카페인 표시도 확인할 수 있다. 미국 CDC의 안내는 카페인을 알코올과 함께 섭취해도 알코올이 몸에 미치는 영향이 줄어들지 않는다고 설명한다. 덜 취한 듯 느끼거나 더 활력이 있다고 느끼는 것이 실제로 술의 영향을 없앤다는 뜻은 아니다.
카페인 없는 콜라를 선택하더라도 술에 들어 있는 알코올은 남는다. 이 레시피를 숙취 해소법이나 안전한 음주량을 보장하는 방법으로 받아들이지는 말자.
1972년에 처음 발명된 음료라고 단정할 필요는 없다
Getxo의 공식 소개는 와인과 콜라를 섞는 음료가 1920년대에 이미 존재했다고 설명한다. 칼리모초라는 이름은 1972년 알고르타 구항구의 산니콜라스 축제와 연결해 소개한다.
따라서 ‘1972년에 와인과 콜라를 처음 섞었다’보다는, 그 축제의 일화와 명칭을 통해 널리 알려진 음료로 이해하는 편이 정확하다.
유래에는 맛이 좋지 않았던 와인을 활용했다는 이야기도 등장한다. 하지만 그 일화를 오늘날 보관이 불명확하거나 변질이 의심되는 와인을 마셔도 된다는 조언으로 옮겨서는 안 된다. 콜라를 섞는 것은 안전성을 확인하거나 되돌리는 절차가 아니다. 집에서는 보관 상태를 확인할 수 있는 와인을 사용하자.
간단한 배합이지만 ‘덜 취하는 비법’은 아니다
칼리모초의 장점은 복잡한 장비나 많은 재료 없이 기본 비율을 시도할 수 있다는 데 있다. 처음에는 와인과 콜라를 같은 양으로 섞고, 레몬·라임과 단맛은 취향에 맞춰 조절하면 된다.
다만 이 글은 성인을 위한 주류 레시피다. 달고 시원한 맛을 알코올이 적거나 안전하다는 신호로 삼지 말자. 음주 후에는 운전하지 말고, 건강상 이유 등으로 음주를 피해야 하는 경우에는 마시지 않는다.
새 AI가 나올 때마다 도구를 갈아타도, 지난번에 찾은 자료와 검토 기준을 다시 설명하고 있다면 일이 쌓이지 않는다. 모델은 좋아졌는데 사용자는 매번 처음부터 시작하는 셈이다. AI 지식창고가 필요한 이유는 더 많은 파일을 모으기 위해서가 아니라, 검토한 지식과 판단 기준을 다음 작업에서도 쓰기 위해서다.
김작가 TV에 출연한 김덕진은 여러 AI를 같은 개인 지식 폴더에 연결해 활용한다고 말한다. 동시에 AI를 기존 업무에 끼워 넣는 것보다, AI가 제안하는 방식을 배우고 자기 전문성과 결합하는 변화에 주목한다. 이 대담을 실무에 옮길 때 남는 질문은 ‘어느 모델이 1등인가’보다 ‘모델이 바뀌어도 무엇을 남길 것인가’다.
새 모델의 충격과 업무 방식의 변화는 구분하자
영상은 아스트라의 등장을 알파고 제로에 비유한다. 출연자가 느낀 변화의 크기를 설명하는 표현이다. 두 시스템을 같은 조건에서 비교한 벤치마크나, 모든 업무에서 같은 생산성 향상이 난다는 증거는 아니다.
바둑 비유의 사실관계도 분명하게 읽을 필요가 있다. AlphaGo Zero의 Nature 논문은 인간 기보 없이 자기대국으로 학습했지만 바둑의 규칙은 주어졌다고 설명한다. ‘규칙도 모르는 상태에서 스스로 모든 것을 배웠다’와는 다르다. 논문의 100대 0은 이전 알파고 버전과의 프로그램 간 평가이지 인간 기사와의 대국 결과가 아니다.
영상에서 전하는 이세돌·신진서와의 대화와 가상 대결 전망은 김덕진의 설명으로 이해해야 한다. 그 자체를 공식 대국 기록이나 독립 성능 평가로 옮기지는 않았다.
출처: 김작가 TV, 김덕진 인터뷰 02:20. 바둑을 비유로 AI 학습을 설명하는 장면. 개별 기사와의 대화 일화를 공식 대국 기록으로 제시하지 않는다. 해설·비평 목적의 장면 인용.
비유에서 가져올 만한 부분은 있다. 익숙한 방식으로 AI의 답을 재단하는 데서 멈추지 않고, 왜 다른 접근을 제안했는지 살펴보는 태도다. 그렇다고 AI의 선택이 늘 정답이므로 무조건 따라야 한다는 뜻은 아니다. 내 분야의 조건과 근거로 비교하는 과정이 필요하다.
AI를 쓰면 모두 비슷해질까, 격차가 커질까
바둑 연구는 한쪽 결론만 보여주지 않는다. 2023년 PNAS 논문의 저자 공개본은 프로 기사들의 기보를 분석해, 초인적 AI 등장 이후 인간의 의사결정 질이 높아지고 새로운 수가 더 자주 나타났다고 보고했다.
반면 2025년 PNAS Nexus 연구는 정석 패턴의 활용을 분석하며 새로운 지식의 발전과 함께 패턴 다양성이 줄어드는 측면을 지적했다. 기존 실력이 높은 기사에게 지식 창출 효과가 더 크게 나타났다는 결과도 제시한다.
이 두 결과를 곧바로 모순이라고 볼 필요는 없다. 새로운 수와 결정의 질을 보는 것, 특정 초반 패턴의 채택과 분포를 보는 것은 측정 대상이 다르다. 더 좋은 결정을 하는 것과 더 다양한 스타일을 갖는 것은 같은 지표가 아니다.
또한 둘 다 전문 바둑이라는 맥락에서 나온 연구다. 이를 근거로 사무직·교육·영업에서도 숙련자가 언제나 더 큰 이득을 얻는다거나, AI를 쓰면 개인의 창의성이 자동으로 늘어난다고 단정할 수는 없다.
실무적으로 가져올 질문은 더 작다. 나는 AI가 내놓은 답의 장단점을 판단할 기준이 있는가. 좋아 보이는 답을 저장하는 데서 끝나는가, 다음번에 왜 그 답을 채택했는지까지 다시 쓸 수 있는가.
기존 일에 AI를 추가하는 것과 업무를 재설계하는 것
회의록 작성에 AI를 추가하는 경우를 생각해 보자. 녹취를 붙여넣고 요약을 받은 뒤, 사람이 다시 항목을 분류하고 담당자를 정한다면 기존 절차의 한 단계만 빨라진 것이다.
업무를 재설계한다면 순서를 다시 볼 수 있다. 회의 전에 필요한 결정과 확인 항목을 정하고, 회의 후에는 결정·보류·추가 확인을 구분한다. AI는 근거가 있는 초안을 만들고, 사람은 잘못 묶인 항목과 책임 범위를 확인한다. 검토가 끝난 결과는 다음 회의의 기준으로 남긴다.
이는 설명을 위한 적용 예시다. 영상에서 그대로 시연한 자동화나, 시간을 측정해 효과를 입증한 절차는 아니다.
출처: 김작가 TV, 김덕진 인터뷰 07:20. AI와 일하는 방식에 관한 출연자의 견해. 특정 모델의 독립 성능 검증은 아니다. 해설·비평 목적의 장면 인용.
기존 업무를 모두 버릴 필요도 없다. 먼저 반복해서 쓰는 자료와 오류가 나는 지점, 사람이 책임져야 하는 판단을 나눠 보자. 도구를 더 연결하기 전에 무엇을 완료로 볼지 정하면, AI가 만든 결과를 평가하기 쉬워진다.
AI 지식창고는 원본과 검토 결과를 나눠야 한다
김덕진은 자신의 정보·프롬프트·작업 결과를 한 폴더에 모으고 여러 AI와 연결하는 사용 방식을 설명한다. 같은 자료를 기반으로 도구를 바꿔 쓰고, 한 도구의 결과를 다른 도구에 넘기는 것이다.
하지만 같은 폴더에 연결했다고 대화 기억이 자동으로 공유되지는 않는다. 폴더의 모든 파일을 각 AI가 빠짐없이 읽었다고 보장할 수도 없다. 이번 작업에서 무엇을 읽고 어떤 기준을 적용해야 하는지 별도로 알려야 한다.
아래는 이 아이디어를 바탕으로 구성한 가상의 운영안이다. 출연자의 실제 폴더 목록이나 특정 서비스의 기본 구조가 아니다.
원본자료: 보고서·회의록·데이터 등 확인의 출발점이다. 작업 과정에서 임의로 덮어쓰지 않는다.
검토된지식: 출처와 확인일을 붙여 다시 쓸 수 있게 정리한 내용이다. 확정된 사실과 추정을 구분한다.
작업중: 모델이 제안한 초안과 아직 검토하지 않은 결과를 둔다.
완성본: 사람이 승인한 결과다. 어떤 버전의 원본을 사용했는지 남긴다.
운영규칙·변경기록: 문체·형식·금지사항과 변경 이유를 기록한다. 다만 규칙 문서가 실제 파일 접근 권한을 강제하는 것은 아니다.
이 구분이 없으면 AI가 만든 초안이 다음 AI의 근거가 되고, 확인하지 않은 설명이 반복될 수 있다. 파일을 많이 저장하는 것보다 무엇을 믿고 다시 사용할 수 있는지 표시하는 일이 먼저다.
출처: 김작가 TV, 김덕진 인터뷰 15:40. 개인 지식창고를 공유하는 사용 경험의 설명. 특정 앱의 폴더 연동을 이 글에서 재현한 결과는 아니다. 해설·비평 목적의 장면 인용.
여러 AI를 연결할 때 필요한 것은 경쟁보다 인계다
여러 모델에 같은 질문을 던져 답변의 말투만 비교하는 것으로는 검토가 끝나지 않는다. 서로 다른 모델이 같은 잘못된 원본을 읽었다면 비슷한 오류를 낼 수도 있다. 답이 일치한다는 것과 독립적으로 검증됐다는 것은 다르다.
작업을 넘길 때는 최소한 다음 내용을 남겨보자.
입력: 어떤 파일과 버전을 읽었는가.
결과: 무엇을 만들었고 어디에 저장했는가.
근거: 어떤 자료가 각 주장을 뒷받침하는가.
미확인: 아직 확인하지 못한 항목은 무엇인가.
다음 판단: 사람이 결정할 부분과 다음 도구가 할 일을 구분했는가.
같은 파일을 여러 AI가 동시에 수정하는 것도 피하는 편이 좋다. 읽기와 초안 작성은 나눌 수 있지만, 최종 파일을 반영하는 담당은 하나로 정한다. 그래야 서로의 수정이 사라지거나 이전 버전이 다시 들어오는 일을 줄일 수 있다.
다음은 이런 인계를 요청하는 예시다. 특정 앱에서 그대로 검증한 자동화 명령이 아니라 작업 조건을 전달하기 위한 문장이다.
이번 작업에서 사용할 원본과 검토 기준을 먼저 확인해 줘.
이전 초안을 사실의 근거로 대신 쓰지 말아 줘.

결과에는 사용한 파일·버전, 근거, 미확인 항목을 구분해 줘.
원본은 바꾸지 말고 수정 제안을 작업중 영역에 따로 작성해 줘.
최종 파일 반영과 외부 공개는 승인 전까지 하지 말아 줘.
이 문장을 적는 것만으로 읽기 전용 접근이 보장되지는 않는다. 앱에 부여한 폴더·도구 권한과 승인 설정도 따로 확인해야 한다.
내 PC의 폴더를 쓴다고 처리까지 모두 로컬인 것은 아니다
폴더 위치와 모델이 작업하는 위치는 다른 문제다. Claude Cowork 공식 안내는 클라우드 작업과 데스크톱을 통한 로컬 파일 접근 조건을 구분한다. 연결한 폴더의 필요한 파일 사본이 클라우드 작업에 사용될 수 있다고 설명한다.
따라서 민감한 자료는 어느 폴더에 두었는지만 보지 말자. 어떤 서비스에 제공할 수 있는 정보인지, 어느 범위까지 읽고 쓸 수 있는지, 결과를 외부로 보낼 수 있는지를 확인해야 한다. 여러 AI에 같은 폴더를 연결한다면 각각의 설정을 확인하는 일이 필요하다.
생각의 요약을 읽는 것과 결과를 검증하는 것은 다르다
영상은 AI가 보여주는 생각의 과정이 짧아지면 사용자가 작업을 이해하기 어려워질 수 있다고 지적한다. 여기서 화면에 보이는 설명과 내부 추론을 구분해야 한다.
OpenAI의 reasoning 문서는 원시 추론 토큰을 그대로 공개하지 않으며, 지원 모델에서 별도의 추론 요약을 요청할 수 있다고 설명한다. 화면의 요약이 짧다는 사실만으로 AI가 새롭게 정보를 숨기려는 의도를 가졌다고 결론 낼 수는 없다.
실무 검증에서는 전체 생각을 읽으려 하기보다 확인 가능한 산출물을 요구하는 편이 낫다. 출처 목록, 계산에 사용한 값, 실행 결과, 파일 변경 내역, 검토하지 못한 부분을 남기게 하는 것이다. 그 설명도 오류가 있을 수 있으므로 실제 원본과 결과를 대조해야 한다.
AI가 AI 연구를 돕는다는 말의 범위도 확인하자
영상의 또 다른 주제는 AI가 다음 AI를 만드는 과정에 더 많이 참여한다는 것이다. 실제 사례로 Google DeepMind의 AlphaEvolve는 모델이 제안한 프로그램을 자동 평가하고 개선하는 흐름을 소개한다. 연구·컴퓨팅과 모델 학습 과정의 일부 최적화에 활용했다는 개발사의 설명이다.
이는 의미 있는 연구 자동화 사례지만, 사람이 평가 조건을 정하는 특정 최적화와 제한 없는 재귀적 자기개선은 같은 주장이 아니다. 새 모델의 출시 간격이 짧아졌다는 사실만으로 후자가 입증되는 것도 아니다.
업무에 가져올 수 있는 원리는 더 구체적이다. 초안을 많이 만드는 것만큼 어떤 기준으로 후보를 통과시키고 버릴지 정하는 일이 중요하다. 지식창고에서도 그럴듯한 결과를 전부 쌓기보다 검토를 통과한 내용과 그 이유를 남겨야 한다.
불안을 따라 도구를 바꾸기보다 남길 것을 정하자
영상 후반부에서 김덕진은 빅데이터·4차 산업혁명·AI로 이름이 바뀌어도 자신이 해온 일의 중심은 데이터 분석과 인사이트 전달이었다고 말한다. 학부모가 유행하는 직함과 학과 이름에 미래를 맡기려는 태도도 경계한다.
이 대목은 제목의 ‘모르면 도태된다’는 압박과 다르게 읽힌다. 새 도구를 배우지 말라는 뜻이 아니라, 유행이 바뀔 때도 계속 깊게 만들 능력이 무엇인지 보자는 이야기다. 특정 학과나 교육법이 자녀의 미래를 보장한다는 결론으로 넓힐 수는 없다.
출처: 김작가 TV, 김덕진 인터뷰 20:00. 학과·기술 유행과 학습 방향에 관한 의견. 특정 교육법의 효과나 진로를 보장하는 자료가 아니다. 해설·비평 목적의 장면 인용.
실무자에게도 남길 것은 비슷하다. 내 분야에서 자주 틀리는 기준, 좋은 결과를 구분하는 경험, 반복해서 설명하는 맥락을 기록해 보자. AI가 제안한 새 방식은 시험하되, 채택한 이유와 버린 이유를 자기 지식으로 남긴다.
오늘 시작할 일은 거대한 자동화 구축이 아니어도 된다. 반복 업무 하나를 고르고 원본·검토 기준·결과·미확인 사항을 분리해 남겨보자. 다음에 모델을 바꿔도 그 기록을 기준으로 이어갈 수 있다면, 도구 사용이 비로소 업무 자산의 축적으로 연결된다.
본문 이미지는 김작가 TV 인터뷰의 해당 논의를 설명하기 위한 장면 인용이다. 출연자의 경험·비유와 연구 결과, 이 글의 적용 제안을 구분했다. 폴더 구조와 요청 예시는 별도로 재구성한 운영안이며, 앱 연동을 독립 재현하거나 모델별 성능을 비교한 실험은 아니다. 공식 문서 확인 기준일은 2026년 11월 4일이다.
FAQ
AI 지식창고는 파일을 한 폴더에 모으면 완성되나요?
아니다. 원본과 미검토 초안, 검토된 지식과 완성본을 구분해야 한다. 출처·확인일·버전·미확인 항목이 있어야 다음 작업에서 무엇을 다시 사용할 수 있는지 판단할 수 있다.
같은 폴더를 연결하면 여러 AI가 대화 기억도 공유하나요?
자동으로 공유된다고 볼 수 없다. 각 도구가 접근한 자료와 대화 맥락은 다를 수 있다. 다음 도구에 입력 파일·완료한 작업·근거·미확인 사항을 명시적으로 넘기는 편이 좋다.
AI가 제안하는 방식을 배우면 누구나 전문성이 높아지나요?
보장할 수 없다. 바둑 연구에서 나타난 결과도 측정 대상과 맥락에 따라 다르다. 제안을 이해하고 검토할 능력, 원천자료의 품질과 실제 업무 조건을 함께 봐야 한다.
AI가 보여주는 추론 요약만으로 작업을 검증할 수 있나요?
충분하지 않다. 요약은 내부 추론 전체가 아니며, 설명 자체에도 오류가 있을 수 있다. 원본 자료·계산값·실행 결과·변경 내역처럼 실제로 대조할 수 있는 근거를 함께 확인해야 한다.
고양이를 어디에 놓을지 고민하기 전에, 놓을 수 없는 칸부터 지워보자. 행·열·색깔 조건이 겹치는 논리 퍼즐은 이 순서로 접근하면 무엇을 근거로 답을 정했는지 설명하기 쉬워진다.
짧은 고양이 퍼즐 광고는 보라색 한 칸에서 시작해 다른 위치를 찾아가는 과정을 보여준다. 그 장면을 바탕으로 규칙 읽기와 후보 제거 방법을 정리하고, 화면에 나온 판을 마지막 고양이까지 검산했다. 아래에는 풀이와 정답이 있으므로 직접 풀고 싶다면 색 배치까지만 먼저 확인하자.
고양이 논리 퍼즐의 규칙부터 읽는다
영상 화면의 조건은 다음과 같다.
각 행에 고양이를 한 마리씩 놓는다.
각 열에도 고양이를 한 마리씩 놓는다.
각 색깔 영역에도 고양이를 한 마리씩 놓는다.
고양이끼리 이웃한 칸에서 닿으면 안 된다. 영상의 표시에서는 대각선으로 맞닿은 칸도 제외한다.
비슷한 구조는 LinkedIn의 Queens 공식 규칙에서도 확인할 수 있다. 각 행·열·색 영역에 하나씩 배치하고 대각선 이웃을 포함한 인접 칸을 피하는 방식이다. 다만 규칙이 비슷하다는 사실이 영상 속 게임이 LinkedIn 게임이라는 뜻은 아니다.
또한 ‘대각선 이웃 금지’를 체스 퀸처럼 대각선 전체의 배치 금지로 바꾸면 안 된다. 멀리 떨어져 대각선상에 있는 칸까지 모두 지울지는 해당 게임의 규칙을 확인해야 한다.
정답을 찍는 대신 후보를 줄인다
이 퍼즐에서 후보란 현재까지 확인한 조건에 어긋나지 않는 칸이다. 후보가 두 개 남았다는 이유만으로 하나를 정답처럼 확정하면, 뒤에서 무엇이 잘못됐는지 찾기 어려워진다.
먼저 한 칸짜리 색 영역이나, 이미 대부분의 칸이 제외된 행·열을 찾는다. 고양이 한 마리를 확정하면 다음 세 가지를 함께 반영한다.
같은 행과 같은 열의 다른 칸을 제외한다.
같은 색깔 영역의 다른 칸을 제외한다.
바로 맞닿은 이웃 칸을 제외한다.
그다음 후보가 하나만 남은 영역을 다시 찾는다. 핵심은 가장 최근에 놓은 고양이뿐 아니라 앞에서 확정한 모든 고양이의 조건을 계속 유지하는 것이다.
영상 속 판을 글자로 옮겨보기
행은 위에서 아래로, 열은 왼쪽에서 오른쪽으로 센다. 영상 첫 화면의 색 배치를 다음 기호로 옮겼다.
하: 하늘색
보: 보라색
노: 노란색
진: 진분홍색
초: 초록색
연: 연분홍색
       1열 2열 3열 4열 5열 6열
1행     하  보  노  노  노  진
2행     하  하  노  노  진  진
3행     하  하  진  진  진  진
4행     하  하  하  진  진  진
5행     초  초  연  연  진  진
6행     연  연  연  연  연  연
이제 같은 판을 순서대로 풀어보자. 다른 퍼즐에 그대로 좌표를 적용하는 것이 아니라, 각 단계에서 후보가 줄어드는 이유를 보는 것이 목적이다.
1. 보라색은 1행 2열로 확정한다
보라색 영역에는 칸이 하나뿐이다. 각 색에 고양이가 한 마리씩 있어야 하므로 1행 2열에 놓는다.
이제 1행의 나머지 칸과 2열의 나머지 칸은 제외한다. 바로 아래의 2행 1~3열도 이 고양이와 닿으므로 제외한다. 같은 열에서 제외하는 칸과 대각선 이웃으로 제외하는 칸이 겹쳐도 괜찮다.
2. 노란색은 2행 4열만 남는다
노란색은 1행과 2행에 걸쳐 있다. 1행에는 이미 보라색 고양이가 있으므로 그 행의 노란색 칸을 쓸 수 없다.
2행의 노란색 후보는 3열과 4열이다. 이 중 3열은 1행 2열과 대각선으로 맞닿는다. 따라서 2행 4열이 노란색 고양이의 자리다.
3. 초록색은 5행 1열이다
초록색 영역은 5행의 1열과 2열에 있다. 2열은 보라색 고양이가 이미 차지한 열이다.
그러므로 초록색은 5행 1열로 확정한다. 이때부터 1열의 나머지 칸도 모두 제외해야 한다. 앞의 고양이와 멀리 떨어져 있다고 해서 같은 열을 다시 사용할 수는 없다.
4. 하늘색은 4행 3열로 좁혀진다
하늘색 영역에서 1행과 2행은 이미 다른 고양이가 놓인 행이다. 남은 하늘색 칸을 보면 1열과 2열은 각각 초록색·보라색 고양이가 사용 중이다.
그 조건을 모두 반영하면 4행 3열만 남는다. 넓어 보이는 색 영역도 다른 행과 열의 확정 위치를 반영하면 한 칸으로 좁혀질 수 있다.
5. 진분홍색에서 이전 고양이의 대각선을 놓치지 않는다
이제 1·2·4·5행에는 고양이가 있다. 진분홍색을 놓을 수 있는 행은 3행으로 좁혀진다.
3행의 진분홍색 칸 중 3열과 4열은 이미 다른 고양이가 사용 중인 열이다. 5열은 어떨까? 바로 위의 2행 4열 고양이와 대각선으로 닿는다. 따라서 3행 5열도 후보에서 제외한다.
남는 곳은 3행 6열이다. 마지막에 놓은 하늘색 고양이 주변만 살폈다면 놓치기 쉬운 조건이다. 이미 확정한 고양이를 모두 기준으로 봐야 한다.
6. 연분홍색은 6행 5열로 끝난다
5행에는 초록색 고양이가 있으므로 그 행의 연분홍색 칸은 사용할 수 없다. 마지막 남은 행은 6행이다.
다른 고양이가 사용 중인 열을 지우면 6행 5열이 남는다. 이로써 각 행·열·색 영역에 하나씩 놓는 조건과 인접 금지 조건을 함께 만족한다.
정답과 검산 결과
위에서부터 각 행의 고양이 열 번호를 읽으면 다음과 같다.
2 → 4 → 6 → 3 → 1 → 5
       1열 2열 3열 4열 5열 6열
1행     ·  고  ·  ·  ·  ·
2행     ·  ·  ·  고  ·  ·
3행     ·  ·  ·  ·  ·  고
4행     ·  ·  고  ·  ·  ·
5행     고  ·  ·  ·  ·  ·
6행     ·  ·  ·  ·  고  ·
화면의 색 배치와 보이는 규칙을 입력해, 행별로 열이 중복되지 않는 720개 배치를 전수 검사했다. 별도의 백트래킹 방식으로도 확인했으며, 두 방식 모두 조건을 만족하는 해는 1개로 일치했다. 각 단계가 해당 색 영역의 유일한 후보인지도 확인했다.
이 검산의 범위는 영상에 보이는 판과 규칙이다. 특정 앱을 설치해 모든 레벨을 시험한 결과나, 광고가 연결하는 실제 게임의 품질을 평가한 결과는 아니다.
막힐 때는 새 규칙을 만들기보다 지운 이유를 확인한다
후보가 하나도 남지 않거나 같은 열에 고양이가 겹친다면, 마지막 선택만 바꾸기 전에 표시를 점검하자.
규칙을 과하게 적용했는가: 인접 금지를 대각선 전체 금지로 바꾸지 않았는지 본다.
확정과 추측을 섞었는가: 후보가 여러 개인 칸을 근거 없이 확정하지 않았는지 확인한다.
이전 조건을 빠뜨렸는가: 멀리 있는 같은 열의 고양이나, 한 단계 전에 놓은 고양이의 대각선 이웃을 다시 살핀다.
색 배치를 잘못 읽었는가: 비슷한 색과 경계를 확인한다. 이 글에서는 색 이름뿐 아니라 글자 기호를 함께 적었다.
스도쿠도 행·열·영역의 조건을 확인한다는 점에서는 비교할 수 있다. 하지만 니코리의 공식 규칙은 1~9를 각 행·열·3×3 블록에 배치하는 숫자 퍼즐이다. 고양이 퍼즐의 인접 금지 규칙을 그대로 가져오면 다른 문제를 푸는 셈이 된다.
‘IQ 130’ 광고 문구와 풀이 능력은 구분하자
영상 상단에는 IQ 130 이상인 사람만 해결할 수 있는지 묻는 문구가 나온다. 그러나 영상에는 그 기준을 뒷받침하는 검사나 연구 설명이 없다. 이 문구만으로 퍼즐 성적을 지능검사 결과처럼 해석할 수는 없다.
이 글에서도 이 퍼즐이 지능이나 건강을 향상시킨다고 주장하지 않는다. 여기서 확인할 수 있는 것은 주어진 조건으로 후보를 제거하고, 선택한 위치의 이유를 설명할 수 있는지다.
풀이를 마쳤다면 정답을 외우기보다 “이 칸은 왜 남았고 저 칸은 왜 지웠는가”를 돌아보자. 판마다 색 배치는 달라도, 규칙과 추측을 구분하며 검산하는 순서는 다시 사용할 수 있다. 이런 판단 점검에 관심이 있다면 내 생각을 점검하는 메타인지 체크리스트도 함께 읽어볼 만하다.
If AI builds a similar app without receiving its source code, can we say it understood the original? A similar-looking interface is different from understanding the data structures and exception handling.
Dante’s Datalab’s REA experiment illustrates this distinction. The creator had it analyze an asset management app whose source code he owned. A separate evaluation agent then compared the original with the result. It reimplemented the main features in about 23 minutes, but scored 74 out of 100 rather than achieving a complete replica. One misinterpreted piece of evidence, in particular, sent the internal design in a different direction.
REA Is More an Integration Layer for Analysis Tools Than a New Decompiler
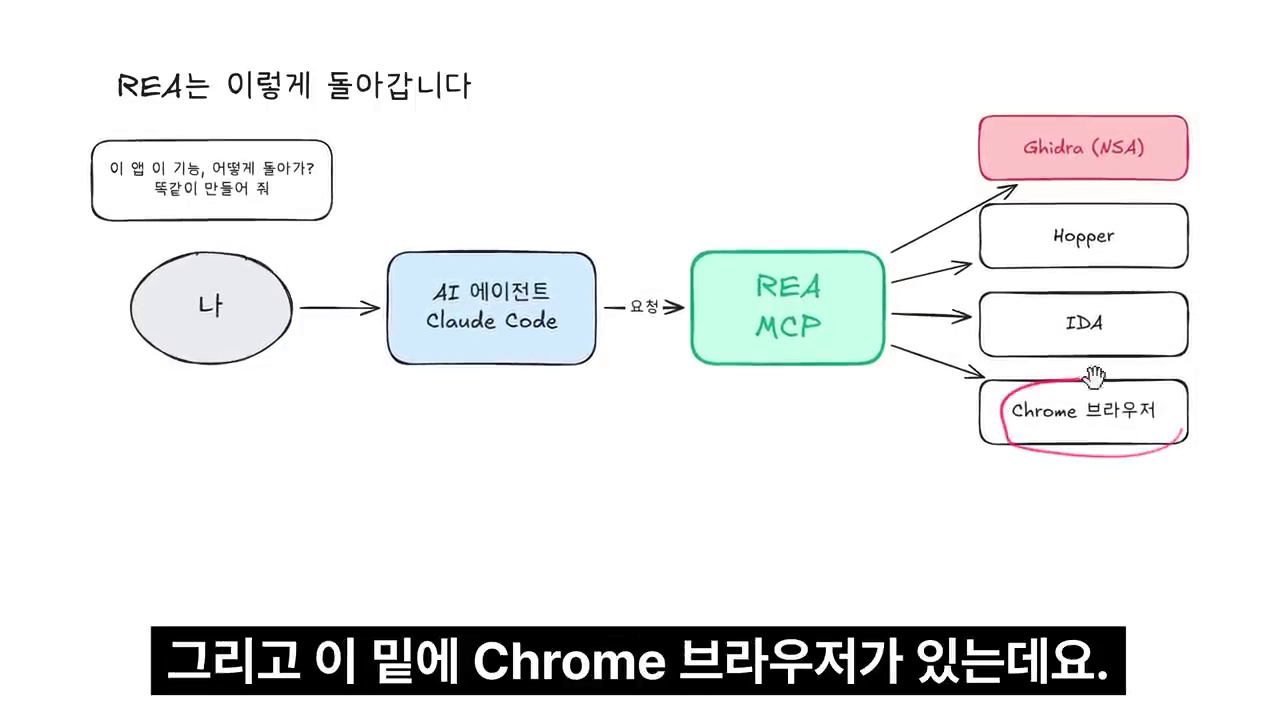
REA stands for Reverse Engineer Anything. Its official documentation describes connecting agents to tools for investigating native binaries, JavaScript and Electron apps, websites, and other targets. The agent reads analysis results, decides what to investigate next, and records both the evidence behind its judgments and their limitations.
It is therefore inaccurate to see REA as a new analysis engine that replaces Ghidra, Hopper, and IDA altogether. It instead brings existing analysis tools and runtime observation into a coding agent’s workflow. The official documentation also distinguishes static JavaScript analysis of Electron apps, which does not require a native analysis engine.
Source: Dante’s Datalab, original video at 02:50. Frame quoted to illustrate the discussion.
An important term in the video is Evidence. Rather than simply saying, ‘This is probably how it works,’ the agent records which files, analysis results, or runtime observations informed its judgment. But keeping a record does not guarantee that its interpretation is correct.
Original Source Access Was Blocked, but the Distributed App’s Internals Were Analyzed
The experiment targeted a Serpent-based asset management app that the creator was modifying. He held the original project’s source, allowing him to compare the analysis with the actual implementation. This differs from starting with an unauthorized attempt to copy a commercial app.
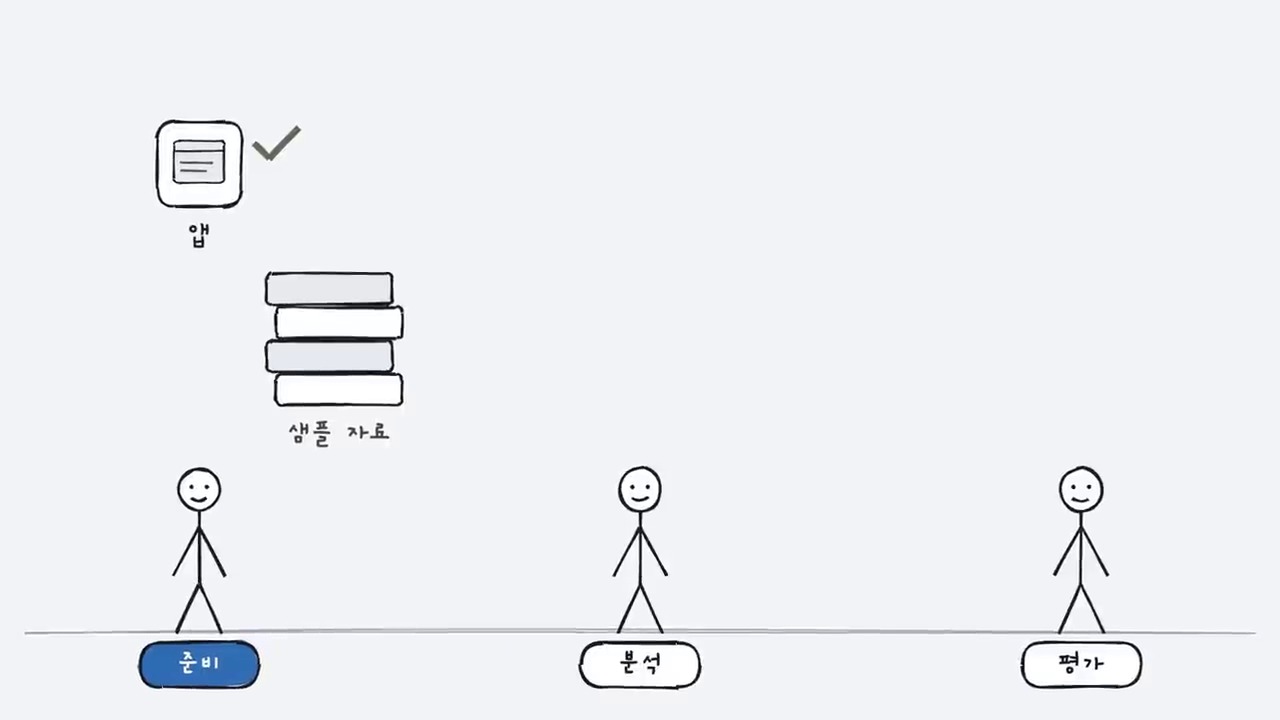
The experiment divided the work into three roles.
Preparation agent: Packaged the app and prepared test materials and instructions.
Analysis agent: Investigated the installed app and built a new app with the same user-facing functions.
Evaluation agent: Examined both the original source and the reimplementation code to compare behavior and evidence.
Source: Dante’s Datalab, original video at 07:50. Frame quoted to illustrate the discussion.
The analysis agent could not access the original project folder, perform external searches, or look things up on GitHub. It could, however, inspect the installed app’s bundled code and files left on disk. ‘The original source was not provided’ does not mean ‘no code was visible.’
This should also be distinguished from clean-room development in the strict sense. The analysis agent handled implementation too. The video acknowledges that the analyst and implementer were not separated. The agent also encountered the original name in files left by the app. Its identity was therefore not completely concealed throughout the experiment.
The 23-Minute Result Recreated Major User Flows, Not a Finished Product
According to the creator’s published record, reimplementation took about 23 minutes. It involved 9 REA calls and produced 949 lines of code without external packages. These figures describe the creator’s particular run, not a benchmark independently reproduced here.
The original was an Electron desktop app, while the rebuild used a Node.js server and a browser interface. The approach was that matching functionality need not require matching technology.
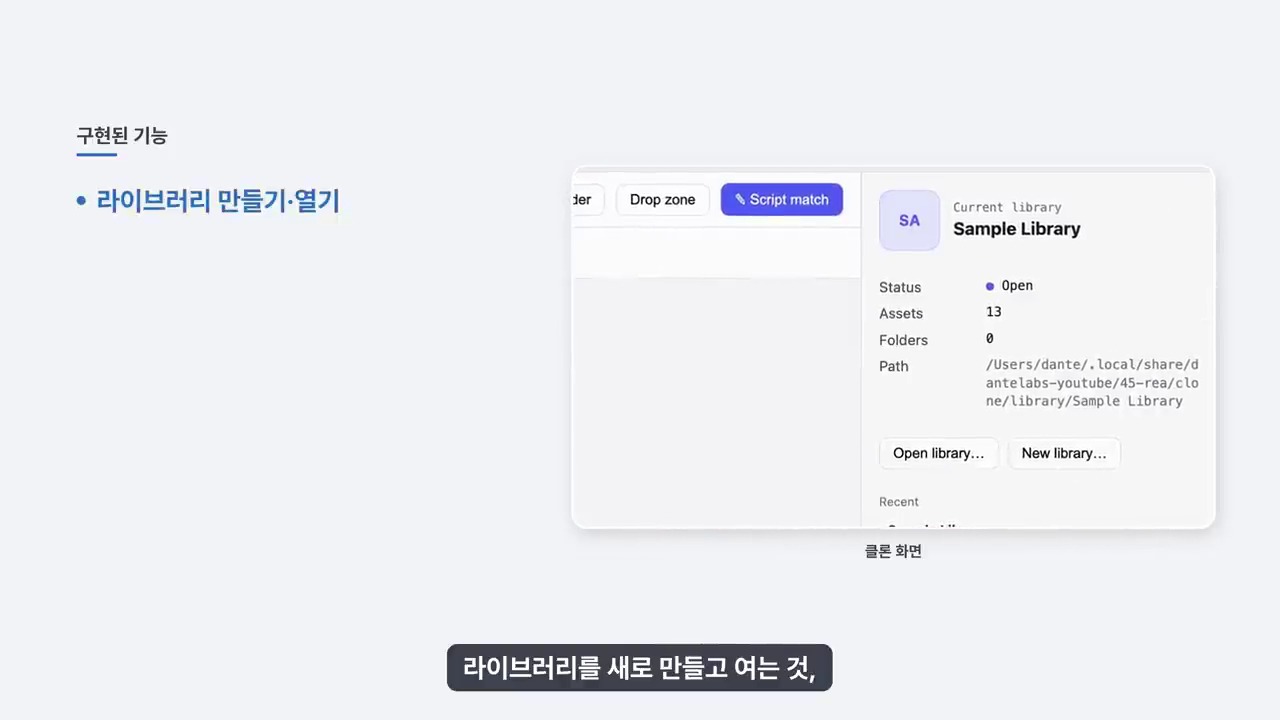
Working features included opening libraries, importing assets, grid display, tags, search, details, trash, and preserving state after restarting. Folders, collections, undo, and some views and filters were missing.
Source: Dante’s Datalab, original video at 13:50. Frame quoted to illustrate the discussion.
The published scorecard gave the following results.
Interface structure: 16/20 points
Data model: 16/20 points
Core behavior: 25/30 points
Edge cases: 8/15 points
Code structure similarity: 9/15 points
Total: 74/100 points
The score of 74 should not be read as ‘74% complete’ or as the probability of copying any app. The evaluation agent assigned it to this result using five criteria set by the creator. Those criteria included whether it adopted the original’s internal structure. This is therefore not a conventional product quality score either.
A Design Can Be Wrong Even When 22 of 24 Evidence Items Are Correct
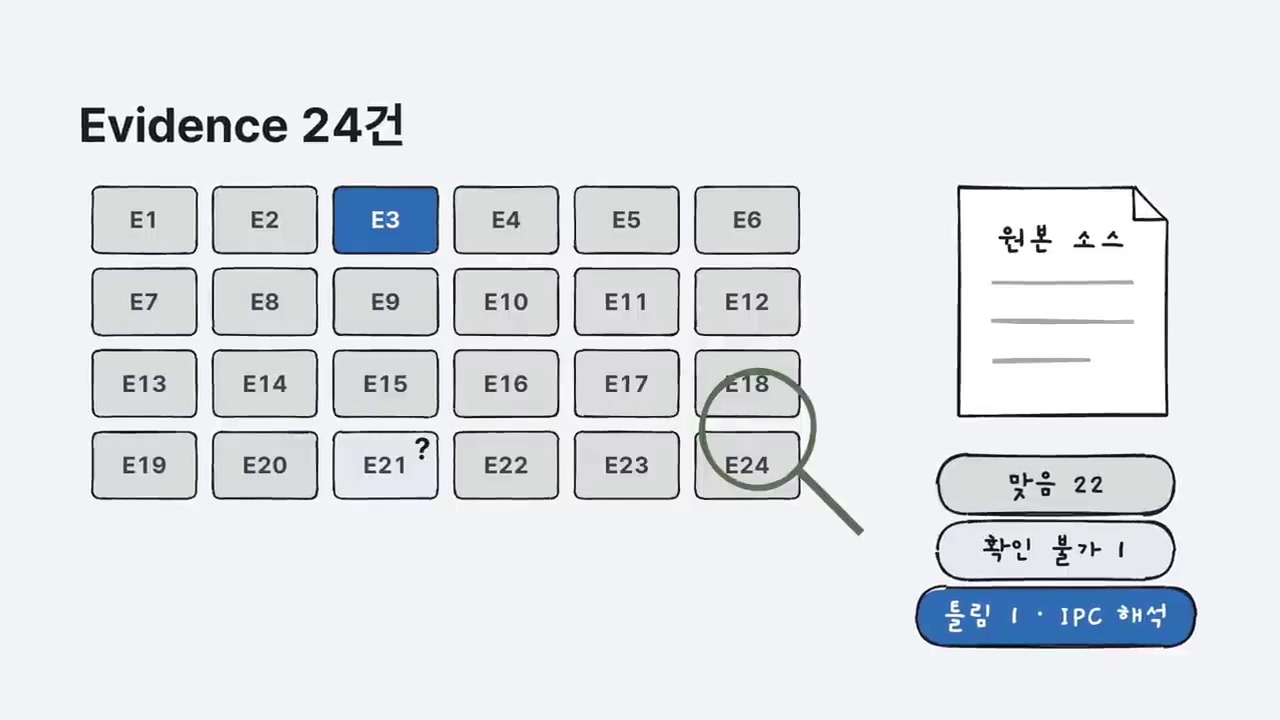
The most noteworthy aspect of this experiment is the error, rather than the speed. Of 24 Evidence items checked against the original source, 22 were correct, 1 could not be verified, and 1 was wrong.
The problematic item concerned Electron IPC communication. Unable to find channel names, the analysis agent inferred that strings were assembled at runtime. It designed new feature-specific APIs on that basis. The original, however, used constants determined at compile time.
Source: Dante’s Datalab, original video at 16:50. Frame quoted to illustrate the discussion.
Duplicate-file handling also differed. The rebuilt app stored file fingerprints but did not use them properly to detect duplicates. It also accepted unsupported formats that the original rejected. Discovering information and implementing the reason for that information turned out to be separate tasks.
This case shows why verification cannot simply count pieces of evidence. Even when many items are correct, one mistaken core design assumption can redirect the entire result. The more important an inference, the more necessary it is to check both primary materials and actual behavior.
Understanding and Extending Features May Be More Useful Than Copying
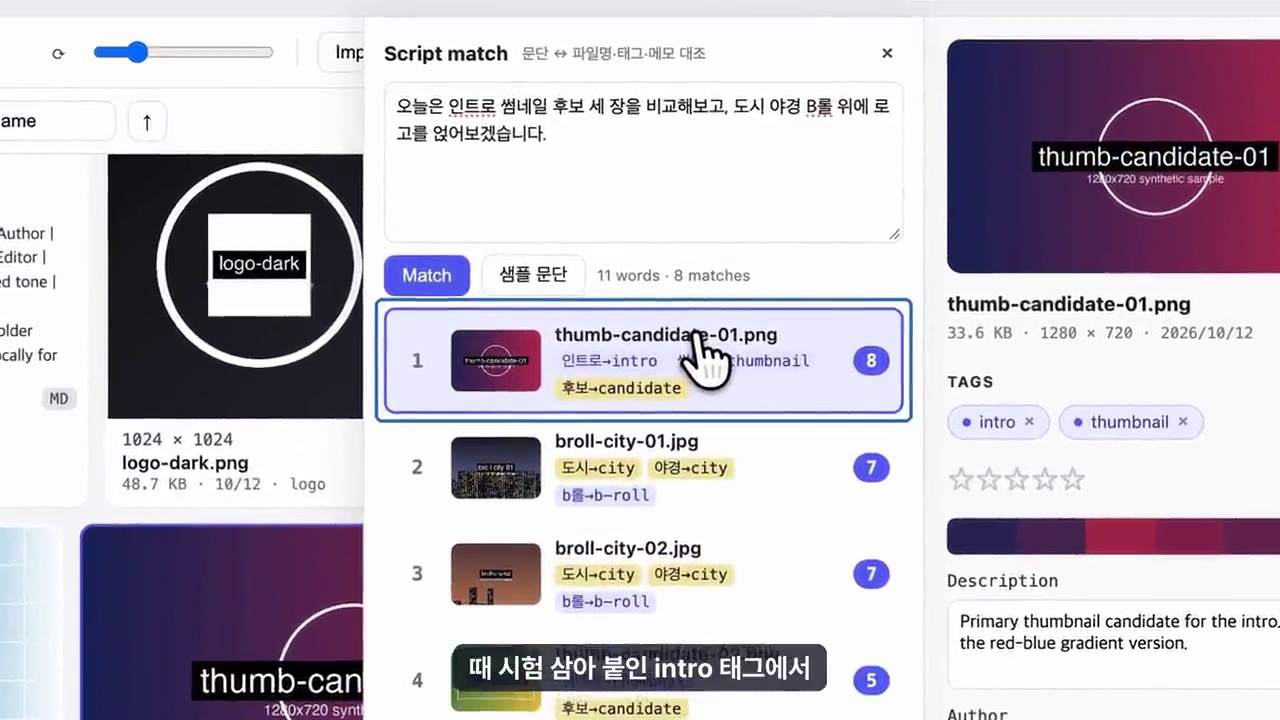
After the rebuild, the creator added a panel that finds relevant assets when given a script paragraph. It compares tags, filenames, and notes to rank the assets. The key point is that this extension reused the data access and interface behavior already built.
Source: Dante’s Datalab, original video at 18:20. Frame quoted to illustrate the discussion.
However, tags added during testing also affected search scores. A working new feature does not, by itself, validate recommendation quality. That is why it needs retesting with separate real-world work data.
From this perspective, REA is worth considering for more than other companies’ commercial apps. The following targets, for which analysis permission is clear, should come first.
In-house business software with inadequate internal documentation after its developer has left
Internal APIs whose actual responses have diverged from the documentation
Old proprietary file formats and data migration work
Existing programs that work but lack sufficient regression tests
A broad goal such as ‘build the same app’ makes verification harder to define. Narrower questions clarify the criteria: ‘How does search work?’ or ‘What rules govern saving and restoring data?’
An 11-Minute Paint Demo: The Features I Want, Not Just the Same App
Success Knowledge Encyclopedia’s additional video shows a different use for REA. The presenter rebuilt a simple Paint-style app based on Windows Paint. He added a feature that accumulates pasted images in an asset list on the right. The video directly checks basic drawing, color changes, filling, and image pasting. It also demonstrates renaming, reusing, and downloading assets, and removing them from the list.
The distinction here is that the presenter added custom features to a newly built app rather than modifying the existing Windows Paint product itself. The point is not to match the original perfectly. It is to combine a familiar workflow with features the user wanted.
The presenter says the result took about 11 minutes. Unlike the earlier Serpent experiment, however, this video provides no scorecard comparing the original source with the result. Unfinished elements, including the cursor display, remain. Features working in a short demonstration should not be mistaken for product quality suitable for long-term use.
11 Minutes and 23 Minutes Are Not a Performance Ranking
The two videos cover the same tool but demonstrate different things.
Dante Labs’ roughly 23-minute experiment: Restricted access to the original source of an asset management app. A separate evaluation agent compared the original and rebuilt app, awarded 74 points, and disclosed incorrect evidence and missing features.
Success Knowledge Encyclopedia’s roughly 11-minute demo: Built a Paint-style app with an asset panel and tested its main functions on screen. It provided neither a score under the same criteria nor results checked against original source code.
The apps’ complexity, implementation scope, execution environments, and evaluation methods differ. Comparing these times cannot establish which agent is faster or how much REA’s performance has improved. The former is better understood as a test of the accuracy of understanding, and the latter as a use case for building personalized features.
What Has Fallen for Non-Specialists Is the Barrier to Starting Analysis
The additional video locates REA’s value in making existing tools easier to access and connect, rather than inventing new reverse engineering technology. Previously, users had to learn tool installation and operation separately. The perspective here is that they can now start by requesting work from an agent.
Source: Success Knowledge Encyclopedia, additional video at 01:50. Frame quoted to discuss the explanation and outlook.
But ‘easier to start’ does not mean ‘no knowledge needed to review the result.’ The presenter also emphasizes learning enough to read, understand, analyze, and review the output. The earlier IPC interpretation error and duplicate-file handling failure show why.
In practice, it is better to narrow the scope than to hand over an entire app from the outset. Start with a program you are authorized to analyze. Check one feature’s input, output, and storage rules, test its explanation and evidence, and then expand. Comparing the same task with an ordinary coding agent without REA can also help establish whether the extra tools are actually necessary.
How Should We Interpret Predictions That Core Logic Will Move to Servers?
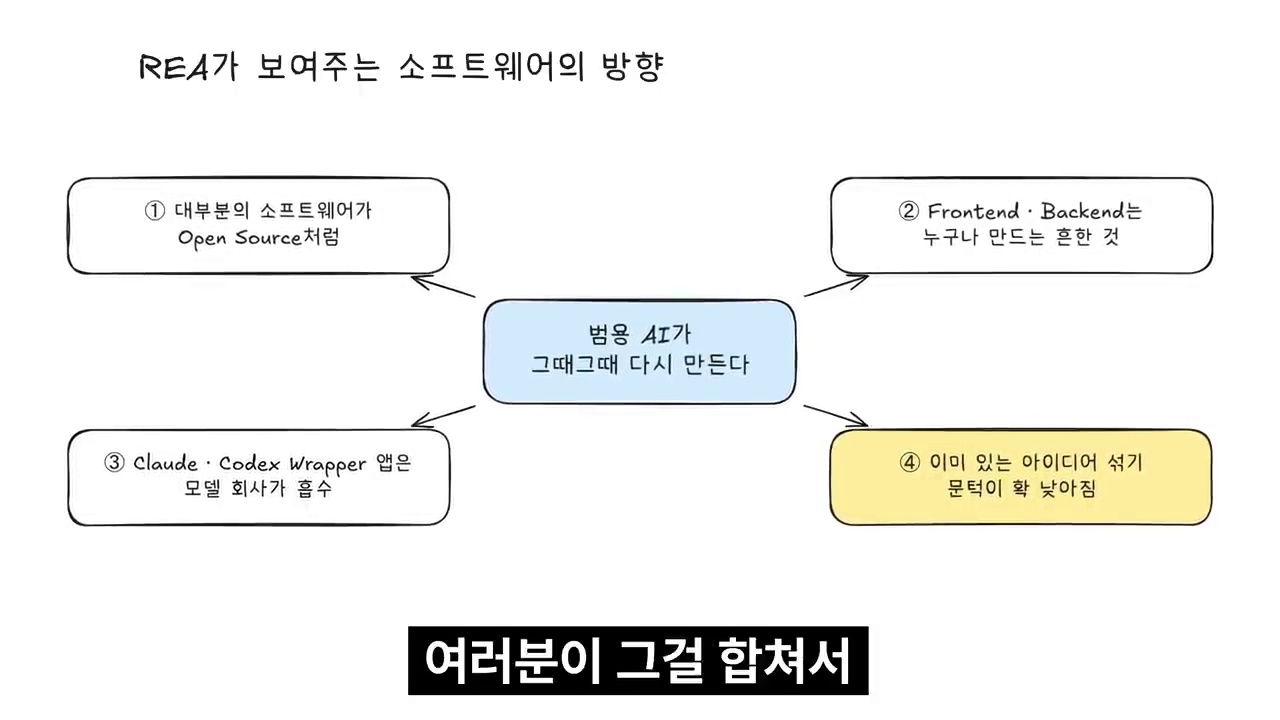
Success Knowledge Encyclopedia predicts that easier analysis may encourage software companies to put core logic on servers rather than inside apps. The reasoning is that implementations distributed to user devices can be investigated, creating an incentive to change how software is delivered.
Source: Success Knowledge Encyclopedia, additional video at 10:20. Frame quoted to discuss the explanation and outlook.
This is the presenter’s prediction, not an established fact that all apps will become server-centered. Server-based designs also require considering operating costs, network latency, offline usability, privacy, and access control. Hosting something on a server does not solve every security problem.
Likewise, statements such as ‘software is over’ or ‘most apps will become open source’ should be read as predictions emphasizing the scale of change. Easier feature implementation is separate from continuously operating a product with maintenance, security, and support. Being able to analyze a product does not grant a license to use its code or assets.
We should also avoid concluding that personal learning use is always acceptable. The additional video’s examples are useful references. But the purpose, authorization, terms, and licenses for analysis should be checked separately using the existing checklist.
What a Web App Example Adds: What Did MathSheets Reproduce?
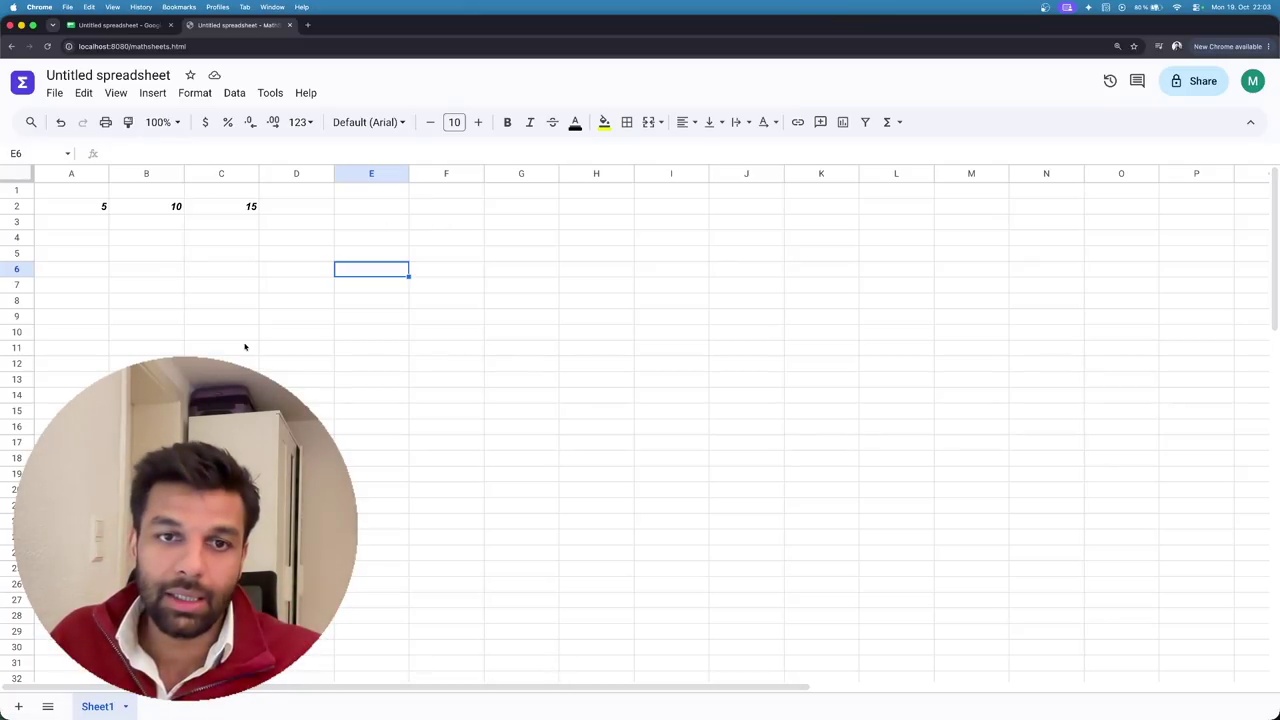
AI with Hassan’s additional video uses Google Sheets’ interface and basic behavior as a reference to show how to build a simple spreadsheet called MathSheets. The presenter requests only the tools needed for web app analysis. He asks not to install native binary analysis tools such as Ghidra and Hopper.
This approach distinguishes observable web functionality from internal analysis of installed programs, rather than using the same reverse engineering tools for every target. Inspecting a browser interface and its interactions does not establish an understanding of server-side implementation or operational architecture.
The video demonstrates cell editing, selection, and a simple addition result. The presenter says the work took about 20–30 minutes, but provides neither precise measurement records nor repeated trials of the same task. There is also no basis for directly comparing this time with the 11-minute Paint demo or the 23-minute asset management app experiment.
Source: AI with Hassan, additional video at 10:35. This demonstrates local MathSheets, not a reproduction of the entire Google Sheets service.
A Share Button Is Not the Same as Working Collaboration
The video alone may give the impression of a completed interface closely resembling Google Sheets. However, the creator’s published MathSheets repository README explains the implementation scope more specifically.
It describes a lightweight spreadsheet built with HTML, CSS, and JavaScript, and says the app itself needs no server.
It lists support for cell references, ranges, some formulas including SUM and AVERAGE, and CSV export.
Data is stored in the browser’s localStorage. It explicitly warns that clearing site data deletes it, and recommends exporting anything worth keeping as CSV.
Share and Email are unimplemented menu items marked ‘soon’, according to the documentation.
This case should therefore not be read as restoring Google Sheets’ collaborative editing, accounts and access permissions, cloud storage, or operational infrastructure. A visible Share button is different from allowing multiple users to edit the same document safely. The feature list above follows public documentation. It is not the result of separately running and verifying the app here.
The official REA repository must also be distinguished from the video’s example repository. The former is a reverse engineering tool; the latter is a learning project built using it. The example README’s License section says no license has yet been specified. Code being visible on GitHub does not, by itself, establish permission for unrestricted reuse or distribution. Before using it, separately check the repository’s latest license and usage permissions.
Define Verification Boundaries Before Dividing Work Among Agents
Hassan shows tasks such as the grid and formulas being divided among subagents. Separating interface work, such as input and selection, from formula interpretation can clarify each role. But using multiple agents does not itself demonstrate greater speed or accuracy. No comparison with a single agent performing the same task is provided.
Using a spreadsheet for work requires tests beyond visual similarity, including the following. These are checks needed before actual use, not claims that the video verified them all.
When a cell changes, do other cells referencing it recalculate correctly?
How are empty cells, invalid formulas, circular references, and error values handled?
Does data survive refreshing or closing the browser, and do CSV export and reimport work as intended?
If collaboration is required, have per-user permissions, simultaneous editing conflicts, change history, and recovery been separately implemented and tested?
The evidence REA returns and its unknowns can serve as starting points for this verification plan. Do not treat unknown items as completed implementations. Track verified behavior, inferred structures, and unimplemented features separately. Even when code generation is divided among multiple roles, final integration and verification need one consistent set of criteria.
Taken together, the three videos do not establish that ‘any app can be perfectly copied for free.’ The asset management app experiment examines the accuracy of analytical evidence; the Paint demo explores personalized feature extensions; and the MathSheets case highlights the difference between an interface with basic behavior and an entire service. Lower barriers to development do not remove the need to decide which problem to solve and how far the result can be trusted.
Three Remaining Limitations When Assessing REA’s Impact
First, these are single-run examples. Times and results may change with the target app, model, prompt, and test data.
Second, there is no comparison condition without REA. This result alone cannot show how much better it was than an ordinary coding agent or which gains came from REA.
Third, an AI agent also performed the evaluation. Comparing with the original code is useful, but that scoring is not equivalent to an independent expert audit or security assessment.
To assess the tool’s usefulness, it is therefore better to examine the experimental conditions and failures rather than just the video’s title.
Check Analysis Permissions and Licenses Before Tool Performance
REA being open source does not make the target app’s rights unrestricted. Check each separately: authorization to analyze, the target program’s license and terms, and permitted uses of code and assets such as images and icons.
The video also introduces provisions concerning computer programs in South Korea’s Copyright Act. However, observing functionality, reverse-analyzing code, achieving interoperability, and distributing results differ in purpose and scope. This should not be simplified into ‘reverse engineering is always legal’ or ‘a similar interface is never a problem.’ If you plan to analyze a commercial app or distribute the result, consulting an expert about the specific conditions is safer.
Before experimenting, check these five points.
Did you create the program yourself, or confirm permission to analyze and use it?
Have you checked the license terms for both the target program and the analysis tools?
Are you avoiding unauthorized reuse of original code and design assets?
Have you removed personal and confidential information from analysis logs and publicly shown screens?
Do you distinguish observed facts from inferences and test edge cases as well as normal behavior?
The REA experiment’s value is both broader and more limited than the phrase ‘copying apps’ suggests. It shows potential to shorten the time needed to understand existing programs, but does not remove responsibility for interpretation and verification. Start by understanding one small feature in a program you are clearly authorized to analyze. Then check that understanding with evidence and tests.
Can REA perfectly copy any app without source code?
That has not been established. The video presents a single case of rebuilding major features while access to the original project source was blocked. The installed app’s bundled code remained available for analysis. Features were missing, and some internal design interpretations were wrong.
Does REA replace Ghidra or IDA?
The official documentation presents REA more as a layer connecting existing analysis engines and various observation tools to agents. The tools used vary with the analysis target and environment.
Do 23 minutes and 74 points represent REA’s typical performance?
No. They are results from one run under the creator’s chosen environment and evaluation criteria. Without repeated experiments or comparison against a condition without REA, they cannot be generalized as typical performance.
Does purchasing a paid app allow unrestricted reverse engineering and redistribution?
Purchase alone does not establish every right to analyze, reuse, or distribute it. Relevant law, terms of use, licenses, and the purpose and scope of analysis require separate review.
Is the 11-minute Paint demo a better result than the earlier 23-minute experiment?
The target apps, implementation scope, and evaluation criteria differ, so direct comparison is not possible. The Paint demo illustrates custom feature extensions. The earlier experiment focuses on checking against original source code and verifying missing features. Both videos show single-run examples.
The images are frames quoted to explain and critique relevant scenes from the original video. Experimental figures and evaluation results follow the video creator’s public records. They are not results from a separately reproduced experiment.
Does human competitiveness in the AI era come from memorizing more knowledge? Or from producing results faster? Professor Kim Dae-sik and choreographer Kim Hye-yeon take their conversation in a slightly different direction. They focus on the ability to put AI to work, and the uniqueness of a life that cannot come from copying someone else.
This video, released by Kyobo Book Centre’s BORA, combines a talk on technology’s future with a conversation with an artist. The description lists September 19, 2026, as the filming date and October 13 as the release date. Below, we reconstruct their remarks and add criteria for applying them to work and learning. We do not treat predictions or personal views as verified facts.
Saying technology matters less does not mean you should stop learning
The video’s provocative title alone could suggest that learning technical skills is unnecessary. Yet in his talk, Professor Kim Dae-sik recommends studying vibe coding and agentic AI. Reading it as a claim that knowledge and skills are useless would be inconsistent.
He contrasts the ability to make something with the question of what to make. If producing comparable writing, images, and videos becomes easier, the advantage gained through production skills alone shrinks. Engaging stories, perspectives drawn from experience, and criteria for deciding what to keep or discard then stand out more.
The discussion of films around the 3-minute mark illustrates this difference. Convincingly imitating an existing work is different from creating a story people encounter for the first time. Professor Kim says new stories require extensive experience and reading. His message is closer to weaving what you learn into your own perspective than to abandoning learning.
Source: Kyobo Book Centre BORA, original video 03:40. Scene excerpt illustrating this discussion.
For example, AI can quickly draft presentation materials. But someone still has to decide why the audience should care about the issue. One objection heard in the field can sometimes persuade more effectively than ten polished slides. This example is an interpretation that applies the talk’s distinction to work.
Divide tasks into four types instead of focusing on job titles
Around the 6-minute mark, Professor Kim divides work along two axes. Is it done alone or with others? Does it have a correct answer or not? This classification is not useful because it predicts the disappearance of particular jobs. It helps distinguish where automation and human judgment belong within a single occupation.
Working alone with a correct answer: These are repetitive tasks with clear rules. Candidates for delegation to AI are easy to identify, but errors still need checking.
Working alone without a correct answer: Exploration plays a large role, as in research and creative work. Rather than excluding AI, you can use it to explore alternatives.
Working with others with a correct answer: Precise procedures overlap with interpersonal relationships. Even when AI assists with providing knowledge, explanation and trust-building remain.
Working with others without a correct answer: People set a direction amid different interests. Reaching agreement on what counts as a good outcome becomes important.
Source: Kyobo Book Centre BORA, original video 06:42. Scene excerpt illustrating this discussion.
The explanation of teachers’ roles is particularly memorable. Professor Kim emphasizes counseling, motivation, and support for resilience over knowledge delivery. This does not mean teachers need not know their subjects. He asks what relationships teachers should build with students when the cost of delivering knowledge has fallen.
However, expressions such as ‘100% replacement’ in the video represent the speaker’s strong predictions. This classification alone cannot quantify actual employment changes. In fields with major safety and responsibility concerns, such as medicine and education, accuracy, institutions, and practical conditions also require separate consideration.
A lack of technical skills is not the only barrier to AI adoption
From around the 8-minute mark, the discussion turns to employees’ emotions. Is AI a tool, a colleague, or a competitor that will eventually push me out? If that remains unclear, asking only for a willingness to learn is difficult. People worry about their place before they worry about productivity metrics.
Here, the idea of ‘people before technology’ becomes more concrete. Organizations must explain the conditions of the transition, not just teach people to use new tools. Who benefits from the time saved? Will people have opportunities to retrain when their roles change? Who bears responsibility for mistakes?
The talk also includes survey percentages and corporate examples. However, this article has not independently verified the original surveys or the results of the unnamed companies. It therefore does not repeat those figures as general facts. The question worth keeping is simpler. Can an adoption plan last if employees see using AI as a personal loss?
Choreographer Kim Hye-yeon’s answer: Immerse yourself in the act before the outcome
Around the 14-minute mark, Professor Kim asks how people might define themselves if work loses its place as a measure of self-worth. Choreographer Kim Hye-yeon answers through her experience as an artist who works with the body. Rather than first calculating monetary or exchange value, she immerses herself in the activity itself.
This answer differs from a ranking of jobs that declares artists safe from automation. Dance, too, is affected by livelihood pressures and technological change. What the conversation highlights is an attitude that does not tie life’s value solely to the price of its output. A reason to move your body can remain even on days when you cannot produce something more marketable.
Source: Kyobo Book Centre BORA, original video 14:50. Scene excerpt illustrating this discussion.
There is a little room for this in working people’s lives, too. Not every hobby needs to generate income. A scene from a walk, a long-held question, and tastes that are hard to explain are also part of your life. Treating experiences without immediate results as nothing but waste leaves less room for a distinctive story to grow.
To reflect further on the value of work and life, continue with Questions About Finding Meaning in a World Without Work. The future of productivity and the meaning of life are connected, but they are not the same question.
Having abundant data is different from having personal memories
After the 16-minute mark, Professor Kim contrasts mass production with human uniqueness. He then discusses the difference between information handled by AI and memories from an individual’s life. From this perspective, data describing a fall is not the same as my memory of what I felt when I fell.
Source: Kyobo Book Centre BORA, original video 17:20. Scene excerpt illustrating this discussion.
We should not extend this distinction into a scientific conclusion that AI can never be creative. Current system characteristics, future technological possibilities, and the philosophical meaning of human experience are separate questions. The title’s absolute wording is better read as a prompt to consider human life, not a proven technical limit.
A practical question remains. What would change if I removed myself from my work? If only explanations available anywhere remain, strengthen your observation and judgment before adding more information. Conversely, relying only on personal experience while skipping fact-checking is also a problem. Uniqueness does not exempt anyone from accuracy.
The priority is deciding what to delegate, not adding more agents
The talk ends by encouraging viewers to try AI themselves. It would be risky to interpret ‘many agents’ as a contest over how many you run. When goals are vague or verification costs are high, automation can create more work. The following suggestions draw on the conversation. They are not a procedure presented verbatim by the speakers.
Choose one repetitive task. Start with work whose results are easy to compare, such as classifying materials or organizing drafts.
Write down completion criteria first. Define the evidence needed, the items that must not be omitted, and the cost of an error.
Keep a human approval checkpoint. Separate actions that are difficult to reverse, such as payments, public publishing, and personal data processing.
Record both time saved and time spent reviewing. Check the actual net benefit rather than relying on the feeling that things are faster.
Use the remaining time to develop your own perspective. Observe the field, meet people, and collect questions that existing answers have missed.
For help choosing specific tools, see Comparing AI Agent Tools for Work Automation. However, tool selection and successful automation are separate matters. First decide what to delegate and what to remain personally responsible for.
Frequently asked questions
Is learning knowledge and skills unnecessary in the AI era?
No. Professor Kim Dae-sik also recommends learning to use AI and studying vibe coding. Saying knowledge alone makes differentiation harder is different from saying knowledge is unnecessary. Evaluating results still requires an understanding of the relevant field.
Does human uniqueness mean the same thing as personal branding?
The video also mentions personal brands. But reducing uniqueness to a promotional slogan misses the discussion of experience and memory. Its foundation is the choices you have made and what you care about. Branding is closer to how you communicate those things.
Will AI replace every task with a correct answer?
The video contains strong predictions of replacement, but these are not established employment forecasts. Actual adoption also involves data quality, error costs, responsibility, regulation, and face-to-face relationships. Testing individual tasks is better than treating an entire occupation as one unit.
Is it true that AI can never match human experience?
This video alone cannot establish grounds for such a categorical claim. The speakers emphasize memories lived through the body and the uniqueness of individual lives. It is best not to turn this into a verified claim of impossibility for all future AI.
After producing more, what will you keep?
This conversation is hard to read as a call to abandon technology and cling only to humanity. Instead, it leaves two tasks to pursue together. Learn how to share repetitive work with AI. And use the resulting time for a life that is not a copy of someone else’s.
Today’s first step can be small. Write down one repetitive task to try delegating and one activity you want to continue without calculating its efficiency. The former changes how you work. The latter gives you a way to describe yourself beyond work.
Key sections: 03:36 Production and new stories / 06:00 Four categories of work / 08:20 Emotional risks in organizations / 14:37 Immersion in the act itself / 16:15 Uniqueness and memory / 19:09 Encouragement to use AI.
Images in the body are scene excerpts used to illustrate the corresponding discussions in the original video. The source is Kyobo Book Centre BORA, and each image includes its video timestamp. Automatic captions contain recognition errors, so sentences have been reconstructed around their meaning. The talk’s predictions, survey figures, and unnamed corporate examples are distinguished from independently verified facts.
Planning a November trip is easier when you choose the scenery before the date. Your destination depends on what you want: red autumn leaves, a walk through reeds, or a city worth staying in after sunset.
Our recommended destinations in Korea for November 2026 are Naejangsan, Baegyangsa Temple, Damyang’s Metasequoia Road, Suncheon Bay Wetland, Gyeongju, Seoul Forest, and Sangumburi on Jeju. The choices range from mountain trips to half-day city walks, with walking demands and transportation both taken into account.
The guide below distinguishes official information checked on October 26, 2026, from suggested itineraries. It does not guarantee peak foliage or the condition of reeds and silver grass on any particular date. Check each site’s notices again just before visiting for opening hours, fees, and access restrictions.
An easy way to choose a November destination in Korea
If autumn foliage is your main priority: Choose Naejangsan or Baegyangsa Temple. Check recent on-site updates just before deciding.
If you prefer walking among trees to climbing hills: Choose Damyang’s Metasequoia Road. It suits an itinerary with plenty of time for meals and breaks.
If you want wide-open autumn scenery rather than leaves: Consider the reeds at Suncheon Bay Wetland or the silver grass at Sangumburi on Jeju.
If you want sights to enjoy regardless of the foliage: Gyeongju combines historic sites with nighttime views.
If you have no time to travel far: A half-day outing centered on Seoul Forest is enough.
Early in the month, check conditions at potential foliage destinations first. For mid- to late-month trips, include walks, historic sites, and indoor breaks. This is not a confirmed peak-foliage forecast. It is a way to plan for fallen leaves or changing weather.
1. Naejangsan, Jeongeup — A day centered on autumn leaves
Naejangsan is a natural first choice for travelers seeking late-autumn mountain scenery. The Korea National Park Service’s official page also highlights Uhwajeong Pavilion and the foliage tunnel on the Nature Love Trail. You need not think of it as a place where a trip is incomplete without reaching the summit.
For a light outing, focus your walk on Uhwajeong Pavilion and the route toward Naejangsa Temple, allowing plenty of time for the return. That is our recommendation. If you want to hike, choose a separate route. Adding a ridge hike to a walking itinerary changes both the equipment needed and your return time.
This year, the park service has posted a ‘2026 Autumn Peak Season Vehicle Access Restriction Notice for Naejangsan National Park.’ Do more than enter your destination into navigation and set off. First check which sections allow vehicles and how to travel onward after parking. If you plan to use the cable car, check its operating status and queues separately.
When traveling with your parents, prioritize less waiting over seeing more. Limit the day to a walk and a meal. If you are coming from far away, consider staying overnight in Jeongeup.
2. Baegyangsa Temple, Jangseong — Take your time around the temple and valley
Baegyangsa Temple sits below Baegamsan in Jangseong, South Jeolla Province. Its official guide lists Ssanggyeru Pavilion, the temple halls, and mountain hermitages separately. Treat a visit around the temple and a hike on Baegamsan as different itineraries.
Our suggested route is a walk along the approach → the area around Ssanggyeru Pavilion → the temple grounds → a meal. Even if you are visiting for photography, leave time to linger rather than continually extending your route. This is especially true if you want to enjoy the temple’s atmosphere.
Naejangsan and Baegyangsa belong to the same national park area, but visitors approach each by different vehicle routes. We do not recommend packing both into one day during peak foliage season simply because they look close together. Choose one as your main destination and keep the other as an option for the next day.
Explore the temple grounds quietly so you do not disturb worship or religious practice. After rain, watch out for wet leaves and steps.
3. Metasequoia Road, Damyang — Walk among towering trees
Damyang’s Metasequoia Road suits those who would rather walk a tree-lined path than climb a mountain. Unlike a trip focused on red maple leaves, this is about the atmosphere of the whole avenue. The scenery changes with the trees’ color and how many leaves have fallen.
Walk along Metasequoia Road → eat in Damyang → visit Juknokwon Bamboo Garden if time allows is our suggested sequence. If you include both walking attractions, avoid shortening meals or cafe breaks to squeeze in another stop. Combining walking routes can be more tiring than expected.
When traveling with parents or young children, adjust the walking distance as you go. Leaving enough energy for the return matters more than reaching the end of the entire road. Metasequoia Road and nearby facilities may have different admission areas and fees. Check the facility name on the booking or ticketing screen.
4. Suncheon Bay Wetland — Wide views of reeds and sky
Consider Suncheon Bay Wetland if you do not want your trip to depend entirely on leaf colors. Its reeds and tidal flats create an atmosphere different from mountain foliage. It is a place to enjoy changing views as you walk, rather than just a single photograph.
Here, distinguish a walk along the reed trails from a route that includes Yongsan Observatory. Reaching the observatory involves an uphill walk and a return journey, so choose from the outset according to your companions’ fitness. For strollers or walking aids, it is safer to check accessible sections separately in the official guidance.
According to the official guide, ticket sales and admission run from 08:00 to 17:00 from November through February. Visitors may stay for up to 1 hour after the admission cutoff. If you are going for the sunset, check Suncheon Bay Wetland’s opening hours alongside that day’s sunset time. The official guide describes Yongsan Observatory as roughly a 30-minute uphill walk from the Yongsan entrance. This is not the total time from entering the wetland. Avoid arriving just before sunset and rushing to the observatory. Stay on designated paths in the tidal flats and wetland, and do not feed or approach the birds.
Despite their similar names, Suncheon Bay Wetland and Suncheon Bay National Garden are not the same place. If you visit both, allow separate travel and sightseeing time for each. Rather than trying to see everything in one day, you can make the wetland your main destination if that suits your interests.
Check the regular closing day, too. The official Suncheon Bay Wetland website lists the Monday of the last week of each month as its regular closing day. If you plan a Monday visit, check for any special operating notices before setting your itinerary.
5. Gyeongju — Historic sites by day, illuminated views by night
Gyeongju is a good choice even if you miss peak foliage. Split your goals between day and night: explore Daereungwon and nearby historic sites, then visit Donggung Palace and Wolji Pond in the evening.
Our suggested sequence is a walk around Daereungwon → a meal and a break on Hwangnidan-gil → an evening visit to Donggung Palace and Wolji Pond. This is a suggested itinerary. Adjust it after checking admission and ticketing cutoffs, as well as events on your actual visit date.
Check visiting information and fees for Daereungwon and Cheonmachong Tomb separately. Donggung Palace and Wolji Pond are also a separate visitor attraction. Treating the admission conditions of several attractions as one set of information can disrupt your plans on arrival.
Arriving at Gyeongju Station does not mean you can immediately begin a walking tour of the historic sites. Arrange your journey from the station to the city center and your return transportation first. If you book accommodation, also consider the route back after your evening visit.
6. Seoul Forest — Half a day of autumn without traveling far
A trip does not have to involve an overnight stay or long-distance travel. Seoul Forest is an urban park in Seoul’s Seongdong District. It works well for a short walk followed by a meal or tea in Seongsu-dong.
Walk in Seoul Forest → eat or visit a cafe in Seongsu-dong is a simple plan to try. Rather than tracking down every photo spot, pause wherever you find a stretch you like. That approach suits a half-day outing. If you are hoping for golden ginkgo trees in a specific area, check recent on-site updates before leaving.
Distinguish access to the outdoor park from the operating hours of individual facilities. According to Seoul’s official guide, the Insect Botanical Garden opens from 10:00 to 16:00 from November through February, with last admission at 15:30. It is closed on Mondays. The Butterfly Garden is listed as operating from May through October, so it is best left out of a November itinerary. If you are bringing children, check opening hours for individual Seoul Forest facilities.
On weekends, check public transportation routes first rather than letting parking availability dictate your plans. This is an option for enjoying autumn even when you cannot travel to a distant region.
7. Sangumburi, Jeju — Enjoy the silver grass, but watch the wind
Sangumburi is worth considering if you are looking for late-autumn scenery on Jeju. It combines a volcanic crater landscape with silver grass. The atmosphere differs from foliage-focused trips on the mainland.
Our suggested itinerary is visit Sangumburi → eat nearby → add one nearby stop depending on the weather and your energy. Staying in one area reduces travel demands. There is no need to combine eastern and western attractions in one day simply because you are visiting Jeju.
Sangumburi is an outdoor attraction. Strong winds can change how a walk feels even in sunshine, so bring a windbreaker and shoes with good grip. Bear in mind that the silver grass and weather may not produce the photographs you imagined.
Before booking flights, accommodation, or a rental car, check cancellation and change conditions. In bad weather, do not force yourself to keep an outdoor itinerary. Leave room to switch to an indoor attraction near your accommodation or simply rest.
Day trip or one-night stay: How much should you combine?
For half a day in the Seoul metropolitan area, choose Seoul Forest. For a full day focused on one foliage destination, we recommend Naejangsan or Baegyangsa Temple. Whether a day trip is feasible depends on your starting point. If round-trip travel takes a long time, decide whether to stay overnight before adding attractions.
For a two-day, one-night trip in South Jeolla, consider spending one day at Baegyangsa in Jangseong and the other in Damyang. If you choose Suncheon Bay Wetland, staying in Suncheon and exploring nearby will allow a more relaxed pace. Gyeongju suits two days and one night with evening sightseeing. Treat Jeju as a separate itinerary that accounts for air travel.
Recent on-site conditions: Foliage forecasts and actual observations are different. Use the 2026 Nationwide Autumn Foliage Map to understand regional trends, then check official on-site updates.
Last admission: Checking only closing time could leave you too late. Check the ticket sales cutoff and last admission separately.
Your route after parking: Check the distance from the parking lot to your destination, shuttle and public transportation services, and how you will return.
The difference between walking and hiking: Including an observatory or ridge changes the preparation required. Check national park restrictions and your companions’ fitness first.
If you want a hike rather than a stroll in the Seoul metropolitan area, consult A Hiking Account from Namhansanseong separately. Do not assume it demands the same walking effort as an outing to a city park.
Frequently asked questions about November travel in Korea
Am I guaranteed to see autumn leaves at Naejangsan and Baegyangsa in November?
No guarantee is possible. Even within one area, conditions vary by elevation, tree species, temperature, wind, and rain. Check booking change conditions when reserving. Reassess just before departure using official on-site updates and access restrictions.
Where should I go with my parents?
Start with places where you can adjust the walking distance, such as Damyang’s Metasequoia Road or Seoul Forest, rather than long hikes. Even flat paths can become demanding over long distances. Check parking and drop-off points, toilets, rest areas, and which sections are actually accessible.
Which destinations work without a car?
Seoul Forest is our first recommendation on this list. In Gyeongju, you can combine rail travel with local transportation, but you still need to travel between the station and attractions. For Naejangsan, Baegyangsa, and similar destinations, check local transportation on your visit date and the last return service before choosing.
Should I cancel if it rains?
You do not need to cancel every trip, but reassess hikes and exposed outdoor routes. Follow strong-wind or heavy-rain advisories and visitor access restrictions. Watch for wet leaves and steps, too. If switching to an indoor attraction, check its closing days and whether reservations are required.
November travel becomes more relaxed when you choose one kind of scenery instead of trying to include every attraction. For autumn leaves, choose Naejangsan or Baegyangsa. For expansive autumn landscapes, choose Suncheon Bay Wetland or Sangumburi. Match that choice to your walking range and travel time, and you have a late-autumn trip that suits you.
Work gets faster when AI drafts content and summarizes materials for us. But does doing more at that faster pace always produce better results? If incorrect information slips in, we may also release more work without checking it.
In a STUDIO LOLA interview, cognitive psychologist Professor Kim Kyung-il says AI has made his work easier but also made him more vigilant. The concern is not just the possibility of being replaced. He also worries about trusting incorrect AI content or citing it without verification. The video’s central concern is not that we should use AI less. Instead, it can be understood as a call to rebalance the time spent generating content and exercising judgment.
The More Convenient AI Becomes, the More We Must Distinguish Finding from Verifying
Finding the information we wanted used to take considerable time. It was easy to see a hard-won answer as an achievement. Now a question immediately produces fluent sentences and organized lists. But getting an answer and knowing it is correct are different things.
Kim is particularly wary of readily trusting AI’s plausible answers. Fluent writing can make information feel as though someone has already reviewed it. Copy an AI explanation into a report or teaching materials, and you pass along unverified claims under your own name.
Source: STUDIO LOLA, original video at 06:00. Frame quoted to illustrate the discussion.
The video also presents a strong view that language model hallucinations will persist. We need not interpret this as permanent proof of the limits of future technology. The practical message is clearer: Check the answers from today’s AI on the assumption that they may contain errors.
Do Not Fill All the Time You Save with More Work
Kim says agentic AI has helped him handle more work faster. Yet he remains vigilant because he feels he may also be making more mistakes. This is a personal impression, not a productivity statistic or experimental finding that applies to everyone.
What follows is the important point. Rather than making speed the sole goal, he says we need quiet time afterward to check, reflect, and verify.
Applying this perspective changes how we evaluate AI use at work. We should consider not just drafting speed, but also the process of finding errors, correcting them, and finalizing the work. Generation may be faster, but fact-checking and rework can still take considerable time. Perceived speed and actual performance may therefore differ.
The following practical workflow draws on the concerns raised in the interview. It is not a formula or measurement scale validated in the video. It is a sequence for making sure verification does not get overlooked.
Generate: Give AI the purpose, audience, and scope of materials, then request a draft.
Separate: Label factual claims, opinions, estimates, and proposed actions separately.
Verify: Check figures, quotations, laws, and proper names against the original sources.
Judge: Remove statements with insufficient support or explicitly state the uncertainty.
Approve: Have the person responsible perform a final check before external delivery, publication, or execution.
Asking AI for another review can help. But agreement from another answer cannot replace checking the original source. What matters is not the number of reviews, but which evidence and actual results you checked against.
Do Not Reduce a Profession to a Single Digital Task
The interview uses radiology to show that a profession involves more than its most visible specialist task. Beyond interpreting images, the work includes persuading patients, coordinating with other medical professionals, securing organizational resources, and taking responsibility when problems arise.
This discussion does not treat the video’s claims about salary changes or task proportions as verified statistics. Instead, it offers a way to understand professions: distinguish an easily automated task from the relationships, circumstances, and responsibilities surrounding it.
Training professionals’ work can be divided in a similar way. AI can help write announcements and summarize surveys. But persuading reluctant employees, coordinating training schedules with operational departments, and reconciling different stakeholders’ needs remain separate tasks.
This does not guarantee that any profession will remain safe forever. It means we should not judge automation potential by job titles or only the most conspicuous technical tasks.
Collaboration Skills Come from Working Together, Not Just Knowing the Theory
Kim also emphasizes understanding people unlike ourselves and gaining experience working with them. He cautions against giving up on collaboration simply because people differ in age, gender, or cultural background.
Source: STUDIO LOLA, original video at 09:20. Frame quoted to illustrate the discussion.
Knowing that empathy matters is different from actually reaching agreement with someone. We learn by hearing why someone interprets the same proposal differently, changing our explanations, and repairing relationships after conflict.
Talking only to AI makes feedback easy to obtain, but it does not eliminate real people’s objections or hesitation. Developing collaboration skills requires keeping opportunities to work with people.
Explain a draft to a colleague in a different role and listen to what they find unclear.
When opinions clash, first identify the conditions the other person wants to preserve and the risks they fear.
Try explaining the same content separately to a manager, a practitioner, and a user.
After finishing, reflect not only on the result but also on what you missed during coordination.
These activities need not be seen as the opposite of using AI. Use AI to organize materials and draft content. Then you can spend the time saved meeting people and understanding context.
Studying the Humanities in the AI Era Is Not a Retreat from Reality
In the interview, the humanities are not decorative knowledge detached from a changing world. Kim explains their role through the growing need to understand people at historical turning points.
Source: STUDIO LOLA, original video at 05:10. Frame quoted to illustrate the discussion.
Learning AI’s capabilities can go hand in hand with learning about people. That means understanding what technology can do while considering who receives its output and the circumstances in which they use it.
For example, an automatically written notice may be grammatically correct yet unhelpful to users. A survey summary may look accurate while overlooking conditions on the ground. That is why skill with tools needs judgment about people and situations.
Five Things to Check in the Work You Create with AI Today
The phrase ‘people becoming less intelligent’ in the video’s title should not automatically be read as a research finding about cognitive decline. The interview poses a practical question: as tools become more convenient, are we unthinkingly handing over our judgment too?
Before releasing your next piece of work, ask five questions.
Can I distinguish facts I checked myself from explanations supplied by AI?
Did I actually open the sources I cited and check their context?
Have I considered who would be affected if this result were wrong?
Did I spend some of the time AI saved on checking and reflection?
Did I revise anything after listening to actual users or colleagues?
Competitiveness in the AI era cannot be explained solely by how quickly we produce more output. Kim’s interview shifts attention toward checking quickly generated answers and gaining experience working with people unlike ourselves. The starting point is to enjoy the convenience without handing over judgment and responsibility.
Does heavy AI use necessarily weaken thinking skills?
This interview alone cannot establish that causal relationship. The central point is not how much AI we use. It is to be careful about trusting AI explanations without checking them and surrendering our judgment.
How should I verify AI answers?
Separate statements that require checking, such as figures, quotations, and laws, then compare them against original sources and actual materials. Remove unsupported claims or mark the uncertainty. Do not consider verification complete merely because another AI gave the same answer.
Why does collaboration experience matter in the AI era?
Work involves not only processing information but also persuading people, coordinating interests, and taking responsibility for outcomes. The interview emphasizes that these abilities develop through experience working with different people.
How should I use the time AI saves?
Rather than spending it all on more work, reserve some for reviewing output, checking original sources, reflecting, and listening to actual users and colleagues. Instead of a fixed time ratio, let the work’s risks and required level of verification guide you.
The images are video frames quoted to explain and critique the interview. The speaker’s views and personal impressions are distinguished from general research findings. The practical checklist was adapted from the concerns raised in the interview.