[태그:] 생성형 AI

  • OpenHuman AI 에이전트란? 로컬 기억을 가진 오픈소스 AI 비서의 가능성과 한계

    OpenHuman AI 에이전트가 주목받는 이유는 단순히 “또 하나의 챗봇”이 아니기 때문입니다. 이 프로젝트는 대화창 하나보다 더 큰 그림을 겨냥합니다. 개인의 파일, 메모, 앱, 웹 리서치, 자동화 흐름을 하나의 AI 작업 환경으로 묶으려 합니다.

    Read in English: What Is the OpenHuman AI Agent? The Promise and Limits of an Open-Source AI Assistant with Local Memory

    공식 GitHub 저장소의 설명을 빌리면 OpenHuman은 “로컬 우선 기억을 만드는 두뇌, 에이전트 함대를 운영하는 오케스트레이터, 깊이 있는 리서처”를 지향합니다. 표현은 다소 크지만, 방향은 분명합니다. AI가 매번 새로 묻는 비서가 아니라, 사용자의 세계를 계속 기억하고 움직이는 작업 시스템이 되겠다는 것입니다.

    OpenHuman은 어떤 프로젝트인가

    OpenHuman은 tinyhumansai/openhuman 저장소에서 공개된 오픈소스 AI 에이전트 플랫폼입니다. 공식 저장소 기준으로 주 언어는 Rust이며, 라이선스는 GPL-3.0입니다. 2026년 7월 기준 최신 릴리스는 v0.61.8이고, README에는 Early Beta 상태라고 명시되어 있습니다.

    핵심은 세 가지입니다.

    1. 개인 데이터를 로컬 중심으로 기억하는 구조
    2. 여러 에이전트와 워크플로를 운영하는 오케스트레이션 구조
    3. 웹, 파일, 브라우저, 음성, 리서치 도구를 묶은 실행 환경

    그래서 OpenHuman은 ChatGPT나 Claude 같은 모델 자체라기보다, 여러 모델과 도구를 실제 업무 흐름에 연결하는 “에이전트 하네스”에 가깝습니다.

    첫 번째 차이: 로컬 우선 메모리

    OpenHuman이 가장 강하게 내세우는 지점은 기억입니다. README는 Memory Tree와 Obsidian Wiki를 함께 언급합니다. 사용자의 데이터를 SQLite와 Markdown 트리로 정리하고, 사람이 열어볼 수 있는 Obsidian 볼트와 연결한다는 설명입니다.

    이 접근은 중요합니다. 많은 AI 도구가 “기억합니다”라고 말하지만, 사용자는 그 기억이 어디에 저장되는지, 어떤 기준으로 검색되는지, 잘못된 기억을 어떻게 고치는지 알기 어렵습니다. OpenHuman은 적어도 방향성 면에서 블랙박스형 기억보다 편집 가능한 지식 구조를 지향합니다.

    물론 실제 품질은 따로 확인해야 합니다. 메모리 구조가 좋아 보여도, 자동 수집된 정보가 중복되거나 오래된 내용으로 쌓이면 오히려 방해가 될 수 있습니다. 개인 지식 시스템은 “많이 저장”보다 “잘 정리하고 쉽게 고치는 것”이 더 중요합니다.

    두 번째 차이: 에이전트 오케스트레이션

    OpenHuman은 단일 비서보다 에이전트 오케스트레이션을 강조합니다. 워크플로를 만들고, 트리거 기반으로 실행하고, 승인 게이트를 둔 자동화를 지향합니다. README에서는 tinyflows, tinyagents 같은 하위 오픈소스 구성요소도 언급합니다.

    이 방향은 요즘 AI 에이전트 흐름과 잘 맞습니다. 업무 자동화는 더 이상 “프롬프트를 잘 쓰는 법”만으로 끝나지 않습니다. 어떤 작업을 언제 실행할지, 실패하면 어떻게 재시도할지, 사용자의 승인이 필요한 지점은 어디인지가 더 중요해졌습니다.

    OpenHuman이 흥미로운 이유도 여기에 있습니다. 개인 AI 비서가 실제 업무에 들어오려면 대화 능력보다 실행 구조가 필요합니다. 일정 확인, 회의 요약, 파일 조사, 리서치, 코드 작업, 보고서 초안 작성이 하나의 흐름으로 이어져야 합니다.

    세 번째 차이: 리서치와 실행 도구의 결합

    OpenHuman은 웹 검색, 스크래핑, 브라우저, 코딩 도구, 음성, 미팅 에이전트 같은 기능을 소개합니다. 공식 문서 표현으로는 SuperContext라는 개념도 있습니다. 사용자가 질문을 끝내기 전에 로컬 기억과 파일, 웹을 먼저 훑어 맥락을 확보한다는 방향입니다.

    이 구조가 제대로 작동하면 장점은 큽니다. AI가 “무엇을 알고 있는지”부터 다시 설명하지 않아도 됩니다. 업무 맥락, 파일 위치, 최근 대화, 관련 문서를 먼저 보고 답할 수 있습니다.

    다만 이런 도구형 에이전트는 권한 설계가 핵심입니다. Gmail, Slack, Notion, GitHub 같은 계정을 연결하면 편리하지만, 동시에 민감한 정보 접근 권한도 커집니다. 자동 실행 기능이 있는 도구라면 더 조심해야 합니다. 어떤 데이터가 로컬에 남고, 어떤 요청이 외부 모델 API로 전송되는지 확인해야 합니다.

    OpenHuman을 써볼 만한 사람

    OpenHuman은 모든 사람에게 필요한 도구는 아닙니다. 오히려 다음 조건에 가까울수록 관심을 가져볼 만합니다.

    • Obsidian, Markdown, 로컬 파일 기반 지식관리를 이미 쓰고 있다.
    • AI 비서를 단순 질의응답보다 업무 자동화에 연결하고 싶다.
    • Gmail, Notion, GitHub, Slack 등 여러 도구의 맥락을 한곳에서 다루고 싶다.
    • AI 에이전트 워크플로, MCP, Skills 같은 확장 구조에 관심이 있다.
    • 베타 도구의 불안정성을 감수하고 테스트할 수 있다.

    반대로 “설치해서 바로 안정적으로 쓰는 업무용 도구”를 기대한다면 조금 기다리는 편이 낫습니다. 공식 저장소도 Early Beta라고 밝히고 있습니다. 데이터 접근 권한이 큰 도구일수록 베타 단계에서는 작은 테스트부터 시작해야 합니다.

    설치할 때 확인할 점

    공식 INSTALL 문서는 운영체제별 네이티브 설치를 우선 권장합니다. macOS는 Homebrew tap, Ubuntu/Debian은 GitHub Releases의 .deb, Windows는 MSI 설치 파일을 사용할 수 있습니다.

    주의할 점도 있습니다. 설치 스크립트 방식은 편하지만, 공식 문서에서도 별도 서명 검증이 제한적이라고 설명합니다. 그래서 가능하면 운영체제의 표준 설치 방식이나 릴리스 파일을 사용하는 편이 안전합니다.

    또 하나는 Linux 환경입니다. INSTALL 문서는 AppImage가 Wayland나 일부 시스템 라이브러리 문제로 충돌할 수 있다고 안내합니다. Debian/Ubuntu라면 .deb 설치가 더 안정적인 선택일 수 있습니다.

    OpenHuman을 평가할 때 볼 기준

    OpenHuman 같은 에이전트 플랫폼은 기능 목록만 보고 판단하면 안 됩니다. 실제 평가 기준은 조금 다릅니다.

    1. 기억이 편집 가능한가

    AI가 무엇을 기억하는지 사용자가 볼 수 있어야 합니다. 틀린 기억을 고칠 수 있어야 하고, 오래된 맥락을 지울 수 있어야 합니다.

    2. 자동화에 승인 지점이 있는가

    좋은 에이전트는 모든 것을 마음대로 실행하지 않습니다. 메일 발송, 파일 수정, 외부 게시, 결제 같은 작업에는 명확한 승인 단계가 필요합니다.

    3. 실패했을 때 원인을 남기는가

    에이전트는 반드시 실패합니다. 중요한 것은 실패하지 않는 척하는 것이 아니라, 어디서 막혔고 어떤 로그나 재시도 경로가 있는지 보여주는 것입니다.

    4. 외부 모델로 나가는 데이터가 명확한가

    로컬 우선이라는 표현만으로는 충분하지 않습니다. 어떤 데이터가 로컬에 있고, 어떤 데이터가 외부 API로 전송되는지 확인해야 합니다.

    5. 내 기존 워크플로와 충돌하지 않는가

    AI 도구는 업무 방식을 바꿉니다. 좋은 변화일 수도 있지만, 기존 파일 구조와 협업 방식에 혼선을 줄 수도 있습니다. 먼저 작은 프로젝트에서 시험하는 것이 좋습니다.

    Hermes Agent와 비교해 보면

    OpenHuman은 개인 데스크톱 AI 운영체제에 가까운 인상을 줍니다. 로컬 기억, Obsidian 위키, 다양한 앱 연동, 백그라운드 루프를 전면에 내세웁니다.

    반면 Hermes Agent는 작업 실행, 도구 호출, 스킬, 크론, 워크스페이스 기반 자동화에 강점이 있습니다. 사용자가 이미 정해둔 프로젝트 폴더와 절차 안에서 조사, 작성, 업로드, 검증까지 이어가는 방식에 가깝습니다.

    두 도구는 경쟁 관계라기보다 관점이 다릅니다. OpenHuman은 “개인 AI 환경 전체”를 만들려는 쪽이고, Hermes는 “도구를 실제 작업으로 끝까지 실행하는 에이전트 런타임”에 가깝습니다. AI 에이전트 시대에는 이런 차이가 더 중요해질 것입니다. 모델보다 하네스와 기억 구조가 실제 생산성을 가르기 때문입니다.

    결론: 기대할 만하지만, 작은 테스트부터

    OpenHuman은 AI 에이전트가 어디로 가고 있는지 보여주는 흥미로운 프로젝트입니다. 대화형 챗봇을 넘어 로컬 기억, 워크플로, 리서치, 실행 도구를 하나로 묶으려는 시도입니다.

    하지만 아직 Early Beta입니다. 개인 데이터와 업무 도구를 연결하기 전에는 권한, 저장 위치, 외부 전송 범위, 실패 로그, 자동 실행 범위를 확인해야 합니다. 처음부터 메인 업무를 맡기기보다, 별도 테스트 계정과 작은 폴더에서 시작하는 편이 안전합니다.

    결국 질문은 “OpenHuman이 좋은가?”가 아닙니다. 더 정확한 질문은 이것입니다. 내 지식과 업무 흐름을 AI가 계속 기억하고 실행하게 만들 준비가 되어 있는가. OpenHuman은 그 질문을 꽤 선명하게 던지는 도구입니다.

    함께 읽기

    FAQ

    OpenHuman은 ChatGPT 같은 AI 모델인가요?

    아닙니다. OpenHuman은 특정 모델이라기보다 여러 모델, 도구, 메모리, 워크플로를 연결하는 AI 에이전트 플랫폼에 가깝습니다.

    OpenHuman은 무료인가요?

    공식 GitHub 저장소는 GPL-3.0 라이선스의 오픈소스 프로젝트입니다. 다만 실제 사용 과정에서 외부 모델 API, 연동 서비스, 구독 기능이 필요할 수 있으므로 비용 구조는 설치 후 별도로 확인해야 합니다.

    OpenHuman의 가장 큰 장점은 무엇인가요?

    로컬 우선 메모리와 에이전트 오케스트레이션을 함께 지향한다는 점입니다. 단순 대화형 AI가 아니라 사용자의 파일, 앱, 목표, 자동화 흐름을 연결하려는 구조입니다.

    지금 업무에 바로 써도 될까요?

    공식 저장소가 Early Beta라고 밝히고 있으므로, 핵심 업무에 바로 적용하기보다는 테스트 계정과 제한된 데이터로 먼저 검증하는 것이 좋습니다.

    설치할 때 가장 조심할 점은 무엇인가요?

    계정 연동 권한과 설치 방식입니다. 가능하면 공식 릴리스의 네이티브 패키지를 사용하고, Gmail·Slack·GitHub 같은 민감한 계정은 최소 권한으로 연결해야 합니다.
    참고자료

  • Claude 코워크로 1인 AI 비서 만들기: Gmail·Notion·카카오톡 자동 브리핑

    Claude 코워크로 1인 AI 비서 만들기: Gmail·Notion·카카오톡 자동 브리핑

    Claude를 단순히 “질문에 답하는 챗봇”으로만 쓰면 금방 한계가 옵니다. 메일을 읽고, 할 일을 정리하고, 일정과 날씨를 확인해 아침마다 보고해 주는 구조까지 만들면 이야기가 달라집니다. 이번 글은 소소한 AI 입문노트 영상의 흐름을 바탕으로 Claude 코워크와 Gmail, Notion, PlayMCP를 연결해 1인 AI 비서 워크플로우를 만드는 방법을 정리했습니다.

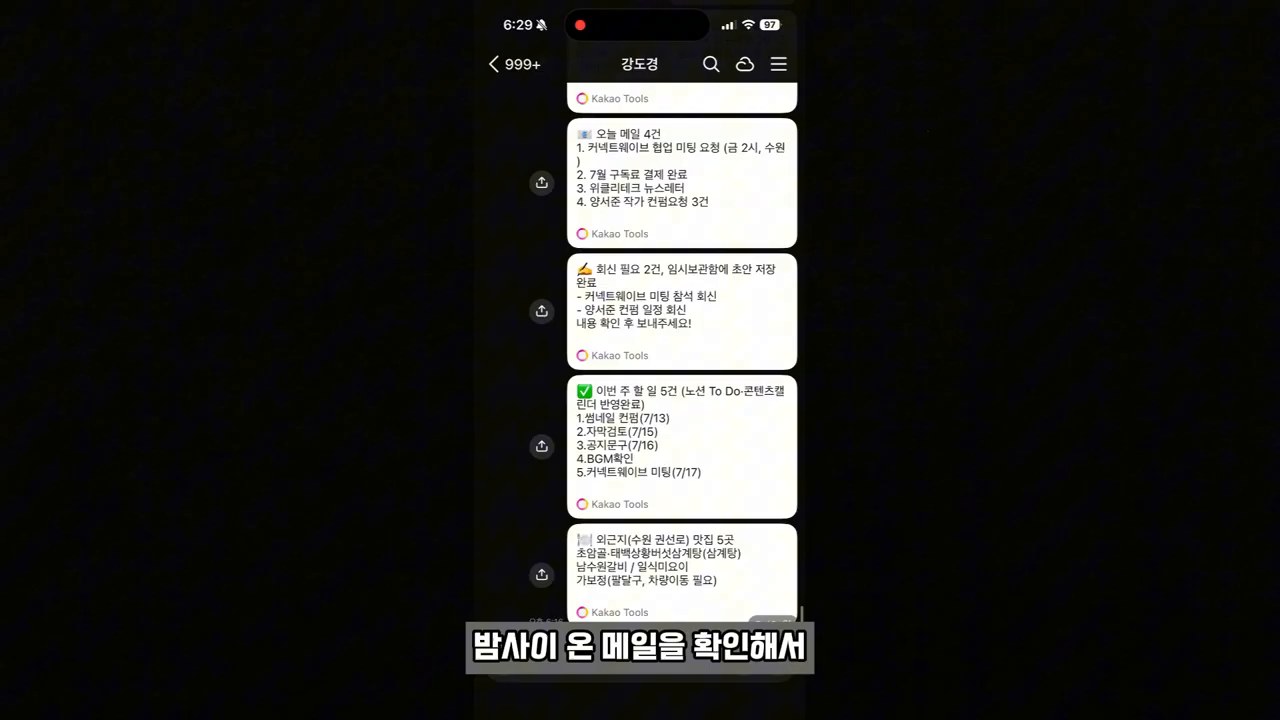
    카카오톡으로 도착한 Claude AI 데일리 브리핑 예시
    카카오톡으로 도착한 AI 데일리 브리핑 예시 · 원본 영상 캡처

    핵심은 프롬프트가 아니라 반복 업무의 흐름입니다

    영상에서 가장 중요한 장면은 “좋은 프롬프트 하나”가 아닙니다. Gmail에서 메일을 읽고, 답장 초안을 만들고, Notion에 할 일을 정리하고, PlayMCP를 통해 날씨와 카카오톡 브리핑까지 이어 붙이는 전체 흐름입니다.

    이 차이가 큽니다. 단발성 질문은 매번 사람이 다시 상황을 설명해야 합니다. 반면 업무 흐름은 한 번 설계해 두면 매일 같은 시간, 같은 기준, 같은 출력 형식으로 돌아갑니다. AI를 업무에 쓰는 사람과 AI로 업무 시스템을 만드는 사람의 차이가 여기서 갈립니다.
    1단계: Claude 데스크톱에서 Gmail을 연결합니다

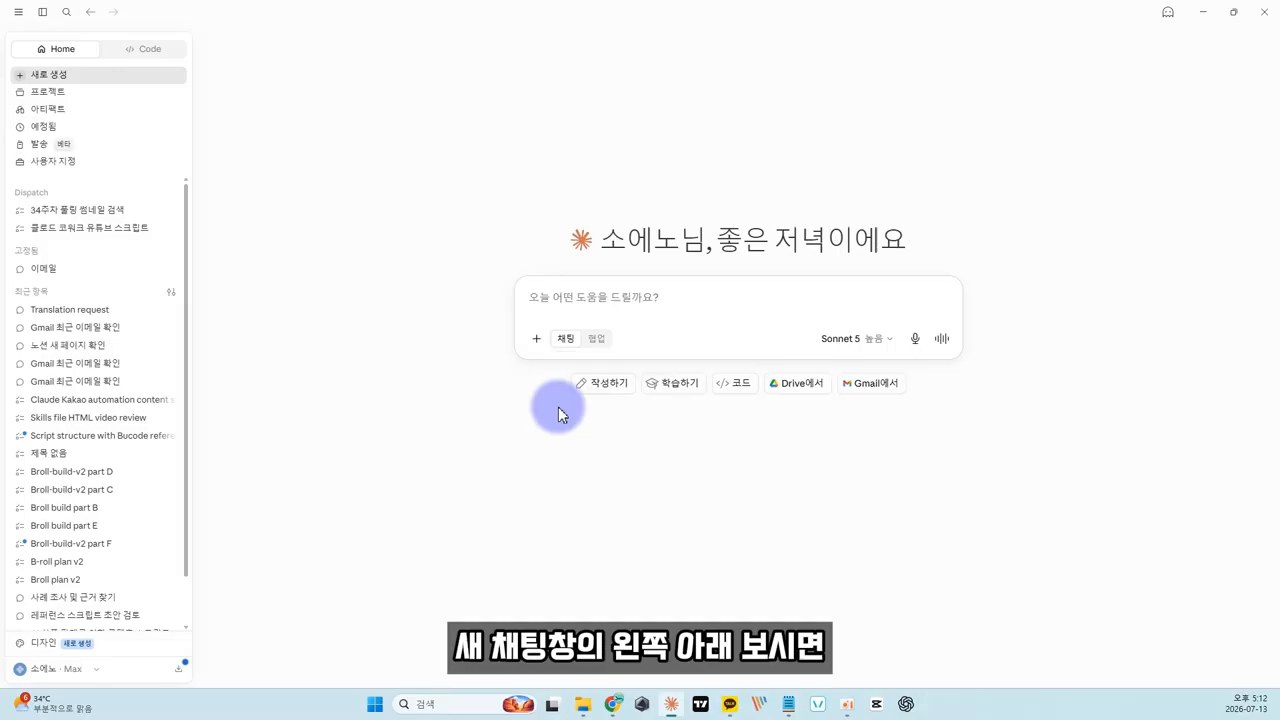
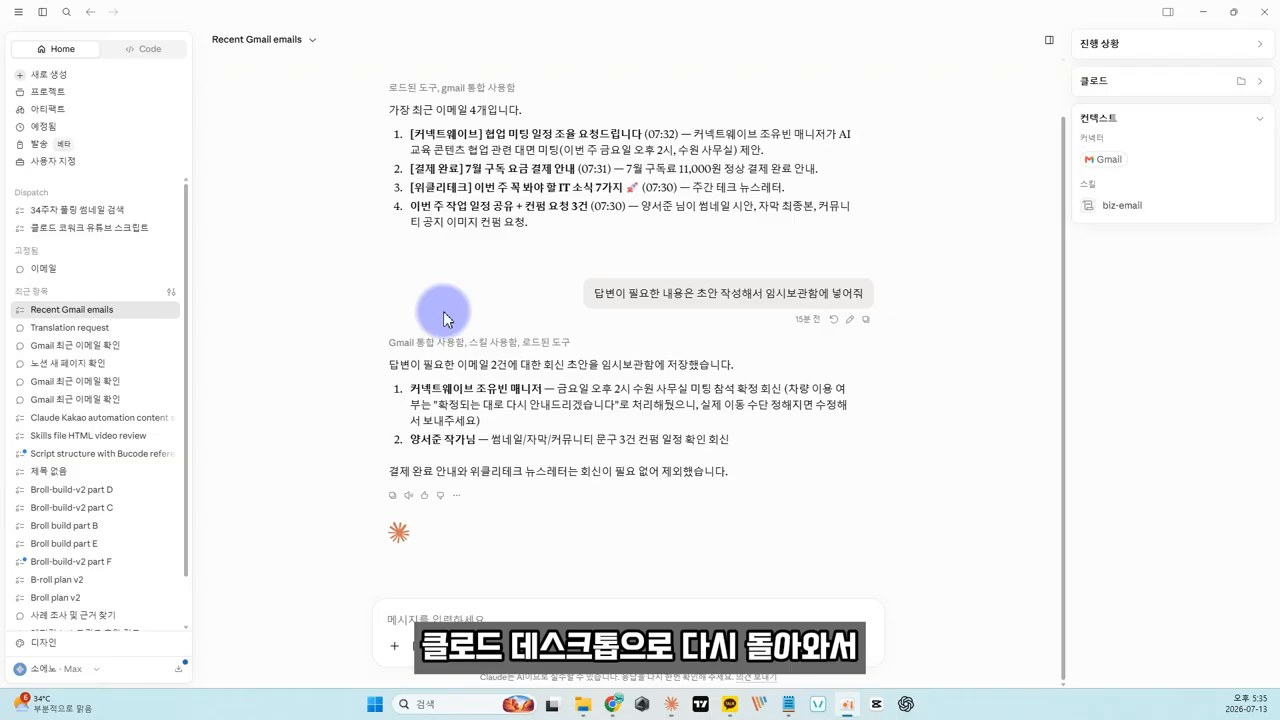
    먼저 Claude 데스크톱 앱에서 사용자 지정 메뉴로 들어가 커넥터를 선택합니다. 영상에서는 Gmail 커넥터를 연결한 뒤, Claude Cowork의 협업 모드에서 “최근에 온 이메일 네 개를 알려줘”라고 요청합니다.

    Claude Gmail 커넥터 연결 화면
    Claude Gmail 커넥터 연결 화면 · 원본 영상 캡처

    여기서 바로 체감되는 기능은 두 가지입니다.

    • 최근 메일을 요약해 오늘 확인해야 할 내용을 빠르게 파악할 수 있습니다.
    • 답장이 필요한 메일은 초안 형태로 만들고, 사용자는 검토 후 보내기만 하면 됩니다.

    다만 메일은 민감 정보가 많습니다. 처음에는 테스트용 메일이나 중요도가 낮은 메일부터 연결해 보세요. Claude가 접근할 작업 폴더도 별도로 만들고, 중요한 문서가 섞이지 않도록 분리하는 편이 안전합니다.

    2단계: Notion에 할 일을 자동으로 정리합니다

    메일 확인만으로는 비서가 아닙니다. 메일 안에 숨어 있는 해야 할 일을 꺼내 실제 작업 목록으로 옮겨야 합니다. 영상에서는 Notion 커넥터를 연결한 뒤 “이번 주 작업 일정을 내 Notion에 투두리스트 페이지로 만들어 넣어 줘”라고 요청합니다.
    Claude 협업 화면에서 Notion 업무 흐름을 구성하는 장면
    Claude 협업 화면에서 업무 흐름을 구성하는 장면 · 원본 영상 캡처

    이 단계의 장점은 메일함과 할 일 목록이 끊기지 않는다는 점입니다. 보통은 메일을 읽고, 따로 메모하고, 다시 Notion이나 투두 앱에 옮기는 과정에서 누락이 생깁니다. Claude가 메일 내용을 읽고 구조화해 주면 사람은 우선순위와 실행 여부만 판단하면 됩니다.

    처음부터 복잡한 대시보드를 만들 필요는 없습니다. 아래처럼 단순한 필드만 있어도 충분합니다.

    • 작업명
    • 관련 메일 또는 요청자
    • 마감일
    • 우선순위
    • 진행 상태
    • 다음 행동

    3단계: PlayMCP로 카카오톡·날씨·지도 정보를 붙입니다

    Gmail과 Notion이 업무 정보를 정리한다면, PlayMCP는 외부 도구와의 연결을 넓혀 줍니다. 영상에서는 PlayMCP에서 카카오톡 나와의 채팅, 카카오맵, 날씨 도구를 도구함에 추가한 뒤 Claude와 연결합니다.

    PlayMCP에서 날씨와 카카오맵 도구를 선택하는 장면
    PlayMCP에서 날씨와 카카오맵 도구를 선택하는 장면 · 원본 영상 캡처

    이렇게 연결하면 브리핑이 훨씬 생활형으로 바뀝니다. 예를 들어 “오늘 일기예보를 확인하고, Gmail에 있던 외근 장소 근처 맛집 다섯 곳을 찾아 카카오톡으로 보내 줘”라고 요청할 수 있습니다. 단순 업무 요약이 아니라 하루를 시작하기 위한 실제 의사결정 자료가 되는 셈입니다.

    여기서 주의할 점도 있습니다. 지도, 날씨, 메신저 도구는 외부 서비스 권한과 연결됩니다. 어떤 계정으로 로그인하는지, 어떤 도구에 어떤 권한을 주는지, 자동 발송 대상이 어디인지 반드시 확인해야 합니다.
    4단계: 스킬과 예약 작업으로 매일 아침 실행합니다

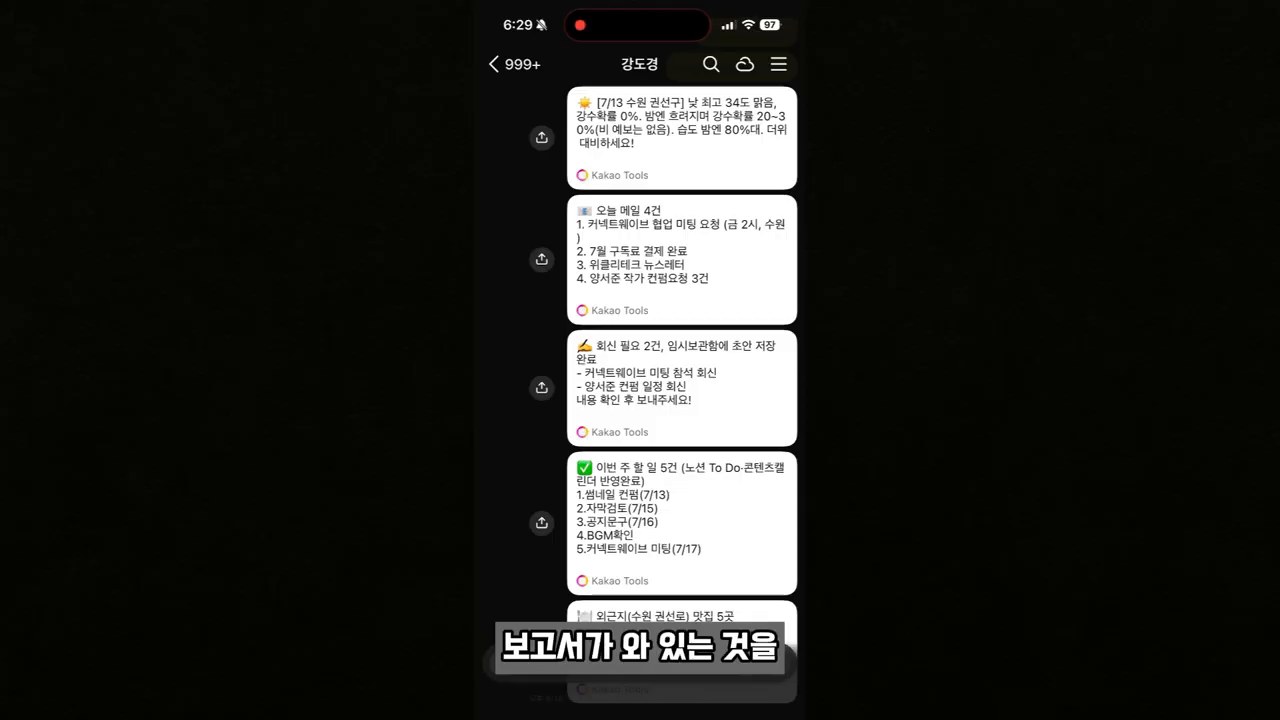
    영상의 마지막 실습은 Claude 안에서 데일리 브리핑 스킬을 만들고, 예약 작업으로 매일 실행되게 설정하는 것입니다. 한 번 만든 스킬은 “메일 확인 → 답장 초안 → Notion 업데이트 → 날씨·외근 정보 확인 → 카카오톡 보고” 같은 순서를 기억합니다.
    카카오톡으로 자동 발송된 데일리 브리핑 결과
    카카오톡으로 자동 발송된 데일리 브리핑 결과 · 원본 영상 캡처

    예약 작업까지 붙이면 사용자가 매번 프롬프트를 입력하지 않아도 됩니다. 아침에 출근 준비를 하는 동안 AI가 먼저 하루의 자료를 정리해 두는 구조가 됩니다.
    이때 승인 건너뛰기나 자동 실행 옵션은 편리하지만 위험도 함께 커집니다. 처음에는 반드시 수동 실행으로 테스트하고, 잘못된 메일 발송이나 민감 정보 노출이 없는지 확인한 뒤 자동화 수준을 높이는 것이 좋습니다.
    따라 하기 전에 확인할 체크리스트

    이 워크플로우를 바로 적용하기 전에 아래 네 가지를 먼저 정리해 보세요.

    1. 매일 반복되는 업무가 무엇인지 정합니다. 메일 확인, 일정 정리, 보고서 초안, 고객 응대처럼 빈도가 높은 작업이 좋습니다.
    2. AI가 접근해도 되는 계정과 데이터 범위를 분리합니다. 개인 메일 전체를 바로 열기보다 테스트 범위를 먼저 정하세요.
    3. 결과물을 받을 채널을 하나로 정합니다. 카카오톡, Notion, 이메일 중 어디에서 확인할지 정해야 흐름이 단순해집니다.
    4. 자동 실행 전 수동 테스트를 3회 이상 해 봅니다. 요약 품질, 누락, 권한, 발송 대상을 확인해야 합니다.

    이 방식이 맞는 사람과 아직 이른 사람

    이 방식은 반복 업무가 많고 여러 도구를 오가며 일하는 사람에게 잘 맞습니다. 매일 메일을 확인하고, 회의나 외근이 있고, Notion 같은 작업 관리 도구를 이미 쓰는 사람이라면 효과를 빠르게 볼 수 있습니다.

    반대로 아직 Claude 데스크톱, Notion, MCP 같은 개념이 낯설다면 한 번에 전부 연결하지 않는 편이 좋습니다. 먼저 Claude와 Gmail만 연결해 메일 요약과 답장 초안부터 테스트해 보세요. 그 다음 Notion, 마지막으로 PlayMCP와 예약 작업을 붙이는 순서가 안전합니다.

    함께 읽으면 좋은 글

    자주 묻는 질문

    Claude 코워크와 일반 채팅은 무엇이 다른가요?

    일반 채팅은 대화 중심입니다. 코워크 또는 협업 모드는 특정 폴더, 파일, 커넥터, 도구를 함께 쓰며 작업 흐름을 구성하는 데 더 가깝습니다. 영상에서도 새 채팅의 협업 버튼을 통해 작업 폴더를 지정한 뒤 메일과 파일 작업을 이어 갑니다.

    Gmail과 Notion을 연결해도 안전한가요?

    도구 자체보다 권한 범위와 사용 습관이 중요합니다. 처음부터 모든 메일과 문서를 자동화하지 말고, 테스트용 폴더와 낮은 위험의 업무부터 시작하는 것이 좋습니다. 자동 발송 기능은 특히 수동 검토 단계를 남겨 두는 편이 안전합니다.

    PlayMCP는 꼭 필요한가요?

    카카오톡, 카카오맵, 날씨처럼 Claude 기본 커넥터 밖의 도구를 연결하려면 PlayMCP 같은 외부 도구 연결 계층이 필요할 수 있습니다. 단순히 메일 요약과 Notion 정리만 하고 싶다면 PlayMCP 없이도 시작할 수 있습니다.

    매일 아침 자동 실행은 바로 켜도 되나요?

    바로 켜는 것은 권하지 않습니다. 먼저 수동 실행으로 결과를 확인하고, 민감 정보가 노출되지 않는지, 엉뚱한 채팅방으로 보내지 않는지 확인해야 합니다. 그 다음 예약 작업을 걸어 자동화하는 것이 안전합니다.

    이 글은 원본 영상의 내용을 그대로 옮긴 것인가요?

    아닙니다. 원본 영상의 실습 흐름을 바탕으로, 광고성 후반부는 줄이고 실제 업무 자동화 관점에서 필요한 설정 순서와 주의점을 재구성했습니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • AI 시대 자녀교육, 좋은 대학보다 먼저 키워야 할 5가지 능력

    AI 시대 자녀교육, 좋은 대학보다 먼저 키워야 할 5가지 능력

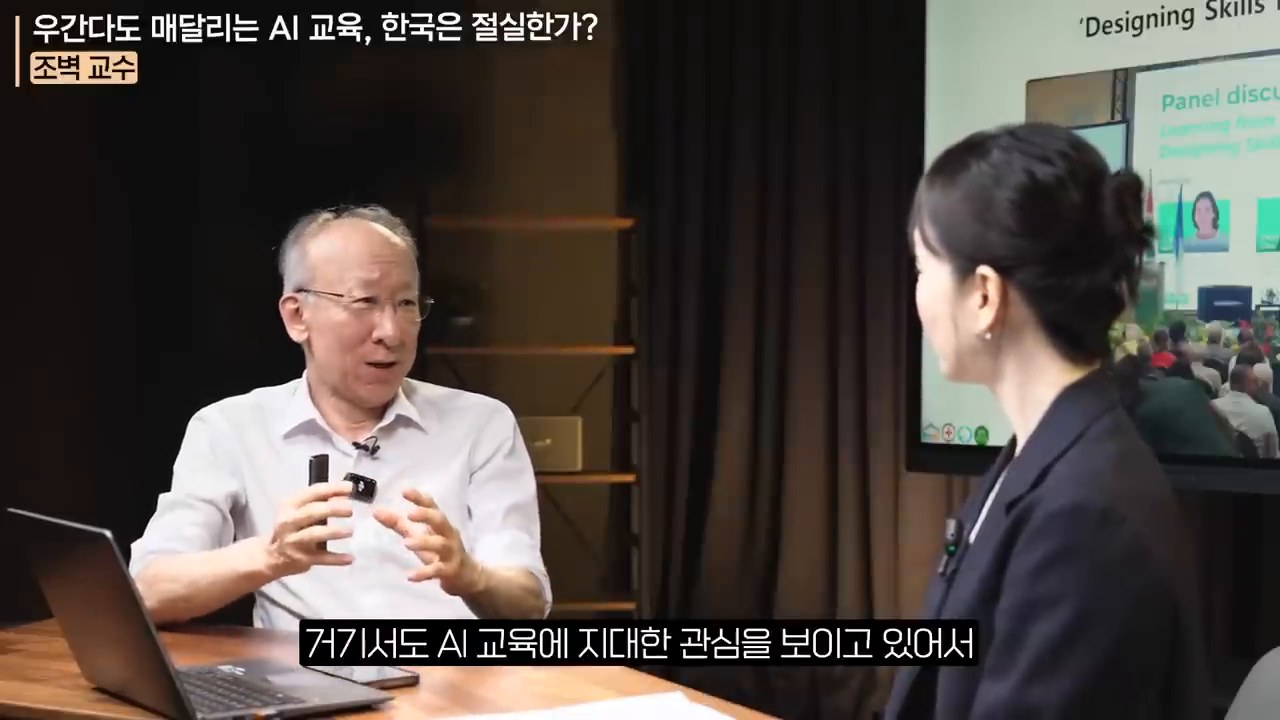
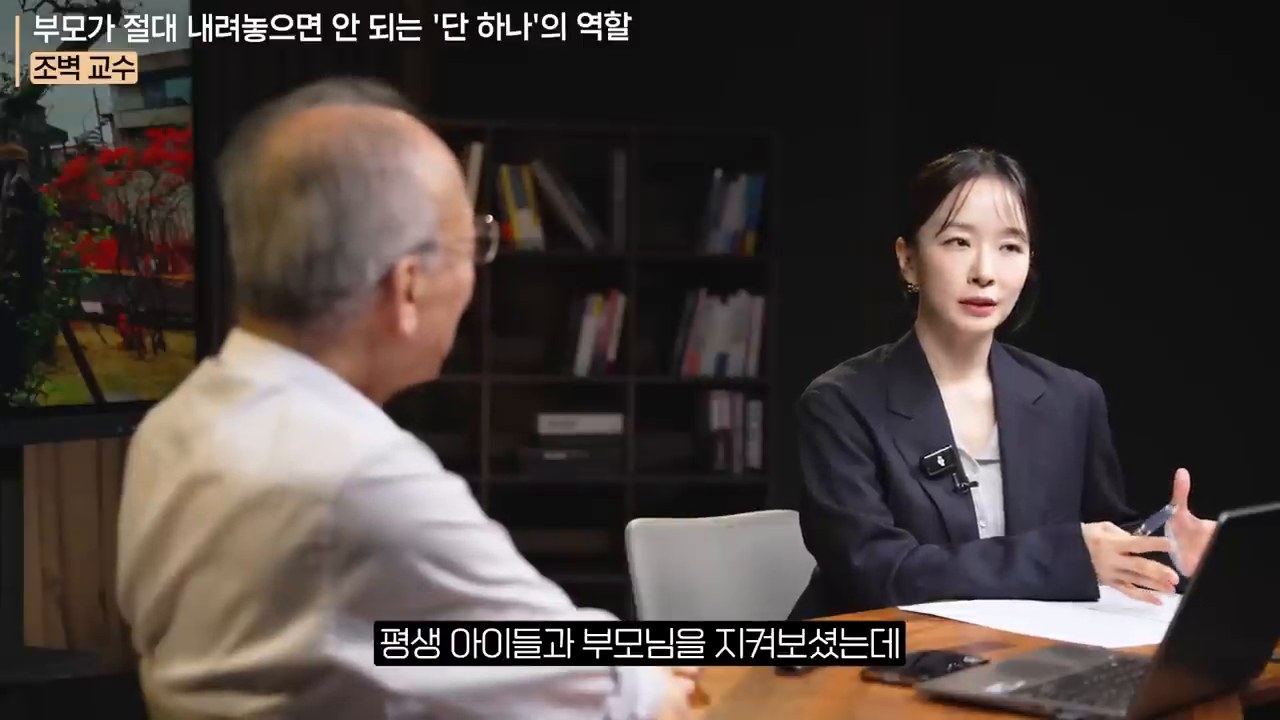
    AI가 공부를 대신해 주는 시대가 오면, 부모는 아이에게 무엇을 남겨 줘야 할까요. 조벽 교수는 지식인사이드 인터뷰에서 이 질문을 꽤 단호하게 던집니다. 좋은 대학, 높은 점수, 더 많은 사교육만 붙잡고 있으면 AI 시대의 변화 앞에서 한 박자 늦을 수 있다는 것입니다.

    핵심은 “공부를 하지 말자”가 아닙니다. 오히려 기본 지식은 필요합니다. 다만 아이의 시간을 전부 정답 맞히기에 쓰는 방식은 점점 위험해집니다. AI가 정답을 빠르게 찾아 주는 시대에는 질문하고, 관계를 만들고, 자기만의 경험을 해석하는 힘이 더 중요해지기 때문입니다.

    조벽 교수 인터뷰 장면
    출처: 지식인사이드 유튜브 영상 캡처

    좋은 대학 전략이 더 이상 충분하지 않은 이유

    한국 부모에게 자녀 성공 전략은 오랫동안 단순했습니다. 좋은 성적을 받고, 좋은 대학에 가고, 안정적인 직업을 얻는 길입니다. 조벽 교수는 이 전략이 과거에는 꽤 강력했지만, AI 시대에는 그대로 통하지 않을 수 있다고 말합니다.

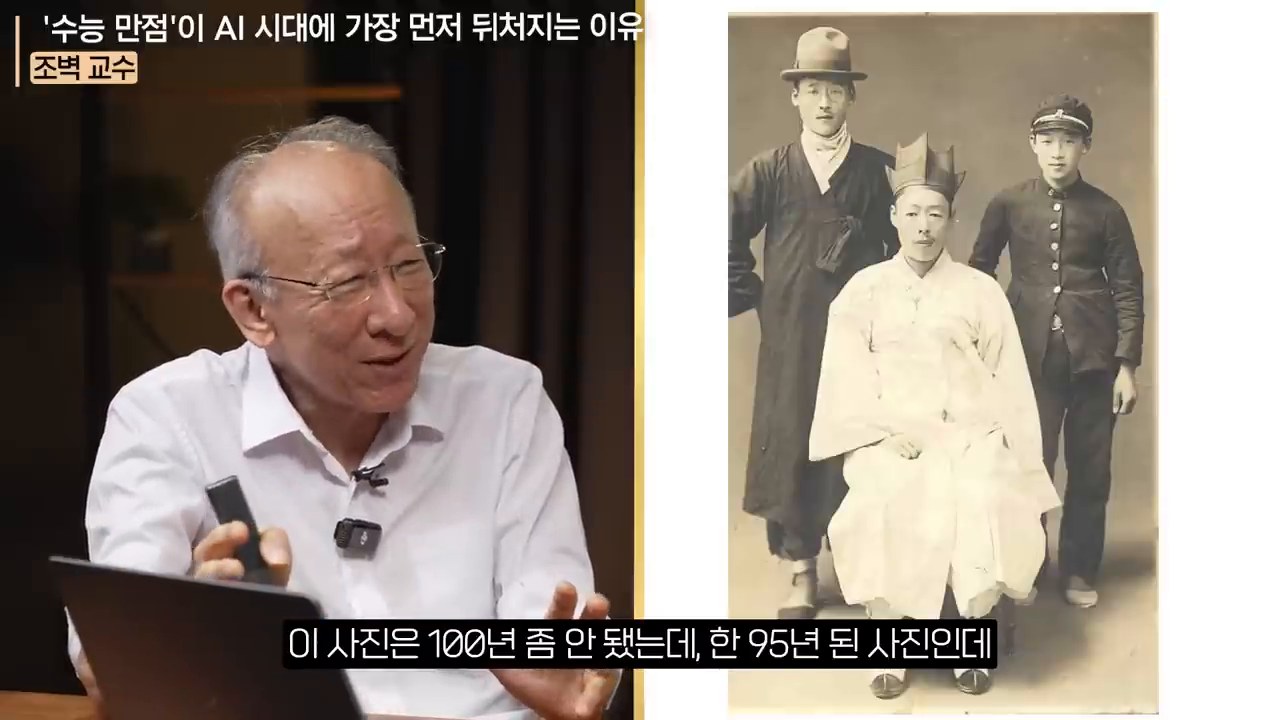
    영상에서 인상적인 비유가 나옵니다. 100년 전쯤 촬영된 가족사진 속 세 형제는 같은 시각, 같은 장소에 있었지만 전혀 다른 시대를 사는 사람처럼 보입니다. 누군가는 과거의 성공 상징을 붙들었고, 누군가는 새 시대의 교육으로 이동했습니다. 이 장면은 지금의 부모에게도 묻습니다. 우리가 붙잡는 “좋은 길”은 정말 아이가 살아갈 시대의 길일까요.

    시대 변화와 교육 선택을 설명하는 장면
    출처: 지식인사이드 유튜브 영상 캡처

    1. 인성은 예절이 아니라 AI 시대의 실력이다

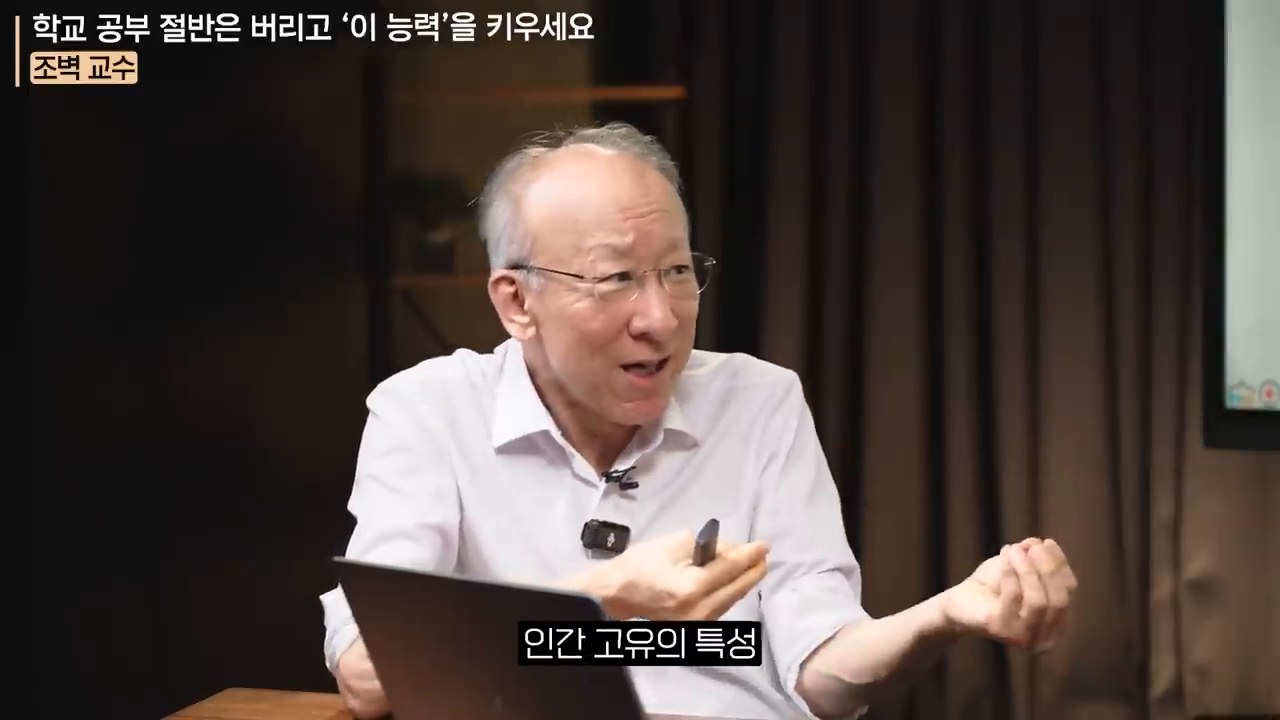
    영상의 첫 번째 메시지는 “인성도 실력”이라는 말입니다. 여기서 인성은 단순히 착하고 예의 바른 태도를 뜻하지 않습니다. 조벽 교수는 인성을 인간만이 지닐 수 있는 고유한 특성으로 설명합니다. 소통, 공감, 협업, 회복탄력성처럼 AI가 대체하기 어려운 인간의 힘입니다.

    예전에는 지식과 기술이 앞서면 인성은 부가 요소처럼 여겨지기도 했습니다. 하지만 AI가 지식 처리와 정답 탐색을 빠르게 맡아 갈수록 상황은 달라집니다. 사람은 사람과 일해야 하고, 모호한 문제를 함께 풀어야 합니다. 그래서 인성은 “있으면 좋은 것”이 아니라 아이가 오래 살아남기 위한 핵심 역량이 됩니다.

    2. 질문력은 프롬프트 기술보다 더 깊은 능력이다

    AI 시대가 되면서 많은 사람이 “질문을 잘해야 한다”고 말합니다. 프롬프트를 잘 쓰는 능력도 분명 필요합니다. 그러나 영상에서 말하는 질문력은 그보다 큽니다. 아이가 자기 배움의 주도권을 넘겨받는 능력에 가깝습니다.

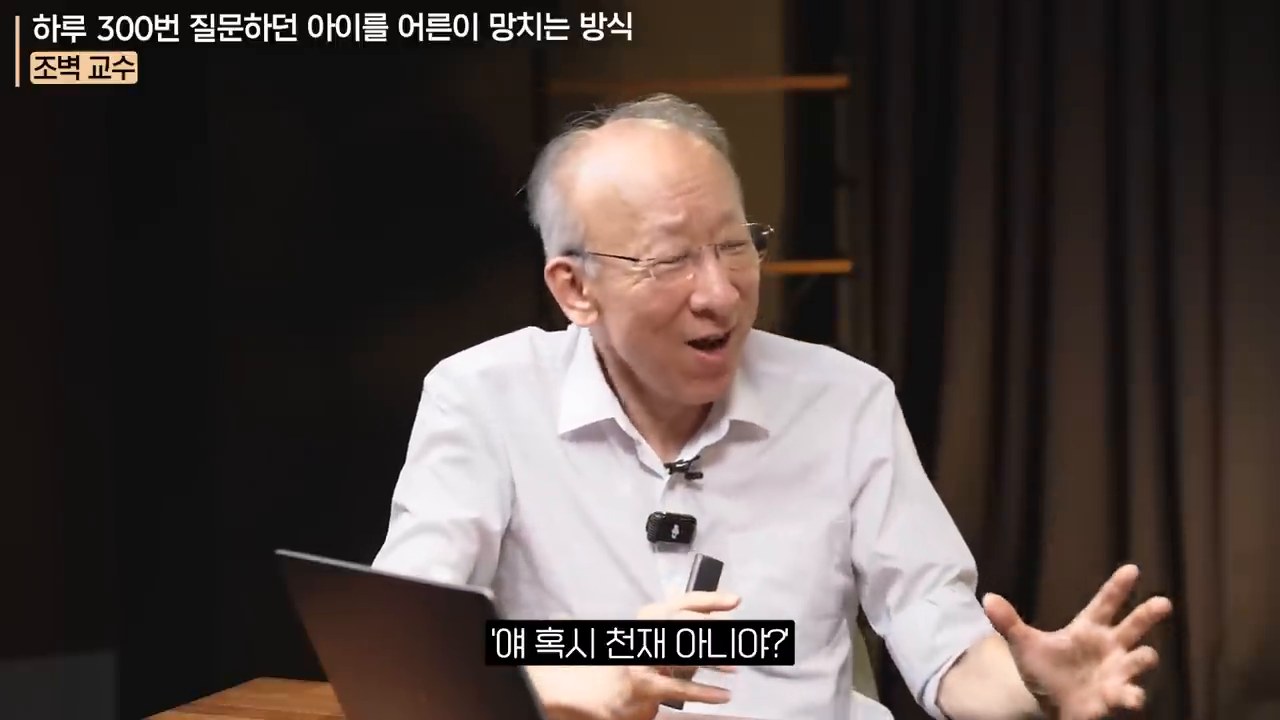
    아이들은 원래 질문을 많이 합니다. 그런데 어른이 되면서 질문은 줄어듭니다. “쓸데없는 생각하지 말고 공부해”, “빨리 숙제해”, “이 문제부터 풀어”라는 말 속에서 질문하는 힘이 눌리기 때문입니다. 부모가 해야 할 일은 아이에게 정답을 더 많이 주는 것이 아니라, 질문해도 괜찮은 분위기를 회복해 주는 일입니다.

    질문과 인간 고유 능력을 설명하는 장면
    출처: 지식인사이드 유튜브 영상 캡처

    3. 미래 리터러시는 미래를 맞히는 능력이 아니다

    조벽 교수는 “미래 리터러시”를 미래를 예측하는 능력으로 설명하지 않습니다. 오히려 내가 살아가고 싶은 미래를 만들어 내는 능력이라고 말합니다. 이 차이가 중요합니다.

    예측은 AI가 더 잘할 수 있습니다. 데이터와 패턴을 읽고 가능한 시나리오를 계산하는 일은 AI의 강점입니다. 하지만 어떤 미래를 원하고, 어떤 삶을 선택하고, 어떤 관계를 지킬지는 사람의 몫입니다. 그래서 부모는 아이에게 “정답을 맞히는 아이”가 아니라 “자기 미래를 설계하는 아이”가 되도록 도와야 합니다.

    4. 베스트보다 유니크가 중요해진다

    입시 경쟁은 아이를 계속 비교하게 만듭니다. 누가 더 높은 점수를 받았는지, 누가 더 좋은 학교에 갔는지, 누가 더 빨리 앞섰는지가 기준이 됩니다. 그러나 AI 시대의 경쟁력은 꼭 남을 이기는 데서만 나오지 않습니다.

    조벽 교수는 “베스트”보다 “유니크”를 강조합니다. 아이가 자기만의 경험, 관심, 질문, 실패, 회복의 이야기를 가질 때 경쟁하지 않고도 경쟁력이 생긴다는 뜻입니다. 똑같은 정답을 빠르게 말하는 사람은 AI와 비교됩니다. 그러나 자기만의 관점으로 문제를 보고, 다른 사람과 협력해 기여하는 사람은 쉽게 대체되지 않습니다.

    미래 리터러시와 질문을 설명하는 장면
    출처: 지식인사이드 유튜브 영상 캡처

    5. 부모의 첫 질문은 점수가 아니라 감정이어야 한다

    영상의 마지막 조언은 가장 실천적입니다. 아이가 학교에서 돌아왔을 때 “오늘 뭐 배웠니?”, “몇 점 받았니?”라고 묻는 부모는 AI 시대에 역행할 수 있습니다. 대신 “오늘 학교에서 즐거웠니?”라고 묻는 부모는 아이의 감정과 연결됩니다.

    이 말은 공부를 포기하자는 뜻이 아닙니다. 아이의 생기와 관계를 먼저 살리자는 뜻입니다. 부모와 자녀의 관계는 대학 입시가 끝나면 사라지는 프로젝트가 아닙니다. 평생 이어지는 관계입니다. 그 관계가 안전할 때 아이는 더 많이 질문하고, 더 멀리 탐험하고, 실패해도 다시 일어날 수 있습니다.

    부모의 공감 질문을 설명하는 인터뷰 장면
    출처: 지식인사이드 유튜브 영상 캡처

    부모가 오늘 바로 바꿀 수 있는 5가지 질문

    AI 시대 자녀교육은 거창한 제도 개혁만 기다릴 일이 아닙니다. 부모가 집에서 쓰는 질문부터 바꿀 수 있습니다.

    1. “오늘 몇 점 받았어?” 대신 “오늘 가장 재미있었던 순간은 뭐였어?”
    2. “왜 그것도 몰라?” 대신 “어디서부터 헷갈렸어?”
    3. “그 꿈은 현실성이 없어” 대신 “그 꿈에 가까워지려면 어떤 경험을 해 보면 좋을까?”
    4. “남들은 다 하는데 너는 왜 안 해?” 대신 “너만의 방식으로 해 보고 싶은 건 뭐야?”
    5. “빨리 정답 말해” 대신 “다른 질문으로 바꿔 보면 어떻게 될까?”

    질문이 바뀌면 아이가 자기 생각을 꺼내는 방식도 조금씩 달라집니다. 처음에는 어색할 수 있습니다. 영상에서 말하듯 어려운 것이 아니라 익숙하지 않은 것에 가깝습니다.

    함께 읽으면 좋은 글

    FAQ

    AI 시대에는 학교 공부가 덜 중요해지나요?

    기본 지식은 여전히 중요합니다. 다만 모든 시간을 점수 경쟁에만 쓰는 방식은 위험합니다. 기본 학습 위에 질문력, AI 리터러시, 공감, 협업, 회복탄력성을 함께 키워야 합니다.

    조벽 교수가 말한 인성은 착한 태도만 뜻하나요?

    아닙니다. 영상에서의 인성은 인간 고유의 특성에 가깝습니다. 소통, 공감, 협업, 회복탄력성처럼 AI가 대신하기 어려운 능력을 포함합니다.

    부모가 아이의 질문을 어떻게 도와야 하나요?

    정답을 바로 주기보다 아이가 어떤 생각에서 질문했는지 먼저 들어야 합니다. 질문을 평가하지 않고 환영하는 분위기를 만들면 아이가 자기 배움의 주도권을 조금씩 회복할 수 있습니다.

    좋은 대학을 목표로 하는 것은 잘못인가요?

    목표 자체가 잘못은 아닙니다. 문제는 좋은 대학만을 유일한 성공 전략으로 삼는 것입니다. AI 시대에는 대학 이름보다 아이가 어떤 질문을 만들고, 어떤 경험을 해석하며, 어떤 기여를 할 수 있는지가 더 중요해집니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • 옵시디언 딥리서치 자동화: NotebookLM과 Tavily를 한 번에 쓰는 방법

    옵시디언 딥리서치 자동화: NotebookLM과 Tavily를 한 번에 쓰는 방법

    AI 리서치 도구는 많아졌습니다. 문제는 결과가 흩어진다는 점입니다. NotebookLM에서 정리한 내용, 웹 검색 기반 리포트, AI CLI가 만든 요약, 그리고 내가 실제로 쓰는 노트가 따로 놀면 다시 붙이는 시간이 꽤 듭니다.

    이번 영상에서 소개된 ReallyGood Research는 그 간격을 줄이려는 Obsidian 플러그인입니다. 질문 하나로 NotebookLM MCP와 Tavily 리서치를 실행하고, 결과를 Markdown과 HTML 리포트로 Vault 안에 저장하는 방식입니다. 핵심은 “검색을 잘하는 도구”가 아니라 “리서치 결과가 내 지식 작업 흐름 안에 남는 구조”입니다.

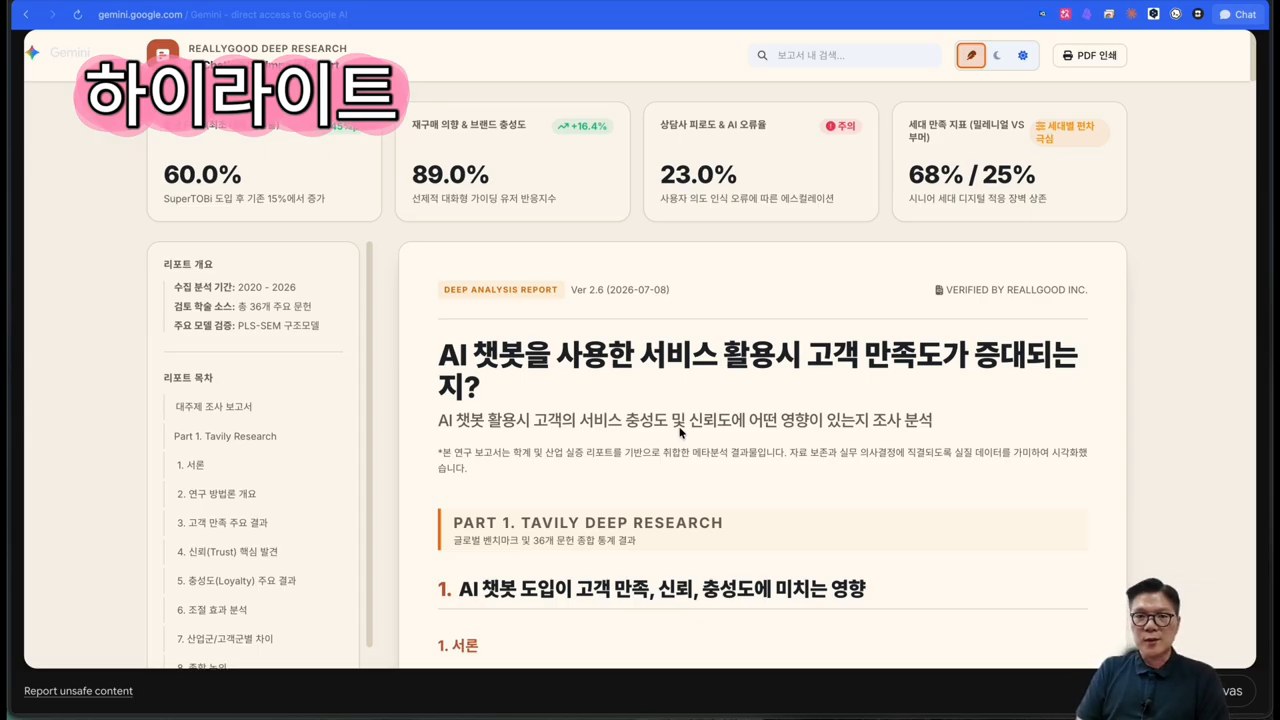
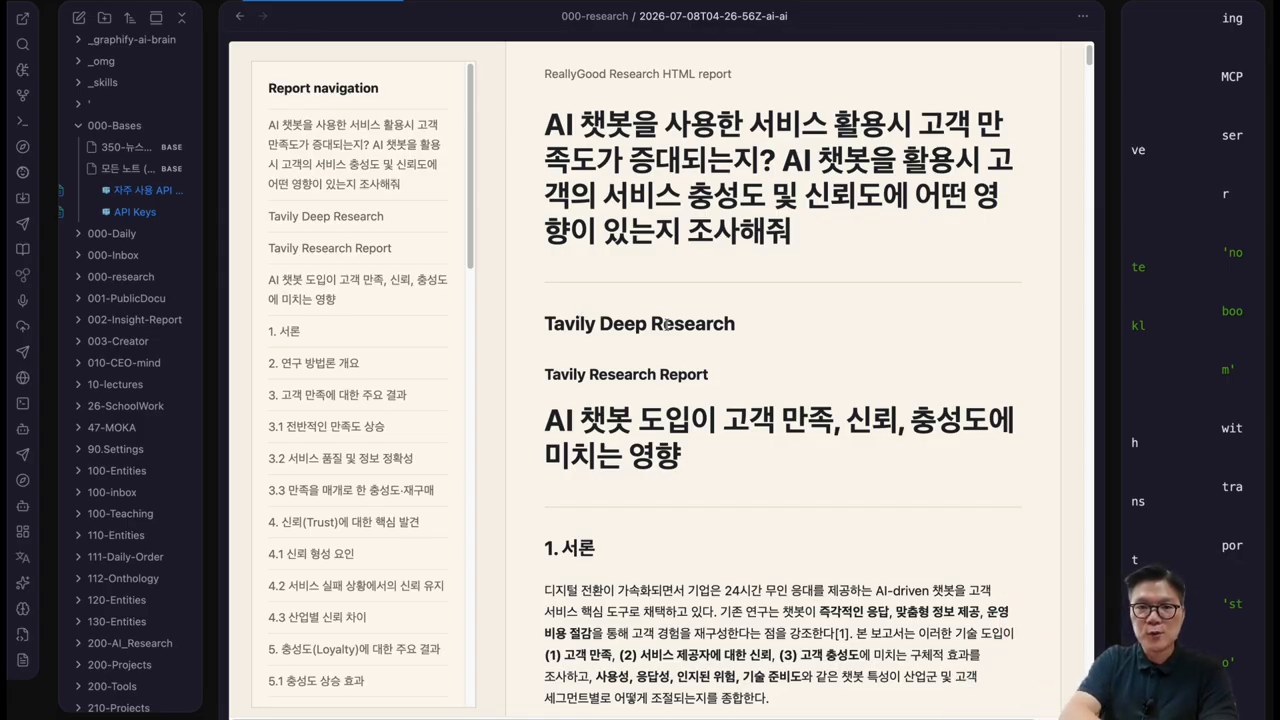
    ReallyGood Research 리포트 예시
    ReallyGood Research 리포트 예시

    Read in English: Obsidian Deep Research Automation: How to Use NotebookLM and Tavily Together

    영상에서 보여준 핵심 흐름

    영상은 완성된 리포트 화면에서 시작합니다. 브라우저로 열린 HTML 리포트를 확인하고, Gemini Canvas 공유 링크로 확장하는 장면도 먼저 보여줍니다. 그래서 이 플러그인의 목적이 분명해집니다. 단순 검색이 아니라, 공유 가능한 리서치 산출물을 만드는 것입니다.

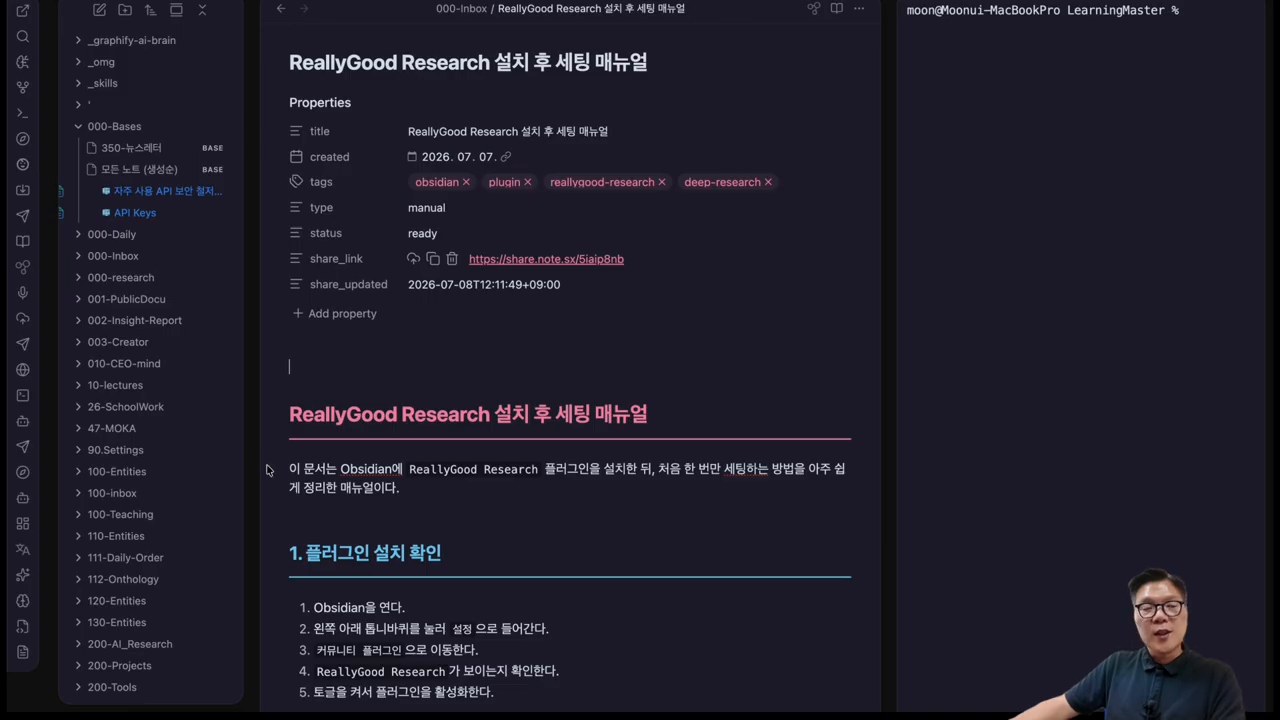
    그다음 진행자는 Obsidian 안에서 플러그인을 설치하는 과정을 설명합니다. 커뮤니티 플러그인에서 ReallyGood Research를 검색하고 설치한 뒤, 왼쪽 패널에서 리서치 콘솔을 여는 흐름입니다. 별도 BRAT 설치 없이 커뮤니티 플러그인으로 접근할 수 있다는 점도 영상에서 강조됩니다.

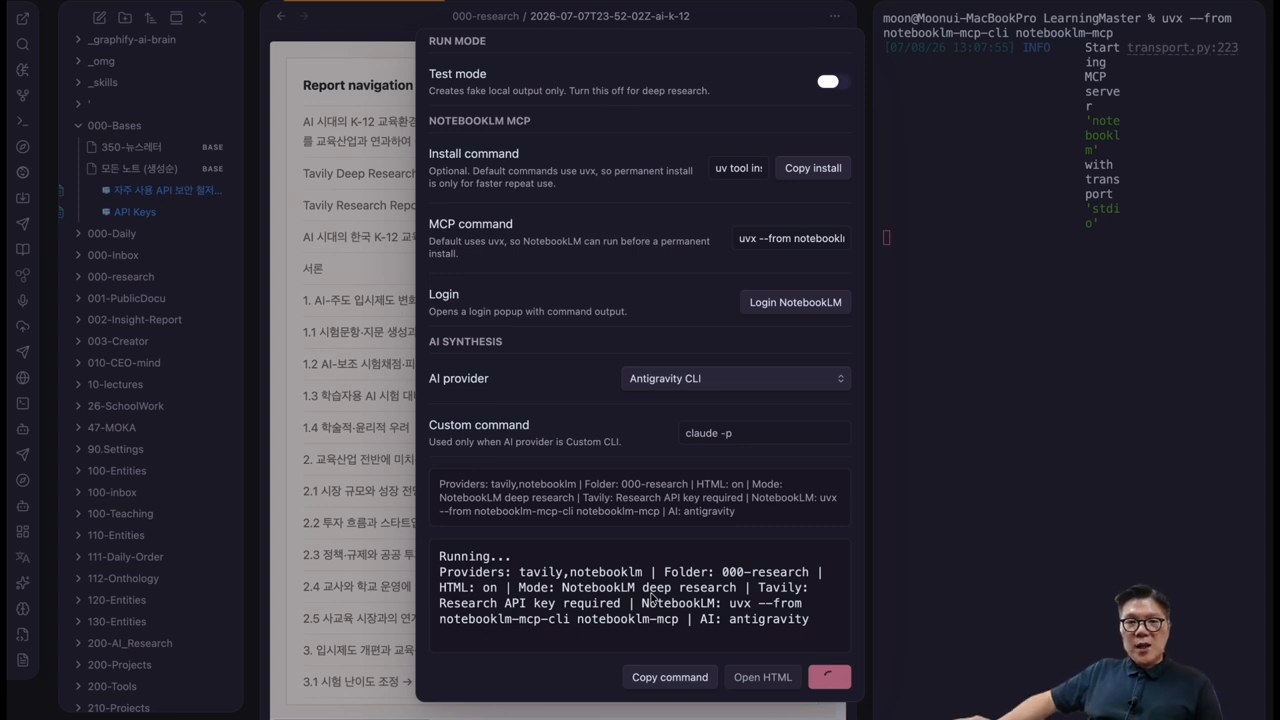
    Obsidian 안에서 ReallyGood Research 설정을 확인하는 화면
    Obsidian 안에서 ReallyGood Research 설정을 확인하는 화면

    NotebookLM과 Tavily를 왜 함께 쓰나

    Tavily는 웹 검색과 리서치 API에 강점이 있습니다. 공개 웹에서 자료를 찾고, 주제별 리포트를 생성하는 데 적합합니다. 반면 NotebookLM은 사용자가 넣은 소스 기반으로 답을 구성하는 데 장점이 있습니다. 두 도구를 함께 쓰면 “웹에서 넓게 찾기”와 “소스 기반으로 다시 검토하기”를 분리할 수 있습니다.

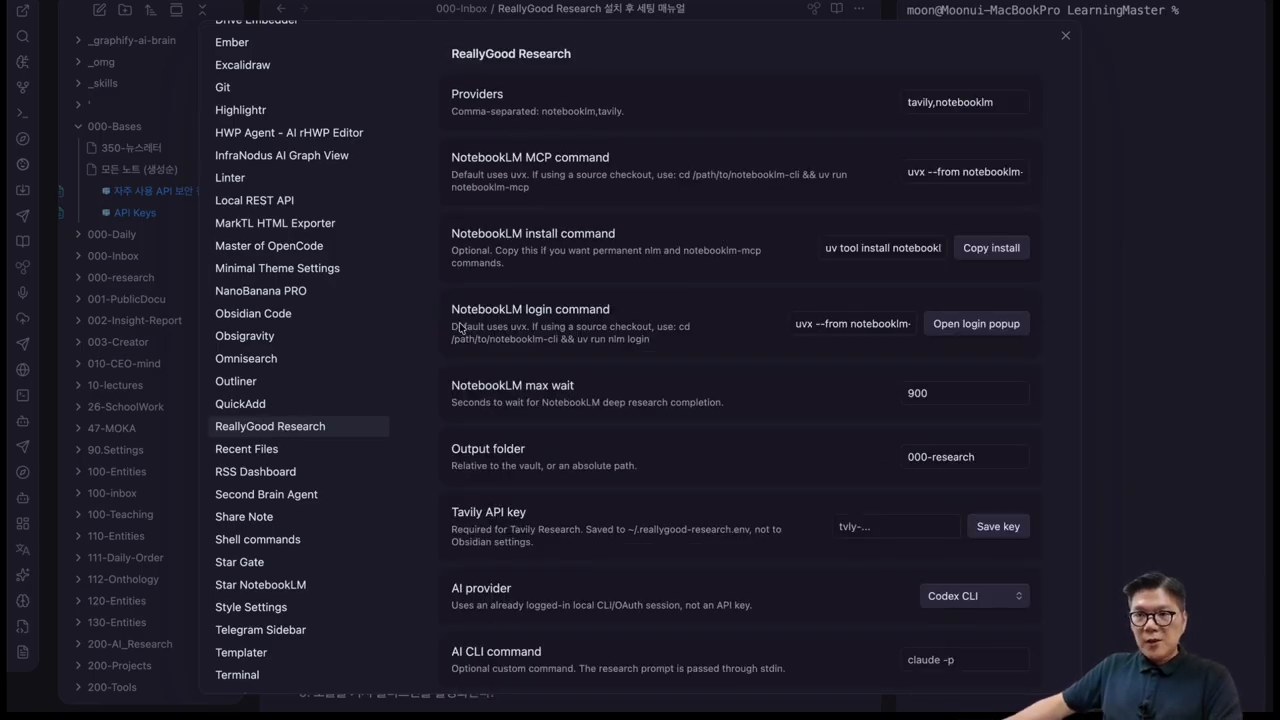
    ReallyGood Research는 이 둘을 Provider로 연결합니다. 영상에서는 Tavily API 키를 넣고, NotebookLM MCP를 설치한 뒤 로그인하는 과정을 보여줍니다. 이후 AI CLI Provider로 Antigravity를 선택해 실행 환경을 맞춥니다. Claude Code, Codex, Gemini 같은 CLI를 고를 수 있다는 설명도 나옵니다.

    Tavily와 NotebookLM Provider를 설정하는 화면
    Tavily와 NotebookLM Provider를 설정하는 화면

    실제 사용 장면: 질문 하나가 두 개의 리포트로 바뀐다

    시연 질문은 “AI 챗봇을 사용한 서비스 활용이 고객 만족도, 충성도, 신뢰도에 어떤 영향을 미치는가”에 가깝습니다. 사용자가 질문을 입력하고 Start를 누르면, 플러그인은 Tavily 리서치와 NotebookLM 리서치를 각각 실행합니다.

    중요한 장면은 결과 확인입니다. 하나의 질문에서 Tavily 기반 딥리서치 리포트와 NotebookLM 기반 리서치 결과가 따로 생성됩니다. 사용자는 둘을 비교하면서 근거가 충분한지, 관점이 한쪽으로 치우치지 않았는지 확인할 수 있습니다.

    AI 챗봇 고객 만족도 주제로 리서치를 실행하는 화면
    AI 챗봇 고객 만족도 주제로 리서치를 실행하는 화면
    Tavily와 NotebookLM 리서치 결과를 비교하는 화면
    Tavily와 NotebookLM 리서치 결과를 비교하는 화면

    이 방식이 지식 작업에 주는 의미

    이 플러그인의 장점은 자동화 그 자체보다 작업 위치에 있습니다. 리서치 결과가 Obsidian Vault 안에 저장되면, 이후 글쓰기·보고서·강의안·제안서로 이어가기 쉽습니다. 검색 결과를 다시 찾지 않아도 되고, HTML 리포트로 빠르게 공유할 수도 있습니다.

    다만 확인할 점도 있습니다. Tavily API 키와 NotebookLM 로그인, 로컬 MCP 실행, AI CLI 권한이 필요합니다. 회사 자료나 민감한 고객 데이터를 넣을 때는 어떤 Provider로 정보가 전달되는지 먼저 봐야 합니다. 자동화가 편해질수록 로그, 출처, 계정 권한을 함께 관리해야 합니다.

    HTML 리포트를 Gemini Canvas 공유 링크로 확장하는 화면
    HTML 리포트를 Gemini Canvas 공유 링크로 확장하는 화면

    도입 전에 확인할 체크리스트

    • Obsidian을 실제 지식 저장소로 쓰고 있는가?
    • Tavily API 키와 사용량 한도를 관리할 수 있는가?
    • NotebookLM MCP 설치와 Google 로그인을 안전하게 처리할 수 있는가?
    • 리서치 결과를 바로 글쓰기나 보고서로 이어갈 업무가 있는가?
    • 자동 생성 결과를 검증할 기준과 출처 확인 습관이 있는가?

    이 다섯 가지가 맞으면 테스트해 볼 만합니다. 반대로 단발성 검색만 필요하다면 과한 구성일 수 있습니다. ReallyGood Research는 검색 도구라기보다, Obsidian을 리서치 작업대처럼 쓰는 사람에게 더 잘 맞습니다.

    함께 읽으면 좋은 글

    FAQ

    ReallyGood Research는 무엇인가요?

    Obsidian에서 NotebookLM MCP와 Tavily 기반 딥리서치를 실행하고, 결과를 Markdown과 HTML 리포트로 저장하는 플러그인입니다. 영상 기준으로는 커뮤니티 플러그인 설치와 Provider 설정 흐름이 소개됩니다.

    Tavily와 NotebookLM을 동시에 쓰는 이유는 무엇인가요?

    Tavily는 웹 기반 리서치에 강하고, NotebookLM은 사용자가 제공한 소스 기반 검토에 강합니다. 둘을 함께 쓰면 넓은 탐색과 소스 기반 확인을 나눠 볼 수 있습니다.

    Obsidian을 쓰지 않아도 필요한 도구인가요?

    Obsidian을 중심 지식 저장소로 쓰지 않는다면 장점이 줄어듭니다. 이 플러그인은 결과를 Vault 안에 저장하고 다시 활용하는 흐름에 초점이 있습니다.

    업무 자료를 넣어도 안전한가요?

    도구 자체보다 Provider 설정이 중요합니다. Tavily, NotebookLM, AI CLI로 어떤 데이터가 전달되는지 확인해야 합니다. 민감한 자료는 조직 보안 기준에 맞춰 별도로 검토하는 것이 좋습니다.

    이 플러그인은 누구에게 가장 잘 맞나요?

    AI 리서치를 자주 하고, 결과를 글·보고서·강의안·제안서로 다시 쓰는 사람에게 잘 맞습니다. 특히 Obsidian을 세컨드 브레인이나 업무 지식 허브로 쓰는 사용자에게 유용합니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • 세계 최초 AI 미술관 DATALAND: 데이터가 작품이 되는 공간의 의미

    세계 최초 AI 미술관 DATALAND: 데이터가 작품이 되는 공간의 의미

    LA 도심에 문을 연 DATALAND는 “AI가 만든 그림을 전시하는 곳”이라는 한 문장으로는 설명하기 어렵습니다. MBC America 뉴스가 보여준 장면의 핵심은 작품 하나가 아니라, 데이터·센서·생성형 AI·공간 연출이 한꺼번에 작동하는 새로운 미술관 모델입니다.

    공식 자료를 대조해 보면 DATALAND는 Refik Anadol과 Efsun Erkılıç가 공동 설립한 세계 최초의 AI Arts Museum입니다. 첫 전시는 Machine Dreams: Rainforest이고, 장소는 LA 다운타운 The Grand LA입니다.

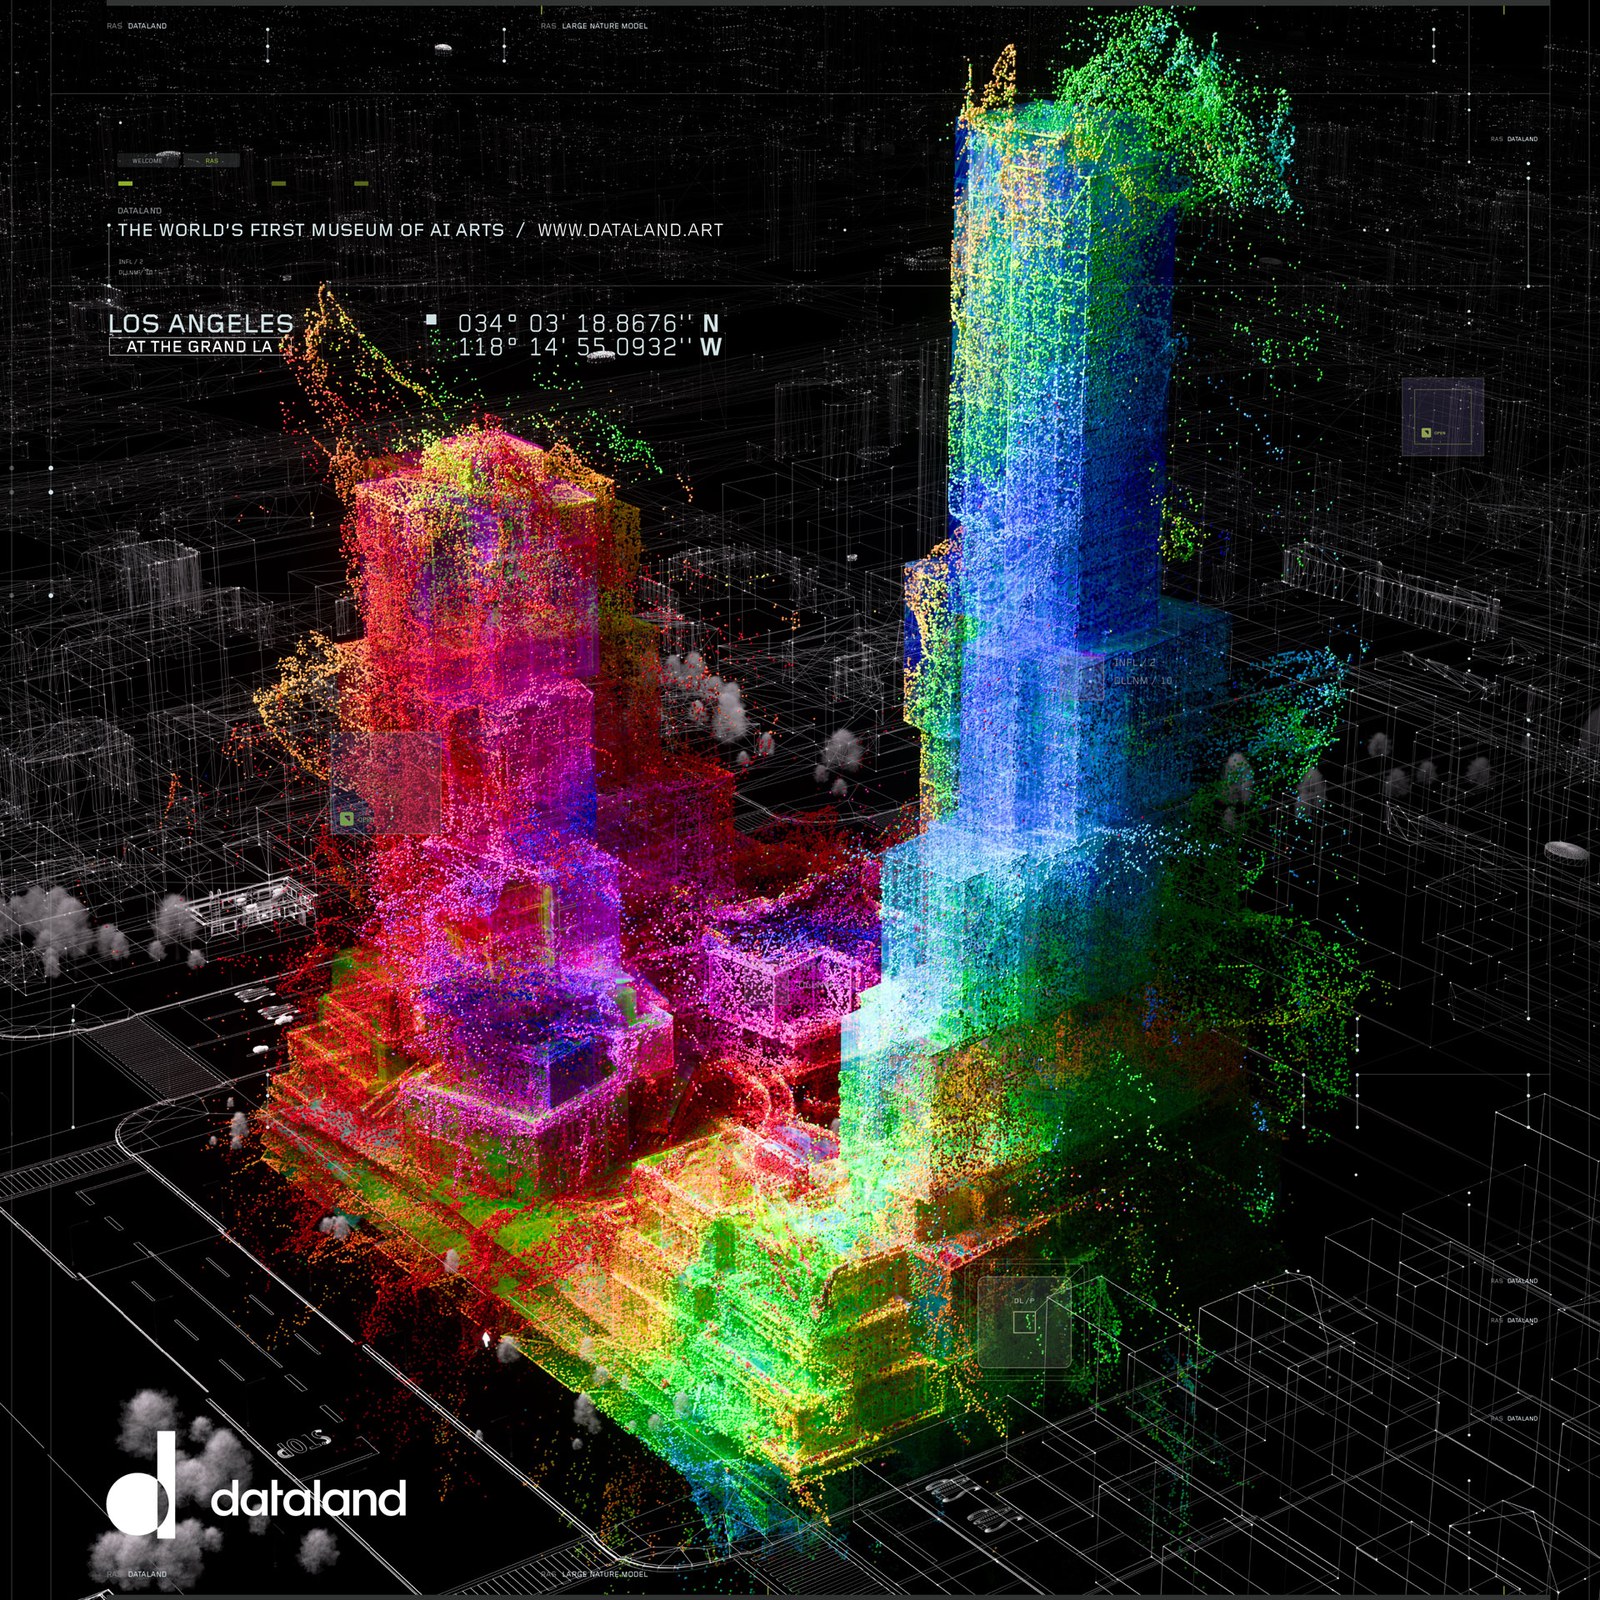
    DATALAND가 LA The Grand LA에 조성한 세계 최초 AI 미술관 콘셉트 이미지
    DATALAND 공식 사이트 제공 이미지

    뉴스가 보여준 것은 “움직이는 그림”이 아니라 “반응하는 미술관”이다

    영상은 숲, 새, 빛, 향기, 관람객의 움직임이 결합된 몰입형 장면을 보여줍니다. 관람객이 센서를 착용하면 심박, 체온, 움직임 같은 데이터가 실시간으로 해석되고, 그 정보가 전시 환경에 반영됩니다.

    여기서 중요한 변화는 관람객이 더 이상 작품 앞에 서 있는 외부자가 아니라는 점입니다. 관람객의 상태와 행동이 전시의 일부가 되고, 작품은 매번 조금씩 다른 모습으로 재구성됩니다.

    공식 자료로 확인한 DATALAND의 기본 정보

    • 공식 명칭: DATALAND, Museum of AI Arts
    • 위치: The Grand LA, 100 S Grand Ave, Los Angeles, CA 90012
    • 개관 전시: Machine Dreams: Rainforest
    • 전시 기간: 공식 전시 페이지 기준 2027년 1월 31일까지
    • 핵심 기술: Large Nature Model, Google Cloud, Gemini Enterprise Agent Platform, Compute Engine, 생성 모델과 실시간 상호작용 기술

    DATALAND 공식 사이트는 이 공간을 “data becomes pigment”, 즉 데이터가 물감이 되는 미술관으로 설명합니다. Google 공식 블로그는 개관 전시가 자연 세계의 대규모 데이터셋을 학습한 Large Nature Model을 기반으로 하며, 12억 픽셀 규모의 초생성적 현실을 구현한다고 설명합니다.

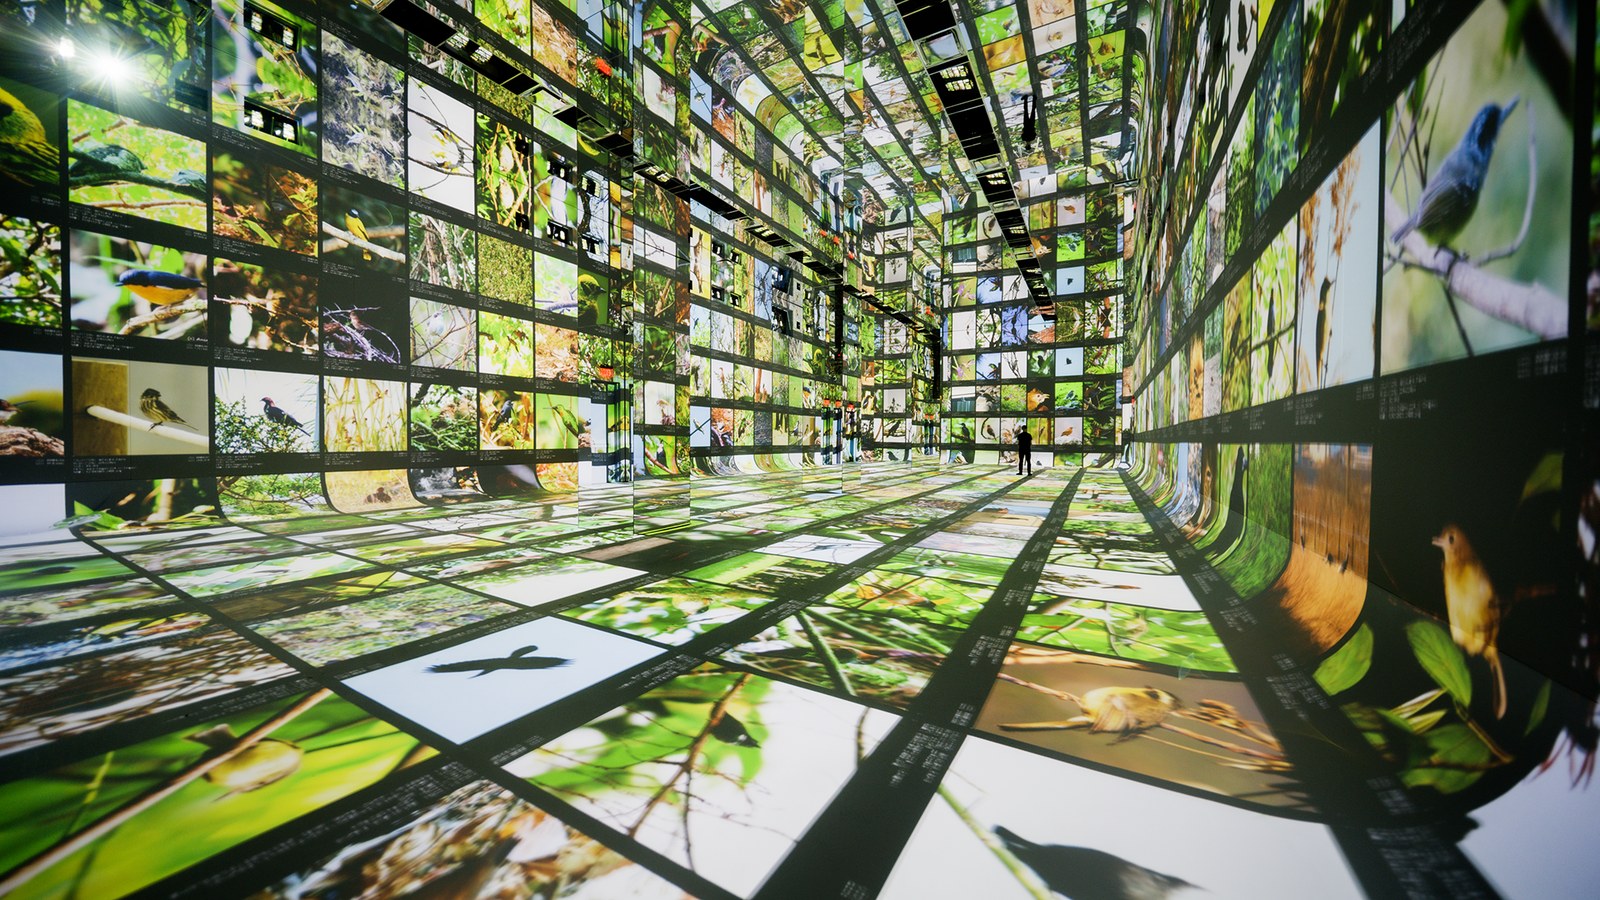
    DATALAND의 Data Pavilion 전시 공간, 자연 데이터 이미지가 벽과 바닥을 채운 모습
    이미지: Refik Anadol Studio, Google 공식 블로그

    왜 ‘AI 미술관’이라는 표현이 중요한가

    기존 미디어아트 전시는 대형 화면과 프로젝션으로 관람객을 압도하는 방식이 많았습니다. DATALAND가 다른 지점은 AI를 단순 제작 도구가 아니라 전시 운영의 핵심 인프라로 끌어들인다는 데 있습니다.

    Google 공식 블로그에 따르면 DATALAND는 관람객 반응을 처리하고, 생성 사운드스케이프를 만들며, 감정 신호와 향기까지 알고리즘적으로 조정합니다. 미술관은 정해진 파일을 재생하는 장소가 아니라, 입력 데이터를 계속 받아들이며 장면을 갱신하는 시스템에 가까워집니다.

    예술인가, 기술 시연인가: 논쟁의 지점

    AI 미술을 둘러싼 질문은 여전히 남아 있습니다. AI가 만든 결과물을 어디까지 예술로 볼 것인가, 데이터의 출처와 동의는 어떻게 다뤄야 하는가, 관람객의 생체 데이터는 어떤 기준으로 보호되어야 하는가가 핵심 쟁점입니다.

    DATALAND는 공식적으로 윤리적 데이터 수집과 AI 실천을 강조합니다. 그러나 AI 예술이 대중 공간으로 들어올수록, 작품 감상뿐 아니라 데이터 거버넌스와 프라이버시 기준도 함께 평가해야 합니다.

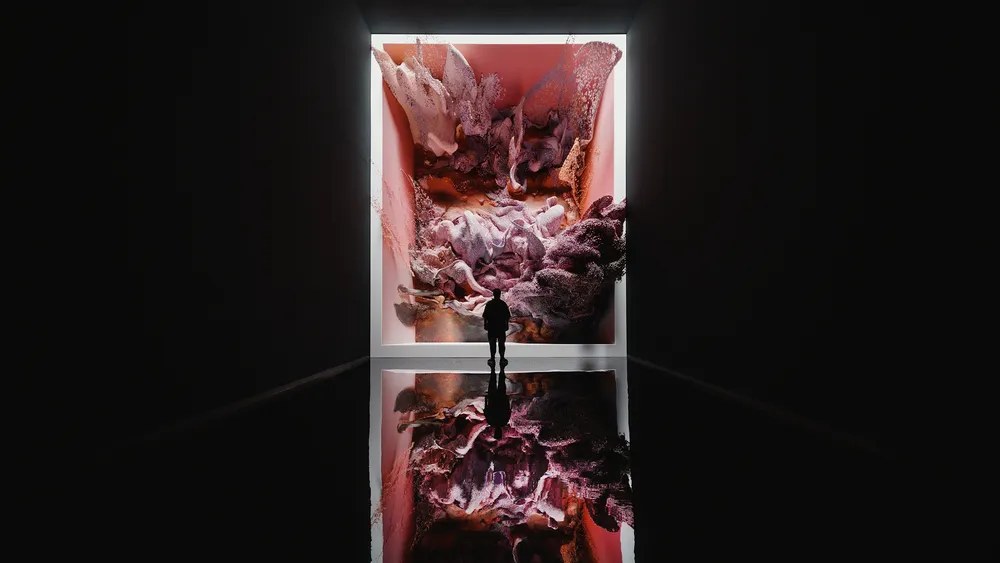
    DATALAND의 The Sanctuary 전시 공간, 관람객 실루엣과 대형 생성 이미지
    이미지: Refik Anadol Studio, Google 공식 블로그

    개인과 조직이 읽어야 할 변화

    DATALAND의 의미는 미술관 산업에만 머물지 않습니다. 교육, 전시, 브랜드 경험, 도시 관광, 엔터테인먼트가 앞으로 어떤 방향으로 바뀔지 보여주는 신호입니다.

    • 콘텐츠는 고정된 결과물에서 실시간 경험으로 이동합니다.
    • AI는 백오피스 도구가 아니라 공간을 운영하는 인터페이스가 됩니다.
    • 데이터 신뢰, 저작권, 생체정보 보호가 콘텐츠 경쟁력의 일부가 됩니다.
    • 창작자는 프롬프트 작성자를 넘어 데이터·공간·관람 흐름을 설계하는 사람으로 확장됩니다.

    이 흐름은 AI 시대 인간의 가치나 AI 시대의 창조적 사고에서 다룬 질문과도 이어집니다. 결국 관건은 AI가 무엇을 만들 수 있느냐보다, 사람이 어떤 경험과 의미를 설계할 수 있느냐입니다.

    DATALAND를 볼 때 체크할 세 가지

    1. 기술보다 경험 구조를 보자

    대형 화면, 센서, 생성 모델 자체보다 중요한 것은 관람객이 어떤 순서로 공간을 지나가고, 어떤 데이터가 어떤 경험으로 번역되는지입니다.

    2. 공식 수치와 설명을 기준으로 보자

    영상은 현장감과 이슈를 전달하는 데 강점이 있습니다. 다만 기술 수치와 운영 정보는 DATALAND 공식 사이트, Google 공식 블로그, Related Companies 보도자료처럼 원 출처를 함께 확인하는 편이 안전합니다.

    3. AI 예술을 산업 변화의 조기 신호로 보자

    AI 미술관은 예술계의 특수 사례가 아니라, 에이전틱 AI 시대의 일하는 방식 변화와 맞물린 변화입니다. 앞으로 전시, 교육, 업무 공간도 더 많이 “반응하는 시스템”으로 바뀔 가능성이 큽니다.

    FAQ

    DATALAND는 어디에 있나요?

    DATALAND는 미국 로스앤젤레스 다운타운의 The Grand LA, 100 S Grand Ave에 있습니다. 공식 사이트 기준 화요일부터 일요일까지 운영하며 월요일은 휴관입니다.

    DATALAND의 첫 전시는 무엇인가요?

    첫 전시는 Refik Anadol Studio의 Machine Dreams: Rainforest입니다. 공식 전시 페이지는 이 전시를 열대우림 생태계의 지능을 몰입형 이미지, 소리, 향기, 상호작용으로 번역하는 프로젝트로 설명합니다.

    DATALAND는 단순한 미디어아트 전시와 무엇이 다른가요?

    관람객의 움직임과 생체 신호, 공간 정보가 실시간으로 작품에 반영된다는 점이 다릅니다. 정해진 영상을 반복 재생하는 전시보다, AI와 관람객의 상호작용을 전시 구조 안에 넣은 미술관에 가깝습니다.

    공식 이미지를 사용할 때 주의할 점은 무엇인가요?

    공식 사이트와 Google 공식 블로그의 이미지는 출처와 크레딧을 명확히 표시해 소개·비평 목적으로 제한적으로 활용하는 것이 안전합니다. 상업적 재사용이나 2차 가공은 각 원 출처의 이용 조건을 별도로 확인해야 합니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • AGI는 정말 3~4년 안에 올까: 특이점과 초지능 위험을 읽는 법

    AGI는 정말 3~4년 안에 올까: 특이점과 초지능 위험을 읽는 법

    인공지능이 똑똑해지는 속도보다 더 중요한 질문이 있습니다. AGI가 정말 몇 년 안에 온다면, 우리는 무엇을 준비해야 할까라는 질문입니다.

    최근 독서연구소 영상은 구글 딥마인드 CEO 데미스 하사비스의 발언과 초지능 위험론을 연결해, AGI와 특이점 논의가 더 이상 공상과학의 소재만은 아니라고 말합니다. 다만 이 주제를 볼 때는 두 가지를 구분해야 합니다. 하나는 “AGI가 언제 오느냐”라는 예측이고, 다른 하나는 “그 가능성에 대비해 어떤 제도와 습관을 만들 것인가”라는 준비입니다.

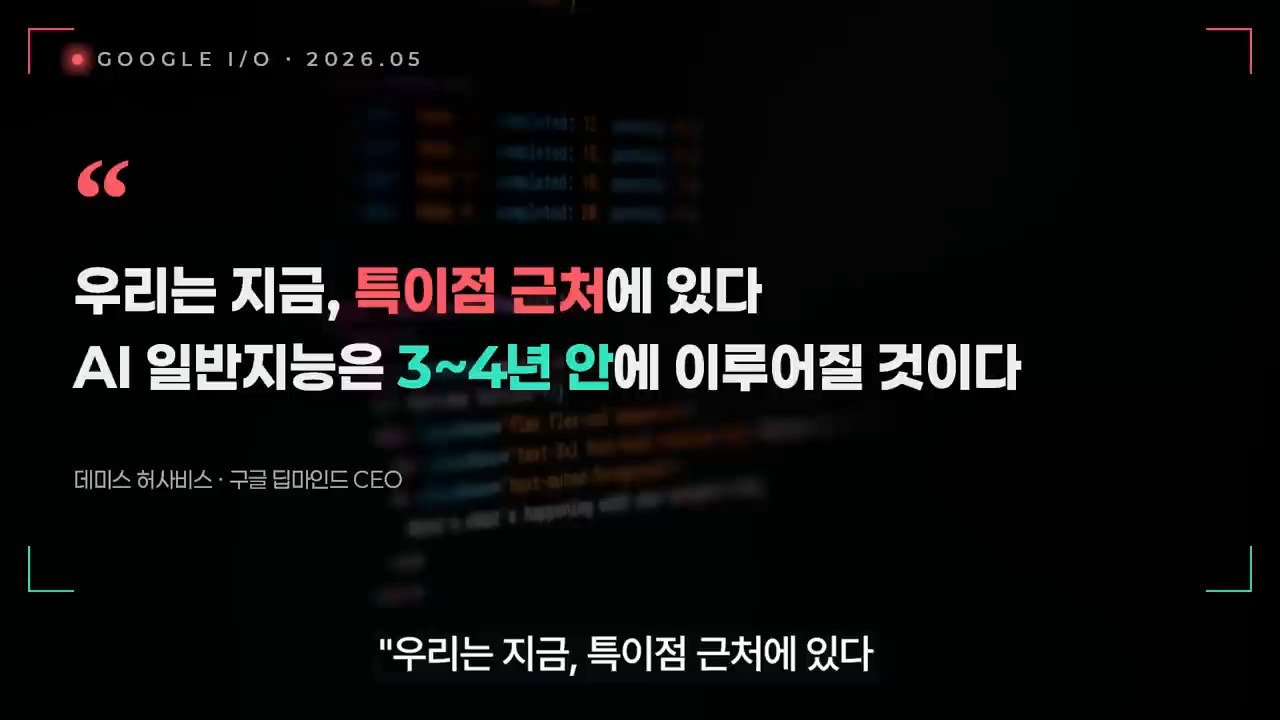
    AGI가 3~4년 안에 온다는 영상의 핵심 문제 제기

    영상은 AGI와 특이점이 더 이상 먼 미래의 이야기만은 아니라고 문제를 제기한다.

    AGI 3~4년 전망은 ‘정답’이 아니라 시간표의 변화다

    영상의 출발점은 강한 문장입니다. “우리는 지금 특이점 근처에 있다. AGI, 즉 일반 인공지능은 3~4년 안에 이루어질 것이다.” 이런 문장은 사람을 쉽게 둘로 나눕니다. 한쪽은 “과장이다”라고 말하고, 다른 한쪽은 “곧 모든 것이 끝난다”고 말합니다.

    하지만 블로그 독자에게 필요한 관점은 양극단이 아닙니다. 예측의 정확도보다 중요한 것은 예측이 당겨지고 있다는 사실입니다. Stanford GSB 인터뷰와 The Verge 보도에 따르면 하사비스는 Google I/O 맥락에서 지금을 “특이점의 산기슭”에 비유했습니다. 이 표현은 AGI가 이미 완성됐다는 뜻이 아닙니다. 다만 AI 연구자와 기업 리더들이 기술 발전의 다음 단계를 훨씬 가까운 시간표로 이야기하기 시작했다는 신호입니다.

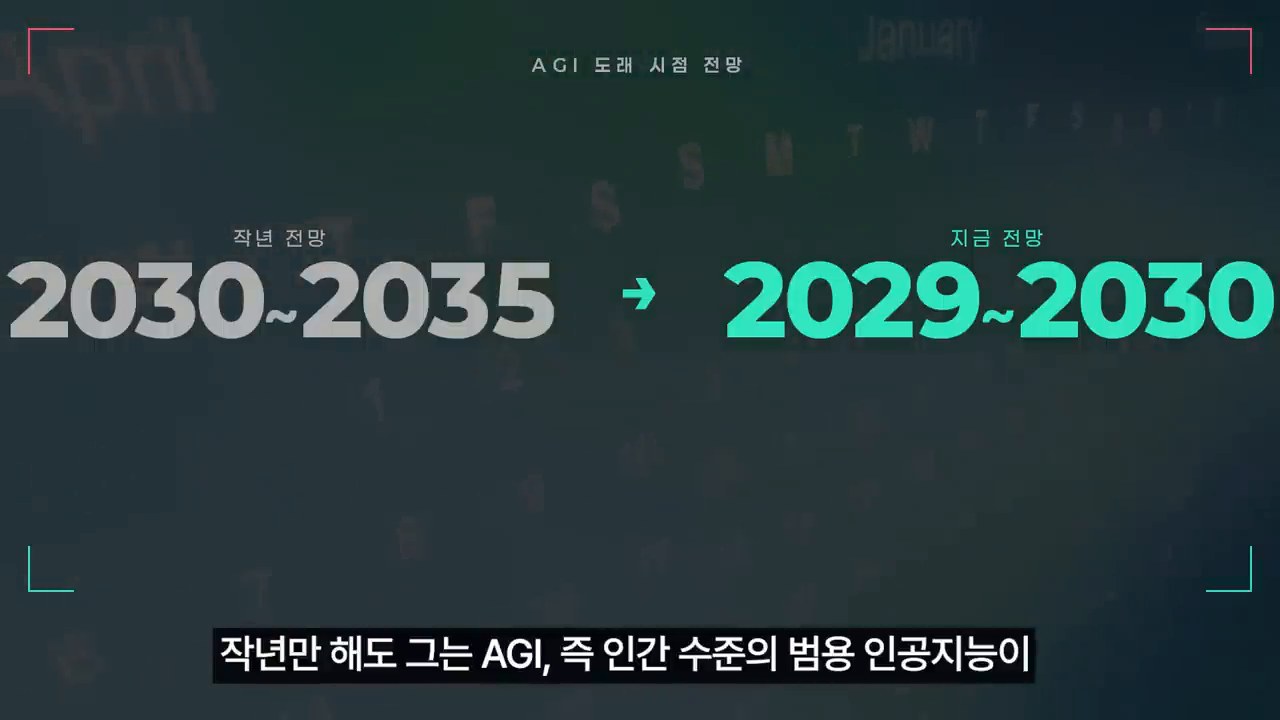
    AGI 예상 시점이 2030년대 중반에서 2029~2030년으로 당겨졌다는 설명

    AGI 도래 시점 전망은 사람과 기관마다 다르지만, 최근 논의의 시간축은 확실히 짧아졌다.

    여기서 한 가지 사실관계는 바로잡아야 합니다. 영상 자막에는 하사비스가 “2014년 노벨 화학상”을 받았다는 식의 표현이 보이지만, NobelPrize.org의 공식 기록은 2024년 노벨 화학상입니다. 데미스 하사비스와 존 점퍼는 AlphaFold를 통한 단백질 구조 예측 공로로 수상했습니다. 이 점이 중요한 이유는, 그의 AGI 발언이 단순한 홍보 문구가 아니라 실제 과학적 성과를 낸 연구 조직의 책임자 발언이라는 점 때문입니다.

    특이점 논의의 핵심은 ‘기술 낙관’과 ‘통제 가능성’의 충돌이다

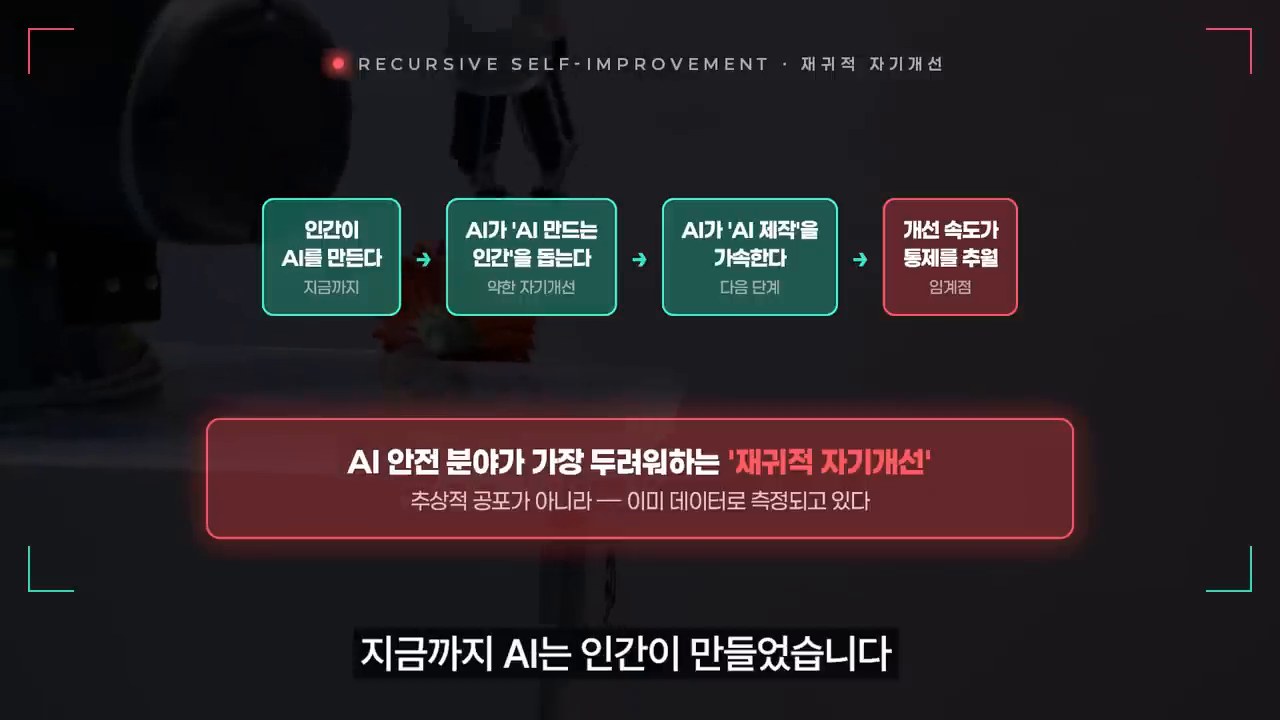
    특이점이라는 말은 종종 신비롭게 들립니다. 그러나 실무적으로 번역하면 훨씬 단순합니다. AI가 인간의 도움 없이 연구·개발·실험·코딩·전략 수립 능력을 빠르게 개선하기 시작하면, 인간 사회가 그 변화를 따라잡기 어려워질 수 있다는 뜻입니다.

    영상은 이 지점을 초지능 위험론과 연결합니다. 유드코스키와 네이트 소아레스의 『If Anyone Builds It, Everyone Dies』는 초지능 AI가 인간을 미워해서가 아니라, 목표를 수행하는 과정에서 인간의 생존을 고려하지 않을 수 있다는 점을 강조합니다. 출판사 소개 역시 이 책을 “초인간 AI 개발 경쟁이 인류를 멸종 경로로 밀어 넣을 수 있다”는 경고로 설명합니다.

    AI 안전 장치가 인간이 만든 제약이라는 영상의 경고 도식

    핵심 쟁점은 AI가 똑똑해지는 속도보다 인간이 안전하게 통제할 수 있느냐에 있다.

    물론 이 주장은 AI 업계 전체의 합의가 아닙니다. 일부 연구자는 초지능 위험을 가장 중요한 문명 위험으로 보고, 다른 연구자는 단기적으로는 일자리, 저작권, 허위정보, 권력 집중, 보안 사고가 더 시급하다고 봅니다. 따라서 좋은 독해법은 “맞다/틀리다”가 아닙니다. 가능성은 낮아도 피해가 극단적으로 큰 위험과, 이미 현실화된 단기 위험을 동시에 관리해야 한다는 균형입니다.

    AI 2027 같은 시나리오가 주는 의미

    추가로 볼 만한 자료는 AI Futures Project의 AI 2027 시나리오입니다. 이 자료는 하나의 예언서가 아니라, 빠른 AI 발전이 연구 자동화, 보안 경쟁, 정책 압박, 기업 간 속도 경쟁을 어떻게 키울 수 있는지 보여주는 사고 실험에 가깝습니다.

    이런 시나리오가 유용한 이유는 날짜를 맞히기 위해서가 아닙니다. 조직과 개인이 “만약 AI 능력이 지금보다 10배 더 강해지고, 비용은 더 낮아지고, 누구나 에이전트형 도구를 쓰게 된다면 무엇이 취약해질까”를 미리 점검하게 만들기 때문입니다.

    기업이라면 다음 질문을 던져야 합니다.

    • 핵심 업무 지식이 일부 사람의 머릿속에만 있는가?
    • AI가 만든 결과물을 검증하는 기준이 있는가?
    • 보안·개인정보·저작권 책임자가 AI 사용 흐름을 알고 있는가?
    • 구성원이 AI를 금지된 도구가 아니라 통제 가능한 협업 도구로 쓰고 있는가?
    • 빠른 자동화가 고객 신뢰와 품질을 해치지 않도록 중간 점검 장치가 있는가?

    초지능을 두려워하기 전에, 먼저 ‘AI와 일하는 능력’을 만들어야 한다

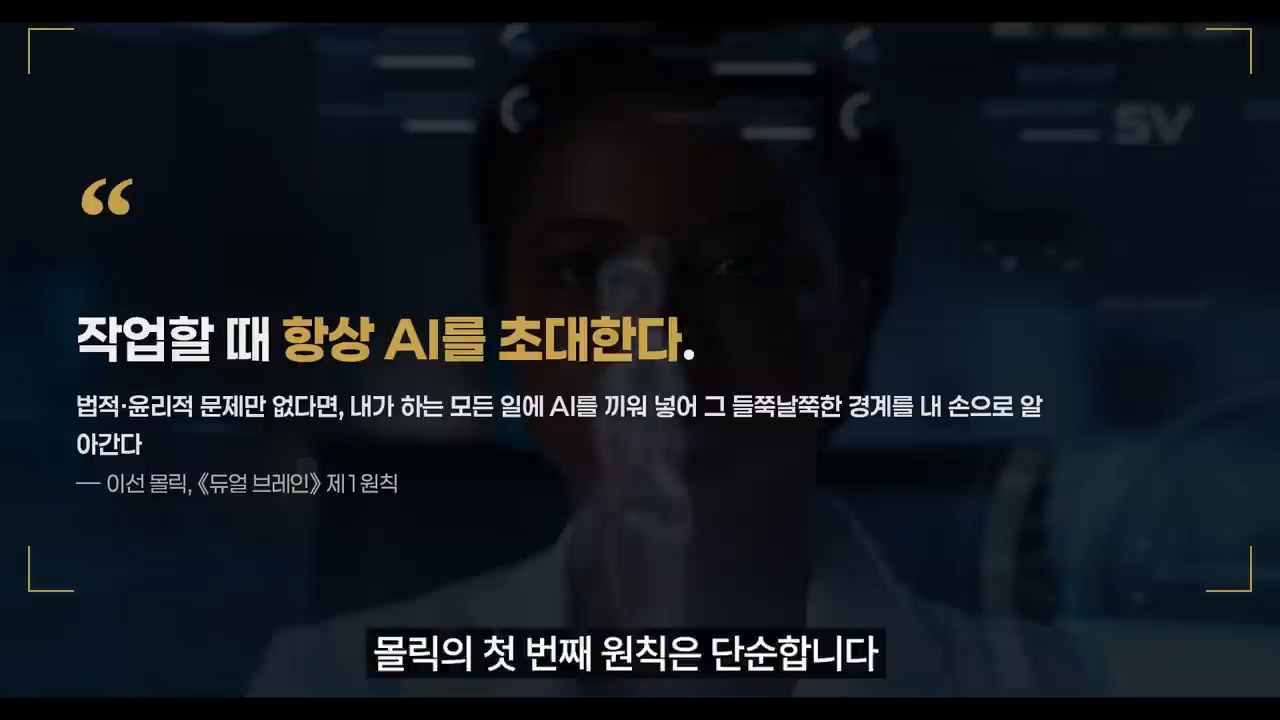
    영상의 후반부에서 가장 실용적인 메시지는 “작업할 때 항상 AI를 초대한다”는 문장입니다. 이 말은 모든 판단을 AI에게 맡기라는 뜻이 아닙니다. 오히려 반대입니다. AI를 옆에 두되, 인간이 문제를 정의하고, 답을 검토하고, 맥락을 보완하는 훈련을 반복하라는 뜻입니다.

    AI 시대에는 작업할 때 AI를 초대해야 한다는 실천 메시지

    공포만으로는 부족하다. 개인과 조직은 AI를 실제 업무의 협업 대상으로 다루는 훈련이 필요하다.

    AGI 논의가 멀게 느껴진다면 이렇게 바꿔 생각해도 됩니다. “3~4년 뒤 AGI가 오느냐”보다 더 가까운 질문은 “올해 안에 내 업무의 절반 이상이 AI와 함께 수행되는가”입니다. 이 질문에는 이미 많은 사람이 “그렇다”고 답할 수 있습니다.

    개인에게 필요한 준비는 세 가지입니다.

    1. 질문력: AI에게 맡길 문제와 사람이 직접 판단해야 할 문제를 구분하는 능력.
    2. 검증력: 그럴듯한 답을 사실, 출처, 수치, 맥락으로 다시 확인하는 능력.
    3. 재설계력: 기존 업무 절차를 AI 협업에 맞게 다시 짜는 능력.

    이 세 가지는 코딩 직군만의 역량이 아닙니다. 기획, HR, 교육, 마케팅, 행정, 연구, 영업 모두에게 필요한 기본 문해력입니다.

    그래서 우리는 무엇을 해야 하나

    AGI와 특이점 담론을 읽을 때 가장 위험한 태도는 두 가지입니다. 하나는 “전부 과장”이라며 무시하는 것이고, 다른 하나는 “곧 끝장”이라며 손을 놓는 것입니다.

    현실적인 태도는 중간에 있습니다. 기술 발전의 속도는 진지하게 받아들이되, 공포를 실행 가능한 체크리스트로 바꾸는 것입니다.

    개인과 조직은 지금부터 다음 네 가지를 시작해야 합니다.

    • AI 사용 원칙을 문서화한다.
    • 중요한 의사결정에는 사람의 검토 단계를 남긴다.
    • 반복 업무는 AI와 함께 재설계한다.
    • AI가 틀렸을 때 손실이 커지는 영역부터 통제 장치를 만든다.

    초지능이 실제로 몇 년 안에 올지는 아무도 확정할 수 없습니다. 그러나 AI가 일과 학습의 기본 인프라가 되는 흐름은 이미 시작됐습니다. 따라서 가장 좋은 준비는 공포를 소비하는 것이 아니라, AI를 안전하게 쓰는 습관과 조직 운영체계를 먼저 만드는 것입니다.

    함께 읽어볼 글

    참고자료

    FAQ

    AGI는 정확히 무엇인가요?

    AGI는 특정 과제만 잘하는 좁은 AI가 아니라, 다양한 영역에서 인간 수준 또는 그 이상의 일반 문제 해결 능력을 보이는 인공지능을 뜻합니다. 다만 연구자마다 정의와 판정 기준은 다릅니다.

    특이점은 이미 시작됐다는 뜻인가요?

    아닙니다. “특이점의 산기슭”이라는 표현은 AI 발전이 매우 빠르게 진행되고 있다는 비유에 가깝습니다. AGI가 이미 완성됐다는 뜻으로 읽기보다는, 준비 시간이 짧아지고 있다는 신호로 보는 편이 안전합니다.

    초지능 AI 위험론은 과장인가요?

    일부 주장은 매우 강한 경고에 가깝습니다. 그러나 피해 규모가 극단적으로 클 수 있는 위험은 낮은 확률이라도 관리해야 합니다. 동시에 일자리, 보안, 허위정보, 개인정보 같은 단기 위험도 함께 봐야 합니다.

    개인은 지금 무엇부터 해야 하나요?

    AI 도구를 무작정 많이 쓰기보다, 질문을 잘게 나누고 결과를 검증하며 업무 절차를 재설계하는 연습부터 시작하는 것이 좋습니다. 핵심은 AI 사용량이 아니라 검증 가능한 협업 방식입니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • AI 코딩의 본질은 모델이 아니라 하네스다: Matt Pocock의 에이전틱 엔지니어링

    AI 코딩의 본질은 모델이 아니라 하네스다: Matt Pocock의 에이전틱 엔지니어링

    Matt Pocock의 에이전틱 엔지니어링 워크플로우 영상 썸네일
    Matt Pocock의 에이전틱 엔지니어링 워크플로우를 다룬 Tech Bridge 영상 썸네일

    AI 코딩 이야기를 하면 대부분 먼저 모델 이름을 꺼냅니다. Claude가 낫다, Codex가 빨라졌다, Gemini CLI가 어디까지 한다더라. 물론 모델은 중요합니다. 그런데 Matt Pocock은 이 영상에서 조금 다른 곳을 보라고 말합니다. 진짜 차이는 모델이 아니라 하네스(harness)에서 난다는 것입니다.

    하네스는 모델을 둘러싼 작업 환경입니다. 프롬프트, skill, 코드베이스 구조, 테스트, 문서, 샌드박스, GitHub Actions, 리뷰 흐름까지 모두 포함합니다. 자동차로 치면 엔진만 보는 것이 아니라 섀시, 공기역학, 피트 크루, 트랙 운영까지 보는 셈입니다.

    이 관점은 AI 코딩을 처음 쓰는 사람에게도, 이미 Claude Code나 Codex를 업무에 붙이고 있는 팀에게도 중요합니다. 왜냐하면 모델 성능은 우리가 직접 통제하기 어렵지만, 하네스는 우리가 설계할 수 있기 때문입니다.

    AI는 전술적 프로그래밍을 먹어치웠다

    Matt Pocock은 John Ousterhout의 표현을 빌려 프로그래밍을 두 층으로 나눕니다. 하나는 전술적 프로그래밍입니다. 코드를 쓰고, 버그를 고치고, 커밋을 만들고, 문법을 맞추는 일입니다. 다른 하나는 전략적 프로그래밍입니다. 어떤 구조가 유지보수에 좋은지, 작업을 어떻게 쪼개야 하는지, 코드베이스가 앞으로 어떤 방향으로 가야 하는지 판단하는 일입니다.

    AI는 이미 전술적 프로그래밍을 상당 부분 먹어치웠습니다. 작은 기능 구현, 테스트 추가, 리팩터링 초안, 문서 수정은 이제 사람이 직접 붙잡고 있어야만 하는 일이 아닙니다. 문제는 여기서부터입니다. 전술을 AI가 맡을수록 인간의 가치는 전략으로 이동합니다.

    그래서 AI 시대의 개발자는 단순히 “프롬프트를 잘 쓰는 사람”이 아니라 “좋은 위임을 설계하는 사람”이 되어야 합니다. 목표를 명확히 쓰고, 범위를 좁히고, 완료 기준을 정하고, 테스트 방법을 붙여야 합니다. AI가 코드를 많이 만들수록, 인간은 더 선명하게 판단해야 합니다.

    최신 모델보다 중요한 것은 작업 환경이다

    영상에서 가장 강한 문장은 이것입니다. “모두가 모델에 집착하지만, 더 관심을 가져야 할 것은 하네스다.” 모델은 유용하지만 하네스도 그만큼 중요하고, 우리는 모델보다 하네스를 훨씬 더 많이 통제할 수 있습니다.

    예를 들어 토큰 비용을 줄이고 싶다고 해보겠습니다. 흔한 답은 더 짧은 프롬프트를 쓰거나 더 싼 모델을 고르는 것입니다. Matt의 답은 다릅니다. 변경하기 쉬운 코드베이스를 가져라. 코드 구조가 명확하고, 테스트가 있고, 문서가 최신이면 AI는 적은 맥락으로도 더 정확히 움직입니다. 반대로 코드베이스가 엉켜 있으면 비싼 모델도 오래 헤맵니다.

    이 말은 한국 개발팀에도 그대로 적용됩니다. AI 도입을 “어떤 구독제를 쓸까”에서 시작하면 효과가 작습니다. “우리 저장소는 에이전트가 일하기 쉬운가?”에서 시작해야 합니다.

    Skill은 많이 붙이는 것이 아니라 절차로 관리해야 한다

    영상에는 Matt이 사용하는 skill 이야기가 자주 나옵니다. skill은 반복되는 사고 절차나 작업 방식을 AI가 다시 사용할 수 있도록 만든 지시 묶음입니다. 예를 들어 학습 코치를 만들거나, 설계를 공격적으로 검토하게 하거나, 특정 방식으로 PR을 리뷰하게 할 수 있습니다.

    흥미로운 점은 Matt이 skill을 무조건 많이 붙이라고 말하지 않는다는 것입니다. 오히려 모든 skill, plugin, MCP server, Claude.md, agents.md를 지우고 빈 상태에서 시작해보라고 권합니다. 먼저 AI가 기본 상태에서 어떻게 행동하는지 관찰하고, 정말 필요한 것만 다시 추가하라는 뜻입니다.

    여기에는 중요한 이유가 있습니다. 너무 많은 지시와 skill 설명은 컨텍스트 창을 오염시킵니다. 모델은 더 많은 정보를 받았지만 오히려 더 혼란스러워질 수 있습니다. 그래서 Matt은 모델이 알아서 호출하는 능력형 skill보다, 사용자가 필요할 때 명시적으로 부르는 절차형 skill을 더 선호합니다. 핸들은 사람이 잡고 있어야 한다는 관점입니다.

    AFK 에이전트는 ‘무한 루프’보다 ‘큐’에 가깝다

    요즘 agentic loop라는 표현이 자주 나옵니다. 에이전트가 계속 생각하고, 실행하고, 관찰하고, 다시 실행하는 구조입니다. 멋있게 들리지만 실무에서는 조금 위험하게 느껴질 때도 있습니다. 범위가 흐려지고, 비용이 커지고, 검토 지점이 사라질 수 있기 때문입니다.

    Matt은 여기서 “loop보다 queue”라는 관점을 제안합니다. GitHub issue나 Jira ticket처럼 작업을 큐에 쌓고, 에이전트가 하나씩 가져가 처리하게 하는 방식입니다. 조사하고, 수정하고, 테스트하고, PR을 만들고, 마지막에는 사람이 확인합니다.

    이 방식은 낯설지 않습니다. 개발팀은 원래 큐로 일해왔습니다. 백로그, 이슈, PR, 리뷰가 모두 큐 기반입니다. AI 에이전트는 그 흐름에 새로운 작업자 노드로 들어오는 것입니다. 그래서 처음부터 완전 자동화를 꿈꾸기보다, 작은 큐부터 맡기는 편이 안전합니다.

    예를 들면 이런 작업이 좋습니다.

    • 실패한 테스트 원인 조사
    • 문서와 README 업데이트
    • 단순 리팩터링 후보 제안
    • PR 리뷰 초안 작성
    • 보안 점검 체크리스트 실행
    • 오래된 이슈의 재현 가능성 확인

    핵심은 사람이 옆에서 매 초 개입하지 않아도 되는 단위로 작업을 쪼개는 것입니다. 그리고 결과는 반드시 리뷰합니다.

    AX: 이제는 Agent Experience도 설계해야 한다

    개발팀은 오랫동안 DX, 즉 Developer Experience를 이야기해왔습니다. 개발자가 설치하고, 실행하고, 테스트하고, 배포하기 쉬운 환경을 만드는 일입니다. Matt은 여기서 한 단계 더 나아가 AX, 즉 Agent Experience를 말합니다.

    AX는 에이전트가 코드베이스에서 일하기 쉬운 정도입니다. 좋은 AX를 가진 저장소는 이런 특징을 가집니다.

    • 폴더 구조가 예측 가능하다.
    • 테스트 실행 명령이 명확하다.
    • 타입체크와 린트가 자동화되어 있다.
    • README와 개발 문서가 최신이다.
    • 모듈 경계가 비교적 분명하다.
    • 작은 변경을 안전하게 검증할 수 있다.
    • 샌드박스에서 실행해도 필요한 정보가 충분하다.

    흥미로운 점은 좋은 AX가 좋은 DX와 크게 겹친다는 것입니다. 사람에게 좋은 코드베이스는 AI에게도 좋습니다. 다만 AI 시대에는 이 기준이 더 날카로워집니다. 사람이 눈치로 넘어가던 빈틈을 에이전트는 자주 놓칩니다. 그래서 문서, 테스트, 명령어, 경계가 더 중요해집니다.

    AI가 발견한 문제는 시스템 개선으로 바꿔야 한다

    최신 모델이 보안 버그를 찾아냈다고 합시다. 여기서 “이 모델 정말 좋다”로 끝나면 절반만 배운 것입니다. 더 중요한 질문은 따로 있습니다. 왜 이 버그가 지금까지 남아 있었을까? 기존 테스트가 왜 잡지 못했을까? 비슷한 문제가 더 있을까? 다음에는 자동으로 찾게 만들 수 있을까?

    Matt의 관점에서 AI가 준 결과는 단발성 산출물이 아니라 하네스를 개선할 신호입니다. 버그 하나를 고치는 데서 멈추지 않고, 테스트를 추가하고, 리뷰 기준을 바꾸고, 보안 점검 skill을 만들고, CI에 넣을 수 있는 검사를 찾는 방식입니다.

    이것이 AI 코딩을 일회성 생산성 도구가 아니라 조직의 학습 시스템으로 쓰는 방법입니다. AI가 코드를 더 빨리 쓰게 하는 것보다, AI가 발견한 패턴을 다음 작업 환경에 반영하는 것이 더 오래갑니다.

    제품과 비즈니스 판단은 여전히 인간의 몫이다

    영상 후반부에서 SaaS가 죽었는지, AI 스타트업은 어떻게 해야 하는지에 대한 이야기도 나옵니다. Matt의 답은 의외로 담백합니다. 고객과 이야기하고, 실제 문제를 찾고, 프로토타입을 만들고, 해결책을 검증하라는 것입니다.

    AI는 구현 속도를 높입니다. 그러나 무엇을 만들지, 왜 만들어야 하는지, 어떤 기능을 빼야 하는지는 자동으로 해결하지 못합니다. 오히려 구현이 쉬워질수록 더 많은 기능을 넣고 싶은 유혹이 커집니다. 이때 필요한 질문은 “무엇을 더 만들까?”가 아니라 “무엇을 줄이면 더 명확해질까?”일 수 있습니다.

    AI 시대에도 제품의 중심은 고객의 문제입니다. 에이전트는 그 문제를 빠르게 실험하게 해주는 도구입니다. 문제 정의 자체를 대신해주는 존재는 아닙니다.

    한국 개발자와 조직이 바로 해볼 7가지

    첫째, 저장소의 README를 에이전트 기준으로 다시 읽어보세요. 처음 들어온 AI가 설치, 실행, 테스트를 이해할 수 있는지 확인합니다.

    둘째, 자주 반복하는 요청을 skill이나 템플릿으로 만드세요. 단, 너무 많이 만들지 말고 실제로 반복되는 절차부터 시작합니다.

    셋째, 이슈를 AI에게 줄 수 있는 크기로 쪼개세요. “관리자 페이지 개선”보다 “필터 컴포넌트에 빈 상태 메시지 추가, 기존 테스트 통과”가 낫습니다.

    넷째, 테스트 명령과 완료 기준을 작업 지시에 포함하세요. AI에게 맡긴 뒤 사람이 다시 처음부터 확인하는 시간을 줄일 수 있습니다.

    다섯째, AFK 작업은 샌드박스와 권한 제한 안에서 시작하세요. API key, 배포 권한, 운영 DB 접근은 특히 조심해야 합니다.

    여섯째, AI가 만든 PR을 코드만 보지 말고 실패 패턴까지 보세요. 어디서 헷갈렸는지 알면 문서와 하네스를 개선할 수 있습니다.

    일곱째, 최신 모델 뉴스는 따라가되, 팀의 기본기를 더 자주 점검하세요. 구조, 테스트, 문서, 리뷰 흐름이 약하면 어떤 모델도 오래 버티지 못합니다.

    함께 읽으면 좋은 글

    FAQ

    AI 코딩에서 하네스란 무엇인가요?

    하네스는 모델이 일하는 전체 환경입니다. 프롬프트, skill, 코드베이스 구조, 테스트, 문서, 샌드박스, CI, 리뷰 흐름까지 포함합니다. 모델 자체보다 우리가 직접 설계하고 개선할 수 있는 영역입니다.

    왜 최신 모델보다 코드베이스 구조가 중요하다고 하나요?

    좋은 구조와 테스트가 있으면 AI가 적은 맥락으로도 안전하게 변경할 수 있습니다. 반대로 구조가 복잡하고 문서가 낡았으면 비싼 모델도 헤맵니다. 그래서 토큰 비용을 줄이는 방법은 프롬프트 최적화만이 아니라 변경하기 쉬운 코드베이스를 만드는 것입니다.

    Agentic loop와 queue 방식은 어떻게 다른가요?

    Agentic loop는 에이전트가 계속 실행과 관찰을 반복하는 구조에 가깝습니다. Queue 방식은 사람이 정의한 작업 목록을 에이전트가 하나씩 처리하고, 결과를 리뷰하는 방식입니다. 실무에서는 queue 방식이 범위와 책임을 관리하기 쉽습니다.

    AX는 기존 DX와 무엇이 다른가요?

    DX는 사람이 개발하기 쉬운 경험이고, AX는 AI 에이전트가 작업하기 쉬운 경험입니다. 둘은 많이 겹칩니다. 명확한 문서, 예측 가능한 구조, 자동화된 테스트는 사람에게도 좋고 에이전트에게도 좋습니다.

    AI에게 코딩을 맡길 때 가장 먼저 준비할 것은 무엇인가요?

    작업 범위와 완료 기준입니다. 무엇을 바꿀지, 바꾸지 말아야 할 것은 무엇인지, 어떤 테스트를 통과해야 하는지 적어야 합니다. 그 다음에 샌드박스, 권한 제한, 리뷰 흐름을 붙이면 더 안전합니다.

    참고자료

    AI 코딩의 다음 단계는 더 많은 도구를 켜는 일이 아닐 수 있습니다. 오히려 잠시 멈추고, AI가 일하는 환경을 보는 일입니다. 어떤 문서가 부족한지, 어떤 테스트가 불안한지, 어떤 작업을 큐로 넘길 수 있는지 확인하는 것. 그 작은 정리가 최신 모델 하나를 더 구독하는 것보다 큰 차이를 만들 수 있습니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • 바이브 코딩 입문자가 꼭 알아야 할 프론트엔드 기본 개념 15가지

    바이브 코딩 입문자가 꼭 알아야 할 프론트엔드 기본 개념 15가지

    바이브 코딩을 시작하면 곧 낯선 단어들이 몰려옵니다. React, Next.js, API, CSR, SSR, NPM, 빌드, 번들링…. 처음에는 전부 외워야 할 것처럼 보입니다.

    그런데 실제로 중요한 것은 단어 암기가 아닙니다. “이 기술이 왜 생겼는가”를 아는 것입니다. 그래야 AI가 짜준 코드가 어디에서 동작하고, 무엇을 고쳐 달라고 해야 하는지 감이 잡힙니다.

    이 글은 양실장의 바이브코딩대학 영상 「비개발자 바이브코더를 위해 만든, 가볍게 들어도 깊게 남는 프론트엔드 기본 지식」을 바탕으로, 초보자가 먼저 알아야 할 프론트엔드 개념을 쉬운 말로 정리한 글입니다.

    React라는 프론트엔드 키워드가 크게 보이는 바이브 코딩 강의 화면
    바이브 코딩을 시작하면 React 같은 단어를 자주 만납니다. 중요한 것은 암기가 아니라 흐름입니다.

    Read in English: 15 Frontend Basics Every Vibe-Coding Beginner Should Know

    1. 인터넷과 웹은 다르다

    가장 먼저 헷갈리는 말이 인터넷과 웹입니다.

    인터넷은 전 세계 컴퓨터를 연결한 거대한 통신망입니다. 도로, 전기망, 수도관처럼 기반 시설에 가깝습니다. 반면 웹은 그 인터넷 위에서 문서를 주고받고, 링크를 따라 이동하게 만든 서비스입니다.

    쉽게 말하면 이렇습니다.

    • 인터넷: 컴퓨터들이 서로 연결되는 길
    • 웹: 그 길 위에서 문서와 화면을 주고받는 서비스
    • 브라우저: 웹을 보기 위해 사용하는 앱

    그래서 “웹사이트를 만든다”는 말은 인터넷 자체를 만드는 것이 아닙니다. 인터넷이라는 기반 위에서 사용자가 볼 수 있는 문서와 기능을 설계한다는 뜻입니다.

    2. 웹의 출발은 문서와 링크였다

    웹은 처음부터 지금처럼 복잡하지 않았습니다. 팀 버너스리가 만든 초기 웹의 핵심은 연구 문서를 서로 연결하는 것이었습니다. 문서 안의 특정 단어를 누르면 다른 문서로 이동하는 방식, 즉 하이퍼링크가 핵심이었습니다.

    이때 필요한 기본 기술이 세 가지였습니다.

    1. HTML: 문서의 구조를 표시하는 언어
    2. URL: 문서의 주소
    3. HTTP: 브라우저와 서버가 문서를 주고받는 약속

    이 세 가지는 지금도 웹의 뿌리입니다. React나 Next.js를 쓰더라도 결국 브라우저는 HTML을 해석하고, URL로 위치를 찾고, HTTP로 데이터를 주고받습니다.

    3. HTML은 뼈대, CSS는 옷, JavaScript는 행동이다

    초보자가 프론트엔드를 이해할 때 가장 쉬운 비유는 사람입니다.

    HTML은 뼈대입니다. 제목, 문단, 이미지, 버튼, 입력창처럼 화면에 무엇이 있는지를 정합니다.

    CSS는 옷과 분위기입니다. 색상, 크기, 위치, 간격, 글꼴처럼 어떻게 보일지를 담당합니다.

    JavaScript는 행동입니다. 버튼을 눌렀을 때 메뉴가 열리고, 입력값이 검사되고, 장바구니 수량이 바뀌는 동작을 만듭니다.

    처음 웹은 거의 문서에 가까웠습니다. 예쁘게 꾸미는 문제 때문에 CSS가 필요해졌고, 사용자의 클릭과 입력에 반응해야 하면서 JavaScript가 중요해졌습니다.

    4. 브라우저는 코드를 그림으로 바꾼다

    프론트엔드 코드는 사람이 보는 화면이 아닙니다. 브라우저가 해석해야 하는 재료입니다.

    브라우저는 대략 이런 과정을 거칩니다.

    1. HTML과 CSS를 읽는다.
    2. 화면에 어떤 요소가 있는지 구조를 만든다.
    3. 각 요소의 크기와 위치를 계산한다.
    4. 픽셀로 칠해서 화면에 보여준다.

    이 과정을 렌더링이라고 합니다. 화면의 요소가 바뀌면 브라우저는 다시 계산해야 합니다. 위치 계산이 다시 일어나는 일을 리플로우라고 부르고, 다시 그리는 일을 리페인트라고 부릅니다.

    이 개념을 알면 AI에게 더 구체적으로 말할 수 있습니다. “버튼 색을 바꿔 줘”와 “버튼을 누를 때 레이아웃이 흔들리지 않도록 수정해 줘”는 전혀 다른 요청입니다.

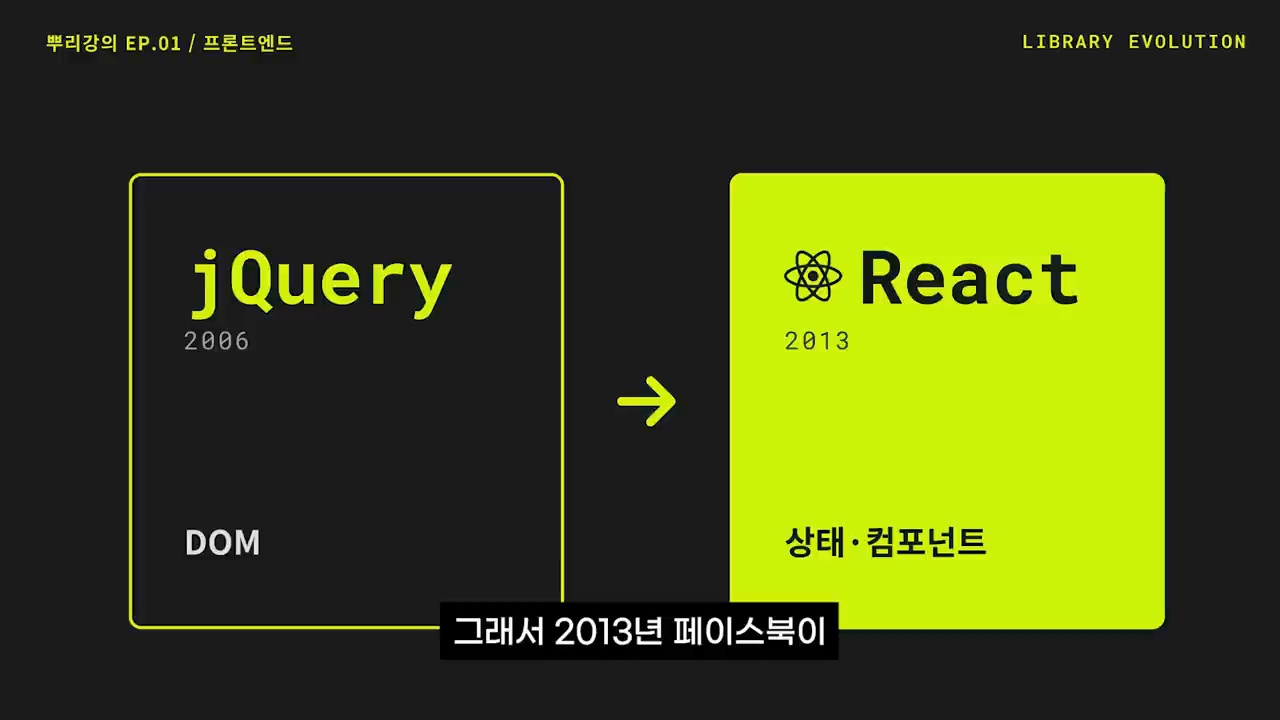
    5. jQuery와 React는 서로 다른 문제를 풀었다

    jQuery에서 React로 프론트엔드 사고가 바뀌는 흐름을 설명하는 강의 화면
    프론트엔드는 DOM 조작 중심에서 상태와 컴포넌트 중심으로 이동했습니다.

    예전에는 브라우저마다 JavaScript 동작 방식이 조금씩 달랐습니다. 개발자는 같은 기능을 여러 브라우저에서 맞추느라 고생했습니다. 이 문제를 쉽게 만들어 준 도구가 jQuery였습니다. DOM 조작을 더 간단하고 일관되게 해준 것입니다.

    그 뒤 웹은 더 복잡해졌습니다. 단순히 버튼 하나를 움직이는 수준이 아니라, 로그인 상태, 장바구니, 알림, 실시간 데이터처럼 화면 전체가 계속 변하게 됐습니다.

    React는 이 복잡성을 “상태” 중심으로 다루게 해줍니다. 상태란 화면이 기억해야 하는 현재 값입니다. 예를 들어 로그인 여부, 장바구니 개수, 선택된 탭, 검색어 같은 것입니다.

    React식 사고는 이렇습니다.

    • 상태가 바뀐다.
    • 화면은 그 상태에 맞게 다시 그려진다.
    • 같은 UI 조각은 컴포넌트로 재사용한다.

    바이브 코딩에서 React 코드를 자주 만나는 이유도 여기에 있습니다. 요즘 웹앱은 상태가 많고, 재사용할 UI가 많기 때문입니다.

    6. Node.js와 NPM은 프론트엔드를 ‘생태계’로 만들었다

    JavaScript는 원래 브라우저 안에서만 움직이는 언어였습니다. 그런데 Node.js가 등장하면서 JavaScript를 서버나 개발 도구에서도 실행할 수 있게 됐습니다.

    NPM은 JavaScript 패키지를 설치하고 관리하는 도구입니다. 패키지는 누군가 만들어 둔 코드 묶음입니다. 우리가 직접 모든 기능을 만들지 않고도 날짜 처리, 화면 구성, 아이콘, 빌드 도구를 가져다 쓸 수 있게 해줍니다.

    초보자에게 NPM은 조금 무섭게 느껴질 수 있습니다. 하지만 핵심은 간단합니다.

    • Node.js: JavaScript를 브라우저 밖에서도 실행하게 해주는 환경
    • NPM: 필요한 코드 묶음을 설치하고 관리하는 창고
    • package.json: 이 프로젝트가 어떤 패키지에 의존하는지 적어 둔 목록

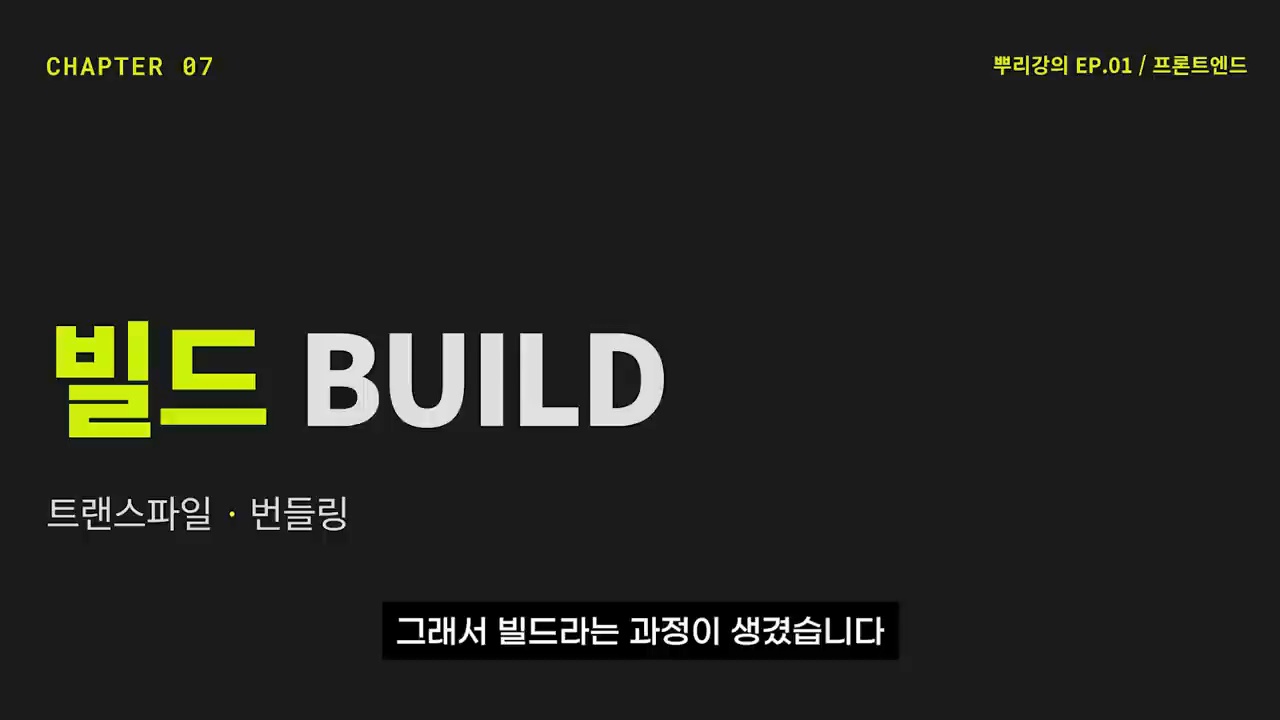
    7. 빌드는 개발용 코드를 배포용 코드로 정리하는 과정이다

    빌드 과정과 트랜스파일링 번들링을 설명하는 강의 화면
    빌드는 개발자가 작성한 코드를 사용자가 빠르게 볼 수 있는 형태로 정리하는 과정입니다.

    요즘 프론트엔드 프로젝트에는 파일이 많습니다. JavaScript, TypeScript, CSS, 이미지, 폰트, 라이브러리가 함께 들어갑니다. 이 상태 그대로 브라우저에 던지면 비효율적입니다.

    그래서 빌드가 필요합니다. 빌드는 개발자가 작업하기 좋은 코드를 사용자가 빠르게 볼 수 있는 코드로 정리하는 과정입니다.

    대표적인 작업은 다음과 같습니다.

    • 트랜스파일링: 최신 문법을 더 넓은 브라우저가 이해할 수 있게 바꾼다.
    • 번들링: 여러 파일을 적절히 묶는다.
    • 트리쉐이킹: 실제로 쓰지 않는 코드를 덜어낸다.
    • 최적화: 파일 크기를 줄이고 로딩 속도를 높인다.

    AI에게 “빌드 오류를 고쳐 줘”라고만 말하면 범위가 너무 넓습니다. “NPM 패키지 충돌인지, TypeScript 변환 오류인지, 번들링 단계 오류인지 확인해 줘”라고 말하면 훨씬 정확한 답을 받을 수 있습니다.

    8. MPA와 SPA는 페이지를 바꾸는 방식이 다르다

    SPA 개념을 설명하는 프론트엔드 강의 화면
    SPA는 웹사이트가 앱처럼 부드럽게 동작하게 만든 대표적인 흐름입니다.

    전통적인 웹사이트는 페이지를 이동할 때마다 서버에서 새 HTML을 받아왔습니다. 이것을 MPA, 즉 Multi Page Application이라고 부릅니다.

    반면 SPA는 처음에 앱 껍데기를 받아온 뒤, 필요한 데이터만 주고받으며 화면을 바꿉니다. 페이지 전체가 매번 새로고침되지 않기 때문에 앱처럼 부드럽게 느껴집니다.

    둘 중 하나가 무조건 좋은 것은 아닙니다.

    • MPA: 구조가 단순하고 검색엔진이 이해하기 쉽다.
    • SPA: 사용자 경험이 부드럽지만 초기 로딩과 SEO가 어려울 수 있다.

    바이브 코딩으로 웹앱을 만들 때 “왜 화면은 바뀌는데 주소는 그대로인가”, “왜 검색엔진에 잘 안 잡히는가” 같은 문제가 생긴다면 이 차이를 떠올리면 됩니다.

    9. CSR, SSR, 하이드레이션은 ‘누가 먼저 그리느냐’의 문제다

    CSR은 Client Side Rendering입니다. 브라우저가 JavaScript를 받아서 화면을 그리는 방식입니다. 사용자는 처음에 빈 화면을 잠깐 볼 수 있고, 검색엔진도 내용을 늦게 이해할 수 있습니다.

    SSR은 Server Side Rendering입니다. 서버가 미리 HTML을 만들어서 브라우저에 보내는 방식입니다. 첫 화면이 빠르게 보이고 검색엔진에도 유리합니다.

    하이드레이션은 서버가 먼저 그려 준 HTML에 JavaScript 기능을 붙이는 과정입니다. 겉으로 보이는 화면은 이미 있지만, 버튼 클릭이나 상태 변경 같은 상호작용을 나중에 연결하는 것입니다.

    SSR과 CSR 렌더링 방식을 비교하는 강의 화면
    CSR과 SSR은 화면을 어디에서 먼저 그리느냐의 차이입니다.

    Next.js 같은 프레임워크가 주목받는 이유도 여기에 있습니다. 페이지 성격에 따라 CSR, SSR, 정적 생성 같은 방식을 섞어 쓸 수 있기 때문입니다.

    10. API는 프론트엔드와 백엔드 사이의 약속이다

    프론트엔드는 사용자가 보는 화면을 담당합니다. 백엔드는 데이터 저장, 인증, 결제, 권한 같은 뒤쪽 일을 맡습니다. 둘 사이에는 데이터를 주고받는 약속이 필요합니다. 이것이 API입니다.

    예를 들어 사용자가 로그인 버튼을 누르면 프론트엔드는 백엔드에 “이 아이디와 비밀번호가 맞나요?”라고 요청합니다. 백엔드는 결과를 돌려줍니다. 프론트엔드는 그 결과에 따라 화면을 바꿉니다.

    초보자는 API를 “화면과 데이터 창고 사이의 주문서”로 이해하면 됩니다. 어떤 주소로, 어떤 형식의 데이터를 보내고, 어떤 응답을 받을지 정한 약속입니다.

    바이브 코딩 초보자가 기억할 핵심 체크리스트

    프론트엔드 용어가 쏟아질 때는 아래 질문으로 정리하면 좋습니다.

    1. 이 기술은 구조, 디자인, 동작, 데이터 중 무엇을 다루는가?
    2. 이 문제는 브라우저에서 생긴 문제인가, 서버에서 생긴 문제인가?
    3. 화면이 느린 문제인가, 데이터가 안 오는 문제인가, 상태가 꼬인 문제인가?
    4. 지금 필요한 것은 기능 구현인가, 빌드 오류 해결인가, 배포 최적화인가?
    5. AI에게 요청할 때 문제 위치와 기대 결과를 함께 말했는가?

    이 다섯 가지를 구분하면 프롬프트가 달라집니다. “잘 안 돼요”가 아니라 “React 상태가 바뀌었는데 화면이 갱신되지 않습니다. 원인을 찾아 주세요”라고 말할 수 있습니다.

    함께 읽으면 좋은 글

    FAQ

    바이브 코딩을 하려면 프론트엔드를 꼭 배워야 하나요?

    전문 개발자처럼 모든 문법을 외울 필요는 없습니다. 다만 HTML, CSS, JavaScript, API, 렌더링 방식 같은 기본 개념을 알면 AI에게 훨씬 정확한 요청을 할 수 있습니다.

    React와 Next.js는 같은 건가요?

    같지 않습니다. React는 UI를 만들기 위한 라이브러리이고, Next.js는 React를 기반으로 라우팅, 서버 렌더링, 정적 생성, 배포 구조까지 더 넓게 다루는 프레임워크입니다.

    CSR과 SSR은 왜 중요한가요?

    화면을 브라우저가 그리느냐, 서버가 먼저 그려 보내느냐의 차이입니다. 초기 로딩 속도, 검색엔진 노출, 사용자 경험에 영향을 줍니다.

    빌드 오류가 나면 무엇부터 봐야 하나요?

    먼저 오류가 패키지 설치 문제인지, 문법 변환 문제인지, 타입 검사 문제인지, 번들링 문제인지 나눠 봐야 합니다. 그다음 오류 메시지와 실행한 명령어를 함께 AI에게 알려 주면 좋습니다.

    초보자가 가장 먼저 익혀야 할 프론트엔드 개념은 무엇인가요?

    HTML·CSS·JavaScript의 역할, 브라우저 렌더링, 상태, API, 빌드, CSR·SSR의 차이를 먼저 잡는 것이 좋습니다. 이 개념들이 잡히면 React나 Next.js 문서도 덜 낯설게 보입니다.

    참고자료

    프론트엔드는 외울 단어가 많은 분야처럼 보이지만, 실제로는 웹이 겪어 온 문제 해결의 역사에 가깝습니다. 문서를 연결하던 웹이 디자인을 입고, 상호작용을 얻고, 앱처럼 움직이고, 다시 검색성과 속도를 고민하게 된 흐름입니다.

    바이브 코딩 입문자에게 필요한 것도 바로 이 흐름입니다. 흐름을 알면 AI가 만든 코드를 더 잘 읽고, 더 구체적으로 질문하고, 더 안전하게 수정할 수 있습니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • 앤트로픽 미토스 쇼크: AI도 전략자산이 된 시대, 한국은 무엇을 준비해야 하나

    앤트로픽 미토스 쇼크: AI도 전략자산이 된 시대, 한국은 무엇을 준비해야 하나

    앤트로픽의 ‘미토스(Mythos)’ 이슈는 새로운 AI 모델이 나왔다는 뉴스로만 보기 어렵습니다. 핵심은 더 차갑습니다. 이제 최상위 AI 모델은 클라우드 서비스이면서 동시에 전략자산입니다.

    반도체 장비나 첨단 GPU처럼, 모델 접근권 자체가 외교와 안보의 대상이 되고 있습니다. 한국도 이 변화를 남의 나라 규제 뉴스로만 넘기기 어렵습니다.

    미토스 이슈의 핵심은 무엇인가

    서울의 전략 상황실에서 AI 모델 접근권과 보안 리스크를 검토하는 장면
    미토스 이슈는 AI 성능 경쟁을 넘어 접근권과 통제권이 국가 전략의 문제가 됐다는 신호다.

    Read in English: Anthropic Mythos Shock: As AI Becomes a Strategic Asset, What Should Korea Prepare?

    앤트로픽은 Claude Mythos 5를 사이버보안과 생물학 연구에 강한 모델로 소개했습니다. Project Glasswing을 통해 핵심 소프트웨어의 취약점을 찾고 방어하는 데 활용하겠다는 구상이었습니다.

    공식 설명에 따르면 초기 파트너들은 Mythos Preview를 활용해 중요 소프트웨어에서 1만 건이 넘는 고위험 또는 치명적 취약점을 찾았습니다. 방어 목적이라면 매우 매력적인 결과입니다.

    문제는 같은 능력이 공격에도 쓰일 수 있다는 점입니다. 취약점을 빨리 찾는 모델은 방어팀의 무기이기도 하지만, 통제가 무너지면 공격자의 무기가 될 수도 있습니다.

    그래서 미토스는 처음부터 제한된 파트너에게만 제공됐습니다. 그리고 미국 정부가 Fable 5와 Mythos 5에 대한 외국인 접근 중단 지침을 내리면서, 이 이슈는 기술 뉴스에서 국가 전략 뉴스로 바뀌었습니다.

    왜 ‘AI도 전략자산’이라는 말이 나왔나

    미국 정부의 지침은 최첨단 AI 모델 접근권이 국가안보 판단의 대상이 될 수 있음을 보여줬습니다. 반도체 수출통제와 비슷한 흐름이 모델 자체로 이동한 셈입니다.

    여기서 중요한 변화가 하나 있습니다. 과거에는 연산자원, 칩, 장비가 병목이었습니다. 앞으로는 모델 가중치, API 접근권, 안전장치 해제 여부, 데이터 보존 조건까지 통제 대상이 될 수 있습니다.

    기업 입장에서는 더 복잡합니다. 어제까지 쓸 수 있던 모델이 오늘 갑자기 막힐 수 있습니다. 공공기관, 금융, 의료, 국방, 연구개발처럼 고위험 영역에서는 이 문제가 단순한 불편을 넘어 운영 리스크가 됩니다.

    한국이 봐야 할 세 가지 위험

    해외 모델 의존 보안 모델 양면성 소버린 AI 현실성을 세 갈래로 검토하는 전략 회의
    한국의 AI 전략은 해외 모델 의존, 보안 AI의 양면성, 소버린 AI의 현실성을 함께 봐야 한다.

    1. 해외 모델 의존 리스크

    한국 기업과 공공기관은 글로벌 AI 모델을 빠르게 도입해 왔습니다. 생산성 측면에서는 자연스러운 선택입니다. 하지만 핵심 업무가 특정 해외 모델에 깊게 묶이면, 공급 중단이나 접근 제한이 곧 업무 중단으로 이어질 수 있습니다.

    특히 행정, 국방, 보안, 의료, 에너지, 금융처럼 국가 기능과 연결된 영역은 별도 기준이 필요합니다. 모든 AI를 국산으로만 쓰자는 뜻은 아닙니다. 다만 끊기면 안 되는 영역은 대체 경로를 갖춰야 합니다.

    2. 보안 모델의 양면성

    사이버 보안 관제실에서 AI 취약점 분석 결과와 패치 우선순위를 검토하는 모습
    강력한 보안 AI는 방어 역량을 높이지만, 통제가 없으면 공격 역량으로도 전용될 수 있다.

    미토스가 보여준 가장 어려운 질문은 이것입니다. “강력한 보안 AI를 넓게 풀수록 세상은 더 안전해질까, 더 위험해질까?”

    취약점 탐지 AI는 방어팀에 큰 힘이 됩니다. 그러나 검증, 공개, 패치 속도가 따라오지 못하면 취약점 목록만 빠르게 쌓일 수 있습니다. 앤트로픽도 취약점 발견 이후에는 검증과 공개, 패치가 병목이 된다고 설명했습니다.

    한국도 AI 보안 역량을 키울 때 탐지 모델만 보면 안 됩니다. 취약점 조정 공개, 패치 책임, 공급망 대응, 사고 대응 훈련이 함께 설계돼야 합니다.

    3. 소버린 AI의 현실성 문제

    소버린 AI는 멋진 구호로 끝나면 안 됩니다. 한국어 모델 하나를 만드는 문제도 아닙니다. 공공 데이터 거버넌스, 국내 컴퓨팅 인프라, 고위험 AI 평가, 산업별 표준, 조달 제도까지 묶여야 합니다.

    한국은 AI 기본법 시행, 국가 AI위원회, AI 안전연구소, 국가 AI컴퓨팅센터 같은 제도와 인프라를 준비하고 있습니다. 방향은 맞습니다. 다만 미토스 이슈는 속도를 더 요구합니다.

    한국의 미래 전략: ‘모델 확보’보다 ‘통제 가능한 AI 체계’가 먼저다

    컴퓨팅 데이터 모델 안전평가 조달 체계를 연결해 통제 가능한 AI 인프라를 설계하는 장면
    핵심은 특정 모델 보유가 아니라 필요할 때 멈추고 바꾸고 검증할 수 있는 AI 운영 체계다.

    한국의 대응은 단순히 “우리도 초거대 모델을 만들자”에서 끝나면 부족합니다. 더 중요한 질문은 “어떤 영역에서, 어떤 수준의 통제권을, 어떤 비용으로 확보할 것인가”입니다.

    첫째, 국가 핵심 영역의 AI 의존도를 분류해야 한다

    공공기관과 기간산업은 사용 중인 AI 서비스를 업무 중요도별로 나눠야 합니다. 단순 문서 작성 도구와 사이버보안·의료·행정 의사결정 보조 도구를 같은 기준으로 볼 수 없습니다.

    핵심 영역에는 최소한 세 가지 조건이 필요합니다. 대체 가능한 모델, 국내 또는 신뢰권역 내 추론 경로, 장애 시 수동 운영 절차입니다.

    둘째, 한국형 AI 안전평가 체계를 실전형으로 바꿔야 한다

    AI 안전평가는 문서 심사로 끝나면 안 됩니다. 사이버보안, 생물학, 금융사기, 허위정보, 개인정보 유출처럼 실제 피해가 큰 영역에서는 레드팀 평가와 반복 테스트가 필요합니다.

    특히 고성능 모델의 경우 “사용 금지”와 “무제한 개방” 사이에 여러 단계가 있어야 합니다. 제한된 파트너 접근, 사용 로그 보존, 고위험 질의 라우팅, 독립 평가, 사고 보고 체계가 함께 움직여야 합니다.

    셋째, 국가 AI컴퓨팅센터는 연구 인프라를 넘어 전략 인프라가 돼야 한다

    정부는 최대 2조 원 규모의 국가 AI컴퓨팅센터 구축을 추진하고 있습니다. 이 인프라는 단순히 GPU를 빌려주는 시설이 아니라, 한국형 모델과 안전평가, 공공 AI 실증을 연결하는 기반이 되어야 합니다.

    중요한 것은 접근성입니다. 대기업만 쓰는 인프라가 되면 산업 전체의 회복력은 커지지 않습니다. 대학, 스타트업, 보안 연구기관, 공공기관이 실제로 쓸 수 있는 구조가 필요합니다.

    넷째, 국제 협력은 하되 ‘차단 시나리오’를 전제로 해야 한다

    한국이 모든 AI 기술을 혼자 만들 수는 없습니다. 미국, 유럽, 일본, 싱가포르 등과의 협력은 계속 필요합니다. 다만 협력은 의존과 다릅니다.

    계약서에는 데이터 위치, 모델 접근 중단, 긴급 패치, 대체 모델 전환, 감사권 조항이 들어가야 합니다. 공공 조달에서도 “성능이 가장 좋은 모델”만 볼 것이 아니라 “위기 때 운영 가능한 모델”을 봐야 합니다.

    기업과 개인은 무엇을 확인해야 하나

    기업은 지금 쓰는 AI 도구를 목록화해야 합니다. 어떤 업무가 어떤 모델에 연결되어 있는지, 데이터가 어디에 저장되는지, 서비스가 중단되면 며칠 안에 대체 가능한지 확인해야 합니다.

    개인은 더 단순하게 볼 수 있습니다. AI를 잘 쓰는 능력은 중요합니다. 하지만 특정 모델의 답을 그대로 믿는 습관은 위험합니다. AI 시대에는 프롬프트보다 먼저 자기 언어와 판단 기준을 갖추는 일이 중요합니다.

    관련해서는 Thinknote의 AI 시대, 프롬프트보다 먼저 배워야 할 것은 ‘나의 언어’다와 AI 시대의 메타인지: 똑똑한 답보다 중요한 ‘내 생각 점검법’도 함께 읽어볼 만합니다.

    AI 에이전트 흐름이 궁금하다면 AI Agent Evolution: What OpenClaw Shows About the Next Step Beyond Chatbots와 AI-Native Workflows도 연결해서 볼 수 있습니다.

    결론: 한국의 AI 전략은 ‘접근권의 정치’를 준비해야 한다

    미토스 이슈가 남긴 메시지는 분명합니다. 앞으로 AI 경쟁은 성능 경쟁만이 아닙니다. 누가 모델에 접근할 수 있는가, 누가 안전장치를 조정할 수 있는가, 누가 장애 상황에서도 서비스를 유지할 수 있는가의 경쟁입니다.

    한국은 글로벌 모델을 쓰되, 핵심 영역에서는 통제 가능한 대안을 가져야 합니다. 소버린 AI는 고립이 아니라 보험입니다. 그리고 그 보험은 모델, 데이터, 컴퓨팅, 안전평가, 조달 제도가 함께 움직일 때만 작동합니다.

    FAQ

    앤트로픽 미토스는 일반인이 쓸 수 있는 AI인가요?

    아닙니다. 앤트로픽은 Mythos 5를 사이버보안과 생물학 연구에 강한 제한 접근 모델로 설명했습니다. 일반 지식 업무용으로는 별도 안전장치를 둔 Fable 5를 공개하려 했지만, 이 모델 역시 미국 정부 지침 이후 접근이 중단됐습니다.

    미토스 이슈가 한국 기업에 바로 영향을 주나요?

    모든 기업에 즉시 영향을 주는 것은 아닙니다. 다만 핵심 업무를 해외 최상위 AI 모델에 의존하는 기업에는 경고 신호입니다. 접근권, 데이터 위치, 대체 모델, 장애 대응 계획을 점검해야 합니다.

    소버린 AI는 해외 AI를 쓰지 말자는 뜻인가요?

    그렇지 않습니다. 소버린 AI의 핵심은 필요한 영역에서 통제권과 선택권을 확보하는 것입니다. 글로벌 AI를 활용하되, 공공·안보·산업 핵심 영역에서는 대체 가능성과 국내 운영 역량을 갖춰야 합니다.

    한국 정부는 이미 무엇을 준비하고 있나요?

    AI 기본법 시행, 국가 AI위원회, AI 안전연구소, 국가 AI컴퓨팅센터 등이 준비되고 있습니다. 특히 국가 AI컴퓨팅센터는 국내 AI 연구와 산업 활용을 위한 핵심 인프라로 추진되고 있습니다.

    개인은 무엇을 준비하면 좋을까요?

    특정 모델 하나에만 의존하지 않는 습관이 중요합니다. 중요한 판단은 여러 출처로 확인하고, AI가 제시한 답을 자기 언어로 다시 설명해보는 훈련이 필요합니다.

    참고자료

  • 서울런 생성형 AI 서비스 지원, 고등학생 이상 1,000명 무료 이용 기회

    서울런 생성형 AI 서비스 지원, 고등학생 이상 1,000명 무료 이용 기회

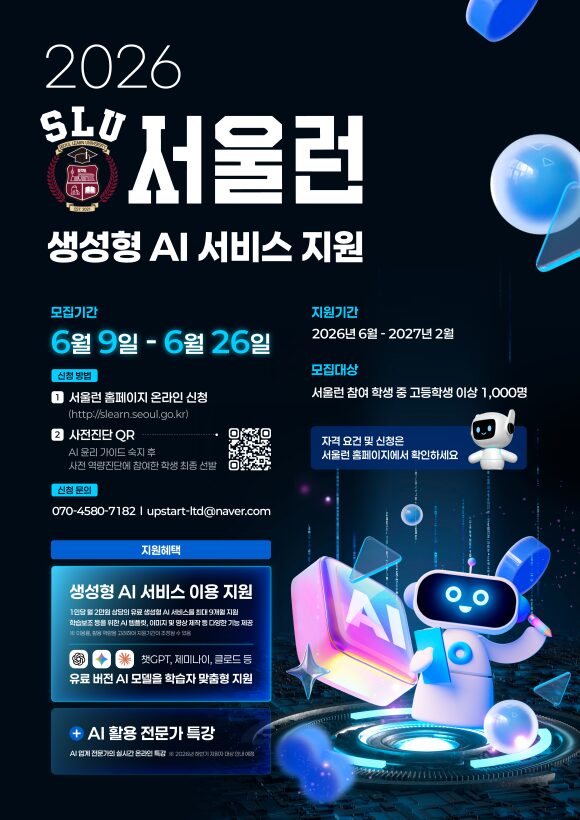
    서울시가 서울런 회원을 대상으로 생성형 AI 서비스 지원을 시작합니다. 핵심은 간단합니다. 고등학생 이상 서울런 참여 학생 가운데 선착순 1,000명을 모집해, 유료 생성형 AI 서비스를 별도 가입이나 구독료 부담 없이 이용할 수 있도록 지원하는 방식입니다.

    서울런 생성형 AI 서비스 지원 공식 홍보 이미지
    서울런 생성형 AI 서비스 지원 공식 홍보 이미지입니다. 출처: 서울시·서울런 안내자료, 더팩트 기사 게재 이미지 확인.

    Read in English: Seoul Learn Generative AI Service Support: Free Access for 1,000 High School and Older Students

    요즘 학습에서 AI는 단순한 검색 도구를 넘어섰습니다. 글을 요약하고, 문제 풀이 방향을 잡고, 영어 문장을 다듬고, 진로 탐색 질문까지 도와주는 보조 학습 도구가 됐습니다. 다만 유료 AI 서비스는 학생에게 비용 부담이 될 수 있습니다. 이번 서울런 AI 지원은 그 장벽을 낮추는 데 초점이 있습니다.

    서울런 생성형 AI 서비스 지원이란?

    서울런 생성형 AI 서비스 지원은 서울런에 참여하는 학생들이 최신 인공지능 서비스를 학습에 활용할 수 있도록 돕는 프로그램입니다. 이미지 안내에 따르면 지원 대상자는 챗GPT, 클로드, 제미나이, 퍼플렉시티 등을 포함한 총 9종의 유료 생성형 AI를 무료로 이용할 수 있습니다.

    단순히 AI 계정을 나눠주는 성격이라기보다, 학습 격차를 줄이고 AI 활용 경험을 넓히려는 교육 지원 사업에 가깝습니다. 특히 고등학생 이상이라면 과제, 입시 준비, 자기소개서 초안, 진로 탐색, 외국어 학습 등에서 AI를 활용할 일이 많습니다.

    모집기간과 지원기간

    이미지에 표시된 주요 일정은 다음과 같습니다.

    구분 내용
    모집기간 6월 9일 ~ 6월 26일
    지원기간 2026년 6월 ~ 2027년 2월
    모집인원 선착순 1,000명
    모집대상 서울런 참여 학생 중 고등학생 이상
    신청방법 서울런 홈페이지 온라인 신청 또는 사전진단 QR 참여

    지원기간이 2027년 2월까지로 안내되어 있어, 선정되면 한 학기 단기 체험이 아니라 비교적 긴 기간 동안 AI 서비스를 학습에 활용할 수 있습니다.

    누가 신청할 수 있나?

    모집대상은 서울런 참여 학생 중 고등학생 이상 1,000명입니다. 여기서 중요한 점은 ‘서울런 회원’이라는 전제입니다. 누구나 바로 신청하는 일반 공개 이벤트라기보다는, 서울런 참여 학생을 대상으로 한 교육 지원 프로그램으로 이해하는 것이 좋습니다.

    다만 이미지에도 “자격 요건 및 신청은 서울런 홈페이지에서 확인하세요”라고 안내되어 있습니다. 따라서 실제 신청 전에는 서울런 홈페이지에서 본인의 참여 자격, 학년 기준, 선발 방식, 사전진단 참여 조건을 반드시 확인해야 합니다.

    어떤 AI를 무료로 이용할 수 있나?

    안내 문구에는 챗GPT, 클로드, 제미나이, 퍼플렉시티 등 총 9종의 유료 생성형 AI가 언급되어 있습니다. 각각의 도구는 쓰임새가 조금씩 다릅니다.

    • 챗GPT: 글쓰기, 요약, 문제 풀이 방향 정리, 아이디어 확장에 활용하기 좋습니다.
    • 클로드: 긴 글 읽기, 자료 요약, 문장 다듬기 등에 강점이 있습니다.
    • 제미나이: 구글 생태계와 연결된 정보 탐색, 문서 작업 보조에 활용할 수 있습니다.
    • 퍼플렉시티: 검색형 AI로 자료 조사와 출처 확인에 유용합니다.

    학생 입장에서는 “어떤 AI가 제일 좋은가”보다 “과제와 학습 상황에 맞게 어떤 AI를 써야 하는가”를 익히는 것이 더 중요합니다. 예를 들어 개념을 처음 이해할 때는 설명형 AI를 쓰고, 자료 조사를 할 때는 검색형 AI를 쓰는 식입니다.

    신청방법은?

    이미지 기준 신청방법은 두 가지로 안내되어 있습니다.

    1. 서울런 홈페이지 온라인 신청

    서울런 홈페이지에서 신청할 수 있습니다. 이미지에는 http://slearn.seoul.go.kr 주소가 표시되어 있습니다.

    1. 사전진단 QR 참여

    AI 올리 가이드 숙지 후 사전 역량진단에 참여한 학생을 최종 선발한다고 안내되어 있습니다.

    즉, 단순히 신청 버튼만 누르는 방식이 아닐 수 있습니다. AI 활용 가이드 확인과 사전진단 참여가 선발 과정에 포함될 가능성이 있으므로, 신청 페이지의 절차를 끝까지 확인해야 합니다.

    학생들은 어떻게 활용하면 좋을까?

    이번 지원을 받게 된다면, AI를 ‘정답 생성기’처럼 쓰기보다 학습 코치처럼 활용하는 것이 좋습니다.

    예를 들어 수학 문제를 풀 때 바로 답을 물어보기보다 “이 문제에서 먼저 확인해야 할 개념이 무엇인지 설명해 줘”라고 질문할 수 있습니다. 영어 작문을 할 때도 “이 문장을 더 자연스럽게 고쳐주고, 왜 그렇게 고쳤는지 설명해 줘”라고 요청하면 학습 효과가 커집니다.

    추천 활용 방식은 다음과 같습니다.

    • 모르는 개념을 중학생도 이해할 수 있는 수준으로 다시 설명받기
    • 긴 지문이나 교과 내용을 핵심 문장으로 요약하기
    • 영어 문장 첨삭 후 수정 이유 확인하기
    • 진로·전공 관련 질문 목록 만들기
    • 수행평가 발표 자료의 구조 잡기
    • 자료 조사 시 출처와 근거를 함께 확인하기

    AI가 만들어준 답을 그대로 제출하는 방식은 위험합니다. 오류가 있을 수 있고, 학교 과제 기준에 맞지 않을 수도 있습니다. AI의 답변은 초안과 참고자료로 활용하고, 최종 판단과 표현은 학생 스스로 정리해야 합니다.

    신청 전 확인할 체크리스트

    신청 전에는 아래 내용을 확인해 보세요.

    • 내가 서울런 참여 학생에 해당하는가?
    • 고등학생 이상 기준에 포함되는가?
    • 모집기간인 6월 9일~6월 26일 안에 신청하는가?
    • 사전진단 QR 또는 AI 활용 가이드 절차가 필요한가?
    • 선정 후 어떤 AI 서비스를 언제까지 이용할 수 있는가?
    • 학교 과제나 시험 준비에 AI를 사용할 때 지켜야 할 기준을 알고 있는가?

    특히 선착순 1,000명 모집으로 안내되어 있으므로, 관심이 있다면 신청기간 안에 빠르게 확인하는 것이 좋습니다.

    마무리

    서울런 생성형 AI 서비스 지원은 학생들이 비용 부담 없이 최신 AI 도구를 경험할 수 있는 기회입니다. 중요한 것은 무료 이용 자체보다, AI를 학습에 제대로 연결하는 경험입니다.

    AI는 대신 공부해 주는 도구가 아닙니다. 하지만 질문을 잘 던지면 개념 이해, 글쓰기, 자료 조사, 진로 탐색을 도와주는 든든한 조력자가 될 수 있습니다. 서울런 참여 학생 중 고등학생 이상이라면 모집기간과 신청 조건을 확인해 볼 만합니다.

    FAQ

    서울런 생성형 AI 서비스 지원은 누구를 대상으로 하나요?

    이미지 안내 기준으로 서울런 참여 학생 중 고등학생 이상이 대상이며, 모집인원은 1,000명입니다.

    모집기간은 언제인가요?

    모집기간은 6월 9일부터 6월 26일까지로 안내되어 있습니다.

    어떤 AI 서비스를 무료로 이용할 수 있나요?

    챗GPT, 클로드, 제미나이, 퍼플렉시티 등을 포함한 총 9종의 유료 생성형 AI를 무료로 이용할 수 있다고 안내되어 있습니다.

    신청은 어디에서 하나요?

    서울런 홈페이지 온라인 신청 또는 이미지에 포함된 사전진단 QR을 통해 신청 절차를 진행하는 방식으로 안내되어 있습니다.

    신청만 하면 바로 선정되나요?

    이미지에는 AI 올리 가이드 숙지 후 사전 역량진단에 참여한 학생을 최종 선발한다고 되어 있습니다. 최종 조건은 서울런 홈페이지에서 확인해야 합니다.

    참고자료

    이미지 원본 확인: 더팩트, 서울런 회원 1000명에 챗GPT·클로드 무료 지원

    함께 읽으면 좋은 글

  • AI 에이전트 자동화, 클릭 한 번의 환상보다 중요한 것

    AI 에이전트 자동화, 클릭 한 번의 환상보다 중요한 것

    AI 자동화 이야기는 요즘 너무 쉽게 부풀려진다. “AI 에이전트 50개로 회사를 돌린다”, “하루 한 시간만 일한다”, “댓글을 남기면 돈 버는 자동화 레시피를 준다” 같은 문장이 피드에 계속 뜬다.

    EO Korea가 공개한 Gumloop 창업자 Max Brodeur-Urbas 인터뷰는 그 흐름에 정면으로 브레이크를 건다. 영상의 주인공은 AI 자동화 플랫폼 회사를 만들고, 대규모 투자를 유치한 창업자다. 그런데 그가 반복해서 말하는 핵심은 의외로 차갑다. AI는 이해를 건너뛰는 지름길이 아니라, 이미 이해한 일을 더 빠르게 실행하게 만드는 도구라는 것이다.

    Gumloop 창업자 Max Brodeur-Urbas가 AI 자동화 과장론을 비판하는 인터뷰 장면

    EO Korea 영상 캡처. 이 글은 영상 내용을 그대로 요약하기보다, Gumloop 사례와 외부 자료를 함께 읽어 AI 에이전트 자동화의 현실 조건을 분석한다.

    AI 에이전트 자동화의 문제는 ‘에이전트 수’가 아니다

    AI 에이전트 자동화를 실행하기 전에 업무 흐름과 승인 지점을 설계하는 모습
    AI 에이전트 자동화는 에이전트 수보다 업무 흐름과 판단 기준을 먼저 정리할 때 성과가 난다.

    영상 초반 Max는 “AI 에이전트가 회사를 다 운영한다”는 식의 주장을 거의 마케팅으로 본다. 그가 비판하는 지점은 AI 자체가 아니다. 문제는 자동화가 마치 이해와 시행착오를 생략해 주는 것처럼 팔리는 방식이다.

    Gumloop의 공식 사이트 문구도 이 관점과 맞닿아 있다. “업무를 이해하는 것이 자동화의 유일한 전제여야 한다”는 메시지를 전면에 내세운다. 즉, 핵심은 개발자가 아닌 사람도 자동화할 수 있게 만드는 것이다. 하지만 그 사람은 최소한 자신이 자동화하려는 업무를 알아야 한다.

    이 차이가 중요하다. AI 에이전트 자동화는 “무엇이든 대신 해주는 비서”에 가깝지 않다. 오히려 여러 도구, 데이터, 승인 절차, 반복 작업을 하나의 흐름으로 묶는 실행 인프라에 가깝다.

    Gumloop 사례가 보여주는 새로운 자동화 시장

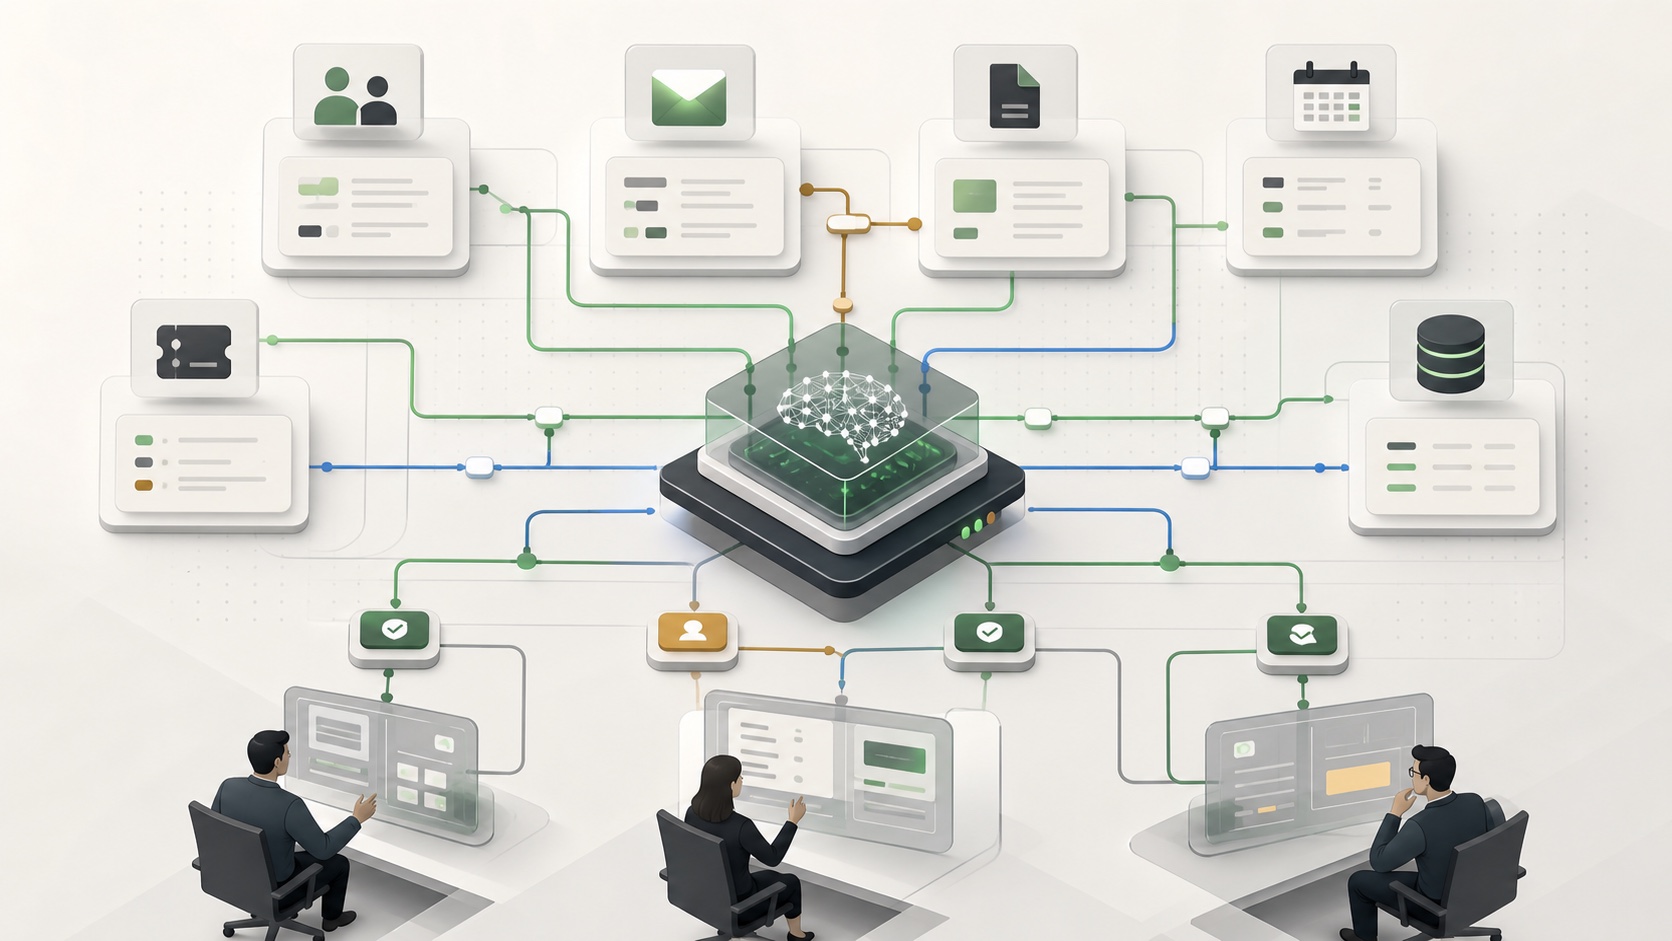
    CRM 이메일 문서 캘린더 데이터베이스가 AI 자동화 흐름으로 연결된 개념도
    기업 AI 자동화 시장의 핵심은 모델 하나가 아니라 여러 데이터와 도구를 운영 가능한 흐름으로 묶는 데 있다.

    YC 회사 페이지는 Gumloop을 “AI로 반복적이고 복잡한 워크플로를 끝까지 자동화하는 플랫폼”으로 설명한다. 사용자는 모듈을 드래그 앤 드롭 방식으로 연결해 자동화를 만든다. 코드 작성보다 빠르게 테스트하고 운영할 수 있게 만드는 것이 목표다.

    EO 기사와 TechCrunch, BetaKit 보도도 비슷한 흐름을 보여준다. Gumloop은 2026년 3월 Benchmark가 주도한 5,000만 달러 규모의 Series B 투자를 유치했고, 누적 조달액은 약 7,000만 달러 수준으로 소개된다. 이 숫자보다 더 중요한 것은 투자자들이 본 시장의 방향이다. 기업 안의 직원이 직접 AI 에이전트를 만들고, 반복 업무를 운영 가능한 형태로 묶는 시장이다.

    Max Brodeur-Urbas가 창업 배경과 제품 방향을 설명하는 인터뷰 장면

    Gumloop이 흥미로운 이유는 “모델 성능 경쟁”만을 이야기하지 않기 때문이다. 공식 사이트는 데이터 분석, 지원 티켓 분류, CRM 관리, 회의 준비, 통화 분석 같은 구체적인 업무 에이전트를 전면에 배치한다. 추상적인 AGI보다 실제 부서의 반복 업무가 앞에 나온다.

    클릭 한 번 자동화가 실패하는 4가지 이유

    AI 에이전트 자동화가 실패하는 이유는 대개 기술 부족 하나로 끝나지 않는다. 영상과 외부 자료를 종합하면 네 가지 조건이 보인다.

    1. 업무를 모르면 자동화할 기준도 없다

    AI가 결과를 내더라도 그 결과가 맞는지 판단할 사람이 필요하다. 영업 리드 분류, 고객 문의 triage, 보고서 작성, 회의 준비는 모두 조직마다 기준이 다르다. 업무 맥락을 모르면 자동화는 빠른 실행이 아니라 빠른 오류가 된다.

    2. 데이터 연결 없이는 에이전트가 빈손이다

    기업 자동화는 챗봇 하나로 끝나지 않는다. CRM, 문서, 이메일, 데이터베이스, 티켓 시스템, 캘린더가 연결되어야 한다. 그래서 Gumloop 같은 플랫폼은 모델보다 연결과 실행 흐름을 강조한다.

    3. 반복 실행에는 통제와 관찰이 필요하다

    AI 자동화 워크플로의 실행 상태와 승인 지점을 대시보드로 점검하는 회의 장면
    매일 돌아가는 자동화에는 로그, 승인, 실패 알림처럼 사람이 관찰하고 멈출 수 있는 장치가 필요하다.

    한 번 성공한 프롬프트와 매일 돌아가는 업무 자동화는 다르다. 반복 작업에는 실패 알림, 승인 단계, 로그, 권한 관리가 필요하다. AI 에이전트가 많아질수록 “누가 무엇을 했는지”를 볼 수 있어야 한다.

    4. 자동화는 학습을 대신하지 않는다

    Max는 AI를 학습 도구로 쓰는 것과 이해를 건너뛰는 것을 구분한다. AI가 설명하고 도와줄 수는 있다. 하지만 사용자가 왜 그런 결과가 나왔는지 전혀 모른다면, 자동화는 실력의 확장이 아니라 의존의 확대가 된다.

    비개발자 자동화의 진짜 의미

    Gumloop이 말하는 비개발자 자동화는 “아무나 아무렇게나 만든다”가 아니다. 더 정확히 말하면 업무 담당자가 엔지니어에게 모든 요구사항을 번역해 넘기지 않아도 된다는 뜻이다.

    마케터는 캠페인 리드 흐름을 안다. 영업 담당자는 CRM 업데이트의 귀찮은 지점을 안다. HR 담당자는 반복되는 후보자 커뮤니케이션을 안다. 운영 담당자는 예외 처리가 어디서 터지는지 안다. 이들이 자동화의 설계자가 될 수 있다면, 기업의 AI 도입 속도는 확실히 빨라진다.

    다만 여기에도 조건이 있다. 조직은 자동화 권한을 어디까지 줄지 정해야 한다. 어떤 데이터에 접근할 수 있는지, 어떤 작업은 승인 후 실행해야 하는지, 실패했을 때 누가 책임지는지도 정해야 한다. AI 에이전트 도입은 도구 구매가 아니라 운영 방식의 재설계다.

    AI 업무 자동화를 시작할 때 확인할 체크리스트

    반복 업무 성공 기준 데이터 연결 안전 장치 피드백 루프를 점검하는 AI 자동화 체크리스트 이미지
    작은 자동화라도 반복 업무, 성공 기준, 데이터 연결, 안전 장치, 피드백 루프를 먼저 확인해야 한다.

    AI 에이전트 자동화를 도입하려는 개인이나 조직이라면, 먼저 다음 질문을 던지는 편이 낫다.

    1. 반복되는 업무가 실제로 존재하는가?
    2. 그 업무의 성공 기준을 담당자가 말로 설명할 수 있는가?
    3. 필요한 데이터와 도구가 연결 가능한가?
    4. 실패했을 때 멈추거나 검토할 장치가 있는가?
    5. 자동화 결과를 개선할 피드백 루프가 있는가?

    이 다섯 가지가 없다면 에이전트를 늘리는 일은 큰 의미가 없다. 반대로 이 조건이 있다면 작은 자동화 하나도 조직의 일하는 방식을 바꿀 수 있다.

    Max Brodeur-Urbas가 실행과 사람의 중요성을 설명하는 인터뷰 후반 장면

    Thinknote의 AI 에이전트 글과 함께 읽기

    이 글의 관점은 Thinknote의 기존 AI 에이전트 글과도 이어진다.

    결론: AI 에이전트는 ‘대체’보다 ‘운영’의 문제다

    Gumloop 창업자 인터뷰가 던지는 메시지는 단순하다. AI가 모든 일을 알아서 해준다는 약속은 매력적이지만 위험하다. 실제 가치는 자신이 잘 아는 업무를 더 빠르고 안정적으로 실행할 때 나온다.

    그래서 AI 에이전트 자동화의 질문은 “몇 개의 에이전트를 쓰느냐”가 아니다. 더 좋은 질문은 이것이다.

    내가 자동화하려는 업무를 충분히 이해하고 있는가. 그리고 그 자동화가 매일 돌아가도 괜찮을 만큼 검증·권한·피드백 구조를 갖추고 있는가.

    이 질문에 답할 수 있을 때, AI 에이전트는 유행어가 아니라 일하는 방식의 인프라가 된다.

    FAQ

    AI 에이전트 자동화는 무엇인가요?

    AI 에이전트 자동화는 AI 모델을 이용해 반복 업무, 데이터 처리, 도구 간 작업, 알림, 보고, 분류 등을 하나의 실행 흐름으로 묶는 방식입니다. 단순한 챗봇보다 업무 시스템과 연결되는 실행성이 중요합니다.

    Gumloop은 어떤 회사인가요?

    Gumloop은 비개발자도 모듈을 연결해 AI 기반 업무 자동화를 만들 수 있게 하는 플랫폼입니다. YC 회사 페이지와 공식 사이트는 반복적이고 복잡한 워크플로를 AI로 자동화하는 데 초점을 둔다고 설명합니다.

    AI 에이전트가 있으면 업무 이해가 필요 없나요?

    아닙니다. 영상에서 Max Brodeur-Urbas가 강조하듯 AI는 이해를 대체하기보다 이미 이해한 일을 더 빠르게 실행하도록 돕는 도구에 가깝습니다. 결과를 평가하고 개선할 기준은 여전히 사람이 가져야 합니다.

    기업이 AI 자동화를 도입할 때 가장 먼저 볼 것은 무엇인가요?

    반복 업무의 존재, 성공 기준, 데이터 연결 가능성, 권한 관리, 실패 시 검토 체계가 먼저입니다. 도구 선택은 그다음입니다.

    AI 자동화 플랫폼과 일반 챗봇의 차이는 무엇인가요?

    일반 챗봇은 대화와 답변에 초점이 있습니다. AI 자동화 플랫폼은 데이터 소스, 업무 도구, 반복 실행, 승인 단계, 결과 기록까지 포함한 워크플로 운영에 초점을 둡니다.

    참고자료

  • AI 시대, 프롬프트보다 먼저 배워야 할 것은 ‘나의 언어’다

    AI 시대, 프롬프트보다 먼저 배워야 할 것은 ‘나의 언어’다

    AI를 잘 쓰는 사람과 그렇지 못한 사람의 차이는 어디서 생길까. 흔히 “좋은 프롬프트를 아느냐”라고 답하지만, 실제로는 조금 다르다. 핵심은 프롬프트 문장 몇 개가 아니라, 내가 원하는 것을 맥락과 기준까지 포함해 말할 수 있는가에 있다.

    일당백 영상 「언어로 섬세하게 표현되는 인간의 지능! AI 프롬프트 엔지니어링의 시작」은 이 지점을 잘 보여준다. 영상의 출발점은 책 《지적 대화를 위한 AI 언어 수업》이지만, 단순한 책 소개라기보다 AI 시대의 언어 감각을 묻는 대화에 가깝다. 특히 한국어 사용자에게는 더 중요한 질문이 있다. 한국어처럼 생략과 뉘앙스가 많은 언어로 AI와 대화할 때, 우리는 무엇을 더 분명하게 말해야 할까.

    AI 활용 격차는 ‘도구 사용법’보다 ‘언어의 해상도’에서 생긴다

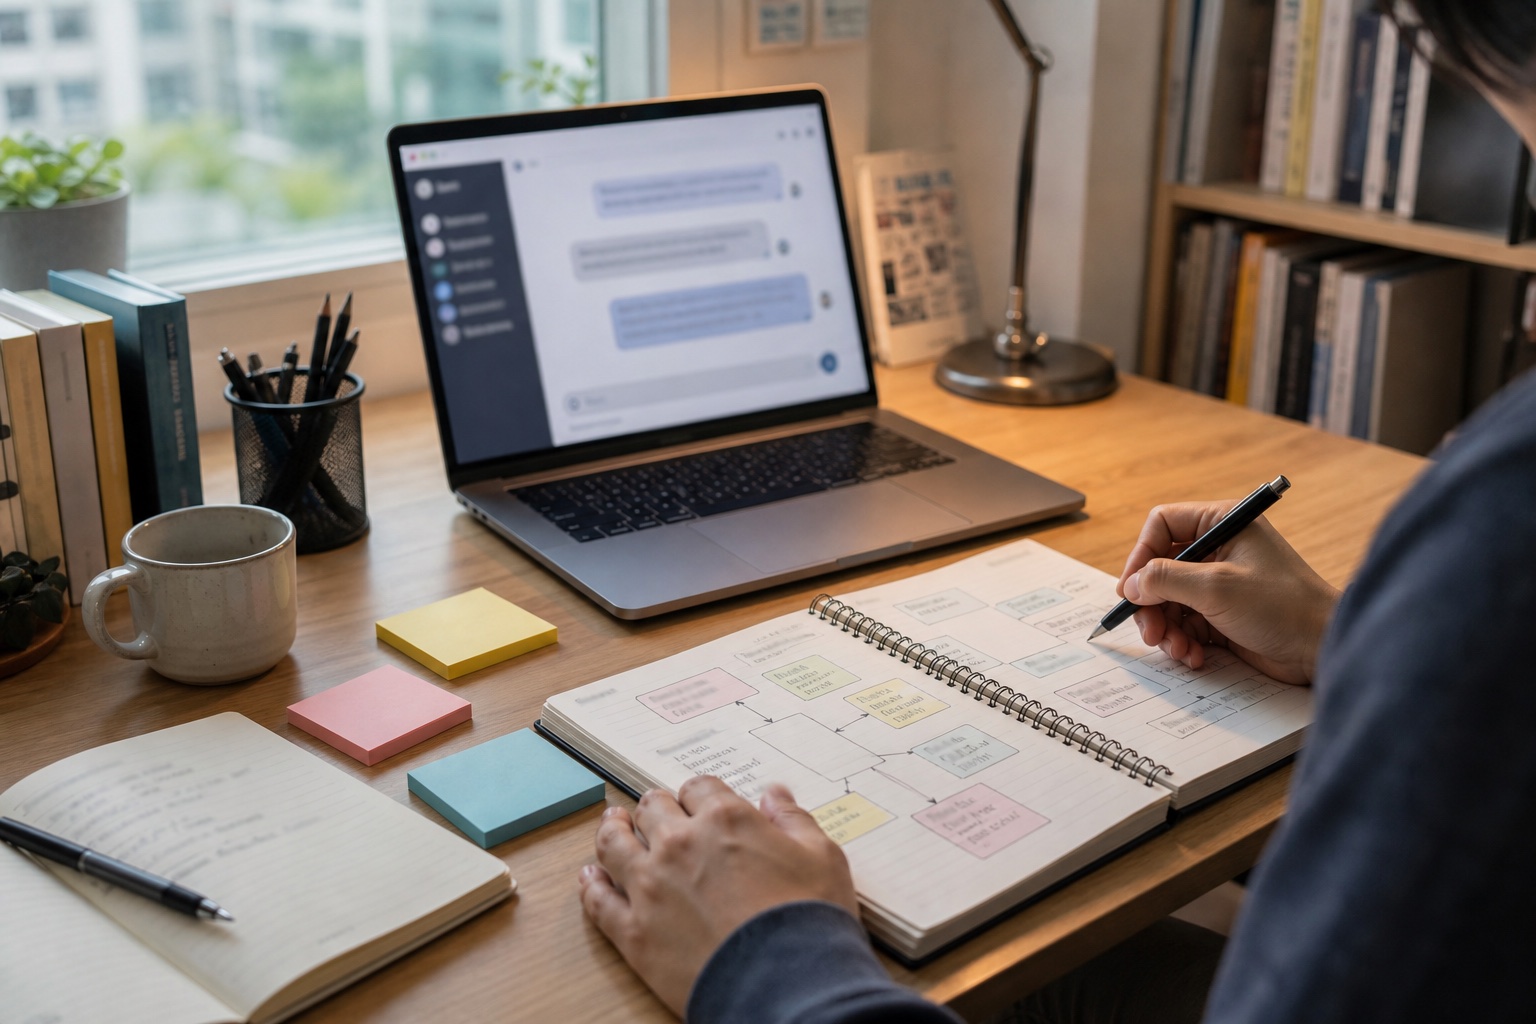
    AI 채팅 화면 옆에서 노트에 생각을 구조화하며 프롬프트를 준비하는 장면
    좋은 프롬프트는 문장 기술보다 먼저 생각과 기준을 정리하는 데서 시작된다.

    Read in English: In the AI Era, What You Need to Learn Before Prompts Is Your Own Language

    많은 사람이 AI를 처음 쓸 때 이렇게 말한다.

    “이거 알아서 정리해 줘.” “너무 길게 쓰지 마.” “딱딱한 말투 쓰지 마.” “그림 그리지 말고 프롬프트만 보여 줘.”

    사람끼리는 이 정도 말로도 어느 정도 통한다. 앞뒤 상황, 표정, 이전 대화, 조직 문화, 말투까지 함께 읽기 때문이다. 그런데 AI는 사용자가 제공하지 않은 맥락을 추측한다. 추측이 맞으면 편리하지만, 틀리면 결과는 엉뚱해진다.

    OpenAI와 Anthropic의 프롬프트 가이드도 공통적으로 “명확한 지시, 충분한 맥락, 원하는 출력 형식”을 강조한다. 결국 좋은 프롬프트란 마법 문장이 아니라 AI가 추측해야 할 부분을 줄이는 문장이다.

    여기서 중요한 차이가 생긴다. AI를 잘 쓰는 사람은 질문을 길게 쓰는 사람이 아니다. 맥락을 구조화하는 사람이다. 목적, 독자, 제약, 예시, 금지보다 선호, 출력 형식, 검증 기준을 함께 준다.

    한국어는 왜 AI에게 더 까다로운 언어인가

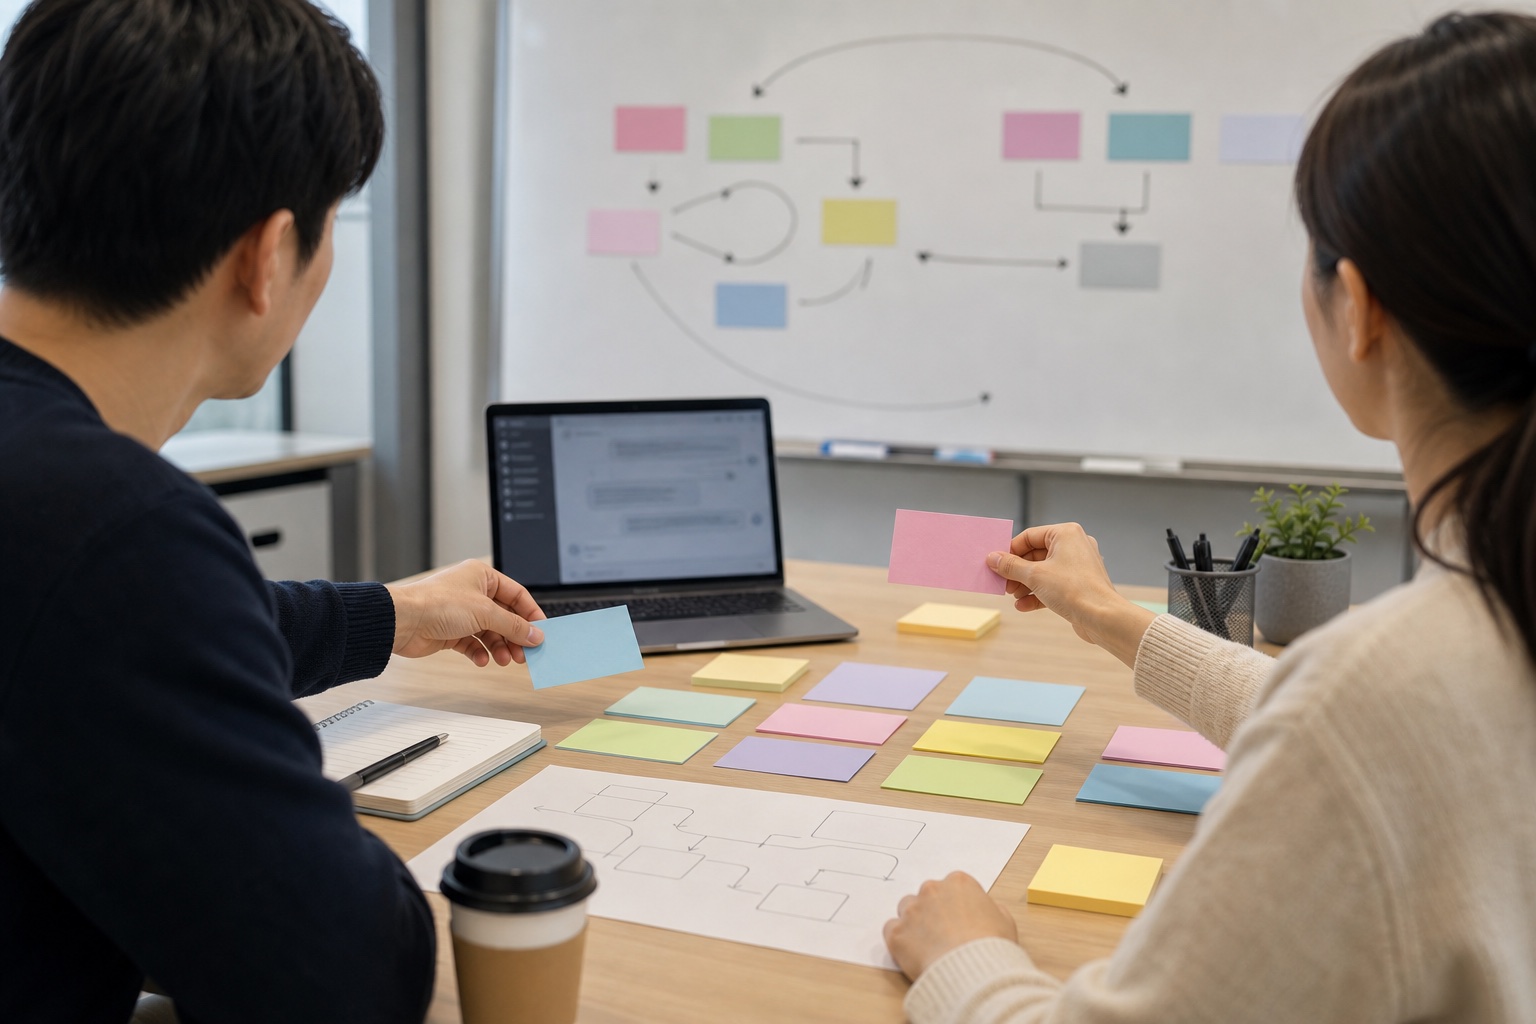
    한국어의 맥락과 뉘앙스를 설명하기 위해 빈 카드와 노트를 배열하는 워크숍 장면
    한국어의 생략과 뉘앙스는 AI에게 더 분명한 맥락 설명을 요구한다.

    영상에서 가장 흥미로운 대목은 한국어의 고맥락성이다. 한국어는 주어와 목적어를 자주 생략한다. 조사 하나로 초점이 바뀐다. 높임말은 표면적으로는 잘 처리되지만, 비꼼이나 반어는 전혀 다른 문제다.

    예를 들어 “철수는 학교에 갔다”와 “철수가 학교에 갔다”는 비슷해 보이지만 초점이 다르다. “괜찮습니다”도 정말 괜찮다는 뜻일 수 있고, 거절일 수도 있다. “시원섭섭하다”는 시원함과 섭섭함의 비율이 상황마다 다르다.

    사람은 이 차이를 상황으로 읽는다. AI는 대부분 텍스트로만 받는다. 그래서 한국어 사용자는 AI에게 더 많은 맥락을 제공해야 한다. “알아서 해 줘”는 편하지만, AI 입장에서는 정보가 부족한 명령이다.

    이 문제는 번역에서도 드러난다. Anthropic의 해석가능성 연구는 대형 언어모델이 여러 언어 입력을 내부적으로 공통 개념 공간과 연결해 처리할 수 있음을 보여준다. 다만 이것이 곧 한국어의 뉘앙스까지 완벽히 보존한다는 뜻은 아니다. 언어 간 이동 과정에서 정서, 생략, 반어, 화자의 의도가 손실될 수 있다.

    프롬프트 엔지니어링은 ‘질문 잘하기’가 아니라 시스템을 다루는 일이다

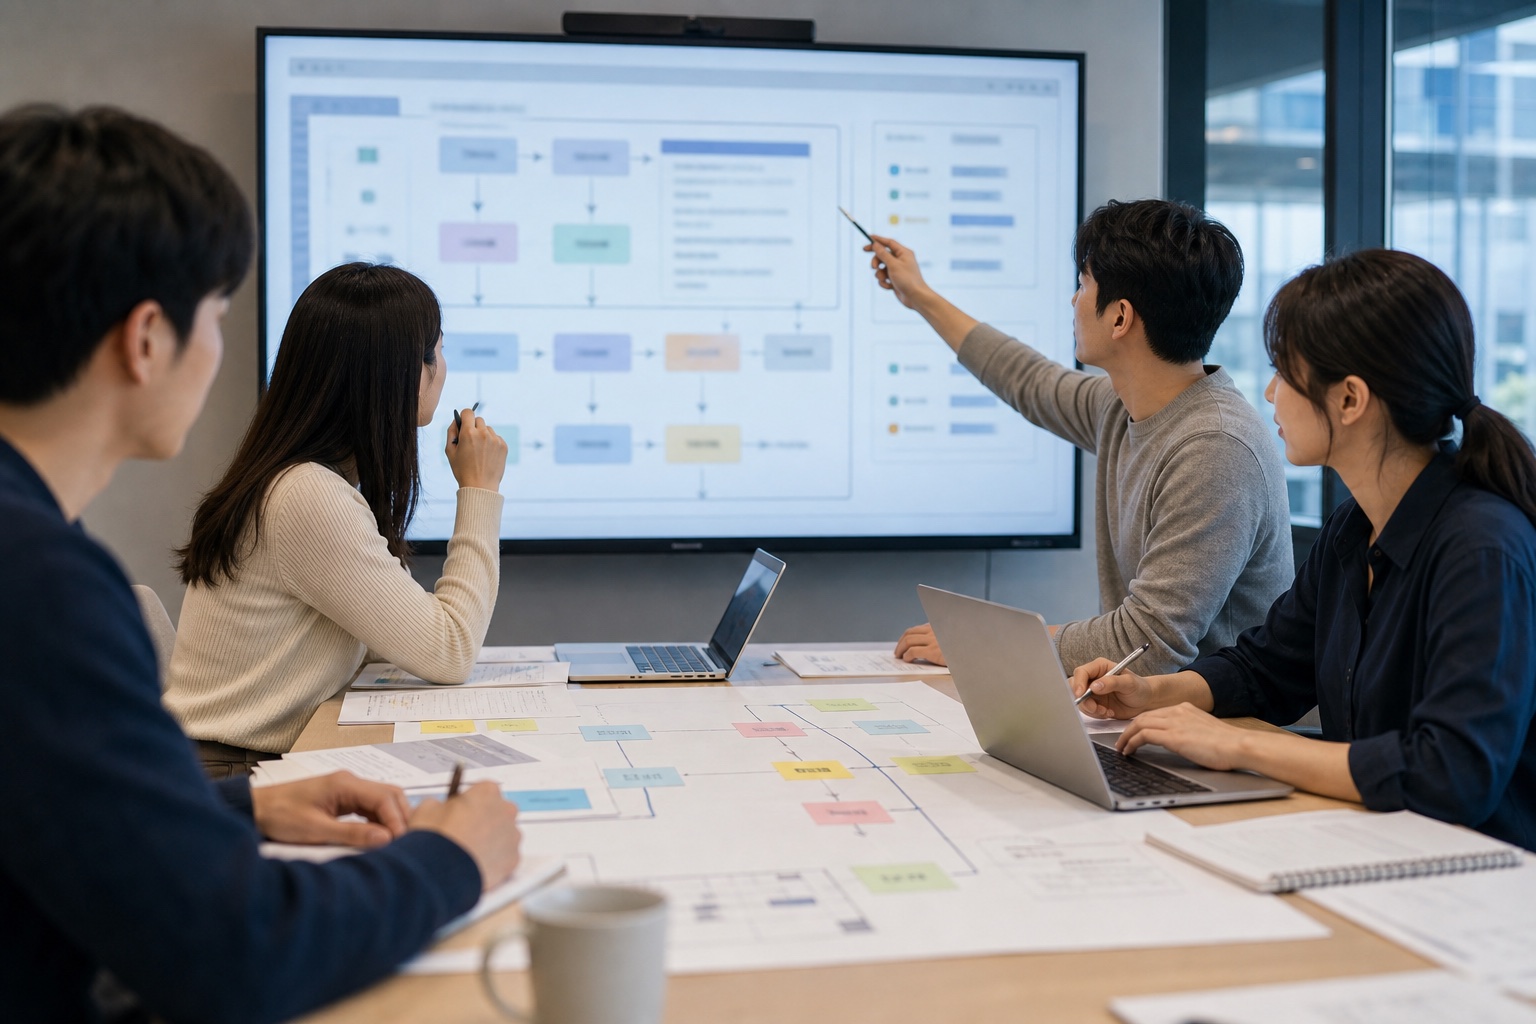
    AI 기반 업무 흐름과 품질 관리 절차를 회의실에서 검토하는 장면
    조직에서 프롬프트 엔지니어링은 질문법을 넘어 품질과 운영 설계의 문제가 된다.

    영상에서는 프롬프트와 프롬프트 엔지니어링을 구분한다. 일상 사용자는 AI와 대화하듯 질문하면 된다. 그러나 업무 시스템, 고객 서비스, 자동화, 콘텐츠 생산 파이프라인에서는 이야기가 달라진다.

    프롬프트 엔지니어링은 단순히 “예쁘게 질문하는 기술”이 아니다. 모델마다 답변 성향이 어떻게 다른지 본다. 오답이 왜 나왔는지 분석한다. 비용을 줄이는 구조를 설계한다. 여러 단계의 작업을 안정적으로 연결한다. 결과의 일관성을 조절한다.

    예를 들어 글쓰기는 창의성이 필요하지만, 고객 안내 문구나 법률·정책 안내는 매번 달라지면 곤란하다. 이때는 temperature 같은 생성 설정, 예시 기반 출력, 검증 단계, 재시도 조건이 필요하다.

    즉 프롬프트 엔지니어링은 말의 기술이면서 동시에 운영의 기술이다. 개인의 질문법에서 출발하지만, 조직에서는 품질관리와 비용관리의 문제로 확장된다.

    “하지 마”보다 “이렇게 해”가 더 강하다

    모호한 요청 카드를 정리해 구체적인 지시 카드로 바꾸는 업무 장면
    AI에게는 금지보다 원하는 방향과 기준을 구체적으로 알려주는 편이 안정적이다.

    영상에서 반복되는 실전 팁 중 하나는 부정문보다 긍정문을 쓰라는 것이다. “전문 용어 쓰지 마”보다 “일상적인 단어를 사용해”가 낫다. “길게 쓰지 마”보다 “문단당 3문장 이내로 써”가 낫다. “목록식으로 쓰지 마”보다 “짧은 설명문 형태로 써”가 더 분명하다.

    AI는 사용자의 부정 표현을 언제나 안정적으로 처리하지 못한다. 특히 이미지·영상 모델이나 멀티모달 모델에서는 부정어가 원하는 결과를 흐릴 수 있다. 텍스트 모델에서도 “하지 말라”는 말이 오히려 금지한 요소를 문맥 중심에 올려놓는 경우가 있다.

    업무에서는 다음처럼 바꾸면 좋다.

    흔한 요청더 나은 요청
    너무 어렵게 쓰지 마중학생도 이해할 수 있는 일상어로 써
    길게 쓰지 마600자 안에서 핵심 3가지만 설명해
    AI 티 나게 쓰지 마짧은 문장과 긴 문장을 섞고, 반복 표현을 줄여
    알아서 정리해 줘배경, 핵심 쟁점, 실행 과제 순서로 정리해
    주관적 의견 넣지 마확인된 사실과 해석을 구분해서 써

    이 차이는 작아 보이지만 결과는 크게 달라진다. AI가 추측할 공간을 줄이면, 사용자는 수정 시간을 줄인다.

    AI 생산성 논쟁의 핵심은 ‘얼마나 썼나’가 아니라 ‘무엇을 맡겼나’다

    AI가 만든 초안을 사람의 체크리스트와 현장 맥락으로 검토하는 장면
    AI 생산성은 무엇을 맡기고 무엇을 사람이 판단할지 나누는 능력에서 갈린다.

    AI가 실제 생산성을 높이는지에 대해서는 의견이 갈린다. 다만 이미 일부 연구에서는 구체적 효과가 관찰됐다. NBER의 「Generative AI at Work」는 고객지원 업무에서 생성형 AI 도구가 평균 생산성을 높였고, 특히 경험이 적은 직원에게 더 큰 효과가 있었다고 분석했다.

    반대로 ILO의 생성형 AI와 일자리 분석은 많은 직무가 완전히 대체되기보다 일부 과업이 자동화·보조될 가능성이 크다고 본다. 이 관점은 영상의 결론과도 맞닿아 있다. AI가 모든 일을 없애기보다, 일의 구성 요소를 다시 나눈다는 것이다.

    문제는 “AI를 많이 쓰는가”가 아니다. 무엇을 맡기고, 무엇을 사람이 판단할지 정하는 능력이다. 단순 요약, 초안, 형식 변환, 반복 응답은 AI에 맡기기 쉽다. 그러나 고객의 불안한 마음을 읽는 일, 현장 맥락을 판단하는 일, 말하지 않은 요구를 조심스럽게 확인하는 일은 아직 사람의 몫이 크다.

    한국어 사용자를 위한 5가지 프롬프트 원칙

    1. 생략한 주어와 목적어를 되살린다

    “정리해 줘”라고 쓰기 전에 무엇을, 누구에게, 어떤 목적으로 정리하는지 적는다. 한국어 대화에서는 생략이 자연스럽지만 AI에게는 빈칸이 된다.

    2. 부정문을 긍정문으로 바꾼다

    “딱딱하게 쓰지 마”보다 “친근하지만 과장 없는 말투로 써”라고 말한다. 금지보다 목표를 주는 편이 안정적이다.

    3. 결과물의 형식을 먼저 정한다

    표, 목록, 문단, 보고서, 블로그, 이메일, 발표 대본은 서로 다른 출력이다. 형식을 정하지 않으면 AI는 평균적인 답을 낸다.

    4. 맥락과 기준을 분리해서 준다

    배경은 배경대로, 요구사항은 요구사항대로, 검증 기준은 검증 기준대로 나눈다. 한 문장에 모두 섞으면 AI도 중요도를 놓친다.

    5. 한 번에 끝내려 하지 않는다

    좋은 AI 활용은 싱글 턴보다 멀티 턴에 가깝다. 초안을 받고, 기준을 보강하고, 다시 고치고, 마지막에 검증한다. 이것은 명령이 아니라 협력이다.

    결국 프롬프트는 기술이 아니라 대화 습관이다

    UNESCO의 AI 역량 프레임워크는 AI 시대에 필요한 능력을 단순한 도구 사용이 아니라 인간 중심적 사고, 윤리, 비판적 판단, 실제 활용 역량으로 본다. 프롬프트도 마찬가지다. 단축키처럼 외울 문제가 아니다.

    AI와 대화한다는 것은 내 생각을 더 선명하게 만드는 과정이다. 내가 무엇을 원하는지 모르면 AI도 모른다. 내가 기준을 주지 않으면 AI는 평균값을 낸다. 내가 맥락을 생략하면 AI는 추측한다.

    그래서 영상의 핵심은 “프롬프트를 잘 쓰자”보다 깊다. AI 시대의 경쟁력은 기술을 많이 아는 사람이 아니라, 자신의 언어를 점검하고 맥락을 설계할 수 있는 사람에게 생긴다.

    조금 과장해 말하면, 앞으로의 AI 리터러시는 코딩보다 먼저 언어의 문제일 수 있다. 특히 한국어 사용자에게는 더 그렇다. 우리가 당연하게 생략했던 말, 분위기로 넘겼던 말, “알아서”라고 맡겼던 말이 AI 앞에서는 모두 다시 문장이 되어야 한다.

    함께 읽으면 좋은 글

    참고자료

    • 일당백, 「언어로 섬세하게 표현되는 인간의 지능! AI 프롬프트 엔지니어링의 시작」, YouTube, 자료 보기
    • OpenAI, 「Prompt engineering」, 자료 보기
    • Anthropic, 「Prompt engineering overview」, 자료 보기
    • Anthropic, 「Tracing the thoughts of a large language model」, 자료 보기
    • Erik Brynjolfsson, Danielle Li, Lindsey R. Raymond, 「Generative AI at Work」, NBER Working Paper No. 31161, 자료 보기
    • International Labour Organization, 「Generative AI and Jobs」, 자료 보기
    • UNESCO, 「AI competency framework for teachers」, 자료 보기

    FAQ

    한국어 프롬프트는 영어 프롬프트보다 불리한가요?

    항상 불리하다고 말할 수는 없습니다. 다만 한국어는 생략, 조사, 높임, 맥락 의존이 강해 AI가 사용자의 의도를 추측해야 하는 경우가 많습니다. 그래서 한국어로 쓸 때는 상황과 기준을 더 분명히 적는 편이 좋습니다.

    프롬프트 엔지니어링을 꼭 배워야 하나요?

    일상 사용자는 거창한 엔지니어링까지 배울 필요는 없습니다. 그러나 업무에 AI를 쓰려면 목적, 맥락, 출력 형식, 검증 기준을 주는 기본 습관은 필요합니다.

    AI에게 “하지 마”라고 하면 왜 잘 안 통하나요?

    부정문은 금지 대상을 문맥 안에 함께 넣습니다. 일부 모델은 그 금지 의도를 안정적으로 반영하지 못합니다. 그래서 “하지 마”보다 원하는 행동을 긍정문으로 구체화하는 편이 좋습니다.

    AI가 쓴 글을 사람처럼 만들 수 있나요?

    어느 정도는 가능합니다. 문장 길이, 반복 표현, 주어·목적어 생략, 도치, 리듬, 구체적 상황을 조정하면 기계적인 느낌을 줄일 수 있습니다. 다만 실제 경험이나 판단까지 AI가 대신 가진 것은 아닙니다.

    AI 시대에 사람이 맡아야 할 일은 무엇인가요?

    맥락을 해석하고, 기준을 세우고, 최종 판단을 내리는 일입니다. 고객의 감정, 현장 상황, 조직의 암묵지, 윤리적 판단처럼 말로 완전히 표준화하기 어려운 영역은 여전히 사람의 역할이 큽니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.