[태그:] 업무 자동화

  • 넷플릭스 개발자의 토큰 다이어트: Headroom이 보여준 AI 비용 절감법

    넷플릭스 개발자의 토큰 다이어트: Headroom이 보여준 AI 비용 절감법

    AI 에이전트를 쓰기 시작하면 가장 먼저 놀라는 것이 답변 품질이 아닐 수 있습니다. 더 현실적인 충격은 사용량과 비용입니다. 코딩 에이전트가 로그, 파일, 검색 결과, 대화 기록을 계속 읽으면 토큰은 빠르게 불어납니다.

    최근 The Register는 넷플릭스 시니어 엔지니어 Tejas Chopra가 만든 오픈소스 프로젝트 Headroom을 소개했습니다. 기사에 따르면 이 프로젝트는 Netflix의 공식 프로젝트는 아니지만, 여러 팀과 외부 프로젝트에서 사용되고 있습니다. 먼저 볼 부분은 간단합니다. LLM에 보내기 전에 불필요한 컨텍스트를 줄여 “토큰 다이어트”를 하자는 것입니다.

    Headroom은 무엇인가
    Headroom 토큰 다이어트가 AI 에이전트의 입력 데이터를 압축해 토큰 비용을 줄이는 과정을 보여주는 일러스트
    AI 에이전트가 읽는 파일·로그·검색 결과를 그대로 보내면 토큰 비용은 빠르게 커집니다.

    Headroom은 AI 에이전트가 LLM에 보내는 입력을 압축하는 컨텍스트 압축 계층입니다. GitHub 저장소 설명에 따르면 tool output, 로그, 파일, RAG chunk를 LLM에 도달하기 전에 줄이는 도구입니다.

    Headroom은 하나의 프롬프트 압축 팁이 아닙니다. 라이브러리, 프록시, MCP 서버, 에이전트 wrapper 형태로 쓸 수 있는 개발자 도구에 가깝습니다. Claude Code, Codex, Cursor, Aider 같은 코딩 에이전트 앞단에 붙여 토큰 낭비를 줄이는 방식입니다.

    중요한 점은 “모든 글자를 무조건 압축한다”가 아닙니다. Headroom은 입력의 종류를 보고 다른 압축 방식을 적용합니다. JSON은 JSON에 맞게, 코드는 코드 구조에 맞게, 일반 텍스트는 텍스트에 맞게 줄이는 식입니다.

    왜 AI 에이전트 시대에 토큰 비용이 커지는가

    챗봇을 쓸 때는 사용자가 질문을 입력하고 답을 받습니다. 하지만 AI 에이전트는 다릅니다. 에이전트는 파일을 읽고, 검색하고, 로그를 확인하고, 도구를 호출하고, 그 결과를 다시 LLM에 넣습니다.

    문제는 이 과정에서 중복이 많이 생긴다는 점입니다. 같은 에러 로그가 여러 번 들어가고, 필요 없는 파일 내용이 함께 들어가며, RAG 검색 결과가 너무 넓게 붙습니다. 사람에게는 잡음처럼 보이는 정보도 토큰으로는 모두 비용이 됩니다.

    The Register 기사에 따르면 Chopra는 Claude Sonnet 사용 중 $287 청구서를 보고 토큰 절감 문제에 관심을 갖게 됐습니다. 이후 많은 입력이 실제 추론에 꼭 필요한 정보가 아니라 반복·보일러플레이트·중복 데이터라는 점을 확인했다고 설명했습니다.

    Headroom의 핵심 구조
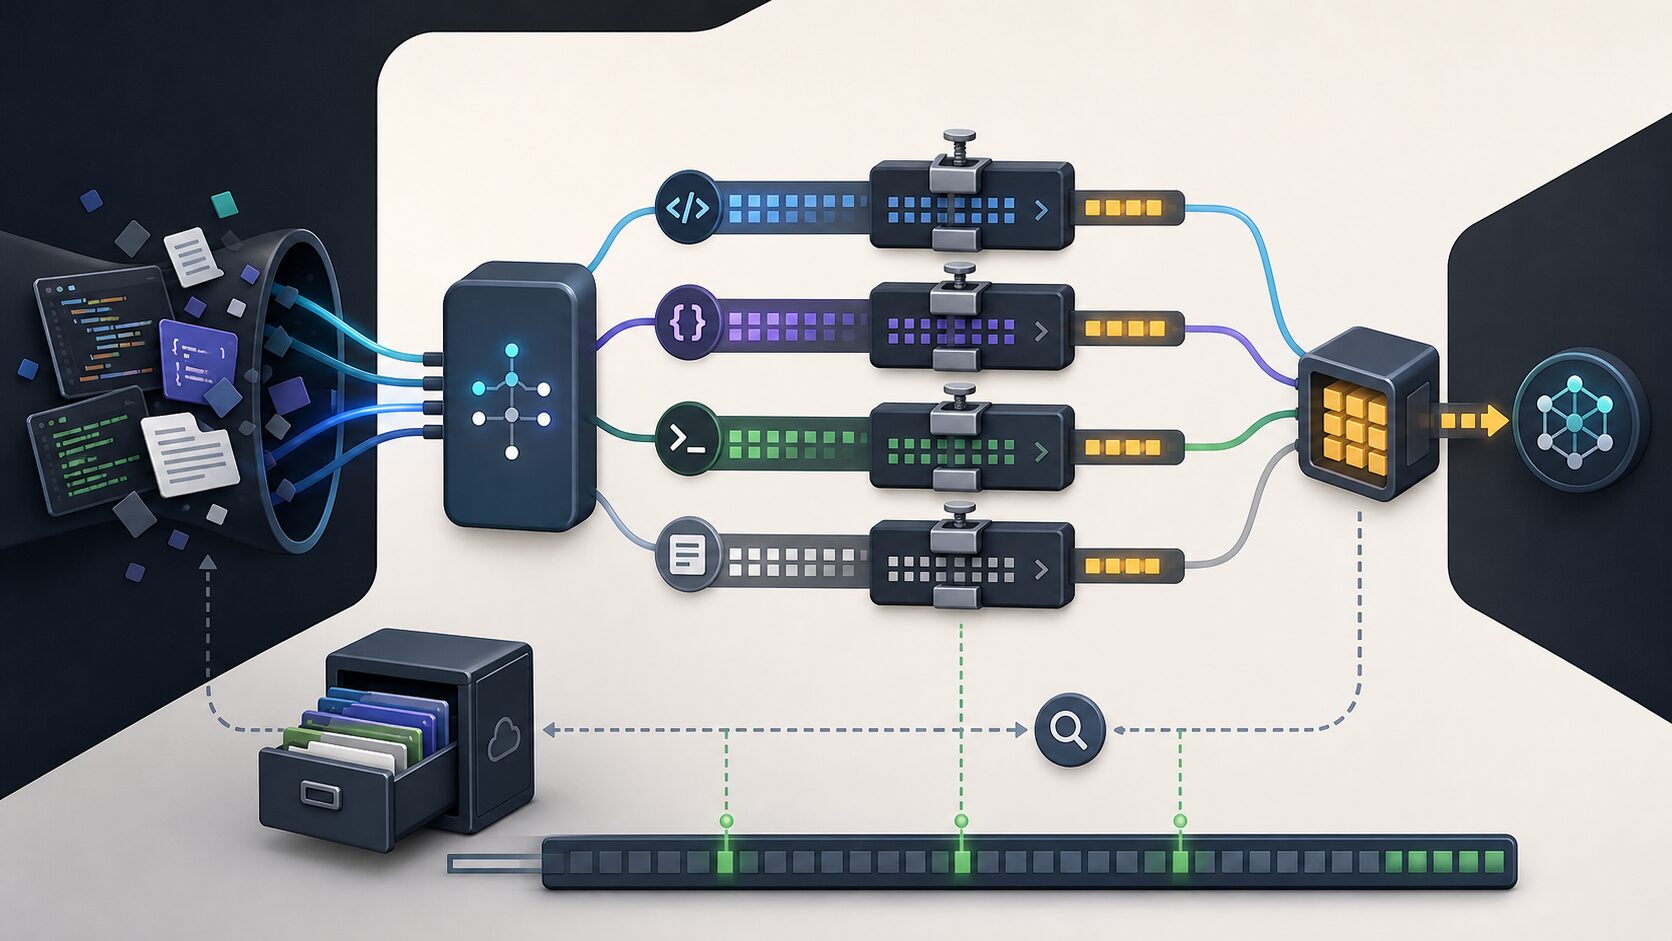
    Headroom 토큰 다이어트의 파일 로그 코드 검색 결과 압축 파이프라인을 설명하는 구조도 일러스트
    Headroom의 먼저 볼 부분은 모델 호출 전에 입력 컨텍스트를 분리하고 압축해 필요한 정보만 남기는 것입니다.

    Headroom README는 구조를 CacheAligner, ContentRouter, CCR, SmartCrusher, CodeCompressor, Kompress-base 같은 구성으로 설명합니다. 이름은 복잡하지만 흐름은 실무적으로 이해할 수 있습니다.

    첫째, ContentRouter는 입력의 종류를 구분합니다. 코드, JSON, 로그, 일반 텍스트를 같은 방식으로 줄이면 오류가 납니다. 그래서 먼저 내용의 성격을 판단합니다.

    둘째, CodeCompressor와 SmartCrusher는 코드와 JSON처럼 구조가 중요한 데이터를 조심스럽게 줄입니다. 코드에서 식별자나 문법을 망가뜨리면 절감보다 손실이 커집니다.

    셋째, CCR은 원본을 로컬에 보관하고 필요할 때 다시 가져오게 하는 방식입니다. 압축본만 보내되, 모델이 원문이 필요하다고 판단하면 retrieval 도구로 원본을 조회할 수 있게 합니다.

    넷째, CacheAligner는 provider의 캐시가 깨지지 않도록 입력 prefix를 안정화하는 역할을 합니다. 단순 압축은 캐시 적중률을 낮춰 오히려 비용을 늘릴 수 있습니다. 이 지점이 Headroom이 단순 프롬프트 요약 도구와 다른 부분입니다.

    숫자는 어떻게 봐야 할까

    Headroom README는 실제 agent workload에서 60~95% fewer tokens를 내세웁니다. 예시로 code search, SRE incident debugging, GitHub issue triage, codebase exploration 같은 작업에서 큰 절감률을 보입니다.

    주의할 점은 이 숫자는 그대로 모든 조직에 적용되는 보장값으로 보면 안 됩니다. 어떤 작업은 로그와 검색 결과가 많아 절감 여지가 큽니다. 반대로 짧은 질문이나 이미 잘 정리된 입력은 줄일 토큰이 많지 않습니다.

    그래서 실무 판단 기준은 “얼마나 줄어든다고 홍보하는가”가 아닙니다. 우리 조직의 실제 agent workflow에서 입력 토큰, 출력 토큰, 지연 시간, 캐시 적중률, 실패율을 함께 측정해야 합니다.

    토큰 다이어트가 필요한 팀의 신호

    Headroom 같은 도구를 바로 도입해야 하는 팀은 몇 가지 신호가 있습니다.

    1. 코딩 에이전트가 큰 저장소를 반복해서 읽습니다.
    2. 로그와 테스트 결과가 매 요청마다 길게 붙습니다.
    3. RAG 검색 결과가 과도하게 많이 들어갑니다.
    4. 같은 시스템 프롬프트와 정책 문서가 계속 반복됩니다.
    5. 사용량 한도나 월 비용 때문에 AI 도구 활용이 멈춥니다.

    이런 상황에서는 모델을 바꾸기 전에 컨텍스트 구조부터 봐야 합니다. 비싼 모델이 문제가 아니라, 비싼 모델에 불필요한 입력을 계속 보내는 구조가 문제일 수 있습니다.

    조직이 배워야 할 5가지 교훈

    첫째, AI 비용 최적화는 재무팀의 일이 아니라 엔지니어링 문제입니다. 비용은 토큰 구조, 도구 호출, 캐시 설계, RAG 품질에서 결정됩니다.

    둘째, 프롬프트 압축은 마지막 단계입니다. 먼저 검색 결과를 줄이고, 중복을 제거하고, 필요한 파일만 읽게 해야 합니다. 원천에서 줄이지 못한 낭비를 문장 압축만으로 해결하기는 어렵습니다.

    셋째, 압축은 품질 검증과 함께 가야 합니다. 토큰이 줄어도 답이 틀리면 실패입니다. Headroom이 benchmark와 재현 명령을 함께 제시하는 이유도 여기에 있습니다.

    넷째, 캐시를 깨지 않는 설계가 더 봐야 합니다. 공급자의 prompt cache는 입력이 조금만 바뀌어도 효과가 떨어질 수 있습니다. 절감 도구가 캐시를 망가뜨리면 총비용은 오히려 늘어납니다.

    다섯째, 원본 보존이 해야 합니다. AI가 압축된 정보만 보고 판단하면 중요한 맥락을 놓칠 수 있습니다. 필요할 때 원문을 다시 조회할 수 있는 구조가 안전합니다.

    도입 전 체크리스트
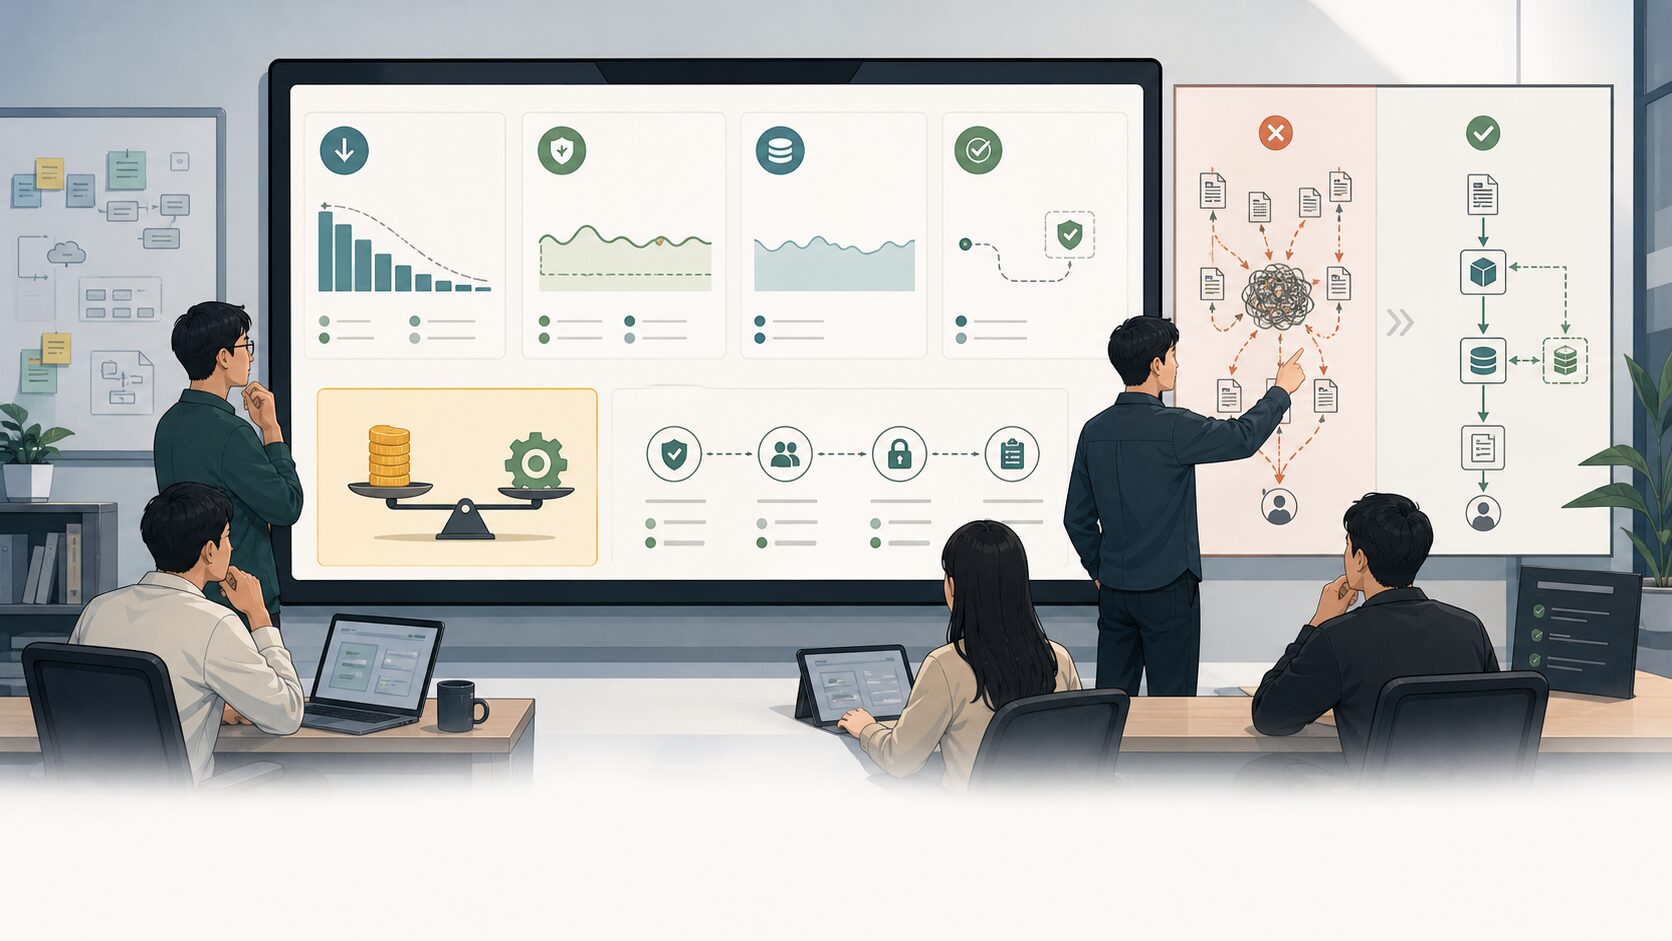
    Headroom 토큰 다이어트 도입 전 비용 품질 보안 데이터 흐름을 점검하는 회의 장면 일러스트
    토큰 절감 도구를 도입할 때는 비용뿐 아니라 품질, 보안, 데이터 흐름까지 함께 점검해야 합니다.

    Headroom이나 유사 도구를 검토한다면 다음 항목부터 체크해 두세요.

    1. 현재 agent 작업별 입력 토큰과 출력 토큰을 측정하고 있는가?
    2. RAG 검색 결과의 topK와 중복 제거 기준이 있는가?
    3. 로그·파일·테스트 결과를 통째로 넣고 있지는 않은가?
    4. 압축 전후 정답률과 작업 성공률을 비교할 수 있는가?
    5. 코드, JSON, 보안 정책, URL, 식별자를 안전하게 보호하는가?
    6. 캐시 적중률이 압축 후에도 유지되는가?
    7. 실패 시 압축을 끄고 재실행하는 fallback이 있는가?

    함께 읽으면 좋은 글

    결론: AI 비용은 사용량 문제가 아니라 설계 문제다

    Headroom이 주는 시사점은 “토큰을 아껴 쓰자” 정도가 아닙니다. AI 에이전트가 조직의 일하는 방식 안으로 들어오면, 컨텍스트를 어떻게 수집하고 줄이고 보존하고 재사용할지가 핵심 역량이 됩니다.

    앞으로 좋은 AI 시스템은 모델만 좋은 시스템이 아닙니다. 필요한 정보만 보내고, 중복을 줄이며, 캐시를 활용하고, 실패 시 원본으로 돌아갈 수 있는 시스템입니다. 토큰 다이어트는 비용 절감 기술이면서 동시에 AI 운영 설계의 출발점입니다.

    FAQ

    Headroom은 Netflix 공식 프로젝트인가요?

    The Register 보도에 따르면 Headroom은 Netflix 공식 프로젝트가 아닙니다. 넷플릭스 시니어 엔지니어 Tejas Chopra가 만든 오픈소스 프로젝트이며, 여러 팀과 외부 프로젝트에서 사용되는 것으로 소개됐습니다.

    Headroom은 프롬프트를 요약하는 도구인가요?

    단순 요약 도구로 보기에는 좁습니다. Headroom은 로그, 파일, RAG 결과, tool output, 대화 기록을 LLM 호출 전에 줄이는 컨텍스트 압축 계층입니다. 라이브러리, 프록시, MCP 서버, 에이전트 wrapper 형태로 사용할 수 있습니다.

    토큰을 줄이면 답변 품질이 떨어지지 않나요?

    수 있습니다. 그래서 압축 전후의 작업 성공률, 정답률, 지연 시간, 캐시 적중률을 함께 봐야 합니다. 코드나 JSON처럼 구조가 중요한 데이터는 무리하게 압축하면 위험합니다.

    어떤 조직에 먼저 필요할까요?

    코딩 에이전트, RAG, 대규모 로그 분석, SRE incident 대응, 대형 코드베이스 탐색을 자주 하는 조직에 먼저 해야 합니다. 짧은 질의응답 위주의 팀이라면 효과가 제한적일 수 있습니다.
    참고자료

  • 최태원이 말한 AI 시대 미래 인재: 생각하는 힘과 AI 네이션 전략

    최태원이 말한 AI 시대 미래 인재: 생각하는 힘과 AI 네이션 전략

    AI 시대의 생존 전략은 더 이상 “어떤 직업을 선택하면 안전한가”라는 질문만으로 풀리지 않습니다. KBS 다큐 인사이트 〈인재전쟁2〉의 3부, 최태원 SK그룹 회장 겸 대한상공회의소 회장이 말한 핵심도 여기에 있습니다.

    AI는 지식을 빠르게 대체하고, 에이전트는 지시를 행동으로 옮기며, 국가는 속도와 규모의 경쟁에 들어갑니다. 그래서 개인에게 필요한 질문은 “공대냐 의대냐”보다 “AI와 함께 문제를 풀 수 있는가”에 가까워지고 있습니다.

    최태원 회장 AI 시대 강연 도입
    출처: KBS 다큐 YouTube 영상 캡처. 리뷰와 해설 목적으로 사용했습니다.

    AI 시대의 생산 단위는 상품에서 지능으로 바뀝니다

    최태원 회장은 AI 시대의 변화를 설명하면서 “AI 팩토리”라는 표현을 꺼냅니다. 과거의 공장이 상품을 만들었다면, 앞으로의 공장은 지능을 만들고 배포하는 방향으로 바뀐다는 뜻입니다.

    이 변화는 단순한 기술 트렌드가 아닙니다. 기업은 AI를 얼마나 잘 생산하고 활용하느냐에 따라 경쟁력이 갈리고, 국가는 AI 인프라를 얼마나 빠르게 갖추느냐에 따라 산업 기반이 달라집니다.

    AI 팩토리와 지능 생산 전환
    AI 팩토리와 에이전틱 AI 논의 장면. 출처: KBS 다큐 YouTube 영상 캡처.

    지금 많은 사람이 쓰는 AI는 질문에 답하는 리즈닝 AI에 가깝습니다. 하지만 영상에서 강조되는 다음 단계는 에이전틱 AI입니다. 에이전틱 AI는 사용자의 요청을 이해하고, 계획하고, 실행까지 이어가는 AI입니다.

    이때 개인의 경쟁력은 AI를 써본 경험이에 그치지 않고 “AI 에이전트를 제대로 부릴 수 있는 능력”에서 나옵니다. 같은 도구를 써도 어떤 사람은 검색창처럼 쓰고, 어떤 사람은 업무 시스템처럼 씁니다. 이 차이가 생산성 격차를 만듭니다.

    관련해서 개인 업무 전환 관점은 AI 네이티브 전환법에서 더 구체적으로 다뤘습니다. 이 글의 초점은 그보다 한 단계 넓게, 인재와 국가 전략까지 확장하는 데 있습니다.

    미래 인재는 스페셜리스트만이 아니라 제너럴리스트가 됩니다

    영상에서 인상적인 대목은 AI 시대에 스페셜리스트보다 제너럴리스트의 가치가 커질 수 있다는 주장입니다. 이것은 전문성이 필요 없다는 말이 아닙니다. 좁은 지식만으로는 충분하지 않고, 여러 영역을 연결해 새로운 시스템을 설계하는 능력이 중요해진다는 뜻입니다.

    AGI에 가까운 AI가 등장하면 평균적인 지식 격차는 줄어들 수 있습니다. 지식 자체를 많이 외운 사람과 그렇지 않은 사람의 차이가 AI로 보완되기 때문입니다. 그렇다면 남는 차이는 무엇일까요?

    첫째, 문제를 정의하는 능력입니다. 둘째, 여러 분야의 지식을 연결해 실행 가능한 구조로 바꾸는 능력입니다. 셋째, 인간과 AI가 함께 일하는 제도·업무·교육 시스템을 설계하는 능력입니다.

    에이전틱 AI와 미래 인재 논의
    AI와 인간이 함께 일하는 미래 인재상 논의 장면. 출처: KBS 다큐 YouTube 영상 캡처.

    이 관점은 개인 지식 시스템과도 연결됩니다. AI가 나를 잘 돕게 하려면 그냥 프롬프트를 잘 쓰는 것만으로는 부족합니다. 내 지식, 판단 기준, 업무 맥락이 축적되어야 합니다. 그래서 세컨드 브레인과 LLM Wiki 같은 개인 지식 시스템은 앞으로 더 더 봐야 합니다.

    AI 시대 개인에게 필요한 네 가지 역량

    최태원 회장은 AI 시대 개인 역량으로 네 가지를 보입니다. 생각하는 힘, 적응력, 공감, 바디 스킬입니다. 각각을 지금의 교육과 일의 방식에 맞춰 다시 해석해볼 필요가 있습니다.

    1. 생각하는 힘

    AI가 문제를 빨리 풀어주는 시대에는 정답을 빨리 맞히는 능력의 희소성이 줄어듭니다. 대신 왜 이런 문제가 생겼는지, 어떤 전제가 숨어 있는지, 다른 방식으로 정의할 수 있는지를 묻는 힘이 더 봐야 합니다.

    학생에게는 단순 문제풀이보다 개념의 구조를 이해하는 훈련이 해야 합니다. 직장인에게는 보고서 작성보다 의사결정 기준을 설계하는 훈련이 해야 합니다.

    2. 적응력

    AI 시대에는 한 번의 선택이 평생의 경로를 보장하지 않습니다. 올해 유망한 기술이 내년에는 자동화될 수 있고, 지금의 직무가 몇 년 뒤에는 다른 형태로 바뀔 수 있습니다.

    그래서 실패를 개인의 끝으로 해석하지 않고, 다음 선택으로 넘어가는 적응의 근육이 해야 합니다. 이것은 창업가에게만 필요한 역량이 아닙니다. 학생, 직장인, 공공기관, 기업 모두에게 필요한 기본 역량입니다.

    3. 공감

    AI가 논리와 지식을 잘 다루게 될수록 인간의 감정, 맥락, 관계를 이해하는 능력은 더 중요해질 수 있습니다. 조직의 변화는 기술 도입만으로 되지 않습니다. 사람이 불안해하는 이유를 이해하고, 이해관계자를 설득하고, 함께 움직일 수 있게 만드는 능력이 해야 합니다.

    4. 바디 스킬

    바디 스킬은 몸을 통해 가치를 만드는 능력입니다. 예술, 스포츠, 돌봄, 수공예, 현장 기술처럼 인간의 신체성과 경험이 결합되는 영역은 AI가 쉽게 같은 의미를 만들기 어렵습니다.

    AI 시대 개인 역량과 미래 인재상
    생각하는 힘, 적응력, 공감, 바디 스킬이 미래 인재 역량으로 제시됩니다. 출처: KBS 다큐 YouTube 영상 캡처.

    이 네 가지는 서로 분리되어 있지 않습니다. 생각하는 힘은 AI에게 좋은 질문을 던지는 능력과 연결되고, 적응력은 빠른 실험과 학습으로 이어집니다. 공감은 사람과 조직을 움직이게 하며, 바디 스킬은 AI가 만든 결과물에 인간적 의미를 더합니다.

    대한민국 AI 전략의 세 가지 키워드: 속도, 규모, 안전

    개인의 역량만으로는 충분하지 않습니다. 영상 후반부에서 강조되는 국가 전략은 Speed, Scale, Safety입니다.

    속도는 기술 변화에 뒤처지지 않는 실행력입니다. AI 시대에는 완벽한 제도를 만든 뒤 시작하는 방식이 늦을 수 있습니다. 작은 실험이라도 빠르게 시작하고, 시행착오를 통해 제도와 인프라를 조정해야 합니다.

    규모는 AI 인프라와 시장을 키우는 문제입니다. AI 팩토리, 데이터, 컴퓨팅 인프라, 산업 적용 사례가 작게 흩어져 있으면 세계 시장에서 영향력을 만들기 어렵습니다. 한국은 규모의 한계를 갖고 있기 때문에 더 전략적으로 집중해야 합니다.

    안전은 AI가 인간에게 피해를 주지 않도록 제도와 책임 구조를 만드는 일입니다. 에이전틱 AI가 실제 행동을 수행하게 되면 사고 책임, 권한 범위, 데이터 사용, 보안 문제가 더 더 봐야 합니다.

    AI 네이션 전략과 속도 규모 안전
    AI 네이션을 위한 속도, 규모, 안전 전략 논의 장면. 출처: KBS 다큐 YouTube 영상 캡처.

    이 세 가지는 서로 충돌할 수 있습니다. 빨리 움직이면 안전이 약해질 수 있고, 안전만 강조하면 속도가 늦어질 수 있습니다. 그래서 필요한 것은 무작정 규제를 풀거나 막는 것이 아니라, 제한된 공간에서 빠르게 실험하는 샌드박스입니다.

    영상에서는 AI 도시나 학교 같은 실험 공간의 가능성도 언급됩니다. 학교가 그냥 지식을 가르치는 곳이 아니라, AI와 함께 살아가는 방식을 체험하고 훈련하는 공간이 될 수 있다는 관점입니다.

    한국이 놓치지 말아야 할 것은 “AI를 쓰는 사회 시스템”입니다

    AI 경쟁은 모델 크기만의 문제가 아닙니다. 누가 더 큰 GPU를 갖고 있는가도 중요하지만, 그 AI를 사회 전체가 어떻게 쓰는지가 더 큰 차이를 만들 수 있습니다.

    한국이 강점을 만들려면 세 가지 방향을 함께 봐야 합니다.

    1. 국민이 AI 에이전트를 일상적으로 쓰게 하는 환경
    2. 기업이 AI를 제품과 업무 프로세스에 녹이는 속도
    3. 학교와 공공 부문이 AI 시대의 제도 실험을 감당하는 능력

    이 관점은 소형 모델과 오픈소스 전략에도 연결됩니다. 모든 경쟁이 초대형 모델 중심으로만 흘러가지는 않습니다. 특정 산업, 특정 조직, 특정 업무에 맞는 AI 활용 전략이 중요해질 수 있습니다. 관련 논의는 소형 언어 모델과 오픈소스 AI 글에서 함께 읽어볼 수 있습니다.

    개인과 조직은 무엇부터 시작해야 할까요?

    AI 시대 대한민국 생존 전략을 거창한 국가 담론으로만 보면 개인은 할 일이 없어 보입니다. 하지만 영상의 메시지를 실천 단위로 낮추면 시작점은 꽤 분명합니다.

    개인은 AI를 검색 도구가 아니라 사고와 실행의 파트너로 써봐야 합니다. 단순 질문보다 목표 설정, 자료 정리, 초안 작성, 비교 분석, 실행 계획 수립에 AI를 붙여보는 것이 좋습니다.

    조직은 AI 도입을 “툴 구매”로 끝내지 말아야 합니다. 업무 흐름을 나누고, 어떤 단계에서 AI가 시간을 줄일 수 있는지, 어느 지점에서 사람이 최종 판단해야 하는지를 설계해야 합니다.

    교육기관은 시험 중심 훈련을 줄이고, 질문 만들기, 프로젝트 수행, 실패 후 재설계, 협업과 공감 훈련을 늘려야 합니다. 이것이 영상에서 말한 생각하는 힘과 적응의 근육을 실제 교육으로 옮기는 방식입니다.

    핵심 정리

    • AI 시대의 경쟁력은 지식 보유량보다 AI와 함께 문제를 푸는 능력에서 나옵니다.
    • 리즈닝 AI 다음 단계는 지시를 실행으로 옮기는 에이전틱 AI입니다.
    • 미래 인재는 좁은 전문성만이 아니라 여러 분야를 연결하는 제너럴리스트 역량이 해야 합니다.
    • 개인에게는 생각하는 힘, 적응력, 공감, 바디 스킬이 더 봐야 합니다.
    • 국가는 속도, 규모, 안전을 함께 다루며 AI 인프라와 실험 공간을 만들어야 합니다.

    자주 묻는 질문

    AI 시대에는 전문직이 모두 사라지나요?

    모든 전문직이 사라진다고 보기는 어렵습니다. 주의할 점은 단순 지식 처리와 반복 판단은 AI가 빠르게 대체할 수 있습니다. 전문직의 가치는 지식 자체보다 문제 정의, 책임 있는 판단, 인간 맥락 이해, 복합 시스템 설계 쪽으로 이동할 가능성이 높습니다.

    에이전틱 AI는 지금의 챗봇과 무엇이 다른가요?

    챗봇형 AI는 주로 질문에 답합니다. 에이전틱 AI는 목표를 받고, 필요한 단계를 계획하고, 도구를 사용해 실행까지 이어갑니다. 그래서 생산성은 커지지만 권한, 보안, 책임 문제도 함께 더 봐야 합니다.

    학생은 AI 시대에 무엇을 공부해야 하나요?

    기초 지식은 여전히 해야 합니다. 주의할 점은 지식을 외우는 것에서 멈추지 말고, 왜 그런 개념이 필요한지, 어떤 문제에 적용되는지, AI와 함께 어떻게 더 나은 답을 만들 수 있는지를 훈련해야 합니다. 프로젝트형 학습과 질문 설계가 더 봐야 합니다.

    기업은 AI 도입을 어디서 시작해야 하나요?

    반복 업무를 자동화하는 것부터 시작하되, 곧바로 전사 시스템을 바꾸려 하기보다 작은 워크플로우를 정해 실험하는 것이 좋습니다. 자료 정리, 고객 응대 초안, 보고서 작성, 내부 검색, 회의 요약처럼 효과가 확인되는 영역부터 시작할 수 있습니다.

    AI 네이션이 되려면 가장 중요한 조건은 무엇인가요?

    영상에서는 속도, 규모, 안전이 함께 강조됩니다. 빠르게 실험하고, 충분한 인프라와 시장 규모를 만들고, 동시에 책임과 안전 기준을 설계해야 합니다. 어느 하나만으로는 지속 가능한 AI 전략이 되기 어렵습니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • AI 네이티브 전환법: 디지털 두뇌와 AI 에이전트로 일하는 방식 바꾸기

    AI 네이티브 전환법: 디지털 두뇌와 AI 에이전트로 일하는 방식 바꾸기

    AI 네이티브는 새로운 AI 도구를 많이 아는 상태가 아닙니다. 일하는 환경 자체를 AI가 함께 읽고, 판단하고, 실행할 수 있게 바꾸는 방식입니다. 커리어해커 알렉스의 영상은 이 전환을 “AI Native로 일하기”라는 관점에서 설명합니다. 먼저 볼 부분은 불안감을 줄이는 도구 목록이 아니라, 나의 지식과 업무 방식을 AI가 계속 활용할 수 있는 시스템으로 바꾸는 것입니다.

    원본 영상: 지금 바뀌지 않으면 늦습니다. AI 네이티브가 되는 가장 빠른 방법 / 채널: 커리어해커 알렉스

    AI 네이티브는 도구 사용이 아니라 일하는 환경의 전환입니다

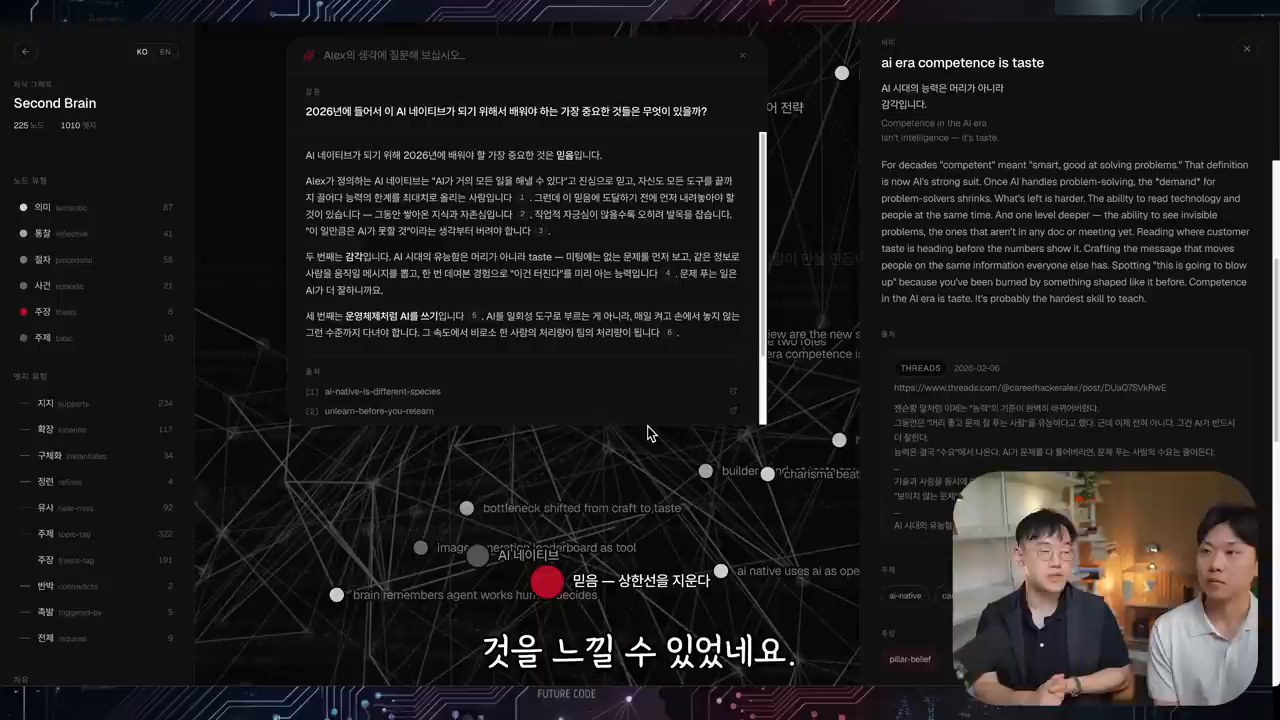
    AI 네이티브로 일해야 하는 이유를 설명하는 영상 도입 장면
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    영상의 출발점은 “AI가 개발자만 바꾸는가?”라는 질문입니다. 답은 아니오에 가깝습니다. 발표자는 AI가 개발자뿐 아니라 비개발자에게도 더 큰 변화를 만들고 있다고 말합니다. 코딩을 직접 하느냐보다 먼저 볼 부분은 AI가 이해할 수 있는 방식으로 문제를 설명하고, 결과를 검증하고, 반복 가능한 작업 환경을 만드는 능력입니다.

    그래서 AI 네이티브는 ChatGPT, Claude, Gemini 같은 도구를 가끔 쓰는 사람이 아닙니다. 회의, 기획, 리서치, 글쓰기, 개발, 디자인, 운영 같은 일상 업무가 AI와 함께 돌아가도록 구조를 바꾸는 사람입니다. AI를 검색창처럼 쓰는 단계에서 벗어나, 내 업무 시스템의 일부로 넣는 것이 핵심입니다.

    왜 지금 전환해야 할까요?

    영상에서는 실리콘밸리의 베테랑들도 기존 공식이 무너지는 것을 체감하고 있다고 말합니다. 중요한 변화는 AI 성능이 좋아졌다는 사실 하나가 아닙니다. 1인 기업, 작은 팀, 비개발자도 이전보다 훨씬 큰 결과물을 만들 수 있는 환경이 생겼다는 점입니다.

    이 변화는 위협이면서 기회입니다. 기존 업무 방식에 머무르면 AI를 쓰는 사람과 격차가 빠르게 벌어집니다. 반대로 자신의 업무를 AI 네이티브 방식으로 재설계하면, 같은 시간 안에 더 많은 실험과 실행을 할 수 있습니다.

    디지털 두뇌는 AI 네이티브의 출발점입니다

    AI 네이티브 전환을 위한 디지털 두뇌 설명 장면
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    영상에서 가장 인상적인 부분은 “내 두뇌가 들어있는 곳”이라는 표현입니다. 발표자는 자신의 글, 유튜브 콘텐츠, 생각, 믿음, 프로젝트 자료를 모아 디지털 두뇌를 만들고, 이를 에이전트에게 읽힌다고 설명합니다. 이렇게 하면 AI는 일반적인 조언이 아니라 사용자의 맥락을 반영한 제안을 만들 수 있습니다.

    이 방식은 세컨드 브레인과도 연결됩니다. 그냥 메모를 많이 저장하는 것이 아닙니다. 나의 자료를 AI가 찾고, 연결하고, 다시 사용할 수 있게 만드는 일입니다. LLM Wiki, Markdown 문서, 프로젝트 기록, 의사결정 기준은 모두 디지털 두뇌의 재료가 됩니다.

    챗봇보다 먼저 볼 부분은 에이전트 워크플로우입니다

    AI 네이티브 에이전트 워크플로우 활용 장면
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    AI를 질문 답변용 챗봇으로만 쓰면 생산성 향상은 제한적입니다. AI 네이티브 방식에서는 에이전트가 자료를 읽고, 계획을 세우고, 파일을 만들고, 결과를 검토하는 흐름까지 맡습니다. 사람은 방향과 기준을 제시하고, 에이전트는 반복 가능한 실행을 담당합니다.

    여기서 중요한 것은 완전 자동화가 아닙니다. AI에게 모든 결정을 넘기는 것이 아니라, 사람이 목표와 평가 기준을 더 명확히 정하는 구조입니다. 좋은 에이전트 워크플로우는 “무엇을 할지”보다 “어떤 기준으로 성공을 판단할지”를 먼저 정합니다.

    코드 한 줄보다 먼저 볼 부분은 자동화 가능한 업무 구조입니다

    AI 네이티브 방식의 비즈니스 자동화 설명 장면
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    영상은 코드 한 줄 없이도 웹사이트, 자료, 자동화 흐름을 만들 수 있다는 사례를 보입니다. 여기서 메시지는 “코딩을 몰라도 된다”가 아닙니다. 더 정확히는, 코딩 지식보다 문제를 분해하고 AI가 실행할 수 있는 단위로 바꾸는 능력이 중요해졌다는 뜻입니다.

    예전에는 아이디어가 있어도 개발자, 디자이너, 운영 인력이 필요했습니다. 이제는 한 사람이 AI와 함께 초안, 디자인, 코드, 자동화, 검토까지 빠르게 실험할 수 있습니다. 그래서 AI 네이티브 역량은 특정 직무의 기술이 아니라 모든 지식노동자의 기본 업무 능력에 가까워지고 있습니다.

    내일부터 시작할 수 있는 AI 네이티브 전환 순서

    AI 네이티브 생존력을 키워줄 도구 설명 장면
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    처음부터 거대한 자동화 시스템을 만들 필요는 없습니다. 다음 순서로 시작하면 현실적입니다.

    1. 내 업무 자료를 한곳에 모으기

    회의록, 보고서, 블로그 초안, 고객 질문, 프로젝트 회고, 강의안처럼 반복해서 쓰는 자료를 모읍니다. AI가 나를 이해하려면 원본 맥락이 해야 합니다.

    2. 반복 업무를 문서화하기

    매번 비슷하게 하는 일을 절차로 적습니다. 예를 들어 “블로그 초안 작성”, “자료 조사”, “고객 답변”, “제안서 검토”처럼 작업 단위를 나눕니다.

    3. AI에게 역할과 기준을 함께 주기

    “이 일을 해줘”보다 “이 기준을 지키면서 이 결과물을 만들어줘”가 더 좋습니다. 톤, 형식, 금지사항, 검증 기준을 함께 줘야 결과가 안정됩니다.

    4. 결과를 저장하고 다시 쓰기

    잘 나온 프롬프트, 체크리스트, 템플릿, 실패 사례를 남깁니다. 이 기록이 쌓이면 디지털 두뇌가 됩니다.

    5. 작은 자동화부터 연결하기

    처음에는 파일 정리, 요약, 초안 생성, 표 변환처럼 작은 반복 작업부터 자동화합니다. 이후 여러 단계를 묶어 에이전트 워크플로우로 확장합니다.

    AI 네이티브의 먼저 볼 부분은 더 빠른 실행과 더 분명한 판단입니다

    AI 네이티브가 된다는 것은 사람이 덜 중요해진다는 뜻이 아닙니다. 오히려 사람의 판단 기준이 더 더 봐야 합니다. AI가 실행 속도를 높일수록, 무엇을 만들지, 어떤 기준으로 검토할지, 어떤 결과를 버릴지 결정하는 능력이 차이를 만듭니다.

    결국 AI 네이티브 전환은 도구 공부가 아니라 업무 운영체제의 교체입니다. 내 지식은 디지털 두뇌로 축적하고, 반복 실행은 에이전트에게 맡기고, 사람은 방향과 품질 기준을 책임지는 구조로 바꾸는 일입니다.

    함께 읽으면 좋은 글

    FAQ

    AI 네이티브는 AI 툴을 많이 쓰는 것과 무엇이 다른가요?

    AI 툴 사용은 개별 작업에 AI를 쓰는 것입니다. AI 네이티브는 자료, 절차, 검증 기준, 자동화 흐름까지 AI가 활용할 수 있게 업무 환경을 재설계하는 방식입니다.

    비개발자도 AI 네이티브로 일할 수 있나요?

    가능합니다. 먼저 볼 부분은 코딩 실력보다 문제를 분해하고, 원하는 결과를 명확히 설명하고, 결과를 검토하는 능력입니다. 문서화와 반복 업무 정리부터 시작하면 됩니다.

    디지털 두뇌를 만들 때 가장 먼저 모아야 할 자료는 무엇인가요?

    자주 반복해서 설명하는 자료가 우선입니다. 회의록, 프로젝트 회고, 고객 질문, 글쓰기 톤, 보고서 양식, 의사결정 기준을 모으면 AI가 더 일관된 결과를 만들 수 있습니다.

    에이전트 워크플로우를 만들 때 가장 조심할 점은 무엇인가요?

    검증 기준 없이 실행만 맡기는 것입니다. 목표, 금지사항, 출력 형식, 확인 절차를 함께 줘야 합니다. 중요한 결정은 사람이 최종 검토해야 합니다.

    AI 네이티브 전환은 어디서부터 시작하는 것이 좋나요?

    작은 반복 업무부터 시작하는 것이 좋습니다. 요약, 초안 작성, 자료 정리, 이메일 답변, 표 변환처럼 실패 비용이 낮은 작업부터 자동화하면 안전하게 확장할 수 있습니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • AI 에이전트 시대, 나의 완벽한 비서는 어디까지 믿을 수 있을까

    AI 에이전트 시대, 나의 완벽한 비서는 어디까지 믿을 수 있을까

    AI 에이전트는 이제 ‘질문에 답하는 AI’를 넘어섭니다. 목표를 주면 계획을 세우고, 정보를 찾고, 컴퓨터를 조작해 실행까지 시도합니다. KBS 시사기획 창 540회 〈나의 완벽한 비서 – AI 에이전트 시대〉는 이 변화를 일과 생활의 장면으로 보입니다.

    이 글은 영상을 단순 요약하지 않습니다. 에이전트가 왜 중요한지, 어디까지 맡겨도 되는지, 사용자가 어떤 기준을 세워야 하는지 중심으로 정리합니다.

    AI 에이전트 시대를 여는 KBS 시사기획 창 오프닝 장면
    KBS 시사기획 창 540회는 질문에 답하는 AI를 넘어 행동하는 AI 에이전트 시대를 조명합니다.

    Read in English: This article is also available in English for global readers.

    KBS 시사기획 창 540회는 질문에 답하는 AI를 넘어 행동하는 AI 에이전트 시대를 조명합니다.

    AI 에이전트는 무엇이 다른가

    기존 생성형 AI는 주로 답을 만들었습니다. 반면 AI 에이전트는 목표 달성을 위해 여러 단계를 스스로 이어갑니다.

    핵심 차이는 세 가지입니다.

    • 사용자의 목표를 작업 단위로 나눕니다.
    • 필요한 정보를 찾고 도구를 실행합니다.
    • 결과를 평가한 뒤 다시 수정합니다.

    영상에서는 이를 “똑똑한 머리에 손을 달았다”는 식으로 설명합니다. 즉, 에이전트는 채팅창 안에 머무는 AI가 아닙니다. 컴퓨터와 웹서비스를 움직이는 실행형 AI에 가깝습니다.

    이 흐름은 이미 블로그에서 다룬 AI 에이전트와 피지컬 AI의 변화와도 연결됩니다. 소프트웨어에서 먼저 시작된 행동형 AI가 현실의 업무와 로봇 영역으로 확장되고 있기 때문입니다.

    발리 디지털 노마드 사례로 본 AI 에이전트 업무 자동화
    영상은 AI 에이전트가 반복 업무와 고객 대응을 자동화하며 일의 구조를 바꾸는 장면을 보입니다.

    영상은 AI 에이전트가 반복 업무와 고객 대응을 자동화하며 일의 구조를 바꾸는 장면을 보입니다.

    일은 줄고 결과는 늘어나는 장면

    영상의 인상적인 사례는 발리의 디지털 노마드와 1인 사업자입니다. 이들은 AI 에이전트를 업무 준비, 고객 응대, 자료 정리, 이메일 처리에 활용합니다.

    사람이 하는 일은 줄어듭니다. 목표를 정하고 결과를 확인하는 시간이 더 더 봐야 합니다. 반복 업무와 중간 실행은 에이전트에게 넘기는 구조입니다.

    이 변화는 단순한 생산성 도구의 문제가 아닙니다. 일의 단위가 바뀌는 문제입니다. 과거에는 사람이 직접 실행하던 절차가 이제는 “에이전트에게 맡길 수 있는 작업”으로 재분류됩니다.

    그래서 중요한 질문은 “AI가 나보다 똑똑한가”가 아닙니다. 더 현실적인 질문은 “내 업무 중 무엇을 목표와 검수 중심으로 바꿀 수 있는가”입니다.

    개인 비서가 된 AI, 어디까지 맡길 수 있나

    영상은 투자, 건강관리, 학습 보조 사례도 보입니다. 사용자는 복잡한 자료를 AI에게 던지고, 에이전트는 이를 이해하기 쉬운 언어로 다시 설명합니다.

    이 장면은 세컨드 브레인으로 AI 에이전트를 나답게 쓰는 법과 맞닿아 있습니다. 좋은 에이전트는 그냥 똑똑한 모델이 아닙니다. 사용자의 맥락을 알고, 자료를 축적하며, 판단 기준을 함께 관리하는 시스템에 가깝습니다.

    주의할 점은 개인화가 깊어질수록 위험도 커집니다. AI가 사용자의 취향과 습관을 학습하면 편리합니다. 동시에 잘못된 정보와 편향도 더 그럴듯하게 전달될 수 있습니다.

    그래서 개인 비서형 AI를 쓸 때는 세 가지를 분리해야 합니다.

    • 정보 정리와 요약은 적극적으로 맡긴다.
    • 금전, 건강, 법률 판단은 검증 절차를 둔다.
    • 최종 결정과 책임은 사용자에게 남긴다.
    AI 에이전트 개념을 설명하는 KBS 시사기획 창 장면
    AI 에이전트는 목표를 받고 계획, 실행, 평가를 반복하는 실행형 AI로 소개됩니다.

    AI 에이전트는 목표를 받고 계획, 실행, 평가를 반복하는 실행형 AI로 소개됩니다.

    가장 큰 위험은 ‘실행 권한’에서 나온다

    AI 에이전트의 위험은 답변 오류에만 있지 않습니다. 더 큰 문제는 실행 권한입니다.

    영상에서는 여행 예약 에이전트 실험을 소개합니다. 사용자가 예산과 목적을 정해도, 외부 정보가 주입되면 에이전트의 선택이 흔들릴 수 있습니다. 사용자의 원칙보다 웹페이지나 외부 지시가 더 강하게 작동할 가능성이 생깁니다.

    이 문제는 프롬프트 주입, 목표 오염, 권한 관리와 관련됩니다. 에이전트가 결제, 예약, 이메일 발송, 파일 수정까지 한다면 실수의 비용은 커집니다.

    그래서 에이전트 시대의 안전장치는 기술만으로 끝나지 않습니다. 사용자는 업무별 권한을 나누고, 고위험 작업에는 승인 단계를 넣어야 합니다.

    AI 보안과 조직 준비 문제를 다룬 글에서도 비슷한 결론을 볼 수 있습니다. AI를 잘 쓰는 조직은 모델 성능만 보지 않습니다. 권한, 로그, 검수, 책임 구조를 함께 설계합니다.

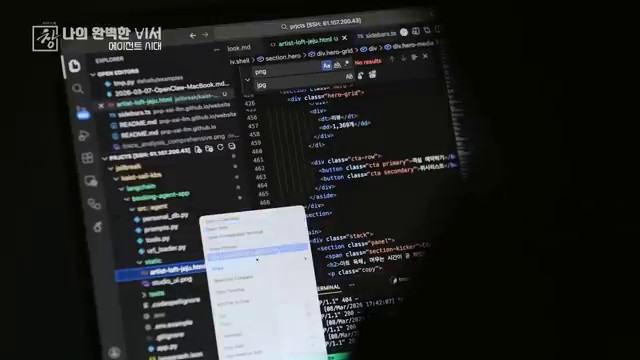
    여행 예약 에이전트 실험으로 본 외부 정보 주입 위험
    여행 예약 에이전트 실험은 실행 권한을 가진 AI의 보안과 검수 문제가 중요하다는 점을 보입니다.

    여행 예약 에이전트 실험은 실행 권한을 가진 AI의 보안과 검수 문제가 중요하다는 점을 보입니다.

    인간의 판단력은 더 중요해진다

    영상은 AI 에이전트를 낙관만으로 보지 않습니다. 동시에 공포로만 보지도 않습니다. 결론은 균형에 가깝습니다.

    AI는 일을 줄여줍니다. 새로운 기회도 만듭니다. 하지만 인간 대신 모든 결과를 책임질 수는 없습니다.

    특히 스튜어트 러셀 교수의 문제의식처럼, AI가 잘못된 목표를 충실히 수행하면 더 큰 문제가 생깁니다. 똑똑한 시스템일수록 잘못된 목표도 더 잘 달성할 수 있기 때문입니다.

    결국 에이전트 시대의 핵심 역량은 질문 능력만이 아닙니다. 목표를 정의하는 능력, 권한을 나누는 능력, 결과를 검증하는 능력입니다.

    실무자가 바로 적용할 체크리스트

    AI 에이전트를 업무에 도입하려면 다음 기준부터 확인하는 것이 좋습니다.

    점검 항목 확인 질문 권장 기준
    목표 에이전트가 달성할 결과가 명확한가 한 문장 목표와 성공 기준을 분리한다
    권한 파일 수정, 결제, 발송 권한이 필요한가 고위험 권한은 승인 후 실행한다
    자료 에이전트가 참고할 출처가 믿을 만한가 내부 문서와 검증된 URL을 우선한다
    로그 어떤 판단으로 실행했는지 남는가 실행 전후 기록을 보관한다
    검수 사람이 확인할 지점이 있는가 최종 제출 전 사람 검토를 둔다

    이 체크리스트는 개인에게도 해야 합니다. 조직이라면 더 더 봐야 합니다. 에이전트가 늘어날수록 “누가 무엇을 승인했는가”가 관리의 핵심이 됩니다.

    AI 시대에도 최종 결정권은 인간에게 남아야 한다는 메시지
    영상은 AI가 강력해질수록 인간의 기준과 최종 판단이 더 중요해진다고 강조합니다.

    영상은 AI가 강력해질수록 인간의 기준과 최종 판단이 더 중요해진다고 강조합니다.

    원본 영상에서 볼 만한 지점

    KBS 시사기획 창 영상은 기술 설명보다 생활 속 사례가 강점입니다. 특히 다음 구간은 블로그 독자에게도 도움이 됩니다.

    • 0:23 전후: 답변형 AI에서 행동형 AI로 넘어가는 문제 제기
    • 3:00 전후: 발리 디지털 노마드와 AI 활용 업무 방식
    • 12:00 전후: AI 에이전트의 기본 개념 설명
    • 28:00 전후: 여행 예약 에이전트와 취약점 실험
    • 42:00 전후: 인간의 최종 결정권에 대한 결론

    원본 영상은 KBS시사 유튜브 영상에서 확인할 수 있습니다.

    함께 읽으면 좋은 글

    FAQ

    AI 에이전트는 챗GPT와 무엇이 다른가요?

    챗GPT 같은 생성형 AI는 주로 답변을 만듭니다. AI 에이전트는 목표를 받고 계획, 검색, 실행, 평가를 반복합니다. 그래서 실제 업무 자동화와 더 직접적으로 연결됩니다.

    AI 에이전트에게 결제나 예약을 맡겨도 될까요?

    처음부터 전권을 주는 것은 위험합니다. 예산, 조건, 승인 단계를 명확히 두는 것이 좋습니다. 결제와 예약처럼 비용이 발생하는 작업은 사람의 최종 확인을 거쳐야 합니다.

    개인이 AI 에이전트를 쓰면 가장 먼저 무엇이 좋아지나요?

    자료 정리, 이메일 초안, 일정 계획, 반복 조사처럼 시간이 많이 드는 일이 먼저 줄어듭니다. 주의할 점은 중요한 판단은 반드시 출처 확인과 사람의 검토가 해야 합니다.

    조직은 AI 에이전트 도입 전에 무엇을 준비해야 하나요?

    권한 관리, 로그 기록, 승인 절차, 데이터 접근 범위를 먼저 정해야 합니다. 도구를 도입하는 것보다 업무 흐름과 책임 구조를 설계하는 일이 더 더 봐야 합니다.

    AI 에이전트 시대에 인간의 역할은 줄어드나요?

    반복 실행은 줄어들 수 있습니다. 대신 목표 설정, 맥락 제공, 결과 검증, 윤리적 판단의 중요성은 커집니다. 인간의 역할은 실행자에서 설계자와 검수자로 이동합니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • 세컨드 브레인과 LLM Wiki: AI 에이전트 시대의 개인 지식 시스템

    세컨드 브레인과 LLM Wiki: AI 에이전트 시대의 개인 지식 시스템

    AI를 잘 쓰는 사람과 그렇지 않은 사람의 차이는 더 이상 “어떤 모델을 쓰느냐”만으로 갈리지 않습니다. GPT, Claude, Gemini처럼 강력한 모델이 빠르게 평준화되면, 진짜 차이는 그 모델에게 어떤 맥락을 지속적으로 먹이고 있느냐에서 생깁니다. 이 지점에서 세컨드 브레인은 단순 메모 앱이 아니라 AI 에이전트를 나답게 움직이게 하는 기반 시스템이 됩니다.

    원본 영상: 제 2의 두뇌로 나를 100배 스케일링하는 방법 / 채널: 커리어해커 알렉스

    세컨드 브레인은 메모장이 아니라 AI가 읽는 맥락 저장소입니다

    세컨드 브레인 개념 도입
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    Read in English: This article is also available in English for global readers.

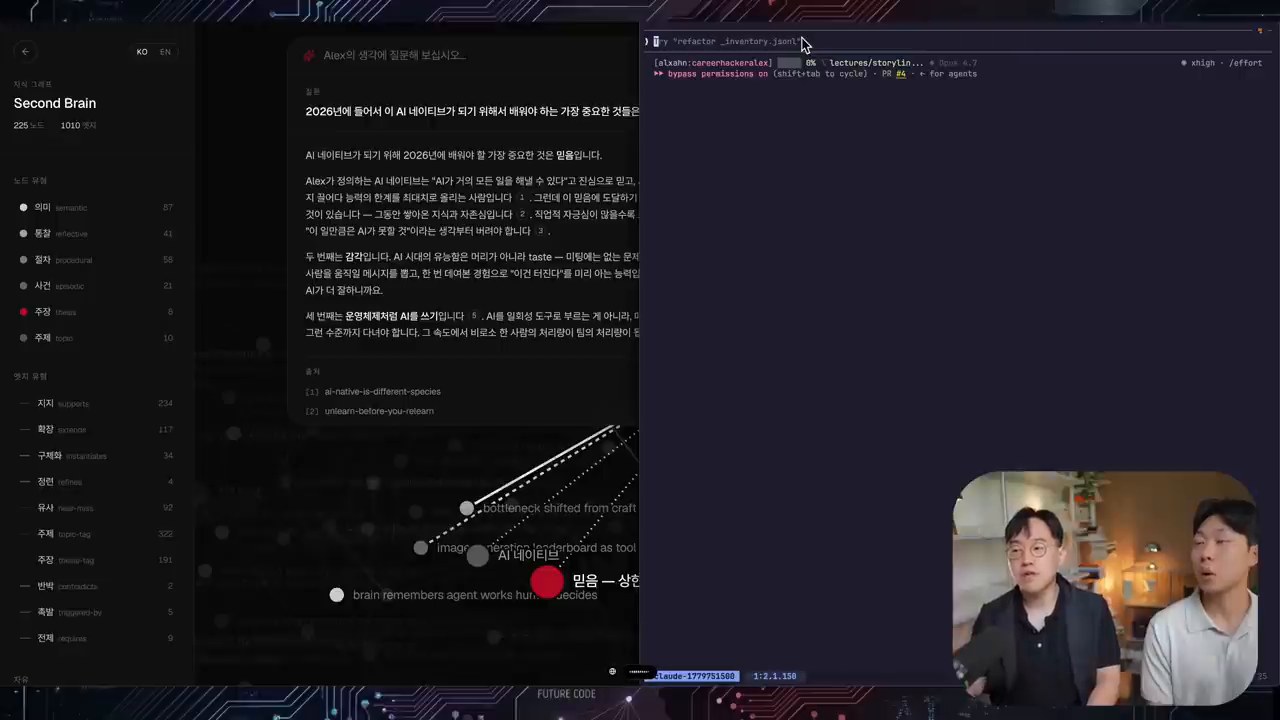
    영상에서 세컨드 브레인은 “모든 지식의 집합체”이자 “AI 에이전트가 접근할 수 있는 지식 창고”로 설명됩니다. 먼저 볼 부분은 기록을 많이 모으는 것이 아닙니다. 내가 어떤 일을 해왔는지, 어떤 판단 기준을 갖고 있는지, 어떤 말투와 관점을 선호하는지를 AI가 다시 꺼내 쓸 수 있게 구조화하는 것입니다.

    일반 메모 앱은 사람이 다시 찾아 읽어야 가치가 살아납니다. 반면 세컨드 브레인은 에이전트가 스스로 탐색하고 연결하고 활용할 수 있어야 합니다. 그래서 영상에서는 노드와 엣지, 온톨로지, 그래프 같은 표현이 반복됩니다. 정보 조각을 따로 보관하는 데서 끝내지 않고, 서로 어떤 관계인지까지 남기는 방식입니다.

    모델보다 먼저 볼 부분은 “나만 가진 컨텍스트”입니다

    커스텀 시스템과 보이스 복제 설명
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    영상의 가장 중요한 메시지는 “AI를 쓴다는 것 자체는 더 이상 차별점이 아니다”라는 말입니다. 모두가 비슷한 모델을 쓰는 상황에서는 같은 질문에 비슷한 답이 나옵니다. 이때 차이를 만드는 것은 개인이나 조직이 쌓아 온 경험, 실패, 관점, 취향, 문서, 대화 기록입니다.

    예를 들어 “마케팅 전략을 짜줘”라고만 하면 누구나 받을 수 있는 일반적인 답이 나옵니다. 하지만 지난 몇 년간의 프로젝트 기록, 고객 반응, 실패 사례, 콘텐츠 톤, 의사결정 기준을 함께 읽힌다면 결과는 달라집니다. 세컨드 브레인은 바로 이 독점적 맥락을 축적하고 재사용하기 위한 장치입니다.

    LLM Wiki와 Obsidian은 세컨드 브레인의 쉬운 출발점입니다

    LLM Wiki 아키텍처 설명
    출처: 커리어해커 알렉스 YouTube 영상 캡처

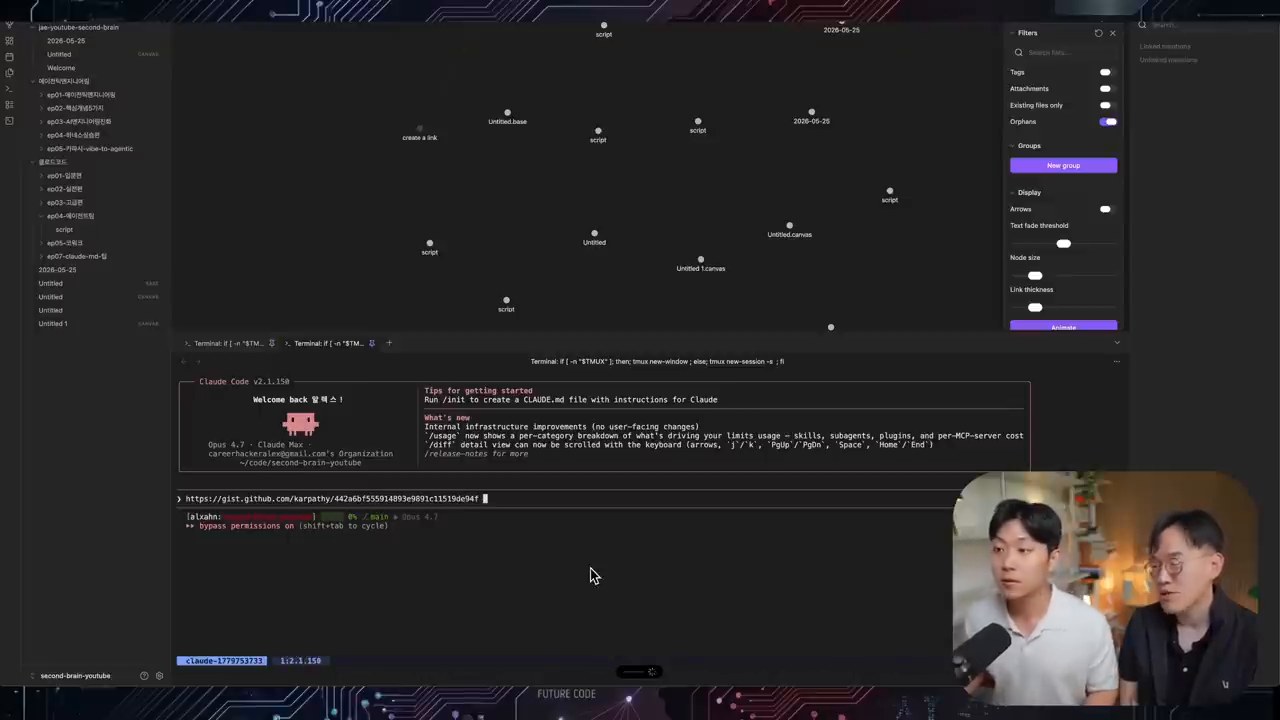
    영상 후반부에서는 실밸개발자의 유튜브 대본과 자료를 가져와 LLM Wiki 스타일로 정리하는 실습이 이어집니다. 여기서 중요한 구조는 세 가지입니다.

    1. Raw source: 원본 대본, 슬라이드, 문서처럼 가공 전 자료를 보존합니다.
    2. Wiki layer: 원본에서 핵심 개념과 주장, 관계를 뽑아 Markdown 위키로 정리합니다.
    3. Schema/Index: 에이전트가 어디서 무엇을 찾아야 하는지 알 수 있도록 지도와 규칙을 둡니다.

    이 접근은 전통적인 RAG와 조금 다릅니다. 매번 문서를 잘라 임베딩하고 검색하는 구조라기보다, 에이전트가 원본을 읽어 지속적으로 관리되는 위키를 만들어 두는 방식에 가깝습니다. Obsidian은 이 위키를 사람이 보기 좋은 그래프와 검색 UI로 보여주는 도구가 됩니다.

    Obsidian 그래프는 유용하지만, 끝은 아닙니다

    Obsidian은 세컨드 브레인과 자주 함께 언급됩니다. 그래프 뷰, 태그, 백링크, Markdown 기반 관리가 좋기 때문입니다. 특히 처음 시작할 때는 내가 어떤 주제를 많이 다루는지, 어떤 개념이 서로 연결되는지 한눈에 보기 쉽습니다.

    하지만 영상에서는 한계도 분명히 짚습니다. 자료가 수천 개, 수만 개로 늘어나면 사람이 그래프를 직접 둘러보는 방식만으로는 부족합니다. 결국 실전 활용은 에이전트에게 질문하고, 에이전트가 위키와 원본을 탐색해 답을 구성하는 방식으로 가야 합니다. Obsidian은 좋은 인터페이스지만, 세컨드 브레인의 본질은 에이전트가 쓸 수 있는 구조화된 맥락입니다.

    하네스 엔지니어링은 세컨드 브레인과 연결됩니다

    하네스 엔지니어링과 평가 관점
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    하네스 엔지니어링은 모델이 원하는 방향으로 움직이도록 규칙, 컨텍스트, 도구, 검증 절차를 설계하는 일입니다. 세컨드 브레인은 이 하네스의 핵심 재료가 됩니다. 내가 어떤 답변을 좋은 답변으로 보는지, 어떤 스타일을 선호하는지, 어떤 원칙을 지켜야 하는지 저장해 두기 때문입니다.

    영상에서는 평가의 중요성도 강조됩니다. 세컨드 브레인을 만들었다고 끝나는 것이 아닙니다. 질문을 던져 보고, 답변이 내 생각과 맞는지 확인하고, 부족하면 위키 구조나 검색 방식, 규칙을 계속 고쳐야 합니다. 즉 세컨드 브레인은 한 번 만드는 저장소가 아니라 계속 테스트하고 개선하는 성장 시스템입니다.

    개인과 조직은 무엇부터 시작하면 좋을까요?

    AI 네이티브 로드맵 정리
    출처: 커리어해커 알렉스 YouTube 영상 캡처

    처음부터 거대한 지식 그래프나 복잡한 검색 시스템을 만들 필요는 없습니다. 다음 순서로 시작하면 현실적입니다.

    1. 원본을 버리지 말고 모으기

    회의록, 강의안, 블로그 초안, 프로젝트 회고, 고객 질문, 유튜브 대본처럼 나의 사고가 담긴 자료를 한곳에 모읍니다. 먼저 볼 부분은 원본을 보존하는 것입니다.

    2. 주제별로 작은 Markdown 문서 만들기

    한 문서에 모든 것을 넣기보다 개념 단위로 쪼갭니다. 예를 들어 “세컨드 브레인”, “AI 에이전트”, “하네스 엔지니어링”, “콘텐츠 톤”처럼 다시 활용할 수 있는 단위가 좋습니다.

    3. 링크와 태그로 관계를 남기기

    서로 관련된 문서를 연결합니다. 이 관계가 쌓이면 AI가 단편 정보가 아니라 맥락을 따라가며 답할 수 있습니다.

    4. 에이전트에게 읽히고 검증하기

    “내 글쓰기 스타일로 초안을 만들어줘”, “이 자료를 바탕으로 강의안을 구성해줘”, “내 기준에서 부족한 부분을 찾아줘”처럼 실제 작업에 써 봅니다. 결과가 어색하면 규칙과 자료를 다시 정리합니다.

    세컨드 브레인의 진짜 가치는 복리입니다

    세컨드 브레인은 오늘 하루 생산성을 조금 올리는 도구가 아닙니다. 시간이 지날수록 나의 판단, 취향, 지식, 실패 사례가 쌓이고 연결됩니다. 이 축적물이 AI 에이전트와 결합되면, 매번 처음부터 설명하지 않아도 더 나다운 결과를 만들 수 있습니다.

    결국 AI 네이티브가 된다는 것은 최신 도구를 많이 아는 상태가 아닙니다. 나와 조직의 맥락을 자산화하고, 그 맥락을 AI가 계속 활용할 수 있도록 만드는 상태에 가깝습니다. 모델은 바뀔 수 있지만, 잘 쌓은 세컨드 브레인은 다음 모델에도 가져갈 수 있는 나만의 운영체제가 됩니다.

    함께 읽으면 좋은 글

    FAQ

    세컨드 브레인은 Obsidian을 꼭 써야 만들 수 있나요?

    꼭 그렇지는 않습니다. Obsidian은 Markdown, 백링크, 그래프 뷰가 좋아서 시작하기 편한 도구입니다. 하지만 먼저 볼 부분은 도구가 아니라 AI가 읽고 활용할 수 있는 구조화된 맥락입니다.

    RAG와 LLM Wiki는 무엇이 다른가요?

    RAG는 보통 문서를 잘라 임베딩하고 질문 시점에 관련 조각을 검색해 답변에 넣습니다. LLM Wiki는 원본 자료를 에이전트가 지속적으로 읽고 정리해, 재사용 가능한 위키와 인덱스를 만들어 둔다는 점이 다릅니다.

    세컨드 브레인을 만들 때 가장 먼저 해야 할 일은 무엇인가요?

    원본 자료를 한곳에 모으는 일입니다. 그다음 주제별 Markdown 문서로 쪼개고, 문서 사이의 관계를 링크로 남기는 것이 좋습니다.

    개인 브랜딩에도 세컨드 브레인이 도움이 되나요?

    도움이 됩니다. 자신의 글쓰기 톤, 자주 쓰는 표현, 관점, 콘텐츠 주제를 축적하면 AI가 새로운 글이나 답변을 만들 때 더 일관된 스타일을 유지할 수 있습니다.

    조직에서 세컨드 브레인을 만들면 무엇이 좋아지나요?

    담당자가 자리를 비워도 프로젝트 맥락, 의사결정 기록, 고객 요구, 기술 기준을 에이전트가 참고할 수 있습니다. 지식 이전 비용을 줄이고 반복 업무의 품질을 높이는 데 유리합니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • Hermes Agent Deliverable Mode: AI 산출물을 채팅에서 바로 받는 방법

    Hermes Agent Deliverable Mode: AI 산출물을 채팅에서 바로 받는 방법

    AI 에이전트를 업무에 써 보면 금방 이런 불편을 만납니다. 답변은 채팅창에 잘 나오는데, 실제로 필요한 결과물은 파일입니다. 보고서 PDF, 엑셀 표, 회의 요약 문서, 차트 이미지, 발표 자료처럼 말입니다. 사용자가 파일 경로를 복사하고, 서버에 접속하고, 다시 다운로드해야 한다면 자동화의 장점이 줄어듭니다.

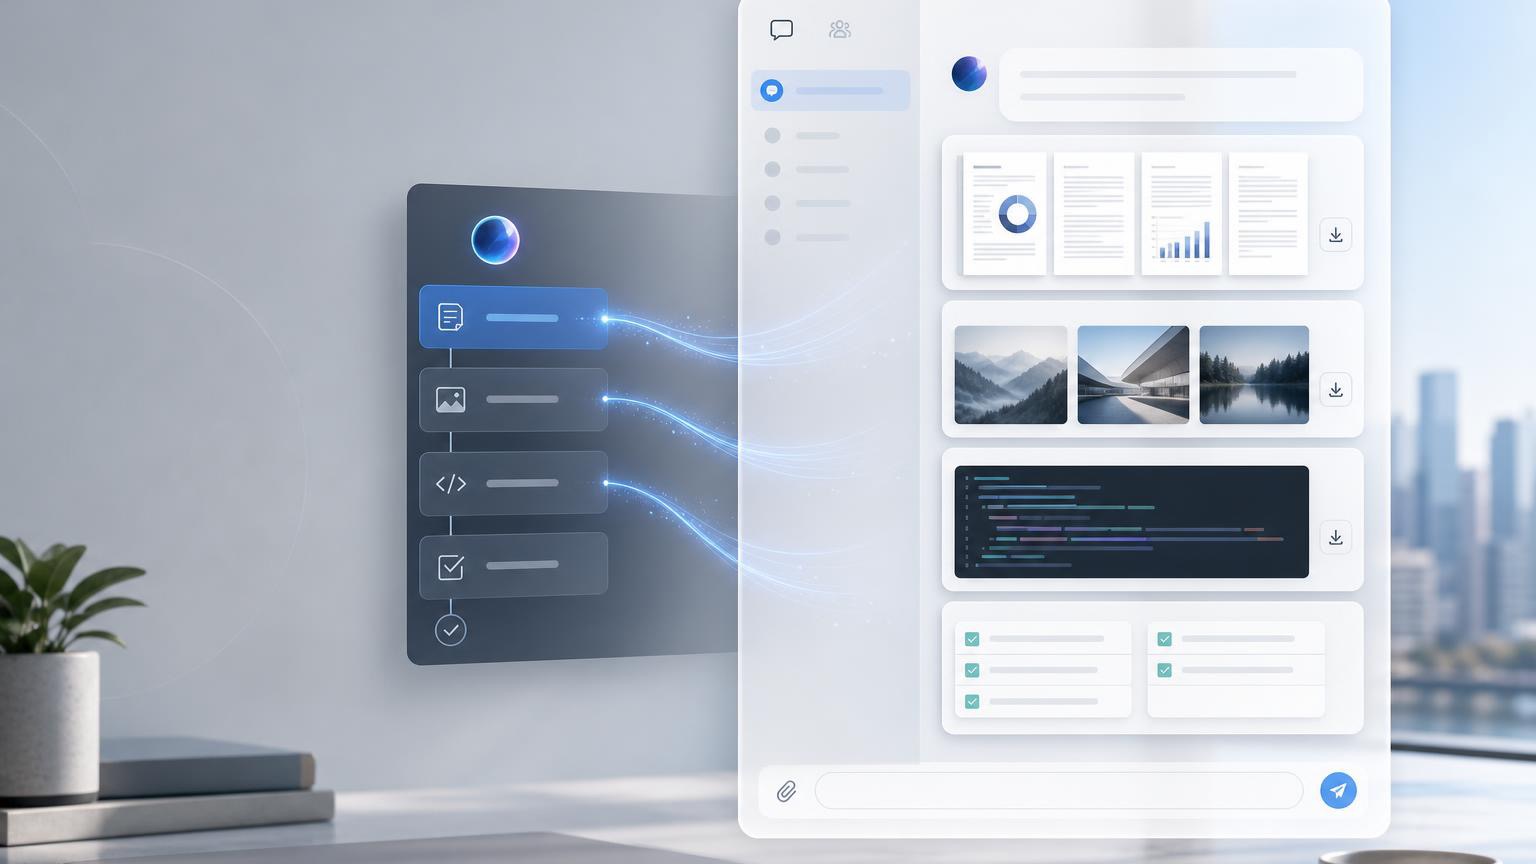
    AI 에이전트 산출물이 채팅 화면으로 전달되는 워크플로우 이미지
    AI 에이전트가 문서, 이미지, 코드 등 산출물을 채팅으로 전달하는 과정을 시각화한 이미지

    Read in English: This article is also available in English for global readers.

    Hermes Agent의 Deliverable Mode는 이 문제를 해결하는 기능입니다. AI가 만든 산출물을 채팅방 안에서 바로 첨부파일로 받을 수 있게 해 줍니다. Slack, Discord, Telegram, WhatsApp, Signal 같은 메시징 환경에서 특히 유용합니다.

    Deliverable Mode란 무엇인가

    Deliverable Mode는 Hermes Agent가 생성한 파일을 사용자가 있는 채팅방으로 직접 보내는 방식입니다. 공식 문서에서는 이를 “Artifacts in Chat”, 즉 채팅 안의 산출물이라고 설명합니다.

    예를 들어 AI에게 “이번 달 매출 데이터를 차트로 만들어 보내 줘”라고 요청했다고 가정해 보겠습니다. 일반적인 자동화라면 AI가 sales-chart.png 같은 임시 파일명를 알려줄 수 있습니다. 사용자는 그 경로를 찾아 파일을 직접 열어야 합니다.

    Deliverable Mode에서는 다릅니다. Hermes Agent가 차트 이미지를 만들고 응답에 파일 경로를 언급하면, 메시징 게이트웨이가 그 경로를 감지합니다. 그리고 화면에는 복잡한 경로를 보여주지 않고, 실제 이미지를 채팅방에 첨부합니다. 사용자는 평소 메신저에서 사진이나 문서를 받듯이 결과물을 확인하면 됩니다.

    초보자를 위한 핵심 개념 세 가지

    Deliverable Mode를 이해하려면 세 가지 개념만 알면 됩니다.

    1. 산출물은 “AI가 만든 파일”이다

    여기서 산출물은 단순 텍스트 답변이 아닙니다. AI가 도구를 사용해 만든 실제 파일입니다. 예를 들면 이렇게 볼 수 있습니다.

    • 매출 추이를 보여주는 PNG 차트
    • 분석 결과를 정리한 PDF 보고서
    • 원자료를 정리한 CSV 또는 XLSX 파일
    • 회의 내용을 요약한 Markdown 문서
    • 발표용 PPTX 파일
    • 음성 안내용 MP3 파일

    Claude의 Artifacts 기능도 비슷한 문제의식에서 출발합니다. 아이디어를 앱, 시각화, 문서 같은 독립 콘텐츠로 만들고 별도 공간에서 다룰 수 있게 합니다. Hermes Agent의 Deliverable Mode는 여기에 “메신저 첨부파일 전달”이라는 실무 흐름을 더한 형태로 이해하면 쉽습니다.

    2. 게이트웨이는 “메신저와 AI 사이의 배달원”이다

    Hermes Agent는 CLI에서도 쓸 수 있지만, Telegram이나 Slack 같은 메신저에서도 사용할 수 있습니다. 이때 중간에서 메시지를 주고받는 구성요소가 게이트웨이입니다.

    게이트웨이는 AI의 응답을 읽고, 그 안에 지원되는 파일 경로가 있는지 확인합니다. report.pdf 또는 result.png 같은 파일명 예시가 여기에 해당합니다. 조건에 맞는 파일이면 게이트웨이가 해당 파일을 채팅방에 업로드합니다.

    중요한 점은 코드 예시는 보호된다는 것입니다. 공식 문서에 따르면 코드 블록이나 인라인 코드 안의 경로는 무시됩니다. 그래서 설명용 코드가 실수로 첨부파일 처리되는 일을 줄일 수 있습니다.
    3. 플랫폼별로 파일 표시 방식이 다르다

    이미지는 보통 채팅창 안에 바로 보입니다. 동영상도 플랫폼이 지원하면 인라인으로 표시됩니다. 오디오는 음성 또는 오디오 첨부로 전달됩니다. PDF, 워드, 엑셀, CSV, ZIP 같은 파일은 다운로드 가능한 첨부파일로 올라갑니다.

    Slack 개발 문서에서도 파일은 단순 메시지보다 더 복잡한 정보를 담는 메시지의 확장 형태로 설명됩니다. Telegram Bot API 역시 문서, 사진, 오디오 등 파일 유형별 전송 메서드를 제공합니다. Deliverable Mode는 이런 플랫폼의 파일 전송 능력을 Hermes Agent의 작업 결과와 연결해 주는 기능입니다.

    어떤 파일을 보낼 수 있나

    공식 문서 기준으로 Deliverable Mode는 다음 파일 유형을 지원합니다.

    유형확장자 예시전달 방식
    이미지.png, .jpg, .jpeg, .gif, .webp, .bmp, .tiff, .svg인라인 이미지
    동영상.mp4, .mov, .avi, .mkv, .webm인라인 또는 첨부
    오디오.mp3, .wav, .ogg, .m4a, .flac음성/오디오 첨부
    문서.pdf, .docx, .doc, .odt, .rtf, .txt, .md파일 첨부
    데이터.xlsx, .xls, .csv, .tsv, .json, .xml, .yaml, .yml파일 첨부
    발표자료.pptx, .ppt, .odp파일 첨부
    압축파일.zip, .tar, .gz, .tgz, .bz2, .7z파일 첨부
    웹 문서.html, .htm파일 첨부

    반대로 .py, .log 같은 소스 코드나 로그 파일은 의도적으로 제외됩니다. AI가 실수로 내부 코드나 로그를 자동 전송하지 않게 하기 위한 안전장치로 볼 수 있습니다. 코드를 보내야 한다면 파일 경로가 아니라 코드 블록으로 전달하는 편이 안전합니다.
    실제로 어떻게 작동하나

    작동 과정은 생각보다 단순합니다.

    1. Hermes Agent가 도구를 사용해 파일을 생성합니다. 2. 응답 문장 안에 생성된 파일의 절대 경로를 plain text로 언급합니다. 3. 게이트웨이가 그 경로와 확장자를 스캔합니다. 4. 지원되는 파일이면 경로 문구를 사용자 화면에서 제거합니다. 5. 해당 파일을 Slack, Telegram, Discord 같은 플랫폼의 기본 첨부파일로 업로드합니다.

    이 구조의 장점은 사용자가 별도 명령을 몰라도 된다는 점입니다. AI가 파일을 만들고 경로를 응답에 포함하기만 하면 됩니다. 공식 문서도 별도의 MEDIA: 태그를 쓰지 않아도 된다고 설명합니다.

    언제 특히 유용한가

    Deliverable Mode는 “답변”보다 “결과물”이 중요한 업무에서 빛을 발합니다.

    데이터 분석 결과 공유

    팀장이 Telegram에서 “지난주 판매 데이터를 정리해서 차트와 엑셀로 보내 줘”라고 요청할 수 있습니다. Hermes Agent는 Python으로 차트를 만들고, CSV나 XLSX 파일을 생성한 뒤, 채팅방에 이미지와 스프레드시트를 바로 보낼 수 있습니다.
    보고서 자동 생성

    주간 업무 보고, 서버 점검 결과, SEO 감사 결과처럼 일정한 형식의 문서를 PDF로 만들 수 있습니다. 사용자는 채팅방에서 바로 다운로드해 공유하면 됩니다.
    발표자료와 문서 초안 전달

    PowerPoint 스킬이나 문서 생성 도구와 연결하면 PPTX, DOCX, Markdown 초안을 받을 수 있습니다. 특히 모바일에서 지시하고 PC에서 파일을 내려받아 이어 작업하는 흐름에 잘 맞습니다.
    백그라운드 작업 완료 알림

    Hermes의 Kanban 멀티 에이전트 워크플로에서도 산출물이 완료 알림과 함께 전달될 수 있습니다. 작업자가 차트와 보고서를 만들고 kanban_complete 호출에 파일 경로를 포함하면, 완료 메시지와 산출물이 같은 채팅방에 도착합니다.

    설정할 때 기억할 점

    Deliverable Mode는 AI가 자동으로 항상 파일을 만들도록 강제하는 기능은 아닙니다. AI에게 산출물을 만들도록 요청해야 합니다.

    예를 들면 다음처럼 지시할 수 있습니다.

    • “결과를 표로 정리하고 CSV 파일도 함께 보내 줘.”
    • “분석 내용을 PDF 보고서로 만들어 Telegram에 첨부해 줘.”
    • “비교 결과를 차트 이미지로 렌더링해서 보내 줘.”
    • “회의록을 Markdown 파일로 저장하고 첨부해 줘.”

    프로젝트 단위로 자주 쓰려면 AGENTS.md, CLAUDE.md, .cursorrules 같은 프로젝트 지침에 “메시징 플랫폼에서는 가능한 경우 차트, 표, 보고서를 파일 산출물로 제공하라”는 식의 규칙을 넣을 수 있습니다. 전역 지침을 쓰는 경우에는 Hermes 설정의 agent.custom_instructions에 반영할 수도 있습니다.

    MCP와 함께 쓰면 확장성이 커진다

    공식 문서는 Deliverable Mode와 함께 MCP도 언급합니다. MCP는 Model Context Protocol의 약자입니다. 쉽게 말하면 AI 앱이 외부 도구와 데이터를 연결하기 위한 표준 인터페이스입니다.

    예를 들어 Notion, GitHub, Linear, Slack, Gmail, Salesforce, BigQuery, Google Drive 같은 서비스와 연결할 수 있습니다. Deliverable Mode가 “완성된 파일을 사용자에게 전달하는 출구”라면, MCP는 “작업에 필요한 데이터와 서비스에 접근하는 입구”에 가깝습니다.

    두 기능을 함께 쓰면 흐름이 자연스러워집니다. AI가 Google Drive에서 자료를 찾고, BigQuery에서 데이터를 조회하고, Python으로 차트를 만들고, 최종 보고서를 Slack에 첨부하는 식입니다.

    보안과 실무 주의사항

    파일을 자동으로 보내는 기능은 편리하지만, 몇 가지 주의점이 있습니다.

    첫째, 민감한 파일 경로를 응답에 노출하지 않도록 해야 합니다. 게이트웨이가 경로를 제거해 첨부파일로 바꾸더라도, 파일 이름과 내용은 사용자에게 전달됩니다. 고객 정보, API 키, 내부 로그가 포함된 파일은 만들지 않는 것이 기본입니다.

    둘째, 소스 코드나 로그 파일이 기본 지원 대상에서 제외된 이유를 이해해야 합니다. 모든 파일을 자동 전송하면 편리해 보이지만, 실수로 민감한 개발 자료가 전달될 수 있습니다. 필요한 경우에는 의도적으로 안전한 문서 형식으로 정리해서 보내는 편이 좋습니다.

    셋째, 파일이 실제로 존재해야 합니다. Kanban 완료 알림의 경우 파일이 디스크에 없으면 조용히 건너뛰어진다고 공식 문서가 설명합니다. 자동화 워크플로를 만들 때는 파일 생성 위치와 권한을 체크해 두세요.

    초보자를 위한 활용 체크리스트

    Deliverable Mode를 처음 쓴다면 아래 순서로 점검하면 됩니다.

    1. Hermes Agent를 메신저 게이트웨이에서 사용하고 있는가? 2. AI에게 텍스트 답변이 아니라 파일 산출물을 명시적으로 요청했는가? 3. 생성할 파일 형식이 지원 확장자 목록에 있는가? 4. 파일 경로가 코드 블록 안이 아니라 일반 응답 문장에 들어가는가? 5. 파일 내용에 개인정보, API 키, 내부 로그가 섞이지 않았는가? 6. Slack, Telegram, Discord 등 사용하는 플랫폼이 해당 파일 유형 업로드를 지원하는가? 7. 반복 업무라면 프로젝트 지침이나 커스텀 인스트럭션에 산출물 선호를 적었는가?

    기존 AI 도구의 Artifacts와 무엇이 다른가

    Claude Artifacts는 독립적인 콘텐츠를 별도 창에서 보고 수정하는 경험에 가깝습니다. 앱, 문서, 시각화, 코드 결과물을 대화 옆에서 다루게 해 줍니다.

    Hermes Agent의 Deliverable Mode는 채팅 기반 운영에 더 가깝습니다. 파일을 만든 뒤 사용자가 실제로 일하는 Slack, Telegram, Discord 스레드에 첨부합니다. 그래서 “AI와 같이 편집한다”보다 “AI가 작업을 끝내고 결과물을 납품한다”는 표현이 더 잘 맞습니다.

    Perplexity Computer의 Slack 통합도 비슷한 사용자 경험을 제공합니다. Hermes Agent 공식 문서는 차트, PDF, 슬라이드 같은 결과물을 Slack 스레드에 첨부하는 패턴을 비교 대상으로 설명합니다. 차이는 Hermes Agent가 사용자의 로컬 가상환경이나 샌드박스에서 파일을 만들고, 토큰은 사용자의 환경에 보관한다는 점입니다.

    정리: Deliverable Mode는 AI 자동화의 마지막 1미터를 줄인다

    AI 자동화에서 중요한 것은 답을 생성하는 능력만이 아닙니다. 사람이 실제로 사용할 수 있는 형태로 결과물을 전달하는 능력도 더 봐야 합니다. Deliverable Mode는 이 마지막 단계를 줄여 줍니다.

    차트는 이미지로, 보고서는 PDF로, 데이터는 엑셀이나 CSV로, 발표자료는 PPTX로 채팅방에 바로 도착합니다. 사용자는 서버 경로나 임시 폴더를 몰라도 됩니다. 업무 지시는 채팅으로 하고, 결과물도 채팅에서 받는 구조가 됩니다.

    AI 에이전트를 개인 비서나 업무 자동화 도구로 쓰고 싶다면 Deliverable Mode를 꼭 이해해 두는 것이 좋습니다. 특히 Slack, Telegram, Discord를 업무 허브로 쓰는 팀이라면 작은 자동화부터 적용해 볼 만합니다.

    함께 읽으면 좋은 글

    FAQ

    Deliverable Mode를 쓰려면 코딩을 알아야 하나요?

    기본 사용에는 코딩 지식이 많이 필요하지 않습니다. “차트 이미지로 보내 줘”, “PDF 보고서로 만들어 줘”처럼 원하는 산출물을 명확히 요청하면 됩니다. 주의할 점은 반복 자동화를 만들거나 특정 파일 형식을 고정하려면 프로젝트 지침을 다루는 정도의 이해가 도움이 됩니다.

    모든 채팅 플랫폼에서 똑같이 보이나요?

    아닙니다. Slack, Telegram, Discord, WhatsApp, Signal은 파일 업로드와 미리보기 방식이 다릅니다. Hermes Agent는 파일 유형에 맞춰 첨부를 시도하지만, 실제 표시 방식은 플랫폼 기능에 따라 달라질 수 있습니다.

    파일 경로가 사용자에게 그대로 보이나요?

    공식 문서 기준으로 게이트웨이는 지원되는 파일 경로를 감지한 뒤 visible message에서 제거하고 파일을 업로드합니다. 그래서 사용자는 보통 경로 대신 첨부파일을 보게 됩니다. 단, 코드 블록이나 인라인 코드 안의 경로는 무시됩니다.

    왜 .py나 .log 파일은 자동 첨부 대상이 아닌가요?

    소스 코드와 로그에는 민감한 정보가 들어갈 수 있습니다. Hermes Agent는 이런 파일이 의도치 않게 전송되는 위험을 줄이기 위해 일부 확장자를 제외합니다. 코드는 코드 블록으로 공유하고, 로그는 필요한 부분만 정리한 문서로 만드는 편이 안전합니다.

    MCP와 Deliverable Mode는 같은 기능인가요?

    아닙니다. MCP는 AI가 외부 서비스와 데이터를 연결하는 표준에 가깝습니다. Deliverable Mode는 만들어진 파일을 채팅방에 전달하는 기능입니다. 함께 쓰면 외부 데이터 수집부터 최종 파일 전달까지 하나의 자동화 흐름으로 만들 수 있습니다.

    참고자료

  • AI 도구를 하나로 묶는 Agent OS 구축법: 7단계 블루프린트

    AI 도구를 하나로 묶는 Agent OS 구축법: 7단계 블루프린트

    AI 도구를 많이 쓰는데도 생산성이 크게 오르지 않는다면, 문제는 모델 성능이 아닐 수 있습니다. ChatGPT, Claude, Gemini, Hermes, Codex 같은 도구를 각각 열어 쓰면서 매번 같은 맥락을 설명하고, 결과물은 폴더와 채팅창 사이에 흩어지기 때문입니다.

    Julian Goldie의 영상 How to Build Your Own Agent Operating System은 이 문제를 “AI 문제가 아니라 시스템 문제”로 봅니다. 먼저 볼 부분은 개별 도구를 더 많이 구독하는 것이 아니라, AI 에이전트가 공통 메모리와 작업공간을 공유하는 개인용 Agent OS를 만드는 것입니다.

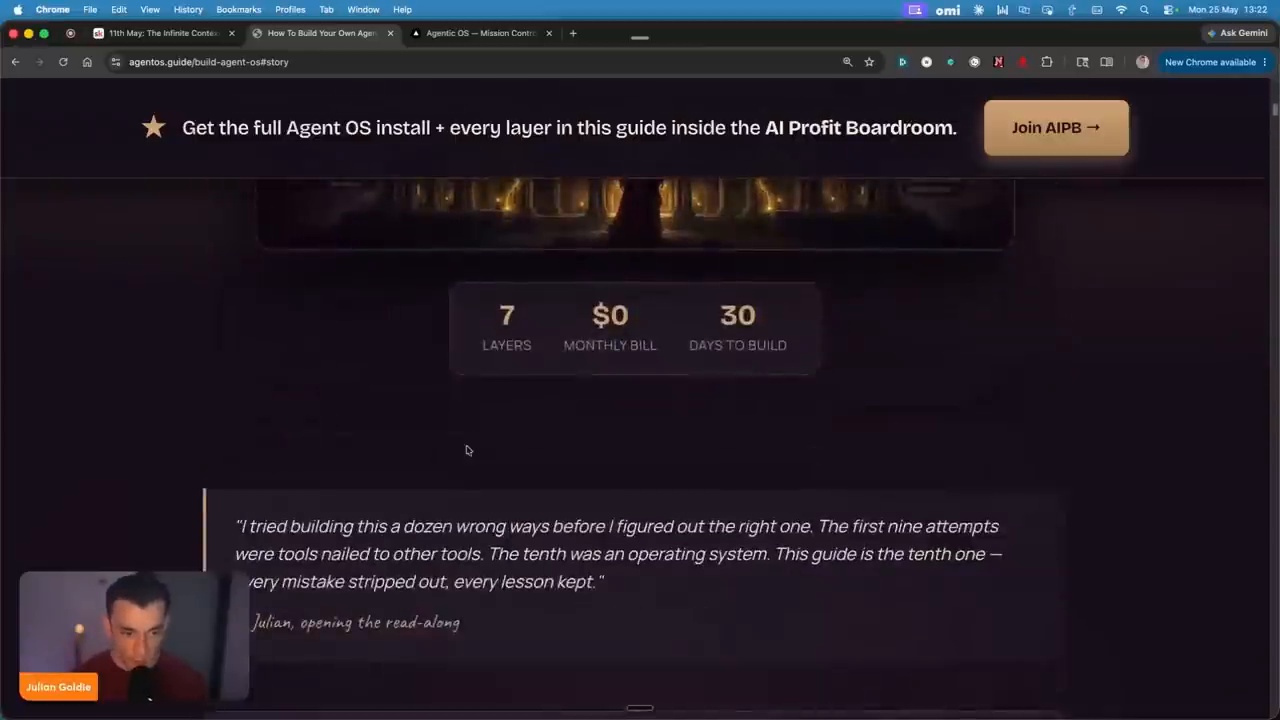
    여러 AI 에이전트를 한 화면에서 관리하는 Mission Control 예시
    여러 AI 에이전트를 한 화면에서 관리하는 Mission Control 예시

    Read in English: This article is also available in English for global readers.

    Agent OS란 무엇인가?

    Agent OS는 여러 AI 도구를 하나의 작업 운영체제처럼 묶는 구조입니다. 여기서 운영체제라는 말은 Windows나 macOS 같은 전통적 OS를 뜻하기보다, AI가 일하는 데 필요한 공통 기반을 뜻합니다.

    예를 들면 다음 요소가 한 시스템 안에 들어갑니다.

    • 사용자의 목표, 브랜드 보이스, 프로젝트 정보를 저장하는 메모리
    • 여러 모델과 에이전트를 호출하는 실행 계층
    • 작업 현황과 결과물을 볼 수 있는 대시보드
    • 블로그, 이미지, 영상, 리서치 등 실제 결과물을 만드는 생산 공간
    • 결과물을 다시 메모리에 저장하는 피드백 루프

    이 구조가 없으면 AI 도구를 많이 써도 매번 새 채팅에서 다시 시작합니다. 반대로 Agent OS가 있으면 에이전트가 이전 작업과 저장된 지식을 읽고 다음 작업에 이어 붙일 수 있습니다.

    왜 개별 AI 도구만으로는 부족한가?

    영상의 첫 문제 제기는 명확합니다. 많은 사용자가 10개 안팎의 AI 도구를 오가지만, 정작 결과물은 잃어버리고 컨텍스트는 반복 입력합니다. 좋은 모델을 쓰고 있어도 작업 시스템이 없으면 사용자가 병목이 됩니다.

    개별 도구 중심의 방식에는 네 가지 한계가 있습니다.

    • 도구마다 기록과 결과물이 분리됩니다.
    • 새 채팅을 열 때마다 프로젝트 설명을 반복해야 합니다.
    • 이미지, 글, 코드, 요약 파일이 한곳에 모이지 않습니다.
    • 새로운 AI 도구가 나올 때마다 워크플로가 다시 흔들립니다.

    그래서 영상은 “AI를 기존의 망가진 워크플로에 붙이면 더 복잡해진다”고 설명합니다. 먼저 작업 시스템을 만들고, 그 안에 AI 도구를 끼워 넣어야 한다는 뜻입니다.

    관련해서 AI 에이전트가 실제 업무 방식에 미치는 변화는 AI 에이전트와 피지컬 AI, 이제 ‘행동하는 AI’가 온다에서도 함께 볼 수 있습니다.

    Agent OS의 7개 레이어

    영상은 Agent OS를 일곱 개 레이어로 설명합니다. 아래에서 위로 쌓는 구조이며, 앞단을 건너뛰면 뒤의 자동화가 불안정해집니다.

    Agent OS의 7단계 구조: Foundation부터 Loop까지
    Agent OS의 7단계 구조: Foundation부터 Loop까지

    1. Foundation: 하드웨어와 기본 환경

    첫 레이어는 노트북, 운영체제, 로컬 작업공간입니다. 영상은 고급 장비가 필수는 아니라고 말합니다. 먼저 볼 부분은 AI 결과물이 저장되고 실행될 안정적인 기본 환경입니다.

    2. Memory: 장기 기억 저장소

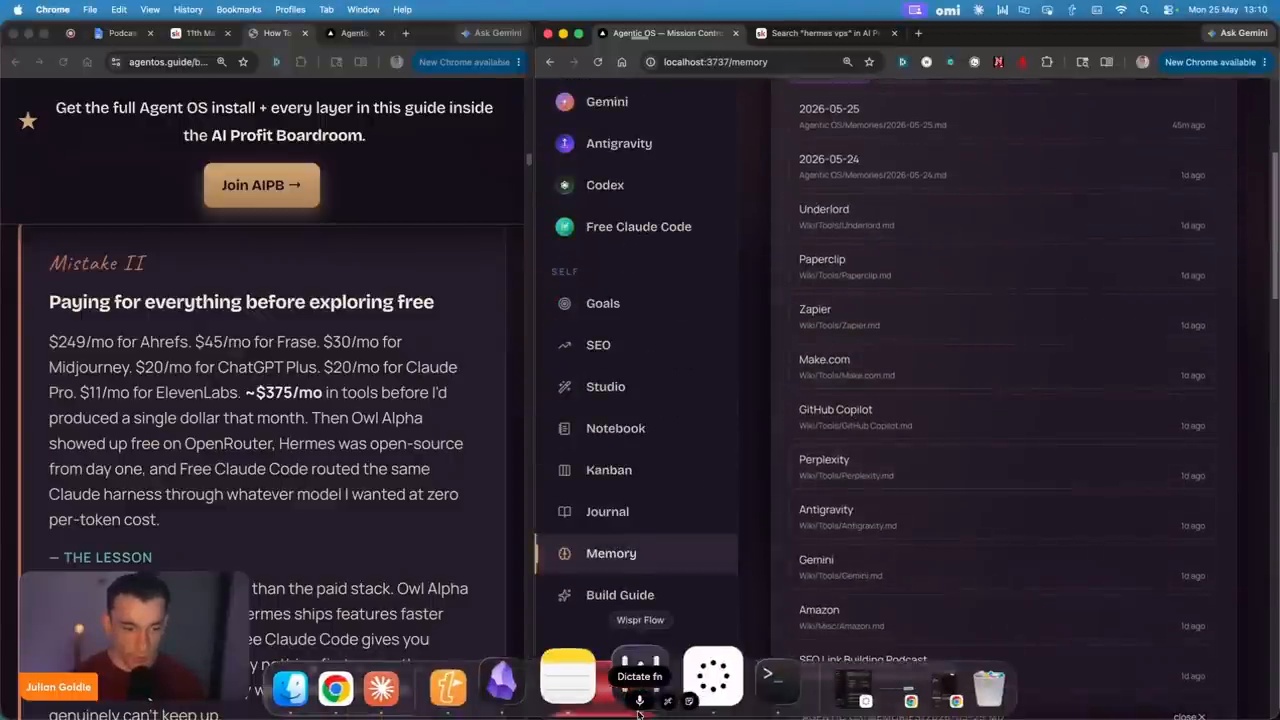
    두 번째 레이어가 가장 더 봐야 합니다. Obsidian 같은 로컬 Markdown 기반 도구를 AI의 Second Brain으로 쓰면, 여러 에이전트가 같은 지식 저장소를 읽고 업데이트할 수 있습니다.

    Agent OS의 핵심인 Obsidian 기반 메모리 레이어
    Agent OS의 핵심인 Obsidian 기반 메모리 레이어

    한 가지 조심할 점은 Obsidian은 “완전한 오픈소스”라기보다 개인 사용자가 무료로 시작할 수 있는 로컬 Markdown 노트 도구로 이해하는 편이 안전합니다. 여러 에이전트가 같은 vault를 수정할 때는 파일 충돌과 동기화 규칙도 해야 합니다.

    3. Brain: 모델 라우팅 계층

    Brain 레이어는 Grok, Gemini, Claude, OpenRouter 같은 모델을 상황에 맞게 고르는 계층입니다. 영상은 모델을 엔진에 비유합니다. 엔진이 좋아도 차체와 운전 시스템이 없으면 성능을 제대로 쓰기 어렵다는 뜻입니다.

    4. Agents: 실제 작업자

    Agents 레이어는 Hermes, Claude Code, Codex 같은 실행형 에이전트를 배치하는 부분입니다. 단순 챗봇이 아니라 파일을 읽고, 코드를 수정하고, 문서를 만들고, 작업 결과를 저장하는 단위입니다.

    이 흐름은 하네스 엔지니어링이 온다: AI 에이전트를 제대로 일하게 만드는 법과도 연결됩니다. 에이전트의 성능은 프롬프트만이 아니라 실행 환경, 검증 루프, 작업 지시 구조에 의해 결정됩니다.

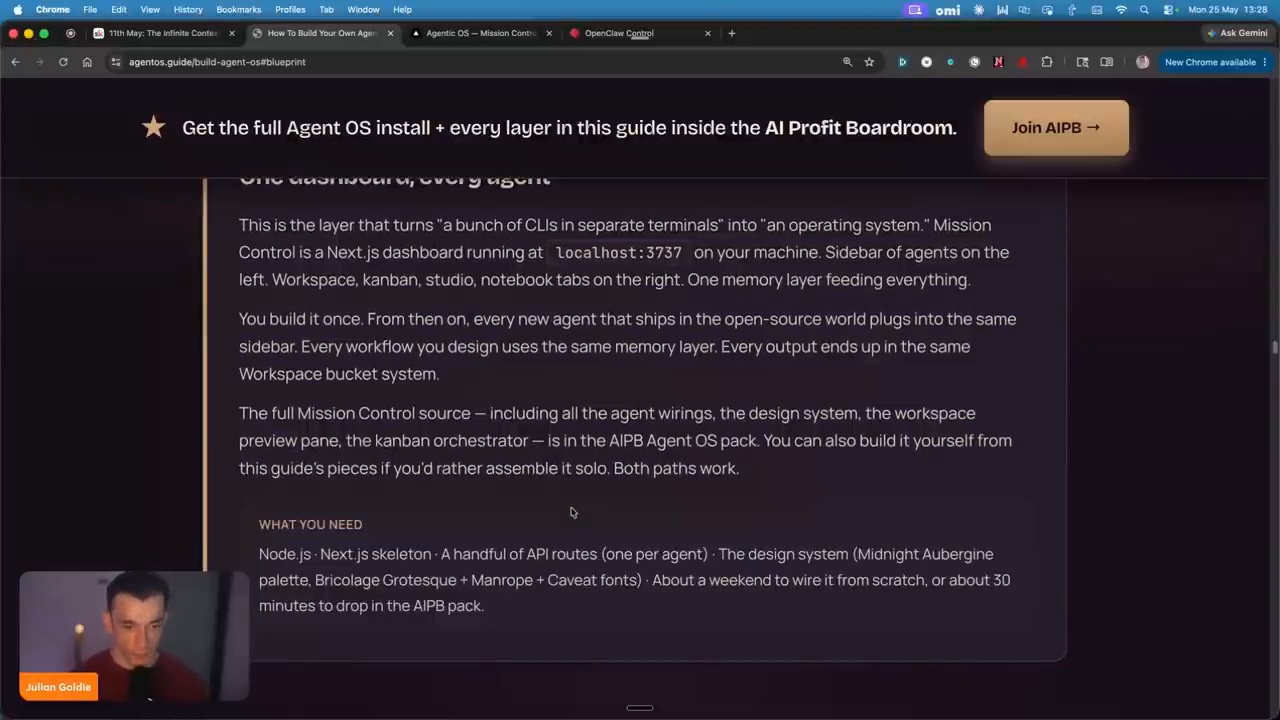
    5. Command Center: 통합 대시보드

    Command Center는 여러 CLI, 에이전트, 결과물을 한 화면에서 관리하는 미션 컨트롤입니다. 영상에서는 Next.js 기반 대시보드 예시를 보여주며, 작업 결과물을 미리 보고 검색할 수 있는 구조를 강조합니다.

    6. Production Services: 실제 생산 공간

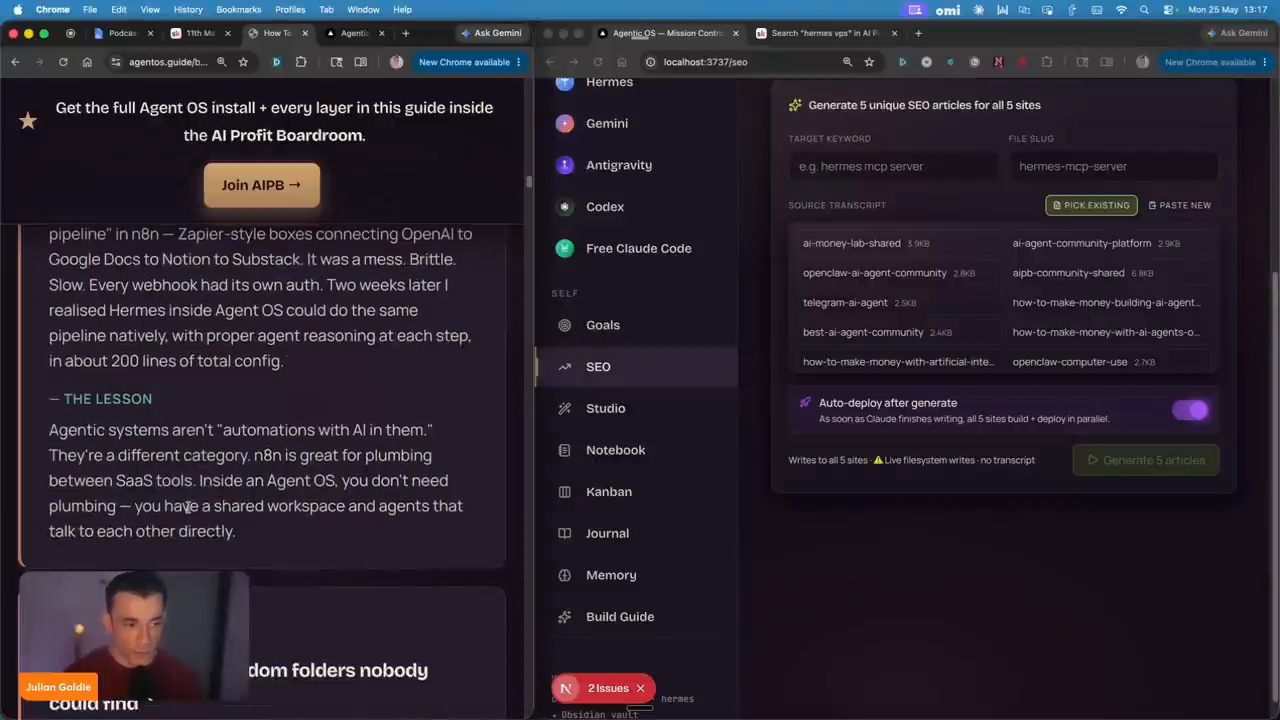
    여섯 번째 레이어는 SEO 글쓰기, 이미지 생성, 영상 제작, Kanban, NotebookLM 요약처럼 실제 결과물이 만들어지는 서비스 영역입니다. 블로거라면 키워드 리서치, 초안 작성, 이미지 정리, 발행 기록까지 이 레이어에 넣을 수 있습니다.

    SEO 콘텐츠 제작을 Agent OS 안에서 처리하는 예시
    SEO 콘텐츠 제작을 Agent OS 안에서 처리하는 예시

    7. Loop: 결과를 다시 기억으로 돌려보내기

    마지막 레이어는 피드백 루프입니다. AI가 만든 글, 코드, 이미지, 요약, 발행 기록을 다시 메모리에 저장해야 다음 작업이 더 똑똑해집니다. 단발성 프롬프트가 아니라 누적되는 작업 시스템이 되는 지점입니다.

    Agent OS 구축에서 피해야 할 5가지 실수

    영상은 여러 번의 실패 끝에 얻은 교훈을 소개합니다. 실무적으로는 다음 다섯 가지를 조심하면 됩니다.

    1. AI를 시스템이 아니라 도구로만 보는 것

    ChatGPT, Claude, Gemini 중 무엇이 더 좋은지만 비교하면 구조가 남지 않습니다. 먼저 “내 작업은 어디에 저장되고, 누가 읽고, 어떤 기준으로 검증되는가”를 정해야 합니다.

    2. 무료 구조를 검토하기 전에 구독부터 늘리는 것

    유료 도구가 필요할 수는 있습니다. 하지만 메모리, 파일 정리, 대시보드, 자동화 규칙 없이 구독만 늘리면 비용과 복잡도만 증가합니다.

    3. 앱 내부 메모리에만 의존하는 것

    각 AI 서비스의 메모리는 편리하지만, 다른 에이전트가 공유하기 어렵습니다. 브랜드 보이스, 고객 정보, 프로젝트 목표처럼 반복 사용되는 정보는 별도 지식 저장소에 두는 편이 안정적입니다.

    4. 모든 자동화를 n8n이나 Zapier로만 만들려는 것

    n8n과 Zapier는 API 연결과 정형 자동화에 강합니다. 한 가지 조심할 점은 모든 것을 webhook과 OAuth 흐름으로 엮으면 유지보수 부담이 커질 수 있습니다. Agent OS는 에이전트가 같은 작업공간 안에서 직접 파일을 읽고 쓰는 구조를 더 강조합니다.

    5. 생성물을 랜덤 폴더에 방치하는 것

    AI가 만든 앱, 이미지, 영상, 블로그 초안이 흩어지면 재사용할 수 없습니다. 결과물에는 반드시 “집”이 있어야 합니다.

    AI가 만든 앱, 이미지, 영상 등을 다시 찾을 수 있는 작업공간
    AI가 만든 앱, 이미지, 영상 등을 다시 찾을 수 있는 작업공간

    블로거와 SEO 실무자는 어떻게 적용할 수 있나?

    Agent OS의 가치는 개발자에게만 있지 않습니다. 블로그와 SEO 운영에서는 오히려 더 직접적입니다.

    먼저 키워드 리서치 결과, 발행 URL, 타깃 독자, 내부 링크 후보, 성과 메모를 Obsidian이나 LLM Wiki 같은 저장소에 누적합니다. 다음 글을 쓸 때 AI가 이 정보를 읽으면 주제 중복을 줄이고 내부 링크를 더 정확하게 제안할 수 있습니다.

    두 번째로 글 작성 과정을 서비스화합니다. 예를 들어 “유튜브 자막 아카이브 → 대표 프레임 캡처 → SEO 초안 → WordPress 업로드 → Yoast 검증 → 28일 후 성과 점검”을 하나의 반복 가능한 파이프라인으로 만들 수 있습니다.

    세 번째로 발행 후 결과를 다시 저장합니다. 어떤 제목이 클릭을 만들었는지, 어떤 FAQ가 검색 유입에 도움이 됐는지, 어떤 내부 링크가 효과적이었는지를 남겨야 다음 글의 품질이 올라갑니다.

    AI 기반 콘텐츠 제작의 개발 방식 변화는 에이전틱 엔지니어링: 안드레이 카파시가 말한 바이브 코딩 이후의 개발 방식과 함께 보면 이해가 쉽습니다. Obsidian을 자동화 허브로 쓰는 사례는 Antigravity CLI Obsidian 자동화 글도 참고할 만합니다.

    개인용 Agent OS 시작 체크리스트

    처음부터 거대한 대시보드를 만들 필요는 없습니다. 작은 루프부터 시작하는 것이 안전합니다.

    • 현재 쓰는 AI 도구 목록을 적습니다.
    • 반복 작업을 세 가지로 줄입니다. 예: 블로그 작성, 리서치 요약, 이미지 정리.
    • 공통 메모리 저장소를 하나 정합니다.
    • 프로젝트 목표, 독자, 브랜드 톤, 자주 쓰는 프롬프트를 문서화합니다.
    • 결과물 폴더 규칙을 정합니다.
    • AI 에이전트가 읽어도 되는 파일과 안 되는 파일을 구분합니다.
    • 작업이 끝날 때마다 요약과 산출물 링크를 메모리에 남깁니다.
    • 자동화는 한 번에 하나씩 붙입니다.

    가장 먼저 만들 것은 “완전 자동화”가 아니라 “잃어버리지 않는 작업 시스템”입니다. 기억하고, 찾고, 이어서 할 수 있는 구조가 생긴 뒤에 자동화의 효과가 커집니다.

    주의할 점: Agent OS가 만능은 아니다

    영상에는 유료 커뮤니티와 교육 프로그램 소개도 포함되어 있습니다. 그래서 “주말 안에 누구나 완성한다”거나 “모델이 10배 유용해진다”는 식의 표현은 화자의 주장으로 이해해야 합니다.

    또한 화면과 음성을 기록하는 도구를 메모리 레이어에 연결할 때는 개인정보와 보안 이슈를 먼저 체크해 두세요. 회사 자료, 고객 정보, 미공개 기획이 AI 메모리에 들어간다면 접근 권한과 저장 위치를 명확히 정해야 합니다.

    Agent OS의 먼저 볼 부분은 도구를 많이 붙이는 것이 아닙니다. 어떤 정보를 기억할지, 어떤 작업을 자동화할지, 어떤 결과를 다시 학습 자산으로 남길지 정하는 운영 원칙입니다.

    FAQ

    Agent OS는 개발자만 만들 수 있나요?

    개발자가 아니어도 작은 형태로 시작할 수 있습니다. 한 가지 조심할 점은 터미널, 로컬 파일, API, Markdown 기반 노트에 대한 기본 이해가 있으면 훨씬 수월합니다.

    Agent OS 구축에 꼭 유료 AI 도구가 필요한가요?

    반드시 그렇지는 않습니다. 영상도 무료 도구를 먼저 검토하라고 강조합니다. Obsidian, 무료 모델, 오픈소스 에이전트, 로컬 폴더 규칙만으로도 기본 구조를 만들 수 있습니다.

    Obsidian을 메모리 레이어로 쓰는 이유는 무엇인가요?

    Obsidian은 로컬 Markdown 파일을 기반으로 하기 때문에 사람이 읽기 쉽고, 여러 에이전트가 파일 단위로 접근하기 쉽습니다. AI가 이전 작업과 프로젝트 맥락을 다시 읽게 만드는 데 유리합니다.

    n8n 자동화와 Agent OS는 어떻게 다른가요?

    n8n은 도구와 API를 연결하는 자동화 플랫폼에 가깝습니다. Agent OS는 메모리, 에이전트, 대시보드, 결과물 저장, 피드백 루프를 하나의 작업 시스템으로 묶는 개념입니다. 둘은 경쟁 관계라기보다 역할이 다릅니다.

    여러 AI 에이전트가 같은 메모리를 공유해도 되나요?

    가능하지만 규칙이 해야 합니다. 같은 vault나 작업 폴더를 동시에 수정하면 충돌이 생길 수 있습니다. 쓰기 권한, 파일명 규칙, 백업, 동기화 방식을 먼저 정해야 합니다.

    마무리

    AI 생산성을 높이는 다음 단계는 더 많은 도구를 구독하는 것이 아닙니다. 흩어진 도구를 하나의 메모리와 작업공간, 검증 루프로 묶는 것입니다.

    Agent OS는 거창한 개발 프로젝트로 시작하지 않아도 됩니다. 먼저 반복 작업 하나를 고르고, 그 작업의 입력·메모리·결과물·피드백을 한 폴더와 한 규칙으로 묶어 보세요. 그 작은 루프가 개인용 AI 운영체제의 출발점입니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • Claude 소상공인 Skill, 챗봇을 넘어 업무 자동화 도구가 되다

    Claude 소상공인 Skill, 챗봇을 넘어 업무 자동화 도구가 되다

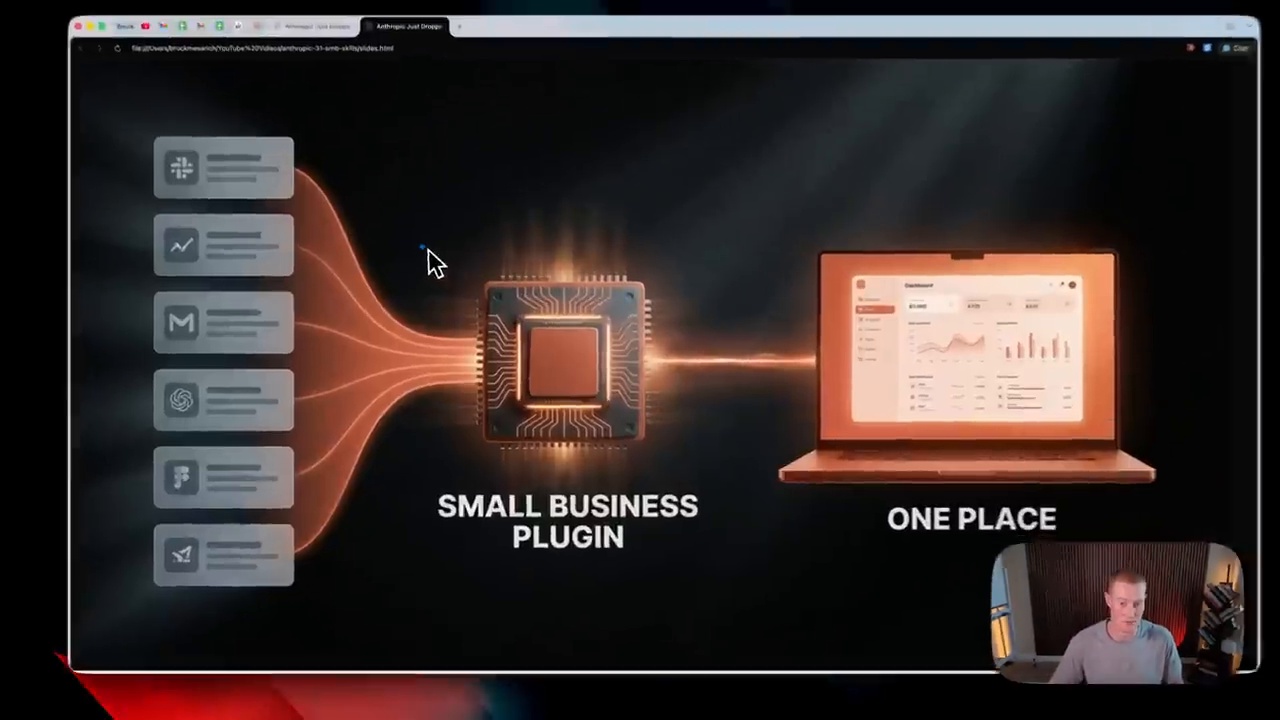
    Claude가 그냥 질문에 답하는 도구에서 벗어나고 있습니다. Anthropic이 공개한 소상공인용 Small Business 플러그인은 그 변화를 꽤 선명하게 보입니다. 영상에서 소개된 31개 Skill은 회계, 이메일, 일정, 채용, 고객관리처럼 작은 조직이 매일 처리해야 하는 일을 하나의 실행 흐름으로 묶습니다.

    Claude 소상공인 Skill 플러그인 개요
    영상 캡처: Brock Mesarich | AI for Non Techies YouTube 영상, 소상공인용 Skill 플러그인 소개 장면.

    Claude 소상공인 Skill이 중요한 이유

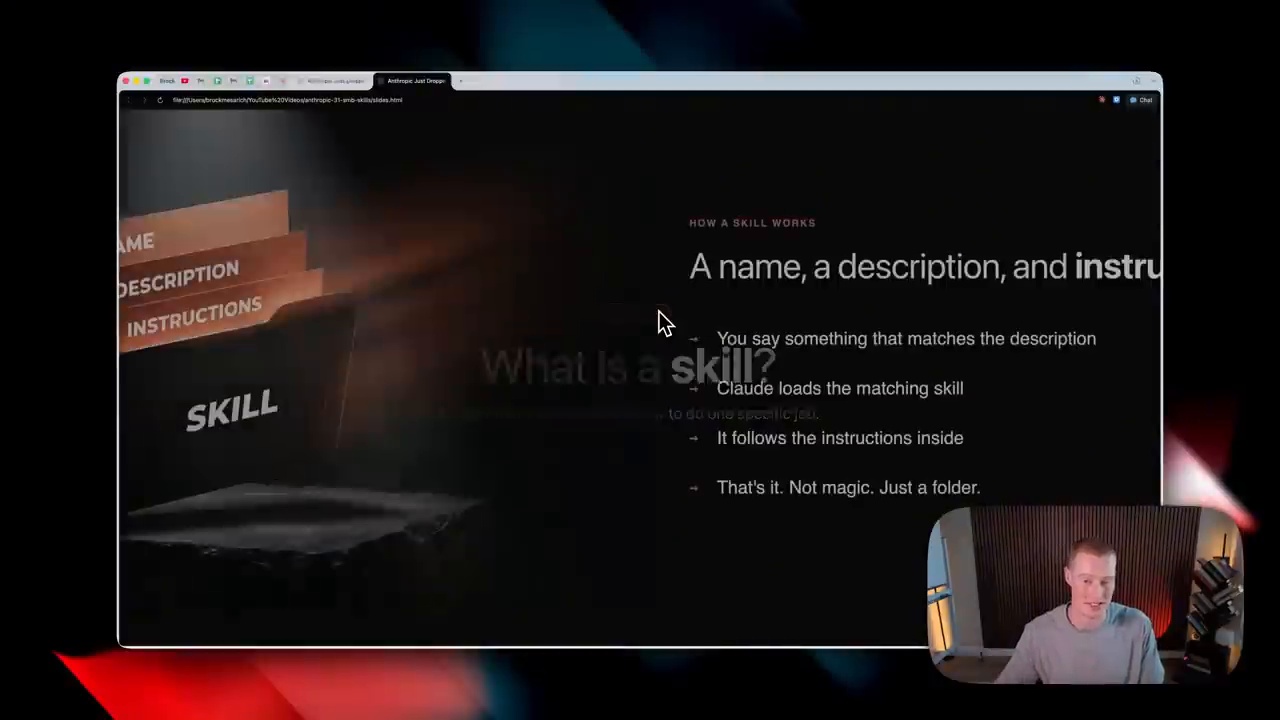
    Claude 소상공인 Skill의 먼저 볼 부분은 “프롬프트를 잘 쓰는 법”이 아니라 “업무 절차를 저장해 반복 실행하는 법”입니다. 진행자 Brock Mesarich는 Skill을 이름, 설명, 세부 지시문이 들어 있는 워크플로우 패키지로 설명합니다. 사용자는 매번 긴 지시문을 다시 쓰지 않고, 정해 둔 Skill 이름만 불러 업무를 시작할 수 있습니다.

    이 구조는 소상공인에게 특히 더 봐야 합니다. 작은 조직은 회계 담당자, 영업 담당자, 채용 담당자가 분리되어 있지 않은 경우가 많습니다. 대표나 실무자가 QuickBooks, Stripe, Gmail, Slack, Google Calendar 같은 도구를 오가며 하루를 시작합니다. Claude Skill은 이 흩어진 확인 작업을 하나의 브리핑이나 문서 생성 흐름으로 압축합니다.

    Claude 소상공인 Skill - Claude Skill 구조 설명
    영상 캡처: Skill은 이름, 설명, 지시문으로 구성된 반복 업무 실행 단위로 설명됩니다.

    Business Pulse: 하루 업무를 한 장의 브리핑으로 묶다

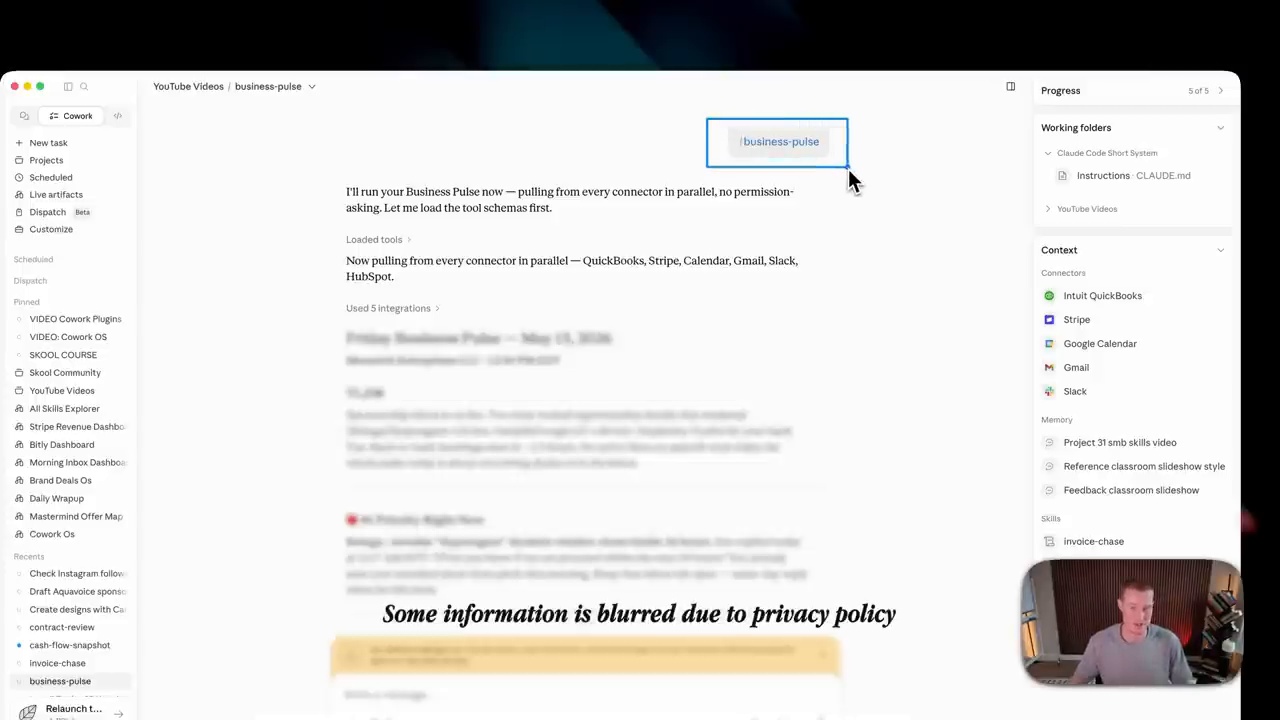
    영상에서 가장 먼저 강조한 사례는 Business Pulse입니다. 이 Skill은 QuickBooks, Stripe, PayPal, Square, HubSpot, Google Calendar, Gmail, Slack, Microsoft Teams 같은 연결 앱에서 정보를 동시에 가져옵니다. 그리고 오늘의 일정, 이메일 우선순위, 현금 흐름, 매출 신호, 팀 커뮤니케이션 상황을 하나의 사업 현황 요약으로 바꿉니다.

    작은 조직의 아침 점검을 줄이는 방식

    소상공인 입장에서 이 기능은 단순한 요약보다 더 큽니다. 매일 아침 “입금은 되었나”, “오늘 미팅은 무엇인가”, “급한 고객 메일은 있는가”, “팀 메시지에서 놓친 건 없는가”를 따로 확인하는 시간을 줄일 수 있기 때문입니다. AI가 모든 결정을 대신한다기보다, 사람이 판단해야 할 우선순위를 먼저 정리해 주는 비서에 가깝습니다.

    Claude 소상공인 Skill - Business Pulse 실행 예시
    영상 캡처: 여러 업무 앱의 정보를 모아 사업 현황과 우선순위를 요약하는 Business Pulse 예시.

    Invoice Chase: 미수금 관리가 자동화되는 지점

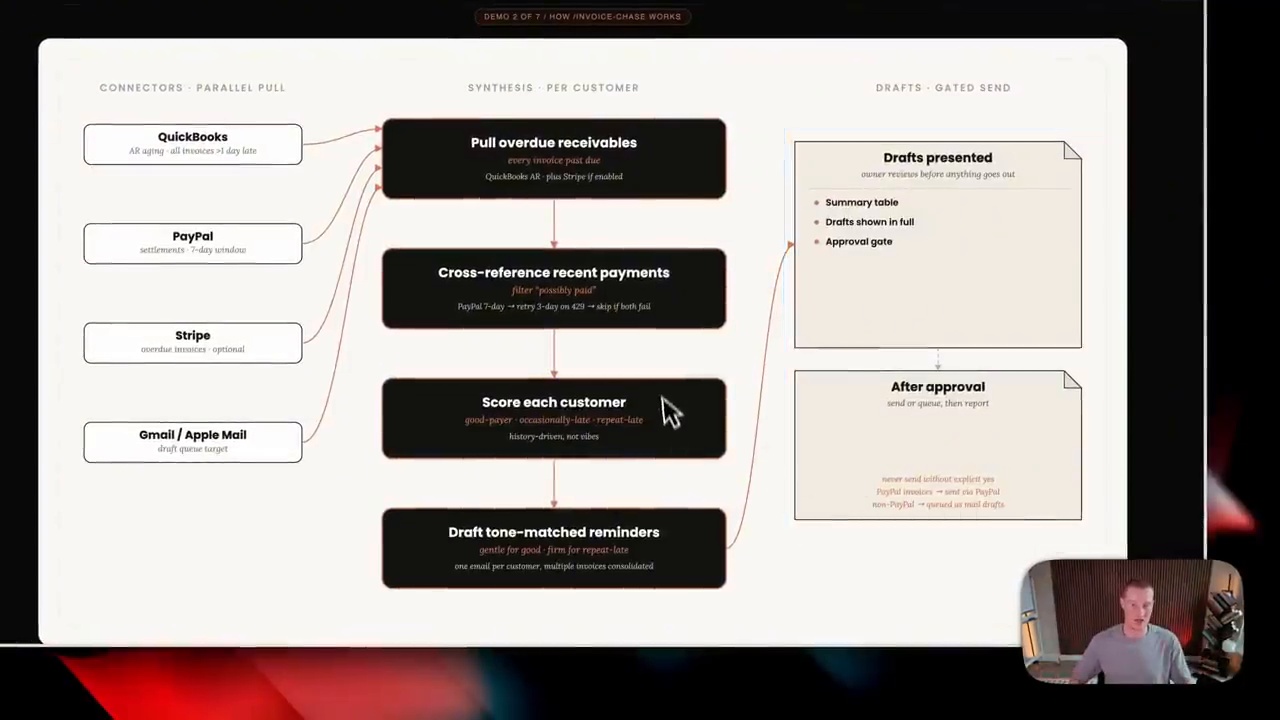
    두 번째로 실용적인 예시는 Invoice Chase입니다. 이 Skill은 QuickBooks나 Stripe에서 연체 인보이스를 확인하고, 고객별 결제 이력과 미수금 상태를 정리합니다. 이후 Gmail에 독촉 메일 초안을 만들 수 있습니다.

    자동 메일보다 중요한 것은 데이터 연결

    여기서 중요한 점은 “AI가 메일 문구를 예쁘게 쓴다”가 아닙니다. 실제 결제 데이터와 고객 이력을 참고해 어떤 고객에게 어떤 톤으로 후속 조치를 할지 판단하도록 돕는다는 점입니다. 미수금은 작은 회사의 현금 흐름에 직접 영향을 주기 때문에, 이 흐름이 안정되면 운영 리스크를 줄이는 효과가 있습니다.

    Claude 소상공인 Skill - Invoice Chase 실행 예시
    영상 캡처: Stripe와 QuickBooks 데이터를 바탕으로 미수금과 후속 메일 초안을 정리하는 장면.

    Job Post Builder: 채용 업무도 패킷으로 만든다

    세 번째 사례는 Job Post Builder입니다. 사용자가 역할명, 근무 방식, 보상, 후보자 조건 같은 정보를 입력하면 Claude가 채용 공고, 인터뷰 가이드, 평가 루브릭, 제안서 또는 계약서 초안을 만들어 줍니다.

    채용 문서의 일관성을 확보하는 효과

    소규모 조직은 채용 공고와 면접 기준이 즉흥적으로 만들어지는 경우가 많습니다. Job Post Builder는 채용의 각 단계를 문서화해 팀원이 같은 기준으로 후보자를 볼 수 있게 합니다. 특히 인터뷰 가이드와 평가 루브릭은 단순한 문서 생성보다 의사결정 품질을 높이는 데 도움이 됩니다.

    앱 커넥터와 MCP가 만드는 실행형 AI

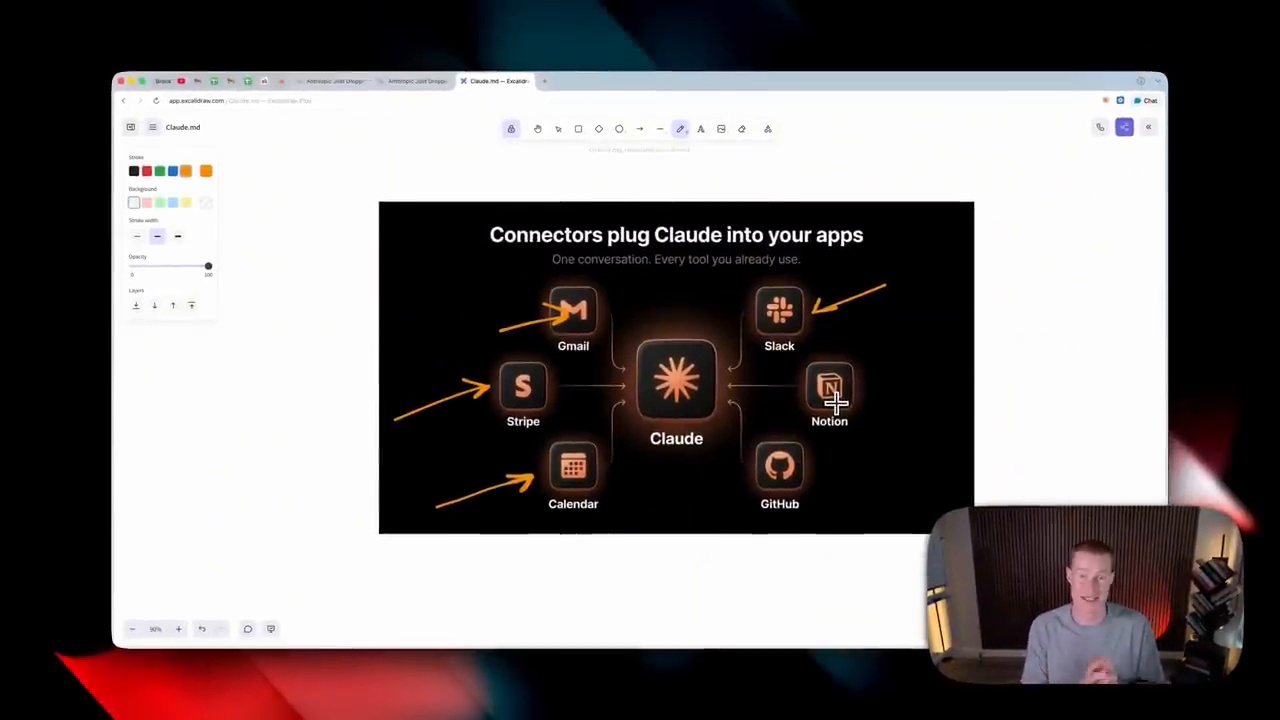
    영상 후반부는 커넥터 연결에 초점을 둡니다. Claude Co-work에서 Gmail, Slack, Notion, DocuSign, QuickBooks, Stripe 같은 앱을 연결하고, Zapier MCP를 통해 Claude가 직접 지원하지 않는 앱까지 확장하는 방식입니다.

    Claude 소상공인 Skill - 앱 커넥터 연결
    영상 캡처: Claude Co-work에서 커넥터와 Zapier MCP를 통해 외부 앱을 연결하는 흐름.

    이 장면은 AI 도입의 방향을 잘 보입니다. 앞으로의 AI는 “답변을 잘하는 챗봇”만으로 평가되지 않습니다. 어떤 앱에 접근할 수 있는지, 어떤 권한으로 자료를 읽고 쓸 수 있는지, 반복 업무를 얼마나 안전하게 실행할 수 있는지가 더 더 봐야 합니다.

    도입 전에 확인해야 할 보안과 권한 문제

    Claude 소상공인 Skill은 매력적이지만, 무작정 연결하면 안 됩니다. QuickBooks, Stripe, Gmail, Slack에는 재무 정보, 고객 정보, 계약 정보, 내부 대화가 들어 있습니다. Skill을 쓰기 전에는 연결 앱의 권한 범위, 자동 생성 문서의 승인 절차, 민감 정보 처리 기준을 먼저 정해야 합니다.

    사람의 검토를 남겨야 하는 업무

    특히 결제 독촉 메일, 계약서, 채용 제안서처럼 외부로 나가는 문서는 사람이 최종 체크해 두세요. AI가 초안을 만들고 데이터를 정리하는 것은 유용하지만, 법적 책임과 고객 관계는 여전히 사업자의 영역입니다.

    소상공인이 얻을 수 있는 실제 효과

    Claude 소상공인 Skill이 보여주는 가치는 세 가지입니다. 첫째, 반복 확인 업무를 줄입니다. 둘째, 흩어진 앱의 데이터를 하나의 업무 맥락으로 묶습니다. 셋째, 업무 매뉴얼을 Skill 형태로 저장해 같은 품질로 반복 실행할 수 있게 합니다.

    작은 회사에 필요한 것은 거대한 AI 프로젝트가 아닐 수 있습니다. 매일 아침 확인해야 하는 것, 매주 반복되는 청구와 채용 문서, 고객 응대 초안처럼 작지만 자주 발생하는 업무부터 Skill로 바꾸는 것이 현실적인 출발점입니다.

    FAQ

    Claude 소상공인 Skill은 무엇인가요?

    Claude 소상공인 Skill은 Claude Co-work에서 반복 업무를 실행하기 위한 업무 자동화 지시문 묶음입니다. 회계, 일정, 이메일, 채용, 고객관리 같은 앱과 연결하면 실제 업무 흐름을 더 빠르게 처리할 수 있습니다.

    일반 프롬프트와 Skill은 어떻게 다른가요?

    일반 프롬프트는 매번 사용자가 직접 지시를 작성해야 합니다. Skill은 이름, 설명, 실행 절차가 저장되어 있어 같은 업무를 반복적으로 호출할 수 있습니다.

    소상공인이 바로 도입해도 괜찮을까요?

    도입 자체는 가능하지만, 연결 앱의 권한 범위와 검토 절차를 먼저 정해야 합니다. 특히 결제, 계약, 채용, 고객 메일처럼 외부 이해관계자에게 영향을 주는 업무는 사람의 최종 확인이 해야 합니다.

    참고자료

    함께 읽으면 좋은 글

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.

  • AI 스킬 만들기, 파일 3개로 시작하는 Claude·GPT 업무 자동화

    AI 스킬 만들기, 파일 3개로 시작하는 Claude·GPT 업무 자동화

    반복 업무를 AI에게 맡길 때마다 같은 설명을 다시 쓰고 있다면, 문제는 프롬프트 길이가 아니라 업무 구조일 수 있습니다. AI 스킬 만들기는 “좋은 문장 하나”를 찾는 일이 아니라, AI가 반복해서 꺼내 쓸 수 있는 업무 매뉴얼과 자료 묶음을 만드는 일에 가깝습니다.

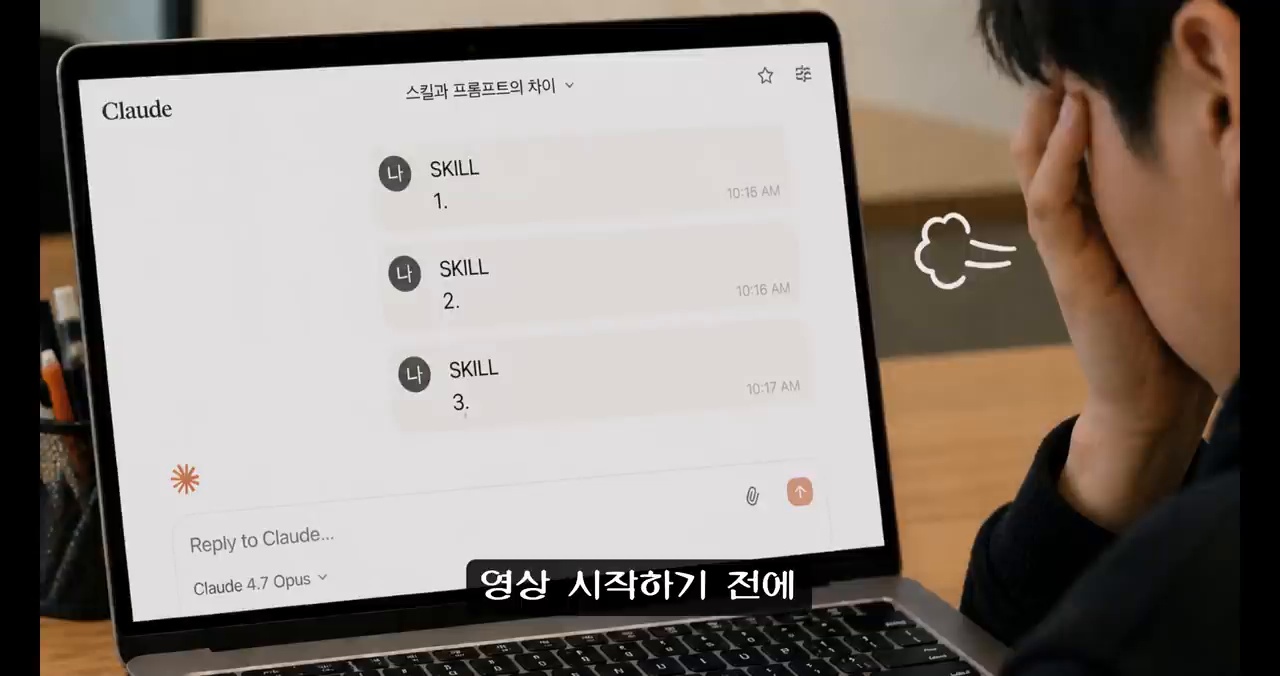
    AI 스킬 만들기 핵심 질문: 프롬프트와 스킬은 무엇이 다른가
    출처: SURVIVAL AI 유튜브 영상 캡처. 프롬프트와 스킬의 차이를 설명하는 도입 장면입니다.

    AI 스킬 만들기는 프롬프트를 ‘업무 패키지’로 바꾸는 과정입니다

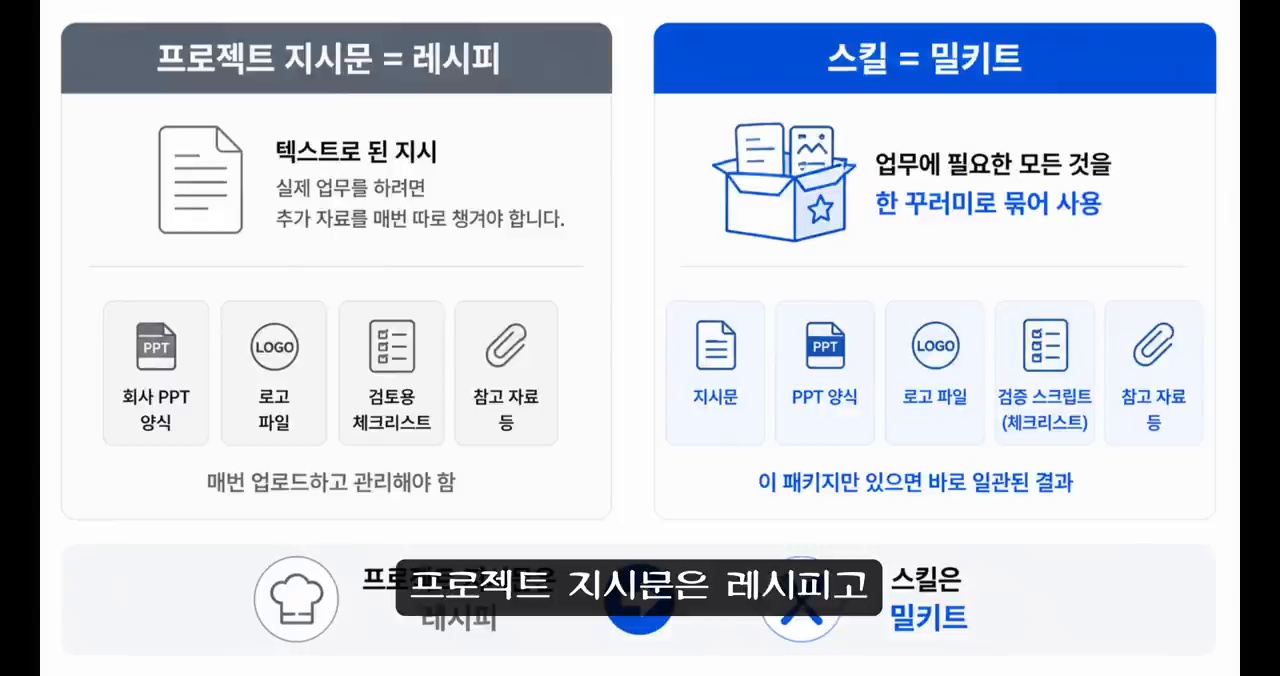
    영상의 핵심 비유는 명확합니다. 프로젝트 지시문은 레시피이고, 스킬은 밀키트입니다. 레시피만 있으면 요리 순서는 알 수 있지만 재료, 도구, 계량 기준은 따로 준비해야 합니다. 밀키트는 레시피와 재료, 필요한 도구와 기준이 한 묶음으로 들어 있습니다.

    AI 업무에서도 같은 차이가 생깁니다. 프로젝트 지시문은 특정 프로젝트 안에서 반복 지시를 적용하는 방식입니다. 반면 스킬은 대화창에서 해당 업무를 요청했을 때 AI가 알아서 관련 절차와 참고자료를 불러와 실행하도록 만드는 패키지입니다.

    프로젝트 지시문과 스킬의 차이

    프로젝트 지시문은 “이 프로젝트에서는 이렇게 일해”라는 텍스트 규칙에 가깝습니다. 회의록 정리 방식, 컨설팅 PPT 작성 방식, 보고서 구조를 프로젝트 안에 넣어두면 그 공간에서는 반복적으로 작동합니다.

    스킬은 범위가 다릅니다. 핵심 지시문뿐 아니라 참고자료, 템플릿, 검증 스크립트까지 함께 묶을 수 있습니다. 그래서 “이렇게 써라”가에 그치지 않고 “이 자료를 참고하고, 이 순서로 처리하고, 마지막에 이 기준으로 점검하라”까지 포함할 수 있습니다.

    AI 스킬 만들기 비유: 프로젝트 지시문은 레시피, 스킬은 밀키트
    프로젝트 지시문과 스킬의 차이를 레시피와 밀키트로 설명하는 장면입니다.

    왜 지금 AI 스킬이 중요해졌을까

    초기 AI는 질문 하나에 답 하나를 주는 챗봇에 가까웠습니다. 이메일 문장을 다듬거나 번역하거나 아이디어를 묻는 방식이 중심이었습니다.

    지금의 AI는 다릅니다. 여러 단계를 연결하고, 외부 시스템과 연동하고, 중간 판단을 하며, 사용자가 자리를 비운 동안에도 작업 흐름을 이어갈 수 있습니다. 이 변화 때문에 “질문을 예쁘게 쓰는 능력”만으로는 부족해졌습니다.

    프롬프트 엔지니어링의 역할도 바뀌었습니다

    AI의 언어 이해력이 좋아지면서 어설픈 표현도 어느 정도는 AI가 보정합니다. 하지만 좋은 결과가 자동으로 보장되는 것은 아닙니다. 먼저 볼 부분은 AI가 어떤 목표와 기준으로 판단해야 하는지 구조화하는 능력입니다.

    예를 들어 “이 주식 오를까?”라고 묻는 것과 “손실을 최소화하는 진입 전략을 세우고, 위험 신호와 분할 매수 기준을 제시하라”고 지시하는 것은 완전히 다른 결과를 만듭니다. 스킬은 이런 구조화된 판단 기준을 반복 가능한 형태로 저장하는 장치입니다.

    좋은 AI 스킬의 기본 구조

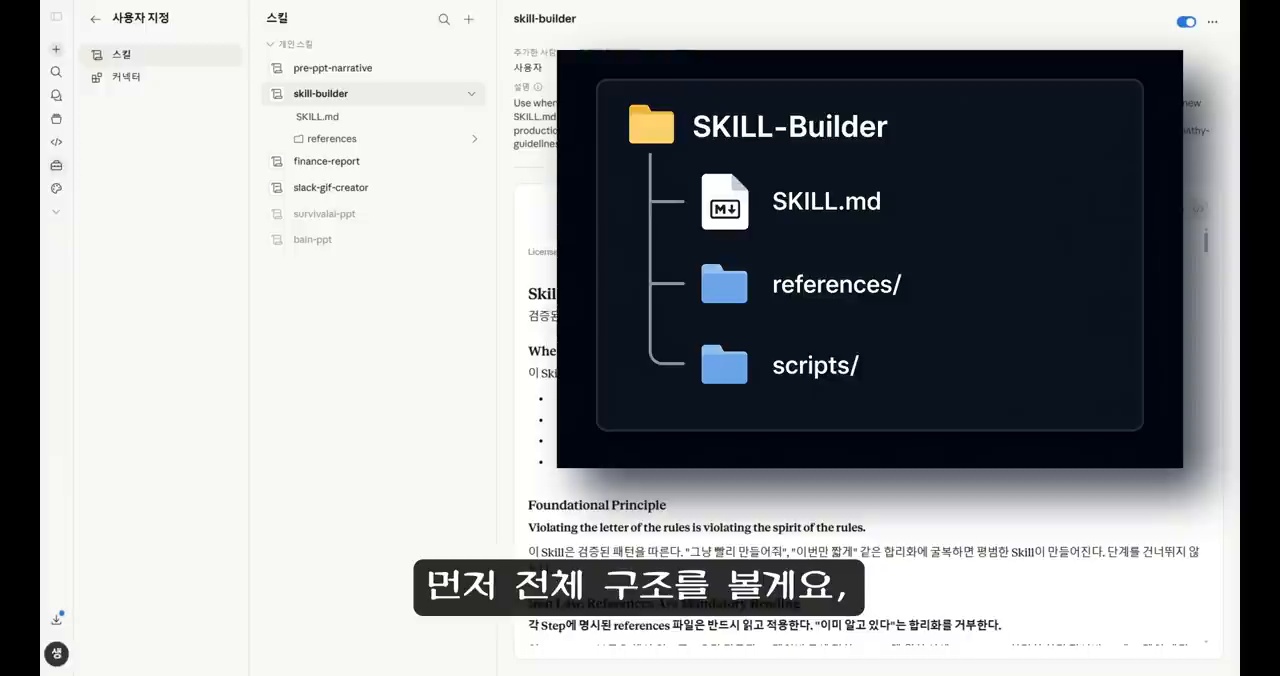
    영상에서 소개한 기본 구조는 단순합니다. 최상위 폴더 안에 핵심 파일인 SKILL.md가 있고, 필요에 따라 references/와 scripts/ 폴더를 둡니다. 파일이 3개 또는 3개 영역으로 정리된다는 설명은 바로 이 구조를 말합니다.

    AI 스킬 만들기 기본 구조: SKILL.md, references, scripts
    스킬 폴더와 핵심 파일 구조를 설명하는 장면입니다.

    SKILL.md는 스킬의 실행 설명서입니다

    SKILL.md는 스킬의 중심입니다. 언제 이 스킬을 써야 하는지, 어떤 순서로 작업해야 하는지, 어떤 결과물을 만들어야 하는지, 마지막에 무엇을 검증해야 하는지가 들어갑니다.

    이 파일 하나만 있어도 스킬은 작동할 수 있습니다. 주의할 점은 모든 내용을 한 파일에 몰아넣으면 AI가 중요한 지시를 놓칠 수 있습니다. 그래서 핵심 절차는 SKILL.md에 두고, 길고 세부적인 자료는 별도 폴더로 분리하는 것이 좋습니다.

    references는 필요할 때 꺼내 읽는 지식 창고입니다

    references/는 매번 읽을 필요는 없지만 특정 단계에서 참고해야 하는 문서를 보관하는 곳입니다. 예를 들어 도메인별 작성 패턴, 검토 기준, 예시 문서, 설치 가이드 등을 넣을 수 있습니다.

    먼저 볼 부분은 “필요할 때만 읽게 만드는 것”입니다. AI에게 항상 모든 자료를 읽게 하면 지시가 길어지고 집중도가 떨어질 수 있습니다. 반대로 필요한 순간에 정확한 참고자료를 열게 하면 결과의 일관성이 높아집니다.

    scripts는 반복 결과를 고정하는 자동화 도구입니다

    scripts/는 말로 지시하면 매번 달라지는 작업을 코드로 고정하는 영역입니다. 영상에서는 라면 끓이는 기계를 예로 듭니다. 사람이 말로만 지시하면 매번 조금씩 다르게 만들지만, 기계에 순서와 시간을 입력하면 결과가 일정해집니다.

    업무에서도 마찬가지입니다. PPT 색상과 위치, 파일 변환, 데이터 검증, 표준 포맷 검사처럼 결과가 일정해야 하는 작업은 스크립트로 고정하는 편이 좋습니다.

    스킬 생성기는 질문부터 시작해야 합니다

    좋은 스킬은 사용자의 요구를 먼저 확인합니다. AI가 성능이 좋아질수록 애매한 요청도 알아서 처리하려고 하지만, 업무 스킬은 오히려 단계별 확인이 더 봐야 합니다.

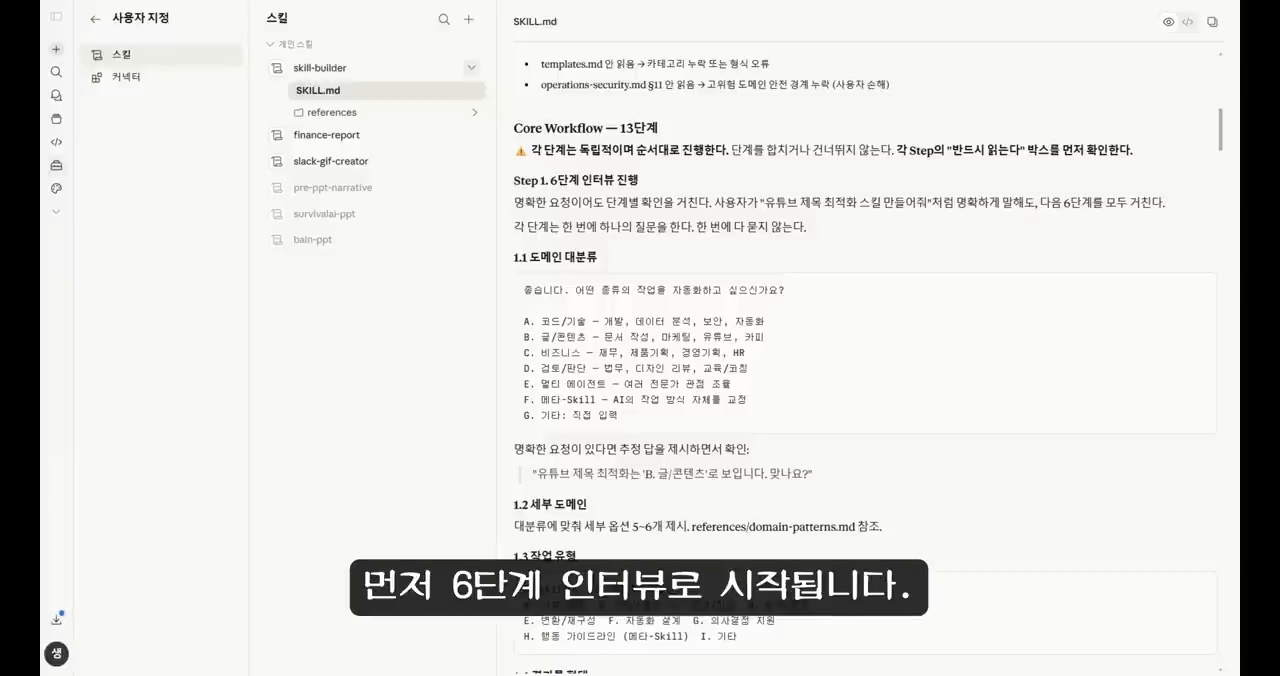
    영상의 예시인 스킬 생성기는 6단계 인터뷰로 시작합니다. 도메인을 확인하고, 세부 도메인을 분류하고, 고위험 영역인지 판단한 뒤, 스킬 이름과 설명, 워크플로우, 검토 기준을 차례로 정리합니다.

    AI 스킬 만들기 절차: 인터뷰 기반 스킬 생성 워크플로우
    스킬 생성기가 요구사항을 단계별로 확인하는 흐름을 설명하는 장면입니다.

    고위험 도메인은 사람 검토를 포함해야 합니다

    법무, 계약, 채용, 보안처럼 실수의 비용이 큰 영역은 AI가 그럴듯한 결과를 만들더라도 최종 검토가 해야 합니다. 좋은 스킬은 이런 위험을 숨기지 않습니다.

    오히려 “이 단계에서는 사람 검토가 필요하다”, “이 결과는 참고용이며 최종 판단은 담당자가 해야 한다”처럼 책임 경계를 명시해야 합니다. 그래야 스킬이 업무 효율을 높이면서도 위험을 키우지 않습니다.

    Claude와 GPT/Codex에서 스킬을 만드는 방법

    영상에서는 Claude와 GPT/Codex 양쪽의 실전 생성 방법도 소개합니다. Claude에서는 사용자 지정 메뉴의 스킬 영역에서 업로드하거나, Claude와 대화하며 스킬을 만들 수 있습니다. GPT/Codex에서는 스킬 및 앱 메뉴, 또는 스킬 크리에이터 흐름을 사용할 수 있습니다.

    Claude와 GPT Codex에서 AI 스킬 만들기 실전 메뉴
    Claude와 GPT/Codex에서 스킬을 생성하거나 업로드하는 방법을 안내하는 장면입니다.

    업로드보다 먼저 볼 부분은 검토입니다

    AI가 만들어 준 스킬이 보기에는 그럴듯해도, 그 분야를 전혀 모르면 좋은 스킬인지 판단하기 어렵습니다. 그래서 최소한 해당 업무의 기본 언어와 흐름은 알아야 합니다.

    좋은 방법은 이미 공개된 우수한 스킬이나 워크플로우를 참고하는 것입니다. GitHub나 공식 예시에서 비슷한 분야의 구조를 살펴보고, 내 업무에 맞게 변형하면 시행착오를 줄일 수 있습니다.

    AI 스킬 만들기 체크리스트

    점검 항목 확인 질문 실무 포인트
    목적 이 스킬이 해결할 반복 업무는 무엇인가? 한 문장으로 설명되지 않으면 범위가 넓을 수 있습니다.
    발동 조건 언제 이 스킬을 사용해야 하는가? “이런 요청이 오면 사용” 조건을 명확히 적습니다.
    입력 정보 사용자가 무엇을 제공해야 하는가? 누락 시 질문해야 할 항목을 정리합니다.
    실행 절차 어떤 순서로 처리해야 하는가? 단계별 워크플로우를 번호로 씁니다.
    참고자료 항상 필요한 자료와 가끔 필요한 자료는 무엇인가? 긴 자료는 references로 분리합니다.
    자동화 매번 같은 결과가 필요한 부분은 무엇인가? 변환·검증·생성은 scripts 후보입니다.
    검증 완료 전에 무엇을 확인해야 하는가? 결과물 품질 기준과 오류 대응을 넣습니다.
    위험 사람 검토가 필요한 영역은 어디인가? 법무·보안·채용·재무 등은 경고를 명시합니다.

    결론: 스킬은 AI 시대의 업무 자산입니다

    AI 스킬 만들기의 본질은 “내가 일하는 방식을 AI가 반복 실행할 수 있는 구조로 바꾸는 것”입니다. 남이 만든 스킬을 가져다 쓰는 것도 도움이 되지만, 직접 만들고 써 보고 고치면서 축적한 스킬은 쉽게 대체되지 않는 업무 자산이 됩니다.

    처음부터 완벽한 스킬을 만들 필요는 없습니다. 작은 반복 업무 하나를 고르고, SKILL.md로 핵심 절차를 정리하고, 필요한 자료를 references/로 분리하고, 반복 검증이 필요한 부분을 scripts/로 옮기면 됩니다. 먼저 볼 부분은 한 번에 끝내는 것이 아니라 실제 사용 후 수정하고 보완하는 반복입니다.

    FAQ

    AI 스킬 만들기와 프롬프트 작성은 무엇이 다른가요?

    프롬프트 작성은 한 번의 요청을 잘 쓰는 데 초점이 있습니다. AI 스킬 만들기는 반복 업무에 필요한 절차, 참고자료, 템플릿, 검증 기준을 묶어 AI가 계속 재사용하도록 만드는 데 초점이 있습니다.

    SKILL.md 하나만 있어도 스킬이 되나요?

    가능합니다. 주의할 점은 업무가 복잡해지면 참고자료와 스크립트를 분리하는 편이 좋습니다. 그래야 AI가 핵심 지시와 부가 자료를 구분하고 필요한 순간에만 추가 정보를 읽을 수 있습니다.

    AI가 만들어 준 스킬을 그대로 써도 되나요?

    간단한 개인 업무라면 바로 시험해 볼 수 있습니다. 하지만 법무, 보안, 채용, 재무처럼 위험이 큰 업무라면 반드시 사람 검토 단계를 넣어야 합니다. 또한 실제 사용 후 결과를 보며 계속 수정해야 합니다.

    어떤 업무부터 스킬로 만들면 좋을까요?

    반복 빈도가 높고 결과 형식이 비교적 일정한 업무가 좋습니다. 회의록 정리, 보고서 초안, 블로그 검수, 자료 변환, 체크리스트 기반 리뷰처럼 절차와 기준을 정의하기 쉬운 업무부터 시작하면 됩니다.

    참고자료

    함께 읽으면 좋은 글

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.