[태그:] AI 시대

  • AI 시대 자녀교육, 좋은 대학보다 먼저 키워야 할 5가지 능력

    AI 시대 자녀교육, 좋은 대학보다 먼저 키워야 할 5가지 능력

    AI가 공부를 대신해 주는 시대가 오면, 부모는 아이에게 무엇을 남겨 줘야 할까요. 조벽 교수는 지식인사이드 인터뷰에서 이 질문을 꽤 단호하게 던집니다. 좋은 대학, 높은 점수, 더 많은 사교육만 붙잡고 있으면 AI 시대의 변화 앞에서 한 박자 늦을 수 있다는 것입니다.

    핵심은 “공부를 하지 말자”가 아닙니다. 오히려 기본 지식은 필요합니다. 다만 아이의 시간을 전부 정답 맞히기에 쓰는 방식은 점점 위험해집니다. AI가 정답을 빠르게 찾아 주는 시대에는 질문하고, 관계를 만들고, 자기만의 경험을 해석하는 힘이 더 중요해지기 때문입니다.
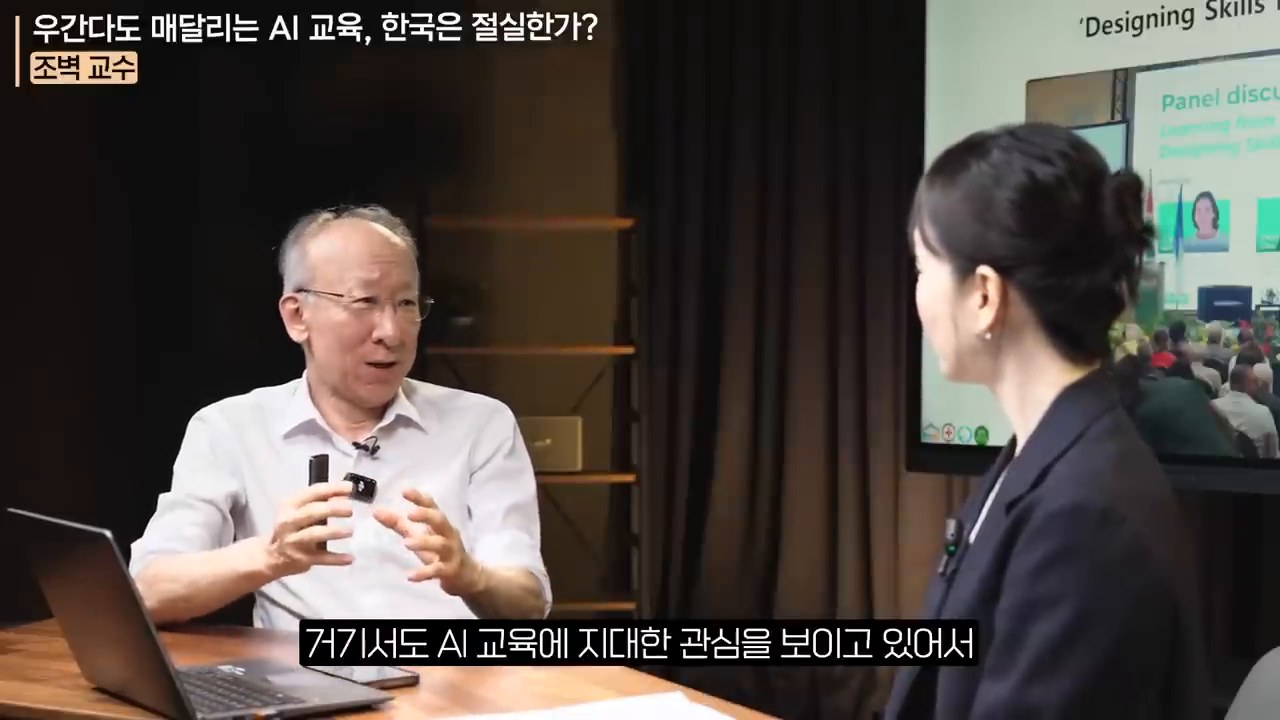
    조벽 교수 인터뷰 장면
    출처: 지식인사이드 유튜브 영상 캡처

    좋은 대학 전략이 더 이상 충분하지 않은 이유

    한국 부모에게 자녀 성공 전략은 오랫동안 단순했습니다. 좋은 성적을 받고, 좋은 대학에 가고, 안정적인 직업을 얻는 길입니다. 조벽 교수는 이 전략이 과거에는 꽤 강력했지만, AI 시대에는 그대로 통하지 않을 수 있다고 말합니다.

    영상에서 인상적인 비유가 나옵니다. 100년 전쯤 촬영된 가족사진 속 세 형제는 같은 시각, 같은 장소에 있었지만 전혀 다른 시대를 사는 사람처럼 보입니다. 누군가는 과거의 성공 상징을 붙들었고, 누군가는 새 시대의 교육으로 이동했습니다. 이 장면은 지금의 부모에게도 묻습니다. 우리가 붙잡는 “좋은 길”은 정말 아이가 살아갈 시대의 길일까요.
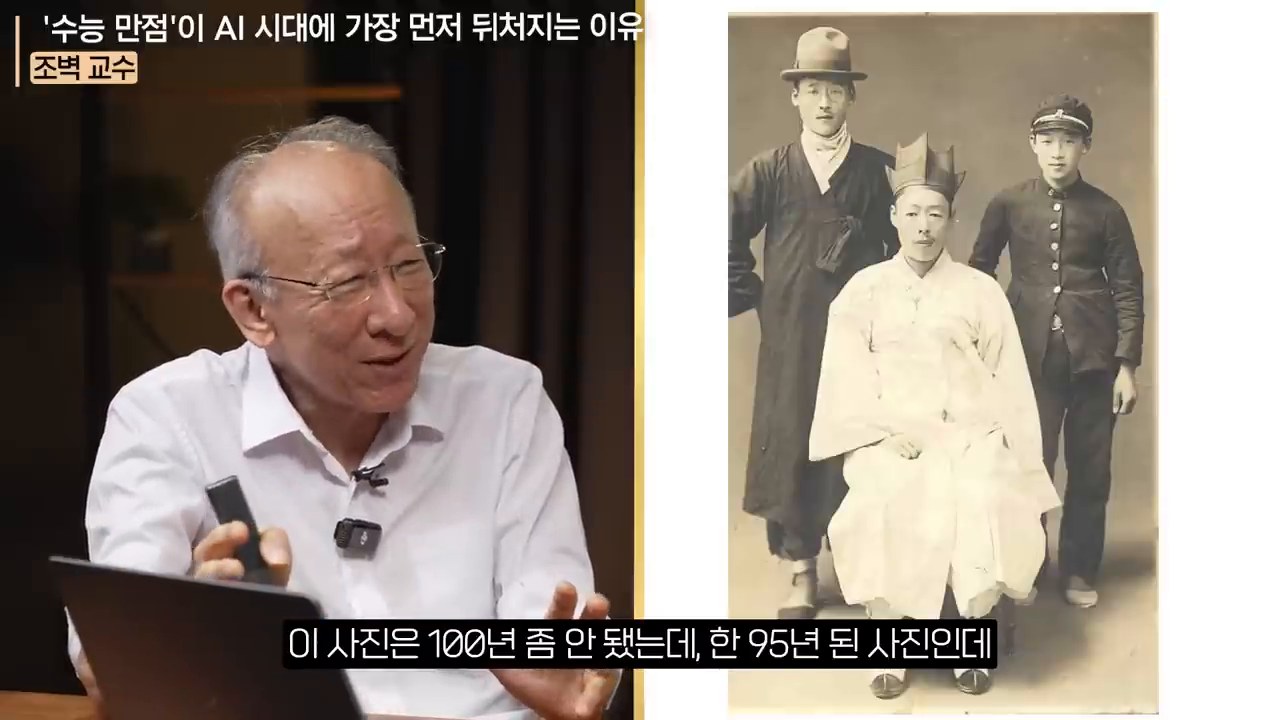
    시대 변화와 교육 선택을 설명하는 장면
    출처: 지식인사이드 유튜브 영상 캡처

    1. 인성은 예절이 아니라 AI 시대의 실력이다

    영상의 첫 번째 메시지는 “인성도 실력”이라는 말입니다. 여기서 인성은 단순히 착하고 예의 바른 태도를 뜻하지 않습니다. 조벽 교수는 인성을 인간만이 지닐 수 있는 고유한 특성으로 설명합니다. 소통, 공감, 협업, 회복탄력성처럼 AI가 대체하기 어려운 인간의 힘입니다.

    예전에는 지식과 기술이 앞서면 인성은 부가 요소처럼 여겨지기도 했습니다. 하지만 AI가 지식 처리와 정답 탐색을 빠르게 맡아 갈수록 상황은 달라집니다. 사람은 사람과 일해야 하고, 모호한 문제를 함께 풀어야 합니다. 그래서 인성은 “있으면 좋은 것”이 아니라 아이가 오래 살아남기 위한 핵심 역량이 됩니다.

    2. 질문력은 프롬프트 기술보다 더 깊은 능력이다

    AI 시대가 되면서 많은 사람이 “질문을 잘해야 한다”고 말합니다. 프롬프트를 잘 쓰는 능력도 분명 필요합니다. 그러나 영상에서 말하는 질문력은 그보다 큽니다. 아이가 자기 배움의 주도권을 넘겨받는 능력에 가깝습니다.

    아이들은 원래 질문을 많이 합니다. 그런데 어른이 되면서 질문은 줄어듭니다. “쓸데없는 생각하지 말고 공부해”, “빨리 숙제해”, “이 문제부터 풀어”라는 말 속에서 질문하는 힘이 눌리기 때문입니다. 부모가 해야 할 일은 아이에게 정답을 더 많이 주는 것이 아니라, 질문해도 괜찮은 분위기를 회복해 주는 일입니다.
    질문과 인간 고유 능력을 설명하는 장면
    출처: 지식인사이드 유튜브 영상 캡처

    3. 미래 리터러시는 미래를 맞히는 능력이 아니다

    조벽 교수는 “미래 리터러시”를 미래를 예측하는 능력으로 설명하지 않습니다. 오히려 내가 살아가고 싶은 미래를 만들어 내는 능력이라고 말합니다. 이 차이가 중요합니다.

    예측은 AI가 더 잘할 수 있습니다. 데이터와 패턴을 읽고 가능한 시나리오를 계산하는 일은 AI의 강점입니다. 하지만 어떤 미래를 원하고, 어떤 삶을 선택하고, 어떤 관계를 지킬지는 사람의 몫입니다. 그래서 부모는 아이에게 “정답을 맞히는 아이”가 아니라 “자기 미래를 설계하는 아이”가 되도록 도와야 합니다.

    4. 베스트보다 유니크가 중요해진다

    입시 경쟁은 아이를 계속 비교하게 만듭니다. 누가 더 높은 점수를 받았는지, 누가 더 좋은 학교에 갔는지, 누가 더 빨리 앞섰는지가 기준이 됩니다. 그러나 AI 시대의 경쟁력은 꼭 남을 이기는 데서만 나오지 않습니다.

    조벽 교수는 “베스트”보다 “유니크”를 강조합니다. 아이가 자기만의 경험, 관심, 질문, 실패, 회복의 이야기를 가질 때 경쟁하지 않고도 경쟁력이 생긴다는 뜻입니다. 똑같은 정답을 빠르게 말하는 사람은 AI와 비교됩니다. 그러나 자기만의 관점으로 문제를 보고, 다른 사람과 협력해 기여하는 사람은 쉽게 대체되지 않습니다.
    미래 리터러시와 질문을 설명하는 장면
    출처: 지식인사이드 유튜브 영상 캡처

    5. 부모의 첫 질문은 점수가 아니라 감정이어야 한다

    영상의 마지막 조언은 가장 실천적입니다. 아이가 학교에서 돌아왔을 때 “오늘 뭐 배웠니?”, “몇 점 받았니?”라고 묻는 부모는 AI 시대에 역행할 수 있습니다. 대신 “오늘 학교에서 즐거웠니?”라고 묻는 부모는 아이의 감정과 연결됩니다.

    이 말은 공부를 포기하자는 뜻이 아닙니다. 아이의 생기와 관계를 먼저 살리자는 뜻입니다. 부모와 자녀의 관계는 대학 입시가 끝나면 사라지는 프로젝트가 아닙니다. 평생 이어지는 관계입니다. 그 관계가 안전할 때 아이는 더 많이 질문하고, 더 멀리 탐험하고, 실패해도 다시 일어날 수 있습니다.
    부모의 공감 질문을 설명하는 인터뷰 장면
    출처: 지식인사이드 유튜브 영상 캡처

    부모가 오늘 바로 바꿀 수 있는 5가지 질문

    AI 시대 자녀교육은 거창한 제도 개혁만 기다릴 일이 아닙니다. 부모가 집에서 쓰는 질문부터 바꿀 수 있습니다.

    1. “오늘 몇 점 받았어?” 대신 “오늘 가장 재미있었던 순간은 뭐였어?”
    2. “왜 그것도 몰라?” 대신 “어디서부터 헷갈렸어?”
    3. “그 꿈은 현실성이 없어” 대신 “그 꿈에 가까워지려면 어떤 경험을 해 보면 좋을까?”
    4. “남들은 다 하는데 너는 왜 안 해?” 대신 “너만의 방식으로 해 보고 싶은 건 뭐야?”
    5. “빨리 정답 말해” 대신 “다른 질문으로 바꿔 보면 어떻게 될까?”

    질문이 바뀌면 아이가 자기 생각을 꺼내는 방식도 조금씩 달라집니다. 처음에는 어색할 수 있습니다. 영상에서 말하듯 어려운 것이 아니라 익숙하지 않은 것에 가깝습니다.

    함께 읽으면 좋은 글

    FAQ

    AI 시대에는 학교 공부가 덜 중요해지나요?

    기본 지식은 여전히 중요합니다. 다만 모든 시간을 점수 경쟁에만 쓰는 방식은 위험합니다. 기본 학습 위에 질문력, AI 리터러시, 공감, 협업, 회복탄력성을 함께 키워야 합니다.

    조벽 교수가 말한 인성은 착한 태도만 뜻하나요?

    아닙니다. 영상에서의 인성은 인간 고유의 특성에 가깝습니다. 소통, 공감, 협업, 회복탄력성처럼 AI가 대신하기 어려운 능력을 포함합니다.

    부모가 아이의 질문을 어떻게 도와야 하나요?

    정답을 바로 주기보다 아이가 어떤 생각에서 질문했는지 먼저 들어야 합니다. 질문을 평가하지 않고 환영하는 분위기를 만들면 아이가 자기 배움의 주도권을 조금씩 회복할 수 있습니다.

    좋은 대학을 목표로 하는 것은 잘못인가요?

    목표 자체가 잘못은 아닙니다. 문제는 좋은 대학만을 유일한 성공 전략으로 삼는 것입니다. AI 시대에는 대학 이름보다 아이가 어떤 질문을 만들고, 어떤 경험을 해석하며, 어떤 기여를 할 수 있는지가 더 중요해집니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • 옵시디언 딥리서치 자동화: NotebookLM과 Tavily를 한 번에 쓰는 방법

    옵시디언 딥리서치 자동화: NotebookLM과 Tavily를 한 번에 쓰는 방법

    AI 리서치 도구는 많아졌습니다. 문제는 결과가 흩어진다는 점입니다. NotebookLM에서 정리한 내용, 웹 검색 기반 리포트, AI CLI가 만든 요약, 그리고 내가 실제로 쓰는 노트가 따로 놀면 다시 붙이는 시간이 꽤 듭니다.

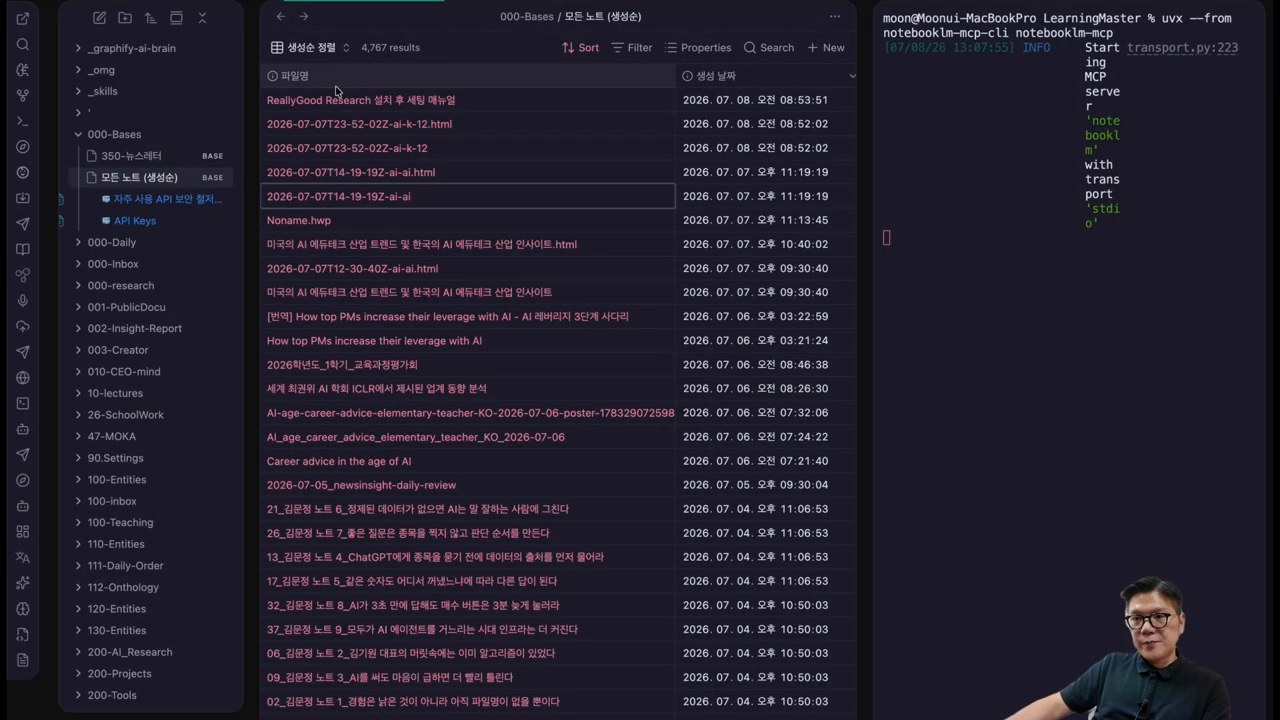
    이번 영상에서 소개된 ReallyGood Research는 그 간격을 줄이려는 Obsidian 플러그인입니다. 질문 하나로 NotebookLM MCP와 Tavily 리서치를 실행하고, 결과를 Markdown과 HTML 리포트로 Vault 안에 저장하는 방식입니다. 핵심은 “검색을 잘하는 도구”가 아니라 “리서치 결과가 내 지식 작업 흐름 안에 남는 구조”입니다.

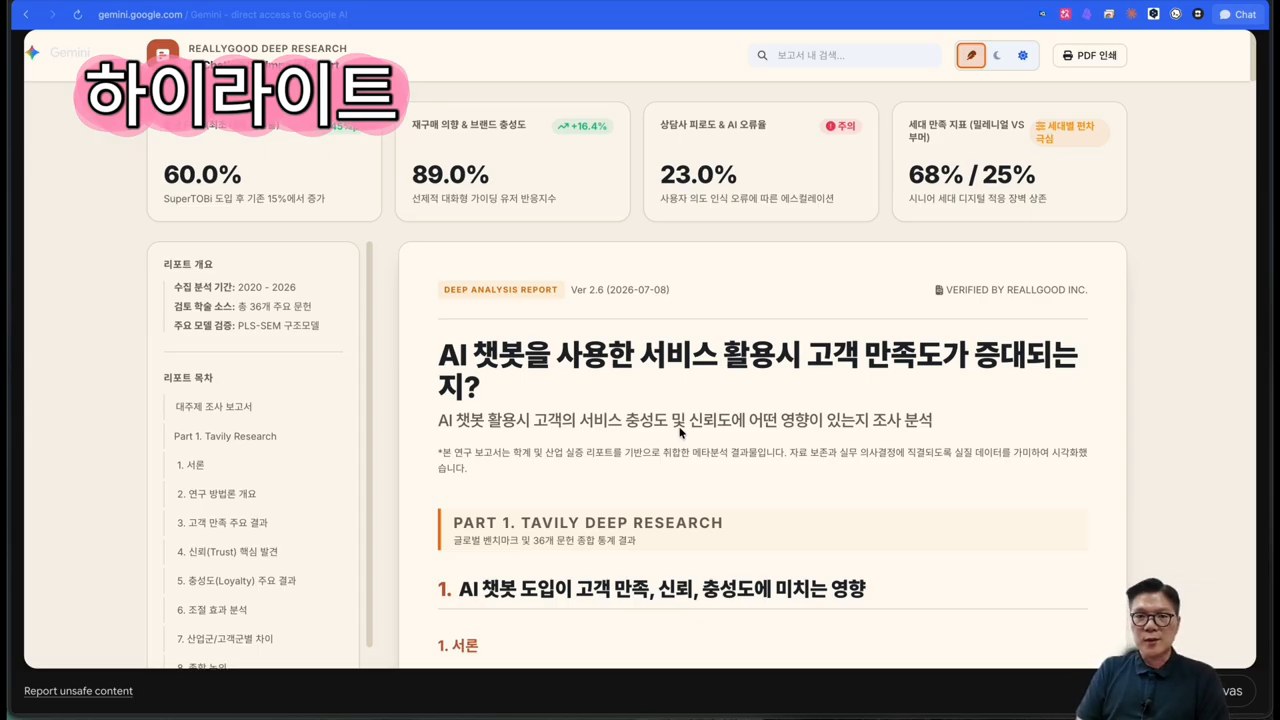
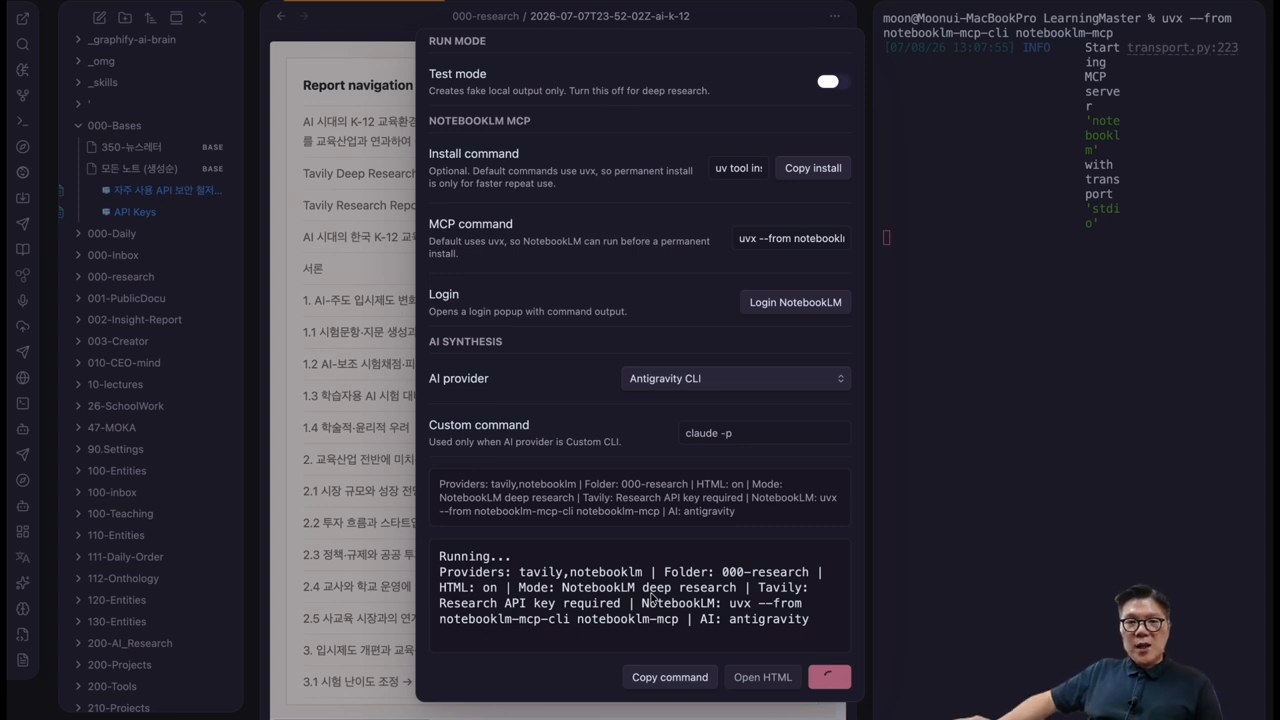
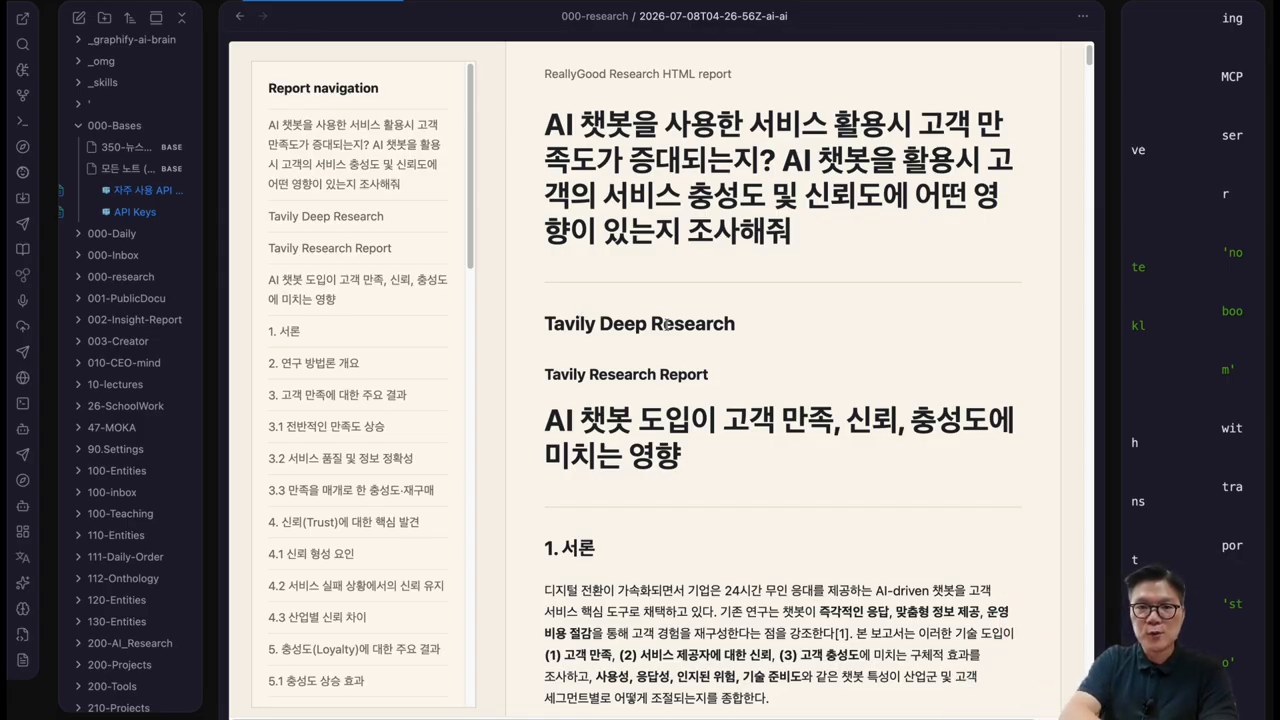
    ReallyGood Research 리포트 예시
    ReallyGood Research 리포트 예시

    Read in English: Obsidian Deep Research Automation: How to Use NotebookLM and Tavily Together

    영상에서 보여준 핵심 흐름

    영상은 완성된 리포트 화면에서 시작합니다. 브라우저로 열린 HTML 리포트를 확인하고, Gemini Canvas 공유 링크로 확장하는 장면도 먼저 보여줍니다. 그래서 이 플러그인의 목적이 분명해집니다. 단순 검색이 아니라, 공유 가능한 리서치 산출물을 만드는 것입니다.

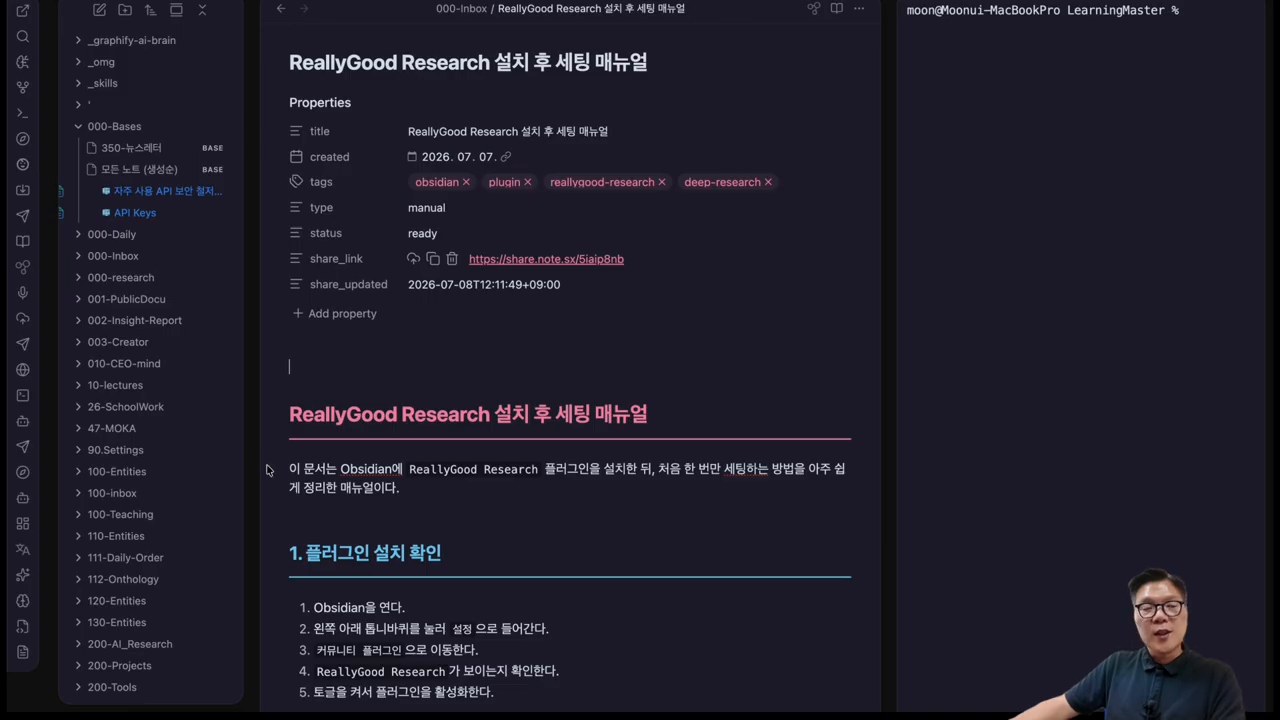
    그다음 진행자는 Obsidian 안에서 플러그인을 설치하는 과정을 설명합니다. 커뮤니티 플러그인에서 ReallyGood Research를 검색하고 설치한 뒤, 왼쪽 패널에서 리서치 콘솔을 여는 흐름입니다. 별도 BRAT 설치 없이 커뮤니티 플러그인으로 접근할 수 있다는 점도 영상에서 강조됩니다.

    Obsidian 안에서 ReallyGood Research 설정을 확인하는 화면
    Obsidian 안에서 ReallyGood Research 설정을 확인하는 화면

    NotebookLM과 Tavily를 왜 함께 쓰나

    Tavily는 웹 검색과 리서치 API에 강점이 있습니다. 공개 웹에서 자료를 찾고, 주제별 리포트를 생성하는 데 적합합니다. 반면 NotebookLM은 사용자가 넣은 소스 기반으로 답을 구성하는 데 장점이 있습니다. 두 도구를 함께 쓰면 “웹에서 넓게 찾기”와 “소스 기반으로 다시 검토하기”를 분리할 수 있습니다.

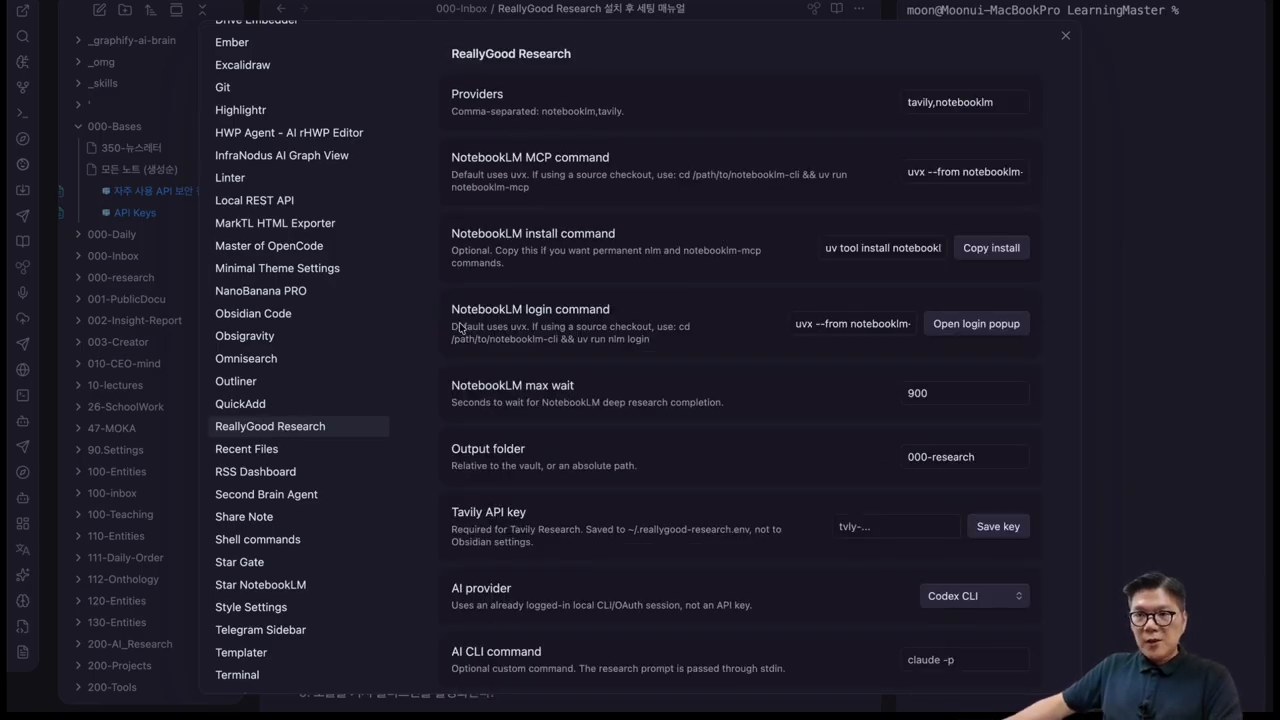
    ReallyGood Research는 이 둘을 Provider로 연결합니다. 영상에서는 Tavily API 키를 넣고, NotebookLM MCP를 설치한 뒤 로그인하는 과정을 보여줍니다. 이후 AI CLI Provider로 Antigravity를 선택해 실행 환경을 맞춥니다. Claude Code, Codex, Gemini 같은 CLI를 고를 수 있다는 설명도 나옵니다.

    Tavily와 NotebookLM Provider를 설정하는 화면
    Tavily와 NotebookLM Provider를 설정하는 화면

    실제 사용 장면: 질문 하나가 두 개의 리포트로 바뀐다

    시연 질문은 “AI 챗봇을 사용한 서비스 활용이 고객 만족도, 충성도, 신뢰도에 어떤 영향을 미치는가”에 가깝습니다. 사용자가 질문을 입력하고 Start를 누르면, 플러그인은 Tavily 리서치와 NotebookLM 리서치를 각각 실행합니다.

    중요한 장면은 결과 확인입니다. 하나의 질문에서 Tavily 기반 딥리서치 리포트와 NotebookLM 기반 리서치 결과가 따로 생성됩니다. 사용자는 둘을 비교하면서 근거가 충분한지, 관점이 한쪽으로 치우치지 않았는지 확인할 수 있습니다.

    AI 챗봇 고객 만족도 주제로 리서치를 실행하는 화면
    AI 챗봇 고객 만족도 주제로 리서치를 실행하는 화면
    Tavily와 NotebookLM 리서치 결과를 비교하는 화면
    Tavily와 NotebookLM 리서치 결과를 비교하는 화면

    이 방식이 지식 작업에 주는 의미

    이 플러그인의 장점은 자동화 그 자체보다 작업 위치에 있습니다. 리서치 결과가 Obsidian Vault 안에 저장되면, 이후 글쓰기·보고서·강의안·제안서로 이어가기 쉽습니다. 검색 결과를 다시 찾지 않아도 되고, HTML 리포트로 빠르게 공유할 수도 있습니다.

    다만 확인할 점도 있습니다. Tavily API 키와 NotebookLM 로그인, 로컬 MCP 실행, AI CLI 권한이 필요합니다. 회사 자료나 민감한 고객 데이터를 넣을 때는 어떤 Provider로 정보가 전달되는지 먼저 봐야 합니다. 자동화가 편해질수록 로그, 출처, 계정 권한을 함께 관리해야 합니다.

    HTML 리포트를 Gemini Canvas 공유 링크로 확장하는 화면
    HTML 리포트를 Gemini Canvas 공유 링크로 확장하는 화면

    도입 전에 확인할 체크리스트

    • Obsidian을 실제 지식 저장소로 쓰고 있는가?
    • Tavily API 키와 사용량 한도를 관리할 수 있는가?
    • NotebookLM MCP 설치와 Google 로그인을 안전하게 처리할 수 있는가?
    • 리서치 결과를 바로 글쓰기나 보고서로 이어갈 업무가 있는가?
    • 자동 생성 결과를 검증할 기준과 출처 확인 습관이 있는가?

    이 다섯 가지가 맞으면 테스트해 볼 만합니다. 반대로 단발성 검색만 필요하다면 과한 구성일 수 있습니다. ReallyGood Research는 검색 도구라기보다, Obsidian을 리서치 작업대처럼 쓰는 사람에게 더 잘 맞습니다.

    함께 읽으면 좋은 글

    FAQ

    ReallyGood Research는 무엇인가요?

    Obsidian에서 NotebookLM MCP와 Tavily 기반 딥리서치를 실행하고, 결과를 Markdown과 HTML 리포트로 저장하는 플러그인입니다. 영상 기준으로는 커뮤니티 플러그인 설치와 Provider 설정 흐름이 소개됩니다.

    Tavily와 NotebookLM을 동시에 쓰는 이유는 무엇인가요?

    Tavily는 웹 기반 리서치에 강하고, NotebookLM은 사용자가 제공한 소스 기반 검토에 강합니다. 둘을 함께 쓰면 넓은 탐색과 소스 기반 확인을 나눠 볼 수 있습니다.

    Obsidian을 쓰지 않아도 필요한 도구인가요?

    Obsidian을 중심 지식 저장소로 쓰지 않는다면 장점이 줄어듭니다. 이 플러그인은 결과를 Vault 안에 저장하고 다시 활용하는 흐름에 초점이 있습니다.

    업무 자료를 넣어도 안전한가요?

    도구 자체보다 Provider 설정이 중요합니다. Tavily, NotebookLM, AI CLI로 어떤 데이터가 전달되는지 확인해야 합니다. 민감한 자료는 조직 보안 기준에 맞춰 별도로 검토하는 것이 좋습니다.

    이 플러그인은 누구에게 가장 잘 맞나요?

    AI 리서치를 자주 하고, 결과를 글·보고서·강의안·제안서로 다시 쓰는 사람에게 잘 맞습니다. 특히 Obsidian을 세컨드 브레인이나 업무 지식 허브로 쓰는 사용자에게 유용합니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • 팀원이 느린 게 아닐 수 있다: 리더가 놓치는 ‘방법과 속도’의 차이

    “왜 이렇게 느려?”

    Read in English: Your Teammate May Not Be Slow: The Difference Between Method and Speed That Leaders Miss

    리더가 가장 쉽게 던지는 말이다. 그런데 이 말이 늘 맞는 진단은 아니다. 팀원이 정말 느린 것이 아니라, 리더가 문제를 잘못 읽고 있을 수 있다.

    라면을 끓이는 장면을 떠올려보자. 리더가 “빨리 라면 끓여”라고 말했다. 팀원이 면을 먼저 넣었다. 그 순간 리더가 말한다.

    “왜 면을 먼저 넣어? 스프부터 넣어야지.”

    여기서 논점은 속도가 아니다. 조리 순서다. 면을 먼저 넣을지, 스프를 먼저 넣을지, 물은 얼마나 넣을지, 어떤 식감을 원하는지의 문제다. 그런데 리더가 계속 “빨리 하라”고만 말하면 팀원은 헷갈린다. 더 빨리 움직여야 하는가. 순서를 바꿔야 하는가. 기준을 다시 물어봐야 하는가.

    이 작은 비유가 보여주는 리더십의 핵심은 분명하다. 방법의 차이를 속도의 차이로 해석하면 안 된다.

    팀 운영에서도 똑같은 일이 벌어진다. 보고서가 마음에 들지 않을 때, 회의 준비가 어긋났을 때, AI로 만든 초안이 기대와 다를 때 리더는 쉽게 “빨리”, “제대로”, “다시”라고 말한다. 하지만 실제 문제는 느린 손이 아니라 흐린 기준일 수 있다.

    리더가 놓치는 첫 번째 문제: 느린 게 아니라 기준이 없을 수 있다

    업무가 기대와 다를 때 리더는 결과만 본다. 늦었다. 부족하다. 답답하다. 그래서 속도를 압박한다.

    하지만 팀원 입장에서는 전혀 다른 문제가 있을 수 있다.

    • 무엇을 우선해야 하는지 모른다.
    • 초안인지 최종본인지 모른다.
    • 어느 정도 품질이면 충분한지 모른다.
    • 누구 의견을 반드시 반영해야 하는지 모른다.
    • 실패했을 때 다시 물어봐도 되는지 모른다.

    이런 상태에서 “빨리 해”는 해결책이 아니다. 오히려 문제를 숨긴다. 팀원은 더 빨리 움직이지만, 리더가 원하는 방향으로 움직이지 못한다. 결국 재작업이 늘어난다.

    라면으로 치면 이렇다. 리더가 원하는 것이 꼬들한 면인지, 진한 국물인지, 3분 안에 먹을 수 있는 빠른 한 끼인지 말하지 않았다. 그런데 결과가 마음에 들지 않자 “왜 이렇게 느려?”라고 말한다. 이건 속도 피드백이 아니라 기준 누락이다.

    상황적 리더십: 사람마다 필요한 리더십은 다르다

    상황적 리더십은 효과적인 리더가 하나의 방식만 고집하지 않는다고 본다. 과업의 난이도, 구성원의 숙련도, 자신감에 따라 지시·코칭·지원·위임의 비중을 바꿔야 한다는 관점이다.

    처음 라면을 끓이는 사람에게는 구체적인 순서가 필요하다. 물의 양, 불의 세기, 면을 넣는 시점, 스프를 넣는 시점을 알려줘야 한다. 이때 “알아서 빨리 해”는 방임에 가깝다.

    반대로 이미 잘 끓이는 사람에게 매번 “왜 면을 먼저 넣어?”라고 개입하면 어떨까. 그 사람은 자기 방식으로 더 좋은 결과를 낼 수도 있다. 이때 필요한 것은 세부 지시가 아니라 결과 기준이다.

    팀도 같다. 신입에게 필요한 것은 친절한 방법 설명일 수 있다. 숙련자에게 필요한 것은 권한 위임일 수 있다. 새로운 과업을 맡은 사람에게는 코칭이 필요하고, 이미 반복해온 과업에는 자율성이 필요하다.

    좋은 리더는 먼저 묻는다.

    “지금 이 사람에게 필요한 것은 속도 압박인가, 방법 설명인가, 기준 정렬인가, 아니면 권한 위임인가?”

    변혁적 리더십: 사람은 속도보다 의미에 더 오래 움직인다

    변혁적 리더십은 구성원이 더 큰 목적과 비전에 연결될 때 몰입과 성과가 높아진다고 본다. 이 관점에서 리더는 단순히 일을 재촉하는 사람이 아니다. 왜 이 일을 하는지, 어떤 변화가 필요한지, 어떤 기준으로 판단해야 하는지 연결해주는 사람이다.

    “빨리 라면 끓여”는 과업 지시다.

    “지금은 회의 시작 전 5분밖에 없으니, 맛보다 빠른 식사가 중요하다”는 목적 설명이다.

    “오늘은 손님에게 내는 거라 1분 늦어도 면 식감과 국물 맛이 중요하다”는 기준 공유다.

    목적이 달라지면 좋은 방법도 달라진다. 빠른 한 끼가 목적이면 조리 순서와 품질 기준이 달라진다. 맛이 목적이면 다른 선택을 할 수 있다. 누군가에게 대접하는 라면이라면 또 달라진다.

    조직도 마찬가지다. 리더가 목적을 말하지 않으면 구성원은 방법을 방어한다. “저는 이렇게 배웠습니다”, “전에는 이렇게 했습니다”, “시간이 없었습니다”라는 말이 나온다. 반대로 목적이 공유되면 방법은 토론할 수 있다.

    리더십은 속도를 외치는 기술이 아니다. 의미와 기준을 맞추는 기술이다.

    서번트 리더십: 사람을 탓하기 전에 막힌 것을 치워야 한다

    서번트 리더십은 리더가 구성원을 통제하는 사람이 아니라 성장과 성과를 돕는 사람이라고 본다. 이 관점에서 리더의 질문은 달라진다.

    “왜 못 했어?”보다 먼저 물어야 할 것은 “무엇이 막고 있지?”다.

    팀원이 라면을 늦게 끓였다면 실제 이유는 다양하다. 냄비를 못 찾았을 수 있다. 가스레인지가 고장났을 수 있다. 물을 얼마나 넣을지 몰랐을 수 있다. 가족마다 선호하는 조리법이 달라서 망설였을 수 있다.

    업무도 그렇다. 일이 늦어진 이유가 개인의 태도 때문이라고 단정하기 전에 확인해야 할 것이 있다.

    • 필요한 정보가 있었는가?
    • 결정권자가 분명했는가?
    • 도구와 자료가 준비되어 있었는가?
    • 우선순위가 충돌하지 않았는가?
    • 중간에 질문할 수 있는 분위기가 있었는가?

    사람을 몰아붙이는 리더는 순간적인 속도를 만들 수 있다. 하지만 장애물을 치우는 리더는 다음 실행의 품질을 높인다.

    심리적 안전감: 말할 수 있어야 빨라진다

    심리적 안전감은 팀원이 질문, 우려, 실수, 다른 의견을 말해도 처벌받거나 모욕당하지 않을 것이라는 믿음이다. 빠른 팀일수록 이 안전감이 필요하다.

    팀원이 이렇게 말할 수 있어야 한다.

    “저는 면을 먼저 넣는 게 더 낫다고 생각했습니다. 이유는 이렇습니다.”

    또는 이렇게 말할 수 있어야 한다.

    “스프를 먼저 넣어야 하는 기준이 있었다면 처음에 알려주셨으면 좋겠습니다.”

    이 대화가 가능한 팀은 빨리 배운다. 반대로 말할 수 없는 팀은 조용히 눈치를 본다. 겉으로는 빠르게 움직이는 것처럼 보인다. 하지만 같은 실수가 반복된다.

    리더가 원하는 것이 진짜 속도라면, 역설적으로 방법을 논의할 수 있는 시간을 줘야 한다. 짧은 기준 정렬이 긴 재작업을 줄인다.

    의사결정 리더십: 누가 결정하는지 모르면 모두가 늦어진다

    속도 문제가 반복될 때는 의사결정 역할이 불분명한 경우도 많다. Atlassian의 DACI 같은 프레임워크는 누가 주도자이고, 누가 승인자이며, 누가 기여자이고, 누가 통보 대상인지 나눠 보게 한다.

    라면 하나에도 역할이 있다. 누가 끓일 것인가. 누가 맛 기준을 정할 것인가. 누가 먹을 사람인가. 누가 최종적으로 “이 정도면 됐다”고 판단할 것인가.

    업무에서는 이 구분이 더 중요하다. 결정권자가 불명확하면 팀원은 안전한 선택만 한다. 기여자가 너무 많고 승인자가 늦게 등장하면 속도는 떨어진다. 승인자가 기준을 뒤늦게 말하면 재작업이 늘어난다.

    그래서 리더는 “빨리 해” 전에 이렇게 말해야 한다.

    “이번 일은 누가 결정하고, 누구 의견을 반드시 반영하며, 어느 수준이면 완료로 볼 것인가?”

    AI 시대에는 더 빨리 만들수록 더 정확히 물어야 한다

    AI와 자동화 도구가 들어오면 속도는 빨라진다. 초안, 요약, 보고서, 코드, 이미지, 발표자료까지 이전보다 훨씬 빠르게 만들 수 있다.

    문제는 여기서 시작된다. 빠르게 만들 수 있다는 사실이 좋은 결과를 보장하지 않는다. 기준 없이 만든 초안은 쌓인다. 검토 기준 없이 생성한 자료는 다시 손봐야 한다. “AI로 빨리 해”라는 말은 강력해 보이지만, 실제로는 리더의 판단을 더 많이 요구한다.

    AI 시대의 리더는 다음을 먼저 정해야 한다.

    • AI에게 맡길 60~80점 영역은 어디인가?
    • 사람이 반드시 판단해야 할 20~40점 영역은 무엇인가?
    • 결과물의 품질 기준은 무엇인가?
    • 데이터 출처와 검증 방식은 무엇인가?
    • 최종 책임은 누가 지는가?

    AI 시대에는 속도보다 질문의 품질이 더 중요해진다. 잘못된 질문은 더 빠른 혼란을 만든다. 좋은 질문은 빠른 실행을 좋은 결과로 연결한다.

    좋은 리더가 먼저 던지는 5가지 질문

    팀원이 느려 보일 때, 바로 속도를 지적하기 전에 이 다섯 가지를 확인해보자.

    1. 목적 질문: 지금 중요한 것은 빠른 처리인가, 높은 품질인가, 학습인가?
    2. 방법 질문: 이 방식은 어떤 문제를 해결하기 위한 선택인가?
    3. 기준 질문: 완료 기준과 품질 기준은 무엇인가?
    4. 역할 질문: 누가 결정하고, 누가 조언하고, 누가 실행하는가?
    5. 장애물 질문: 속도를 막는 것은 사람의 의지인가, 도구·정보·권한·기준의 부족인가?

    이 질문을 하지 않으면 리더는 모든 문제를 속도 문제로 본다. 질문을 바꾸면 보이지 않던 원인이 보인다.

    함께 읽으면 좋은 글

    결론: 리더십은 속도를 높이는 일이 아니라 판단을 맞추는 일이다

    라면을 빨리 끓이는 것과 라면을 어떤 방식으로 끓일 것인지는 다른 문제다. 팀 운영도 그렇다. 리더가 방법의 차이를 속도의 차이로 오해하면, 팀원은 더 빨리 움직이지만 더 나은 판단을 하지는 못한다.

    좋은 리더는 속도를 부정하지 않는다. 다만 속도 전에 목적을 묻는다. 방법을 묻는다. 기준을 맞춘다. 역할을 정한다. 장애물을 치운다.

    그때 팀은 단지 빨라지는 것이 아니라, 같은 방향으로 움직이기 시작한다.

    FAQ

    팀원이 느린 것과 방법이 다른 것은 어떻게 구분하나요?

    목표와 기준이 충분히 공유됐는데도 시간이 오래 걸린다면 속도 문제일 수 있습니다. 하지만 목표, 순서, 역할, 품질 기준이 불명확하다면 먼저 방법의 문제로 봐야 합니다.

    리더가 “빨리 하라”고 말하면 안 되나요?

    말할 수 있습니다. 다만 빠른 실행이 왜 필요한지, 어느 수준까지 완성하면 되는지, 무엇을 생략해도 되는지를 함께 말해야 합니다. 그렇지 않으면 속도 압박은 재작업을 늘릴 수 있습니다.

    상황적 리더십과 이 비유는 어떻게 연결되나요?

    상황적 리더십은 구성원의 숙련도와 과업 상황에 맞게 리더의 개입 방식을 바꾸는 관점입니다. 초보자에게는 구체적 방법이 필요하고, 숙련자에게는 기준과 권한 위임이 더 효과적일 수 있습니다.

    AI 시대에는 왜 이 문제가 더 중요해지나요?

    AI는 초안을 빠르게 만들 수 있습니다. 하지만 목적과 기준이 없으면 빠른 초안이 더 많은 혼란을 만들 수 있습니다. 그래서 AI 시대의 리더는 속도보다 먼저 판단 기준과 검증 루프를 설계해야 합니다.

    참고자료

  • 세계 최초 AI 미술관 DATALAND: 데이터가 작품이 되는 공간의 의미

    세계 최초 AI 미술관 DATALAND: 데이터가 작품이 되는 공간의 의미

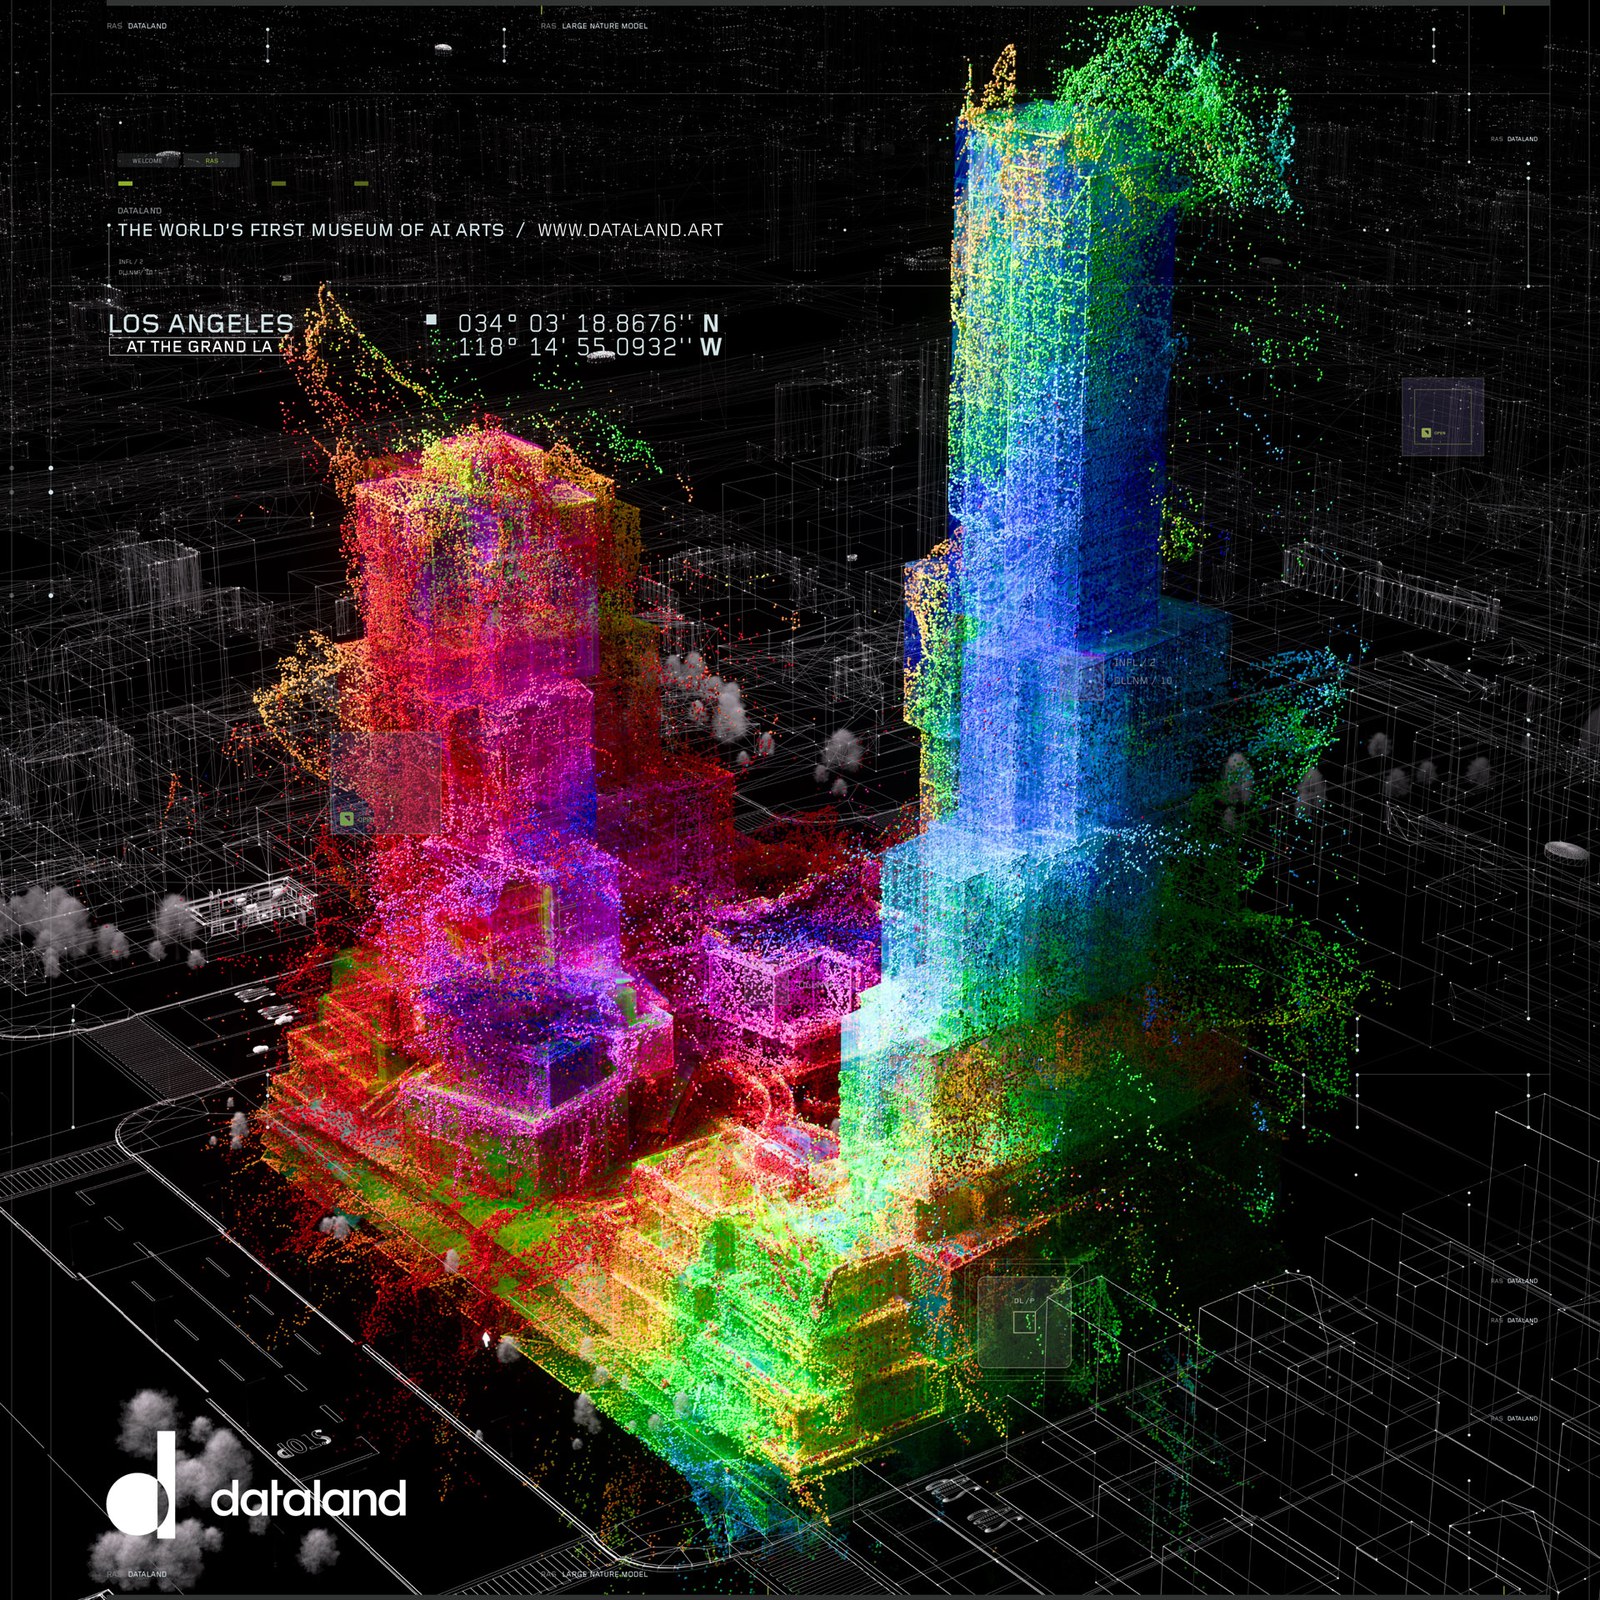
    LA 도심에 문을 연 DATALAND는 “AI가 만든 그림을 전시하는 곳”이라는 한 문장으로는 설명하기 어렵습니다. MBC America 뉴스가 보여준 장면의 핵심은 작품 하나가 아니라, 데이터·센서·생성형 AI·공간 연출이 한꺼번에 작동하는 새로운 미술관 모델입니다.

    공식 자료를 대조해 보면 DATALAND는 Refik Anadol과 Efsun Erkılıç가 공동 설립한 세계 최초의 AI Arts Museum입니다. 첫 전시는 Machine Dreams: Rainforest이고, 장소는 LA 다운타운 The Grand LA입니다.

    DATALAND가 LA The Grand LA에 조성한 세계 최초 AI 미술관 콘셉트 이미지
    DATALAND 공식 사이트 제공 이미지

    뉴스가 보여준 것은 “움직이는 그림”이 아니라 “반응하는 미술관”이다

    영상은 숲, 새, 빛, 향기, 관람객의 움직임이 결합된 몰입형 장면을 보여줍니다. 관람객이 센서를 착용하면 심박, 체온, 움직임 같은 데이터가 실시간으로 해석되고, 그 정보가 전시 환경에 반영됩니다.

    여기서 중요한 변화는 관람객이 더 이상 작품 앞에 서 있는 외부자가 아니라는 점입니다. 관람객의 상태와 행동이 전시의 일부가 되고, 작품은 매번 조금씩 다른 모습으로 재구성됩니다.

    공식 자료로 확인한 DATALAND의 기본 정보

    • 공식 명칭: DATALAND, Museum of AI Arts
    • 위치: The Grand LA, 100 S Grand Ave, Los Angeles, CA 90012
    • 개관 전시: Machine Dreams: Rainforest
    • 전시 기간: 공식 전시 페이지 기준 2027년 1월 31일까지
    • 핵심 기술: Large Nature Model, Google Cloud, Gemini Enterprise Agent Platform, Compute Engine, 생성 모델과 실시간 상호작용 기술

    DATALAND 공식 사이트는 이 공간을 “data becomes pigment”, 즉 데이터가 물감이 되는 미술관으로 설명합니다. Google 공식 블로그는 개관 전시가 자연 세계의 대규모 데이터셋을 학습한 Large Nature Model을 기반으로 하며, 12억 픽셀 규모의 초생성적 현실을 구현한다고 설명합니다.

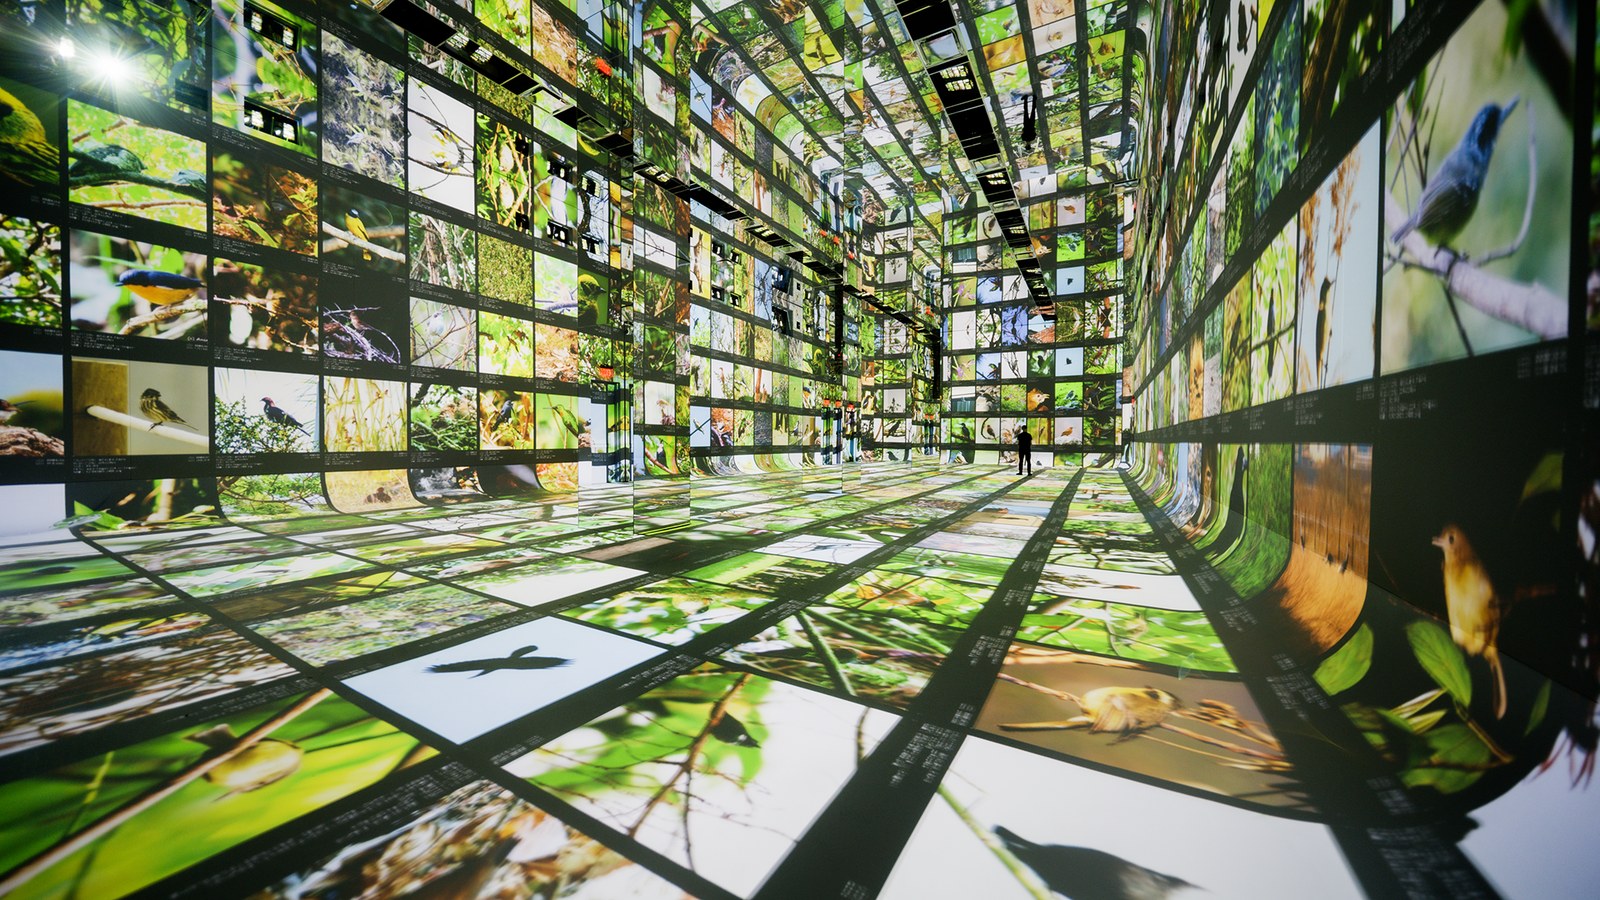
    DATALAND의 Data Pavilion 전시 공간, 자연 데이터 이미지가 벽과 바닥을 채운 모습
    이미지: Refik Anadol Studio, Google 공식 블로그

    왜 ‘AI 미술관’이라는 표현이 중요한가

    기존 미디어아트 전시는 대형 화면과 프로젝션으로 관람객을 압도하는 방식이 많았습니다. DATALAND가 다른 지점은 AI를 단순 제작 도구가 아니라 전시 운영의 핵심 인프라로 끌어들인다는 데 있습니다.

    Google 공식 블로그에 따르면 DATALAND는 관람객 반응을 처리하고, 생성 사운드스케이프를 만들며, 감정 신호와 향기까지 알고리즘적으로 조정합니다. 미술관은 정해진 파일을 재생하는 장소가 아니라, 입력 데이터를 계속 받아들이며 장면을 갱신하는 시스템에 가까워집니다.

    예술인가, 기술 시연인가: 논쟁의 지점

    AI 미술을 둘러싼 질문은 여전히 남아 있습니다. AI가 만든 결과물을 어디까지 예술로 볼 것인가, 데이터의 출처와 동의는 어떻게 다뤄야 하는가, 관람객의 생체 데이터는 어떤 기준으로 보호되어야 하는가가 핵심 쟁점입니다.

    DATALAND는 공식적으로 윤리적 데이터 수집과 AI 실천을 강조합니다. 그러나 AI 예술이 대중 공간으로 들어올수록, 작품 감상뿐 아니라 데이터 거버넌스와 프라이버시 기준도 함께 평가해야 합니다.

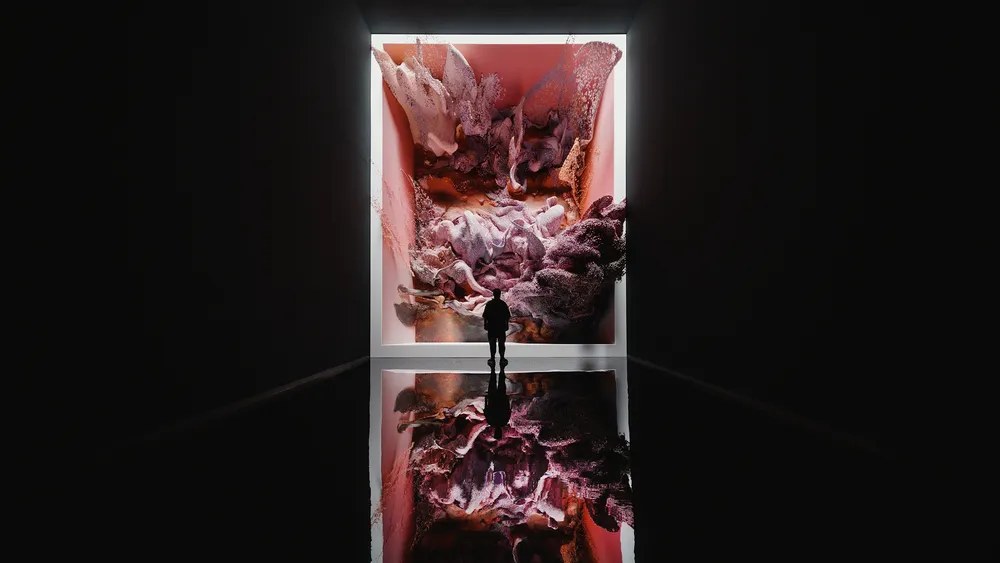
    DATALAND의 The Sanctuary 전시 공간, 관람객 실루엣과 대형 생성 이미지
    이미지: Refik Anadol Studio, Google 공식 블로그

    개인과 조직이 읽어야 할 변화

    DATALAND의 의미는 미술관 산업에만 머물지 않습니다. 교육, 전시, 브랜드 경험, 도시 관광, 엔터테인먼트가 앞으로 어떤 방향으로 바뀔지 보여주는 신호입니다.

    • 콘텐츠는 고정된 결과물에서 실시간 경험으로 이동합니다.
    • AI는 백오피스 도구가 아니라 공간을 운영하는 인터페이스가 됩니다.
    • 데이터 신뢰, 저작권, 생체정보 보호가 콘텐츠 경쟁력의 일부가 됩니다.
    • 창작자는 프롬프트 작성자를 넘어 데이터·공간·관람 흐름을 설계하는 사람으로 확장됩니다.

    이 흐름은 AI 시대 인간의 가치나 AI 시대의 창조적 사고에서 다룬 질문과도 이어집니다. 결국 관건은 AI가 무엇을 만들 수 있느냐보다, 사람이 어떤 경험과 의미를 설계할 수 있느냐입니다.

    DATALAND를 볼 때 체크할 세 가지

    1. 기술보다 경험 구조를 보자

    대형 화면, 센서, 생성 모델 자체보다 중요한 것은 관람객이 어떤 순서로 공간을 지나가고, 어떤 데이터가 어떤 경험으로 번역되는지입니다.

    2. 공식 수치와 설명을 기준으로 보자

    영상은 현장감과 이슈를 전달하는 데 강점이 있습니다. 다만 기술 수치와 운영 정보는 DATALAND 공식 사이트, Google 공식 블로그, Related Companies 보도자료처럼 원 출처를 함께 확인하는 편이 안전합니다.

    3. AI 예술을 산업 변화의 조기 신호로 보자

    AI 미술관은 예술계의 특수 사례가 아니라, 에이전틱 AI 시대의 일하는 방식 변화와 맞물린 변화입니다. 앞으로 전시, 교육, 업무 공간도 더 많이 “반응하는 시스템”으로 바뀔 가능성이 큽니다.

    FAQ

    DATALAND는 어디에 있나요?

    DATALAND는 미국 로스앤젤레스 다운타운의 The Grand LA, 100 S Grand Ave에 있습니다. 공식 사이트 기준 화요일부터 일요일까지 운영하며 월요일은 휴관입니다.

    DATALAND의 첫 전시는 무엇인가요?

    첫 전시는 Refik Anadol Studio의 Machine Dreams: Rainforest입니다. 공식 전시 페이지는 이 전시를 열대우림 생태계의 지능을 몰입형 이미지, 소리, 향기, 상호작용으로 번역하는 프로젝트로 설명합니다.

    DATALAND는 단순한 미디어아트 전시와 무엇이 다른가요?

    관람객의 움직임과 생체 신호, 공간 정보가 실시간으로 작품에 반영된다는 점이 다릅니다. 정해진 영상을 반복 재생하는 전시보다, AI와 관람객의 상호작용을 전시 구조 안에 넣은 미술관에 가깝습니다.

    공식 이미지를 사용할 때 주의할 점은 무엇인가요?

    공식 사이트와 Google 공식 블로그의 이미지는 출처와 크레딧을 명확히 표시해 소개·비평 목적으로 제한적으로 활용하는 것이 안전합니다. 상업적 재사용이나 2차 가공은 각 원 출처의 이용 조건을 별도로 확인해야 합니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • AGI는 정말 3~4년 안에 올까: 특이점과 초지능 위험을 읽는 법

    AGI는 정말 3~4년 안에 올까: 특이점과 초지능 위험을 읽는 법

    인공지능이 똑똑해지는 속도보다 더 중요한 질문이 있습니다. AGI가 정말 몇 년 안에 온다면, 우리는 무엇을 준비해야 할까라는 질문입니다.

    최근 독서연구소 영상은 구글 딥마인드 CEO 데미스 하사비스의 발언과 초지능 위험론을 연결해, AGI와 특이점 논의가 더 이상 공상과학의 소재만은 아니라고 말합니다. 다만 이 주제를 볼 때는 두 가지를 구분해야 합니다. 하나는 “AGI가 언제 오느냐”라는 예측이고, 다른 하나는 “그 가능성에 대비해 어떤 제도와 습관을 만들 것인가”라는 준비입니다.

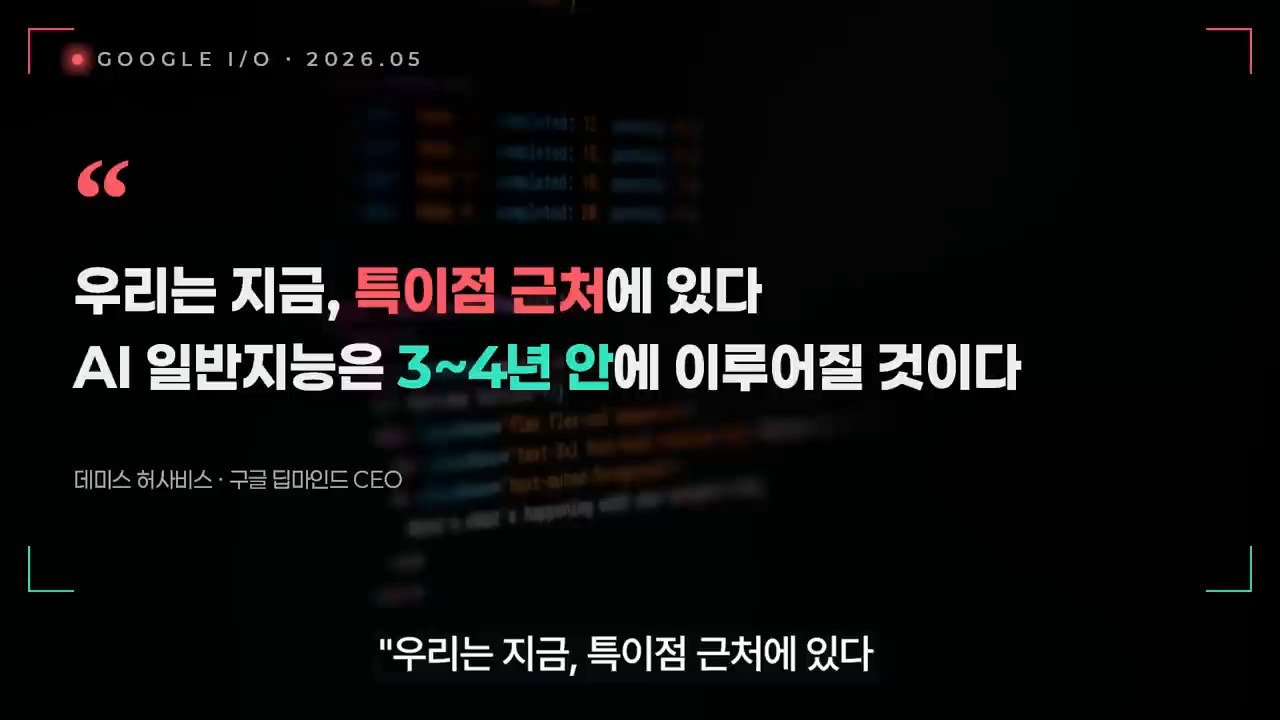
    AGI가 3~4년 안에 온다는 영상의 핵심 문제 제기

    영상은 AGI와 특이점이 더 이상 먼 미래의 이야기만은 아니라고 문제를 제기한다.

    AGI 3~4년 전망은 ‘정답’이 아니라 시간표의 변화다

    영상의 출발점은 강한 문장입니다. “우리는 지금 특이점 근처에 있다. AGI, 즉 일반 인공지능은 3~4년 안에 이루어질 것이다.” 이런 문장은 사람을 쉽게 둘로 나눕니다. 한쪽은 “과장이다”라고 말하고, 다른 한쪽은 “곧 모든 것이 끝난다”고 말합니다.

    하지만 블로그 독자에게 필요한 관점은 양극단이 아닙니다. 예측의 정확도보다 중요한 것은 예측이 당겨지고 있다는 사실입니다. Stanford GSB 인터뷰와 The Verge 보도에 따르면 하사비스는 Google I/O 맥락에서 지금을 “특이점의 산기슭”에 비유했습니다. 이 표현은 AGI가 이미 완성됐다는 뜻이 아닙니다. 다만 AI 연구자와 기업 리더들이 기술 발전의 다음 단계를 훨씬 가까운 시간표로 이야기하기 시작했다는 신호입니다.

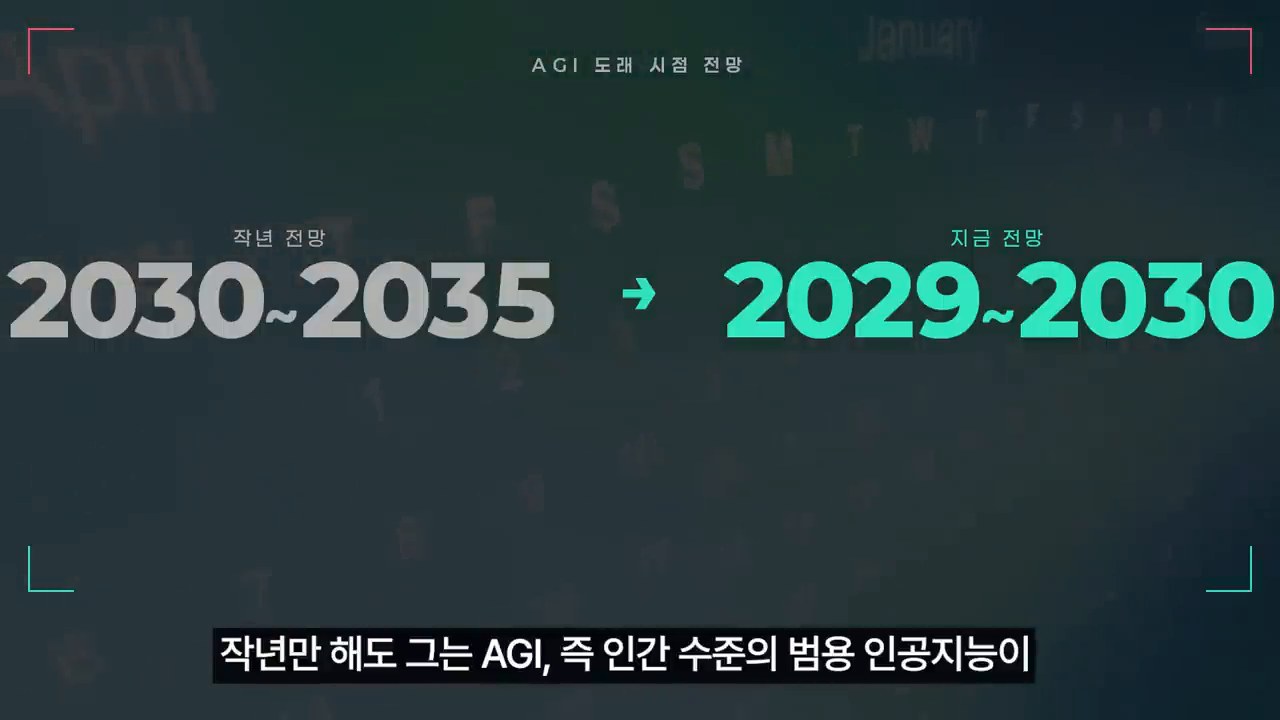
    AGI 예상 시점이 2030년대 중반에서 2029~2030년으로 당겨졌다는 설명

    AGI 도래 시점 전망은 사람과 기관마다 다르지만, 최근 논의의 시간축은 확실히 짧아졌다.

    여기서 한 가지 사실관계는 바로잡아야 합니다. 영상 자막에는 하사비스가 “2014년 노벨 화학상”을 받았다는 식의 표현이 보이지만, NobelPrize.org의 공식 기록은 2024년 노벨 화학상입니다. 데미스 하사비스와 존 점퍼는 AlphaFold를 통한 단백질 구조 예측 공로로 수상했습니다. 이 점이 중요한 이유는, 그의 AGI 발언이 단순한 홍보 문구가 아니라 실제 과학적 성과를 낸 연구 조직의 책임자 발언이라는 점 때문입니다.

    특이점 논의의 핵심은 ‘기술 낙관’과 ‘통제 가능성’의 충돌이다

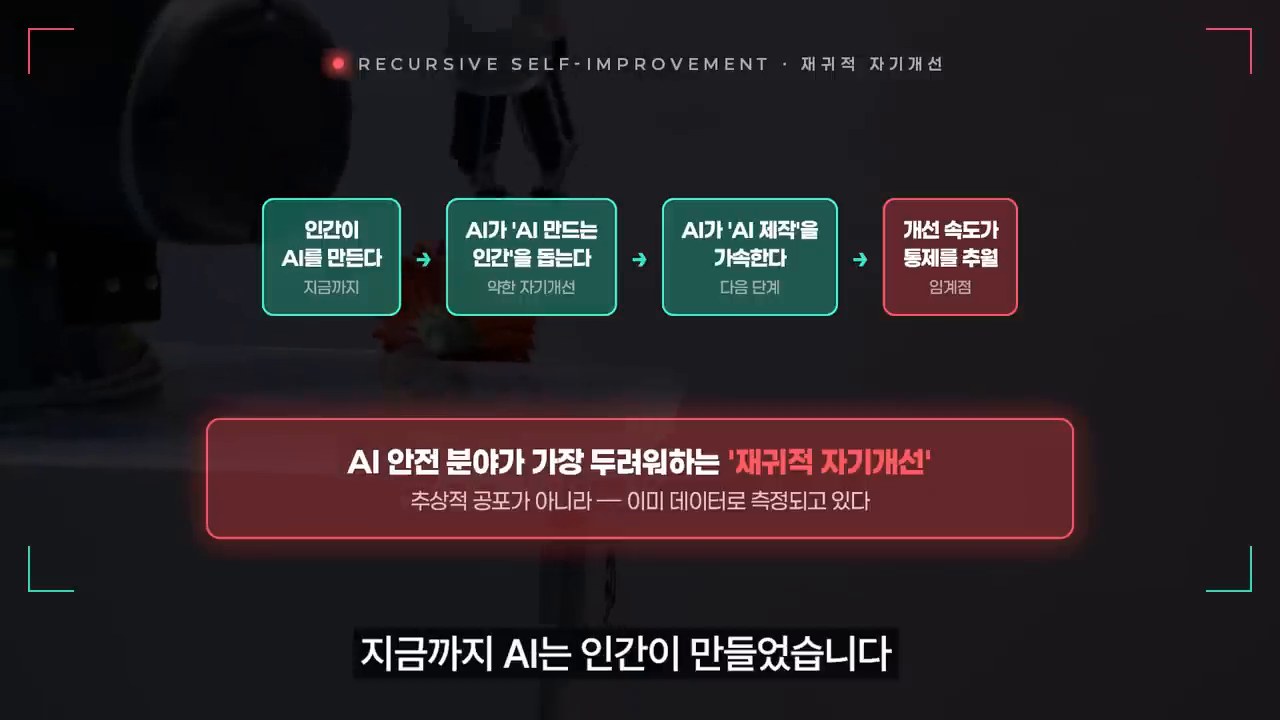
    특이점이라는 말은 종종 신비롭게 들립니다. 그러나 실무적으로 번역하면 훨씬 단순합니다. AI가 인간의 도움 없이 연구·개발·실험·코딩·전략 수립 능력을 빠르게 개선하기 시작하면, 인간 사회가 그 변화를 따라잡기 어려워질 수 있다는 뜻입니다.

    영상은 이 지점을 초지능 위험론과 연결합니다. 유드코스키와 네이트 소아레스의 『If Anyone Builds It, Everyone Dies』는 초지능 AI가 인간을 미워해서가 아니라, 목표를 수행하는 과정에서 인간의 생존을 고려하지 않을 수 있다는 점을 강조합니다. 출판사 소개 역시 이 책을 “초인간 AI 개발 경쟁이 인류를 멸종 경로로 밀어 넣을 수 있다”는 경고로 설명합니다.

    AI 안전 장치가 인간이 만든 제약이라는 영상의 경고 도식

    핵심 쟁점은 AI가 똑똑해지는 속도보다 인간이 안전하게 통제할 수 있느냐에 있다.

    물론 이 주장은 AI 업계 전체의 합의가 아닙니다. 일부 연구자는 초지능 위험을 가장 중요한 문명 위험으로 보고, 다른 연구자는 단기적으로는 일자리, 저작권, 허위정보, 권력 집중, 보안 사고가 더 시급하다고 봅니다. 따라서 좋은 독해법은 “맞다/틀리다”가 아닙니다. 가능성은 낮아도 피해가 극단적으로 큰 위험과, 이미 현실화된 단기 위험을 동시에 관리해야 한다는 균형입니다.

    AI 2027 같은 시나리오가 주는 의미

    추가로 볼 만한 자료는 AI Futures Project의 AI 2027 시나리오입니다. 이 자료는 하나의 예언서가 아니라, 빠른 AI 발전이 연구 자동화, 보안 경쟁, 정책 압박, 기업 간 속도 경쟁을 어떻게 키울 수 있는지 보여주는 사고 실험에 가깝습니다.

    이런 시나리오가 유용한 이유는 날짜를 맞히기 위해서가 아닙니다. 조직과 개인이 “만약 AI 능력이 지금보다 10배 더 강해지고, 비용은 더 낮아지고, 누구나 에이전트형 도구를 쓰게 된다면 무엇이 취약해질까”를 미리 점검하게 만들기 때문입니다.

    기업이라면 다음 질문을 던져야 합니다.

    • 핵심 업무 지식이 일부 사람의 머릿속에만 있는가?
    • AI가 만든 결과물을 검증하는 기준이 있는가?
    • 보안·개인정보·저작권 책임자가 AI 사용 흐름을 알고 있는가?
    • 구성원이 AI를 금지된 도구가 아니라 통제 가능한 협업 도구로 쓰고 있는가?
    • 빠른 자동화가 고객 신뢰와 품질을 해치지 않도록 중간 점검 장치가 있는가?

    초지능을 두려워하기 전에, 먼저 ‘AI와 일하는 능력’을 만들어야 한다

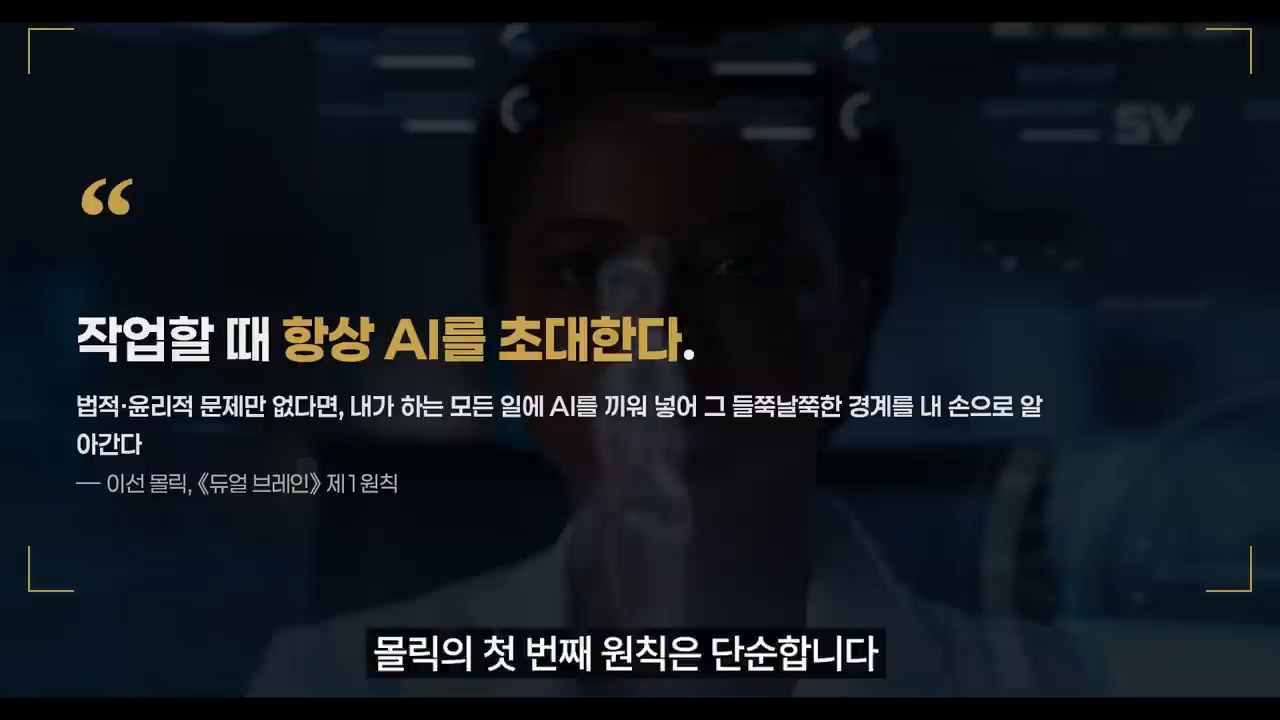
    영상의 후반부에서 가장 실용적인 메시지는 “작업할 때 항상 AI를 초대한다”는 문장입니다. 이 말은 모든 판단을 AI에게 맡기라는 뜻이 아닙니다. 오히려 반대입니다. AI를 옆에 두되, 인간이 문제를 정의하고, 답을 검토하고, 맥락을 보완하는 훈련을 반복하라는 뜻입니다.

    AI 시대에는 작업할 때 AI를 초대해야 한다는 실천 메시지

    공포만으로는 부족하다. 개인과 조직은 AI를 실제 업무의 협업 대상으로 다루는 훈련이 필요하다.

    AGI 논의가 멀게 느껴진다면 이렇게 바꿔 생각해도 됩니다. “3~4년 뒤 AGI가 오느냐”보다 더 가까운 질문은 “올해 안에 내 업무의 절반 이상이 AI와 함께 수행되는가”입니다. 이 질문에는 이미 많은 사람이 “그렇다”고 답할 수 있습니다.

    개인에게 필요한 준비는 세 가지입니다.

    1. 질문력: AI에게 맡길 문제와 사람이 직접 판단해야 할 문제를 구분하는 능력.
    2. 검증력: 그럴듯한 답을 사실, 출처, 수치, 맥락으로 다시 확인하는 능력.
    3. 재설계력: 기존 업무 절차를 AI 협업에 맞게 다시 짜는 능력.

    이 세 가지는 코딩 직군만의 역량이 아닙니다. 기획, HR, 교육, 마케팅, 행정, 연구, 영업 모두에게 필요한 기본 문해력입니다.

    그래서 우리는 무엇을 해야 하나

    AGI와 특이점 담론을 읽을 때 가장 위험한 태도는 두 가지입니다. 하나는 “전부 과장”이라며 무시하는 것이고, 다른 하나는 “곧 끝장”이라며 손을 놓는 것입니다.

    현실적인 태도는 중간에 있습니다. 기술 발전의 속도는 진지하게 받아들이되, 공포를 실행 가능한 체크리스트로 바꾸는 것입니다.

    개인과 조직은 지금부터 다음 네 가지를 시작해야 합니다.

    • AI 사용 원칙을 문서화한다.
    • 중요한 의사결정에는 사람의 검토 단계를 남긴다.
    • 반복 업무는 AI와 함께 재설계한다.
    • AI가 틀렸을 때 손실이 커지는 영역부터 통제 장치를 만든다.

    초지능이 실제로 몇 년 안에 올지는 아무도 확정할 수 없습니다. 그러나 AI가 일과 학습의 기본 인프라가 되는 흐름은 이미 시작됐습니다. 따라서 가장 좋은 준비는 공포를 소비하는 것이 아니라, AI를 안전하게 쓰는 습관과 조직 운영체계를 먼저 만드는 것입니다.

    함께 읽어볼 글

    참고자료

    FAQ

    AGI는 정확히 무엇인가요?

    AGI는 특정 과제만 잘하는 좁은 AI가 아니라, 다양한 영역에서 인간 수준 또는 그 이상의 일반 문제 해결 능력을 보이는 인공지능을 뜻합니다. 다만 연구자마다 정의와 판정 기준은 다릅니다.

    특이점은 이미 시작됐다는 뜻인가요?

    아닙니다. “특이점의 산기슭”이라는 표현은 AI 발전이 매우 빠르게 진행되고 있다는 비유에 가깝습니다. AGI가 이미 완성됐다는 뜻으로 읽기보다는, 준비 시간이 짧아지고 있다는 신호로 보는 편이 안전합니다.

    초지능 AI 위험론은 과장인가요?

    일부 주장은 매우 강한 경고에 가깝습니다. 그러나 피해 규모가 극단적으로 클 수 있는 위험은 낮은 확률이라도 관리해야 합니다. 동시에 일자리, 보안, 허위정보, 개인정보 같은 단기 위험도 함께 봐야 합니다.

    개인은 지금 무엇부터 해야 하나요?

    AI 도구를 무작정 많이 쓰기보다, 질문을 잘게 나누고 결과를 검증하며 업무 절차를 재설계하는 연습부터 시작하는 것이 좋습니다. 핵심은 AI 사용량이 아니라 검증 가능한 협업 방식입니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • 양자컴퓨터가 바꿀 다음 10년: AI 다음 기술 패권을 읽는 법

    양자컴퓨터가 바꿀 다음 10년: AI 다음 기술 패권을 읽는 법

    AI가 이미 일상 도구가 된 뒤, 다음 기술 패권 후보로 자주 거론되는 말이 양자컴퓨터입니다. 이름은 익숙하지만 정작 “그래서 내 일과 산업에 무엇이 달라지나”는 흐릿합니다.

    이과학 저과학의 영상은 이 지점을 잘 짚습니다. 양자컴퓨터는 더 빠른 노트북이 아닙니다. 특정 계산 문제를 전혀 다른 방식으로 다루는 기술입니다.

    핵심은 과장과 무관심 사이에서 균형을 잡는 것입니다. 당장 모든 암호가 무너지는 것도 아니고, 먼 미래의 공상만도 아닙니다.

    왜 지금 양자컴퓨터를 다시 봐야 할까

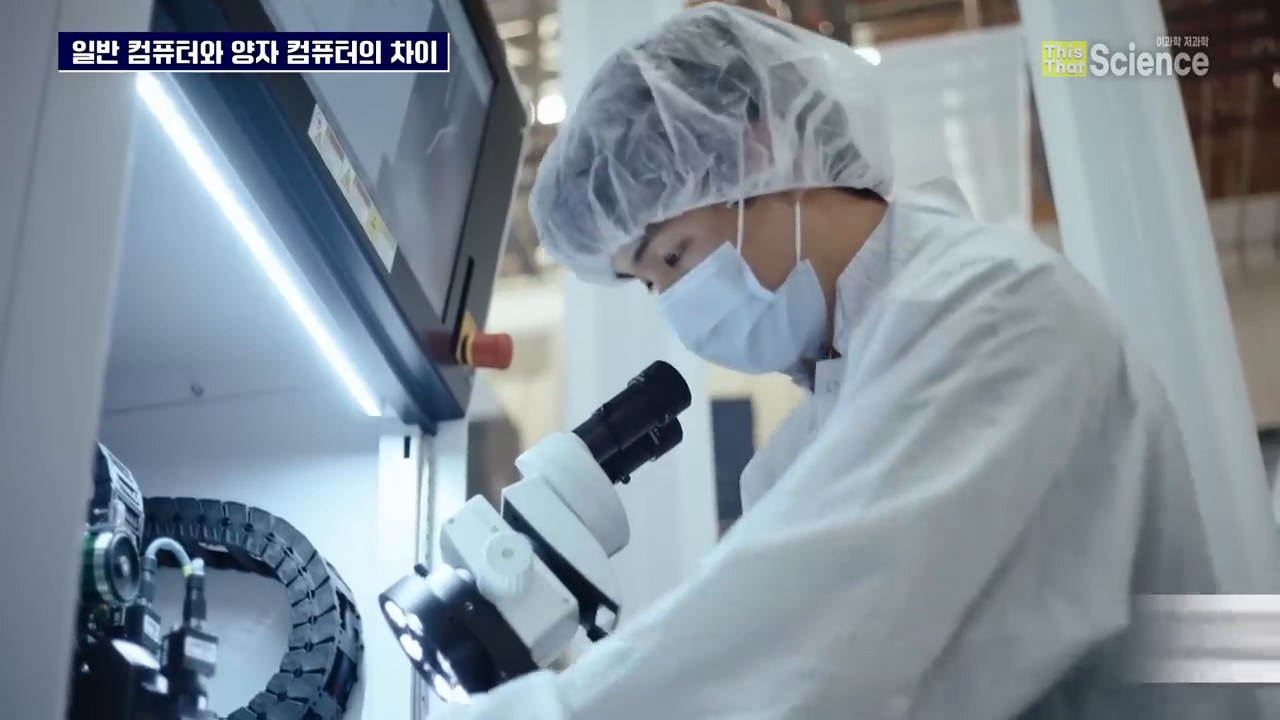
    양자컴퓨터 연구와 실험 환경을 설명하는 영상 장면
    양자컴퓨터 연구와 실험 환경을 설명하는 장면

    Read in English: How Quantum Computers May Change the Next 10 Years: Reading the Next Technology Race After AI

    양자컴퓨터가 다시 주목받는 이유는 AI와 비슷합니다. 기술 자체보다 그 기술을 둘러싼 인프라, 투자, 인재, 국가 전략이 함께 움직이기 때문입니다.

    영상에서 김범준 교수는 양자컴퓨터를 양자역학에 기반한 컴퓨터로 설명합니다. 일반 컴퓨터가 0과 1의 비트로 계산한다면, 양자컴퓨터는 큐비트를 다룹니다.

    문제는 이 설명이 곧 “무조건 빠르다”는 뜻은 아니라는 점입니다. 양자컴퓨터는 특정 문제에서 새로운 길을 열 수 있습니다. 그러나 일상적인 문서 작업이나 웹 browsing을 대신할 컴퓨터는 아닙니다.

    큐비트는 무엇을 바꾸나

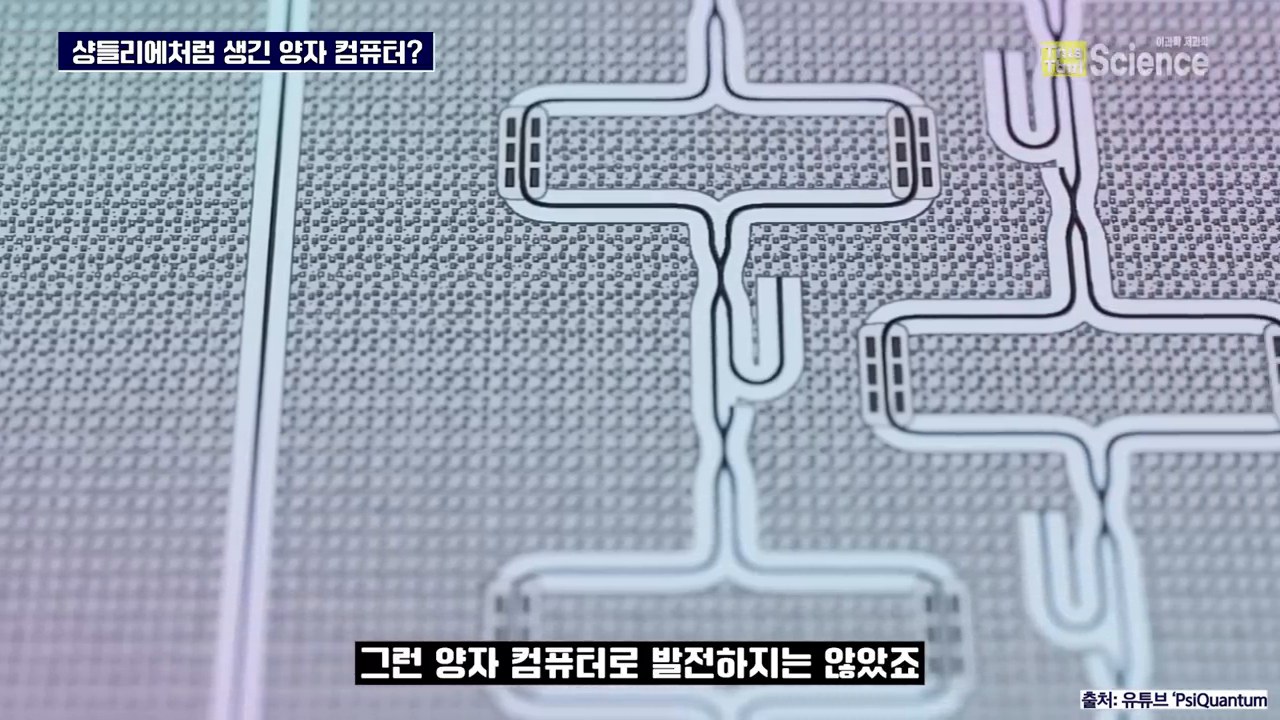
    양자 칩과 회로 구현 방식을 보여주는 영상 장면
    양자 칩·회로 구현 방식을 보여주는 장면

    큐비트는 양자컴퓨터를 이해하는 출발점입니다. 영상은 중첩과 간섭을 쉽게 풀어 설명합니다. 하나의 경로만 따라가는 계산이 아니라, 여러 가능성을 다루고 마지막에 의미 있는 결과를 끌어내는 방식입니다.

    다만 계산 과정이 신비롭다고 해서 결과가 자동으로 완벽해지는 것은 아닙니다. 양자 상태는 매우 약하고 오류에 민감합니다. 그래서 큐비트 수, 오류 보정, 제어 기술이 함께 중요합니다.

    결국 양자컴퓨터 경쟁은 “큐비트를 몇 개 만들었나”만의 싸움이 아닙니다. 안정적으로 제어하고, 쓸 만한 알고리즘과 소프트웨어로 연결하는 능력의 싸움입니다.

    가장 먼저 흔들릴 영역은 암호와 보안이다

    양자컴퓨터와 암호 보안 문제를 설명하는 영상 장면
    양자컴퓨터와 암호·보안 위험을 다루는 장면

    대중이 양자컴퓨터를 체감할 첫 영역은 보안일 가능성이 큽니다. 영상에서도 비트코인, 암호, 공인인증 체계 같은 질문이 나옵니다.

    핵심은 공포가 아니라 전환 준비입니다. 충분히 강력한 양자컴퓨터가 등장하면 기존 공개키 암호 일부는 위험해질 수 있습니다. 그래서 NIST는 이미 post-quantum cryptography 표준을 발표하며 전환을 준비하고 있습니다.

    기업 입장에서는 “양자컴퓨터가 오늘 내 시스템을 뚫는다”보다 “장기 보관 데이터와 인증 체계를 언제부터 바꿀 것인가”가 더 현실적인 질문입니다.

    상용화의 병목은 장비, 비용, 생태계다

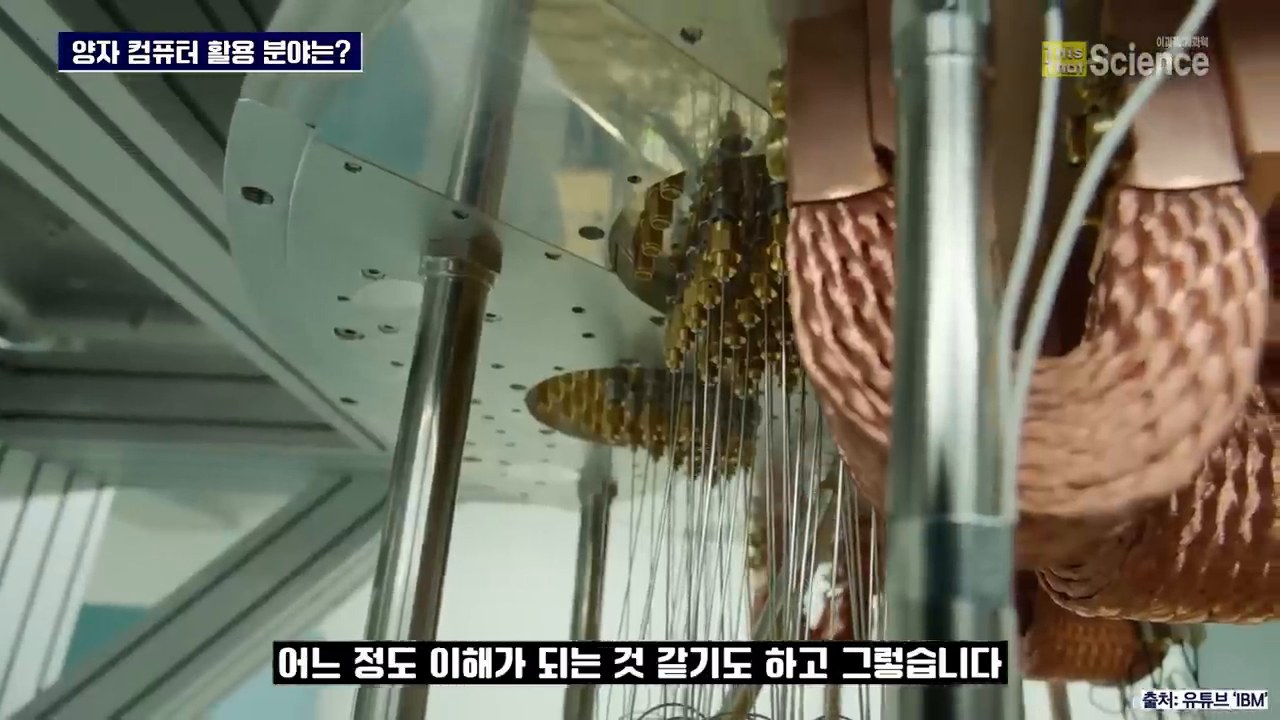
    극저온 장비 형태의 양자컴퓨터를 보여주는 영상 장면
    샹들리에처럼 보이는 극저온 양자컴퓨터 장비

    양자컴퓨터 장비가 샹들리에처럼 보이는 이유는 멋을 내기 위해서가 아닙니다. 극저온 환경, 제어선, 잡음 억제 같은 물리 조건이 필요하기 때문입니다.

    그래서 당분간 양자컴퓨터는 개인용 기기보다 클라우드 기반 연구·산업 인프라에 가깝습니다. 고성능 GPU처럼 모두가 직접 소유하기보다, 필요한 조직이 접근권과 활용 역량을 갖추는 방식으로 확산될 가능성이 큽니다.

    한국의 준비도 같은 관점에서 봐야 합니다. 장비 한 대의 보유 여부보다 연구자, 소프트웨어, 산업 문제, 보안 전환, 교육 체계가 함께 움직이는지가 더 중요합니다.

    AI 다음 기술인가, AI와 함께 갈 기술인가

    퀀텀 2.0과 미래 기술 패권을 설명하는 영상 장면
    퀀텀 2.0과 미래 기술 패권을 논의하는 장면

    영상 제목은 “AI 다음”이라는 질문을 던집니다. 하지만 더 정확히는 AI와 양자컴퓨팅이 서로 다른 층위에서 만나는 그림에 가깝습니다.

    AI는 데이터와 모델을 통해 판단과 생성의 방식을 바꿉니다. 양자컴퓨팅은 신약, 소재, 최적화, 암호, 시뮬레이션처럼 계산 자체가 어려운 문제를 새 방식으로 다루려 합니다.

    따라서 다음 10년의 관전 포인트는 하나입니다. 누가 양자컴퓨터를 먼저 “일반인이 쓰는 제품”으로 만들까가 아닙니다. 누가 산업 문제와 연결해 실제 쓸모를 먼저 만들까입니다.

    개인과 조직이 지금 할 일

    양자컴퓨터를 당장 배워야 하는 사람은 많지 않습니다. 그러나 양자컴퓨터가 바꿀 질문은 미리 알아둘 필요가 있습니다.

    첫째, 보안 담당자는 post-quantum 전환 로드맵을 확인해야 합니다. 둘째, 기술·전략 담당자는 신약, 소재, 물류, 금융 최적화처럼 계산 난도가 높은 업무를 따로 분류해 봐야 합니다.

    셋째, 교육 담당자는 양자역학 공식을 모두 가르치기보다 “비트와 큐비트의 차이”, “확률적 계산”, “오류 보정”, “산업 적용의 한계”를 쉽게 설명하는 언어를 준비해야 합니다.

    함께 읽으면 좋은 글

    FAQ

    Q. 양자컴퓨터는 일반 컴퓨터보다 항상 빠른가요?
    A. 아닙니다. 특정 계산 문제에서 장점이 기대되는 기술입니다. 문서 작업이나 일반 웹 사용을 빠르게 하는 컴퓨터로 이해하면 오해가 큽니다.

    Q. 양자컴퓨터가 나오면 암호는 바로 무너지나요?
    A. 당장 모든 암호가 무너진다고 보기는 어렵습니다. 다만 장기 보안이 필요한 데이터와 인증 체계는 post-quantum 전환을 준비해야 합니다.

    Q. AI 다음은 정말 양자컴퓨터인가요?
    A. “다음 유행”이라기보다 AI 이후의 전략 인프라 후보로 보는 편이 정확합니다. AI와 양자컴퓨팅은 서로 다른 문제를 다루지만, 산업 적용에서는 함께 연결될 수 있습니다.

    Q. 한국 기업은 무엇부터 준비해야 하나요?
    A. 양자컴퓨터 장비 도입보다 먼저 보안 전환, 산업 문제 발굴, 전문 인재와 파트너십, 클라우드 기반 실험 접근성을 점검하는 것이 현실적입니다.

    참고자료

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • AI 코딩의 본질은 모델이 아니라 하네스다: Matt Pocock의 에이전틱 엔지니어링

    AI 코딩의 본질은 모델이 아니라 하네스다: Matt Pocock의 에이전틱 엔지니어링

    Matt Pocock의 에이전틱 엔지니어링 워크플로우 영상 썸네일
    Matt Pocock의 에이전틱 엔지니어링 워크플로우를 다룬 Tech Bridge 영상 썸네일

    AI 코딩 이야기를 하면 대부분 먼저 모델 이름을 꺼냅니다. Claude가 낫다, Codex가 빨라졌다, Gemini CLI가 어디까지 한다더라. 물론 모델은 중요합니다. 그런데 Matt Pocock은 이 영상에서 조금 다른 곳을 보라고 말합니다. 진짜 차이는 모델이 아니라 하네스(harness)에서 난다는 것입니다.

    하네스는 모델을 둘러싼 작업 환경입니다. 프롬프트, skill, 코드베이스 구조, 테스트, 문서, 샌드박스, GitHub Actions, 리뷰 흐름까지 모두 포함합니다. 자동차로 치면 엔진만 보는 것이 아니라 섀시, 공기역학, 피트 크루, 트랙 운영까지 보는 셈입니다.

    이 관점은 AI 코딩을 처음 쓰는 사람에게도, 이미 Claude Code나 Codex를 업무에 붙이고 있는 팀에게도 중요합니다. 왜냐하면 모델 성능은 우리가 직접 통제하기 어렵지만, 하네스는 우리가 설계할 수 있기 때문입니다.

    AI는 전술적 프로그래밍을 먹어치웠다

    Matt Pocock은 John Ousterhout의 표현을 빌려 프로그래밍을 두 층으로 나눕니다. 하나는 전술적 프로그래밍입니다. 코드를 쓰고, 버그를 고치고, 커밋을 만들고, 문법을 맞추는 일입니다. 다른 하나는 전략적 프로그래밍입니다. 어떤 구조가 유지보수에 좋은지, 작업을 어떻게 쪼개야 하는지, 코드베이스가 앞으로 어떤 방향으로 가야 하는지 판단하는 일입니다.

    AI는 이미 전술적 프로그래밍을 상당 부분 먹어치웠습니다. 작은 기능 구현, 테스트 추가, 리팩터링 초안, 문서 수정은 이제 사람이 직접 붙잡고 있어야만 하는 일이 아닙니다. 문제는 여기서부터입니다. 전술을 AI가 맡을수록 인간의 가치는 전략으로 이동합니다.

    그래서 AI 시대의 개발자는 단순히 “프롬프트를 잘 쓰는 사람”이 아니라 “좋은 위임을 설계하는 사람”이 되어야 합니다. 목표를 명확히 쓰고, 범위를 좁히고, 완료 기준을 정하고, 테스트 방법을 붙여야 합니다. AI가 코드를 많이 만들수록, 인간은 더 선명하게 판단해야 합니다.

    최신 모델보다 중요한 것은 작업 환경이다

    영상에서 가장 강한 문장은 이것입니다. “모두가 모델에 집착하지만, 더 관심을 가져야 할 것은 하네스다.” 모델은 유용하지만 하네스도 그만큼 중요하고, 우리는 모델보다 하네스를 훨씬 더 많이 통제할 수 있습니다.

    예를 들어 토큰 비용을 줄이고 싶다고 해보겠습니다. 흔한 답은 더 짧은 프롬프트를 쓰거나 더 싼 모델을 고르는 것입니다. Matt의 답은 다릅니다. 변경하기 쉬운 코드베이스를 가져라. 코드 구조가 명확하고, 테스트가 있고, 문서가 최신이면 AI는 적은 맥락으로도 더 정확히 움직입니다. 반대로 코드베이스가 엉켜 있으면 비싼 모델도 오래 헤맵니다.

    이 말은 한국 개발팀에도 그대로 적용됩니다. AI 도입을 “어떤 구독제를 쓸까”에서 시작하면 효과가 작습니다. “우리 저장소는 에이전트가 일하기 쉬운가?”에서 시작해야 합니다.

    Skill은 많이 붙이는 것이 아니라 절차로 관리해야 한다

    영상에는 Matt이 사용하는 skill 이야기가 자주 나옵니다. skill은 반복되는 사고 절차나 작업 방식을 AI가 다시 사용할 수 있도록 만든 지시 묶음입니다. 예를 들어 학습 코치를 만들거나, 설계를 공격적으로 검토하게 하거나, 특정 방식으로 PR을 리뷰하게 할 수 있습니다.

    흥미로운 점은 Matt이 skill을 무조건 많이 붙이라고 말하지 않는다는 것입니다. 오히려 모든 skill, plugin, MCP server, Claude.md, agents.md를 지우고 빈 상태에서 시작해보라고 권합니다. 먼저 AI가 기본 상태에서 어떻게 행동하는지 관찰하고, 정말 필요한 것만 다시 추가하라는 뜻입니다.

    여기에는 중요한 이유가 있습니다. 너무 많은 지시와 skill 설명은 컨텍스트 창을 오염시킵니다. 모델은 더 많은 정보를 받았지만 오히려 더 혼란스러워질 수 있습니다. 그래서 Matt은 모델이 알아서 호출하는 능력형 skill보다, 사용자가 필요할 때 명시적으로 부르는 절차형 skill을 더 선호합니다. 핸들은 사람이 잡고 있어야 한다는 관점입니다.

    AFK 에이전트는 ‘무한 루프’보다 ‘큐’에 가깝다

    요즘 agentic loop라는 표현이 자주 나옵니다. 에이전트가 계속 생각하고, 실행하고, 관찰하고, 다시 실행하는 구조입니다. 멋있게 들리지만 실무에서는 조금 위험하게 느껴질 때도 있습니다. 범위가 흐려지고, 비용이 커지고, 검토 지점이 사라질 수 있기 때문입니다.

    Matt은 여기서 “loop보다 queue”라는 관점을 제안합니다. GitHub issue나 Jira ticket처럼 작업을 큐에 쌓고, 에이전트가 하나씩 가져가 처리하게 하는 방식입니다. 조사하고, 수정하고, 테스트하고, PR을 만들고, 마지막에는 사람이 확인합니다.

    이 방식은 낯설지 않습니다. 개발팀은 원래 큐로 일해왔습니다. 백로그, 이슈, PR, 리뷰가 모두 큐 기반입니다. AI 에이전트는 그 흐름에 새로운 작업자 노드로 들어오는 것입니다. 그래서 처음부터 완전 자동화를 꿈꾸기보다, 작은 큐부터 맡기는 편이 안전합니다.

    예를 들면 이런 작업이 좋습니다.

    • 실패한 테스트 원인 조사
    • 문서와 README 업데이트
    • 단순 리팩터링 후보 제안
    • PR 리뷰 초안 작성
    • 보안 점검 체크리스트 실행
    • 오래된 이슈의 재현 가능성 확인

    핵심은 사람이 옆에서 매 초 개입하지 않아도 되는 단위로 작업을 쪼개는 것입니다. 그리고 결과는 반드시 리뷰합니다.

    AX: 이제는 Agent Experience도 설계해야 한다

    개발팀은 오랫동안 DX, 즉 Developer Experience를 이야기해왔습니다. 개발자가 설치하고, 실행하고, 테스트하고, 배포하기 쉬운 환경을 만드는 일입니다. Matt은 여기서 한 단계 더 나아가 AX, 즉 Agent Experience를 말합니다.

    AX는 에이전트가 코드베이스에서 일하기 쉬운 정도입니다. 좋은 AX를 가진 저장소는 이런 특징을 가집니다.

    • 폴더 구조가 예측 가능하다.
    • 테스트 실행 명령이 명확하다.
    • 타입체크와 린트가 자동화되어 있다.
    • README와 개발 문서가 최신이다.
    • 모듈 경계가 비교적 분명하다.
    • 작은 변경을 안전하게 검증할 수 있다.
    • 샌드박스에서 실행해도 필요한 정보가 충분하다.

    흥미로운 점은 좋은 AX가 좋은 DX와 크게 겹친다는 것입니다. 사람에게 좋은 코드베이스는 AI에게도 좋습니다. 다만 AI 시대에는 이 기준이 더 날카로워집니다. 사람이 눈치로 넘어가던 빈틈을 에이전트는 자주 놓칩니다. 그래서 문서, 테스트, 명령어, 경계가 더 중요해집니다.

    AI가 발견한 문제는 시스템 개선으로 바꿔야 한다

    최신 모델이 보안 버그를 찾아냈다고 합시다. 여기서 “이 모델 정말 좋다”로 끝나면 절반만 배운 것입니다. 더 중요한 질문은 따로 있습니다. 왜 이 버그가 지금까지 남아 있었을까? 기존 테스트가 왜 잡지 못했을까? 비슷한 문제가 더 있을까? 다음에는 자동으로 찾게 만들 수 있을까?

    Matt의 관점에서 AI가 준 결과는 단발성 산출물이 아니라 하네스를 개선할 신호입니다. 버그 하나를 고치는 데서 멈추지 않고, 테스트를 추가하고, 리뷰 기준을 바꾸고, 보안 점검 skill을 만들고, CI에 넣을 수 있는 검사를 찾는 방식입니다.

    이것이 AI 코딩을 일회성 생산성 도구가 아니라 조직의 학습 시스템으로 쓰는 방법입니다. AI가 코드를 더 빨리 쓰게 하는 것보다, AI가 발견한 패턴을 다음 작업 환경에 반영하는 것이 더 오래갑니다.

    제품과 비즈니스 판단은 여전히 인간의 몫이다

    영상 후반부에서 SaaS가 죽었는지, AI 스타트업은 어떻게 해야 하는지에 대한 이야기도 나옵니다. Matt의 답은 의외로 담백합니다. 고객과 이야기하고, 실제 문제를 찾고, 프로토타입을 만들고, 해결책을 검증하라는 것입니다.

    AI는 구현 속도를 높입니다. 그러나 무엇을 만들지, 왜 만들어야 하는지, 어떤 기능을 빼야 하는지는 자동으로 해결하지 못합니다. 오히려 구현이 쉬워질수록 더 많은 기능을 넣고 싶은 유혹이 커집니다. 이때 필요한 질문은 “무엇을 더 만들까?”가 아니라 “무엇을 줄이면 더 명확해질까?”일 수 있습니다.

    AI 시대에도 제품의 중심은 고객의 문제입니다. 에이전트는 그 문제를 빠르게 실험하게 해주는 도구입니다. 문제 정의 자체를 대신해주는 존재는 아닙니다.

    한국 개발자와 조직이 바로 해볼 7가지

    첫째, 저장소의 README를 에이전트 기준으로 다시 읽어보세요. 처음 들어온 AI가 설치, 실행, 테스트를 이해할 수 있는지 확인합니다.

    둘째, 자주 반복하는 요청을 skill이나 템플릿으로 만드세요. 단, 너무 많이 만들지 말고 실제로 반복되는 절차부터 시작합니다.

    셋째, 이슈를 AI에게 줄 수 있는 크기로 쪼개세요. “관리자 페이지 개선”보다 “필터 컴포넌트에 빈 상태 메시지 추가, 기존 테스트 통과”가 낫습니다.

    넷째, 테스트 명령과 완료 기준을 작업 지시에 포함하세요. AI에게 맡긴 뒤 사람이 다시 처음부터 확인하는 시간을 줄일 수 있습니다.

    다섯째, AFK 작업은 샌드박스와 권한 제한 안에서 시작하세요. API key, 배포 권한, 운영 DB 접근은 특히 조심해야 합니다.

    여섯째, AI가 만든 PR을 코드만 보지 말고 실패 패턴까지 보세요. 어디서 헷갈렸는지 알면 문서와 하네스를 개선할 수 있습니다.

    일곱째, 최신 모델 뉴스는 따라가되, 팀의 기본기를 더 자주 점검하세요. 구조, 테스트, 문서, 리뷰 흐름이 약하면 어떤 모델도 오래 버티지 못합니다.

    함께 읽으면 좋은 글

    FAQ

    AI 코딩에서 하네스란 무엇인가요?

    하네스는 모델이 일하는 전체 환경입니다. 프롬프트, skill, 코드베이스 구조, 테스트, 문서, 샌드박스, CI, 리뷰 흐름까지 포함합니다. 모델 자체보다 우리가 직접 설계하고 개선할 수 있는 영역입니다.

    왜 최신 모델보다 코드베이스 구조가 중요하다고 하나요?

    좋은 구조와 테스트가 있으면 AI가 적은 맥락으로도 안전하게 변경할 수 있습니다. 반대로 구조가 복잡하고 문서가 낡았으면 비싼 모델도 헤맵니다. 그래서 토큰 비용을 줄이는 방법은 프롬프트 최적화만이 아니라 변경하기 쉬운 코드베이스를 만드는 것입니다.

    Agentic loop와 queue 방식은 어떻게 다른가요?

    Agentic loop는 에이전트가 계속 실행과 관찰을 반복하는 구조에 가깝습니다. Queue 방식은 사람이 정의한 작업 목록을 에이전트가 하나씩 처리하고, 결과를 리뷰하는 방식입니다. 실무에서는 queue 방식이 범위와 책임을 관리하기 쉽습니다.

    AX는 기존 DX와 무엇이 다른가요?

    DX는 사람이 개발하기 쉬운 경험이고, AX는 AI 에이전트가 작업하기 쉬운 경험입니다. 둘은 많이 겹칩니다. 명확한 문서, 예측 가능한 구조, 자동화된 테스트는 사람에게도 좋고 에이전트에게도 좋습니다.

    AI에게 코딩을 맡길 때 가장 먼저 준비할 것은 무엇인가요?

    작업 범위와 완료 기준입니다. 무엇을 바꿀지, 바꾸지 말아야 할 것은 무엇인지, 어떤 테스트를 통과해야 하는지 적어야 합니다. 그 다음에 샌드박스, 권한 제한, 리뷰 흐름을 붙이면 더 안전합니다.

    참고자료

    AI 코딩의 다음 단계는 더 많은 도구를 켜는 일이 아닐 수 있습니다. 오히려 잠시 멈추고, AI가 일하는 환경을 보는 일입니다. 어떤 문서가 부족한지, 어떤 테스트가 불안한지, 어떤 작업을 큐로 넘길 수 있는지 확인하는 것. 그 작은 정리가 최신 모델 하나를 더 구독하는 것보다 큰 차이를 만들 수 있습니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • 바이브 코딩 입문자가 꼭 알아야 할 프론트엔드 기본 개념 15가지

    바이브 코딩 입문자가 꼭 알아야 할 프론트엔드 기본 개념 15가지

    바이브 코딩을 시작하면 곧 낯선 단어들이 몰려옵니다. React, Next.js, API, CSR, SSR, NPM, 빌드, 번들링…. 처음에는 전부 외워야 할 것처럼 보입니다.

    그런데 실제로 중요한 것은 단어 암기가 아닙니다. “이 기술이 왜 생겼는가”를 아는 것입니다. 그래야 AI가 짜준 코드가 어디에서 동작하고, 무엇을 고쳐 달라고 해야 하는지 감이 잡힙니다.

    이 글은 양실장의 바이브코딩대학 영상 「비개발자 바이브코더를 위해 만든, 가볍게 들어도 깊게 남는 프론트엔드 기본 지식」을 바탕으로, 초보자가 먼저 알아야 할 프론트엔드 개념을 쉬운 말로 정리한 글입니다.

    React라는 프론트엔드 키워드가 크게 보이는 바이브 코딩 강의 화면
    바이브 코딩을 시작하면 React 같은 단어를 자주 만납니다. 중요한 것은 암기가 아니라 흐름입니다.

    Read in English: 15 Frontend Basics Every Vibe-Coding Beginner Should Know

    1. 인터넷과 웹은 다르다

    가장 먼저 헷갈리는 말이 인터넷과 웹입니다.

    인터넷은 전 세계 컴퓨터를 연결한 거대한 통신망입니다. 도로, 전기망, 수도관처럼 기반 시설에 가깝습니다. 반면 웹은 그 인터넷 위에서 문서를 주고받고, 링크를 따라 이동하게 만든 서비스입니다.

    쉽게 말하면 이렇습니다.

    • 인터넷: 컴퓨터들이 서로 연결되는 길
    • 웹: 그 길 위에서 문서와 화면을 주고받는 서비스
    • 브라우저: 웹을 보기 위해 사용하는 앱

    그래서 “웹사이트를 만든다”는 말은 인터넷 자체를 만드는 것이 아닙니다. 인터넷이라는 기반 위에서 사용자가 볼 수 있는 문서와 기능을 설계한다는 뜻입니다.

    2. 웹의 출발은 문서와 링크였다

    웹은 처음부터 지금처럼 복잡하지 않았습니다. 팀 버너스리가 만든 초기 웹의 핵심은 연구 문서를 서로 연결하는 것이었습니다. 문서 안의 특정 단어를 누르면 다른 문서로 이동하는 방식, 즉 하이퍼링크가 핵심이었습니다.

    이때 필요한 기본 기술이 세 가지였습니다.

    1. HTML: 문서의 구조를 표시하는 언어
    2. URL: 문서의 주소
    3. HTTP: 브라우저와 서버가 문서를 주고받는 약속

    이 세 가지는 지금도 웹의 뿌리입니다. React나 Next.js를 쓰더라도 결국 브라우저는 HTML을 해석하고, URL로 위치를 찾고, HTTP로 데이터를 주고받습니다.

    3. HTML은 뼈대, CSS는 옷, JavaScript는 행동이다

    초보자가 프론트엔드를 이해할 때 가장 쉬운 비유는 사람입니다.

    HTML은 뼈대입니다. 제목, 문단, 이미지, 버튼, 입력창처럼 화면에 무엇이 있는지를 정합니다.

    CSS는 옷과 분위기입니다. 색상, 크기, 위치, 간격, 글꼴처럼 어떻게 보일지를 담당합니다.

    JavaScript는 행동입니다. 버튼을 눌렀을 때 메뉴가 열리고, 입력값이 검사되고, 장바구니 수량이 바뀌는 동작을 만듭니다.

    처음 웹은 거의 문서에 가까웠습니다. 예쁘게 꾸미는 문제 때문에 CSS가 필요해졌고, 사용자의 클릭과 입력에 반응해야 하면서 JavaScript가 중요해졌습니다.

    4. 브라우저는 코드를 그림으로 바꾼다

    프론트엔드 코드는 사람이 보는 화면이 아닙니다. 브라우저가 해석해야 하는 재료입니다.

    브라우저는 대략 이런 과정을 거칩니다.

    1. HTML과 CSS를 읽는다.
    2. 화면에 어떤 요소가 있는지 구조를 만든다.
    3. 각 요소의 크기와 위치를 계산한다.
    4. 픽셀로 칠해서 화면에 보여준다.

    이 과정을 렌더링이라고 합니다. 화면의 요소가 바뀌면 브라우저는 다시 계산해야 합니다. 위치 계산이 다시 일어나는 일을 리플로우라고 부르고, 다시 그리는 일을 리페인트라고 부릅니다.

    이 개념을 알면 AI에게 더 구체적으로 말할 수 있습니다. “버튼 색을 바꿔 줘”와 “버튼을 누를 때 레이아웃이 흔들리지 않도록 수정해 줘”는 전혀 다른 요청입니다.

    5. jQuery와 React는 서로 다른 문제를 풀었다

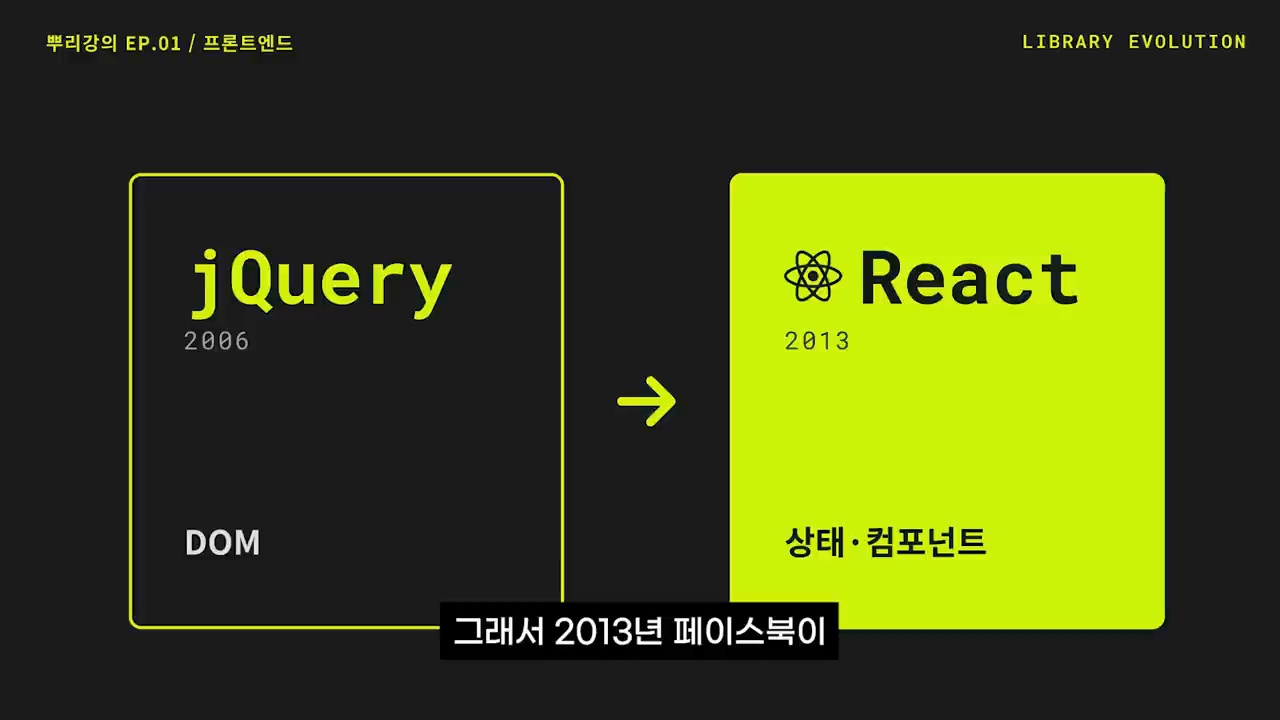
    jQuery에서 React로 프론트엔드 사고가 바뀌는 흐름을 설명하는 강의 화면
    프론트엔드는 DOM 조작 중심에서 상태와 컴포넌트 중심으로 이동했습니다.

    예전에는 브라우저마다 JavaScript 동작 방식이 조금씩 달랐습니다. 개발자는 같은 기능을 여러 브라우저에서 맞추느라 고생했습니다. 이 문제를 쉽게 만들어 준 도구가 jQuery였습니다. DOM 조작을 더 간단하고 일관되게 해준 것입니다.

    그 뒤 웹은 더 복잡해졌습니다. 단순히 버튼 하나를 움직이는 수준이 아니라, 로그인 상태, 장바구니, 알림, 실시간 데이터처럼 화면 전체가 계속 변하게 됐습니다.

    React는 이 복잡성을 “상태” 중심으로 다루게 해줍니다. 상태란 화면이 기억해야 하는 현재 값입니다. 예를 들어 로그인 여부, 장바구니 개수, 선택된 탭, 검색어 같은 것입니다.

    React식 사고는 이렇습니다.

    • 상태가 바뀐다.
    • 화면은 그 상태에 맞게 다시 그려진다.
    • 같은 UI 조각은 컴포넌트로 재사용한다.

    바이브 코딩에서 React 코드를 자주 만나는 이유도 여기에 있습니다. 요즘 웹앱은 상태가 많고, 재사용할 UI가 많기 때문입니다.

    6. Node.js와 NPM은 프론트엔드를 ‘생태계’로 만들었다

    JavaScript는 원래 브라우저 안에서만 움직이는 언어였습니다. 그런데 Node.js가 등장하면서 JavaScript를 서버나 개발 도구에서도 실행할 수 있게 됐습니다.

    NPM은 JavaScript 패키지를 설치하고 관리하는 도구입니다. 패키지는 누군가 만들어 둔 코드 묶음입니다. 우리가 직접 모든 기능을 만들지 않고도 날짜 처리, 화면 구성, 아이콘, 빌드 도구를 가져다 쓸 수 있게 해줍니다.

    초보자에게 NPM은 조금 무섭게 느껴질 수 있습니다. 하지만 핵심은 간단합니다.

    • Node.js: JavaScript를 브라우저 밖에서도 실행하게 해주는 환경
    • NPM: 필요한 코드 묶음을 설치하고 관리하는 창고
    • package.json: 이 프로젝트가 어떤 패키지에 의존하는지 적어 둔 목록

    7. 빌드는 개발용 코드를 배포용 코드로 정리하는 과정이다

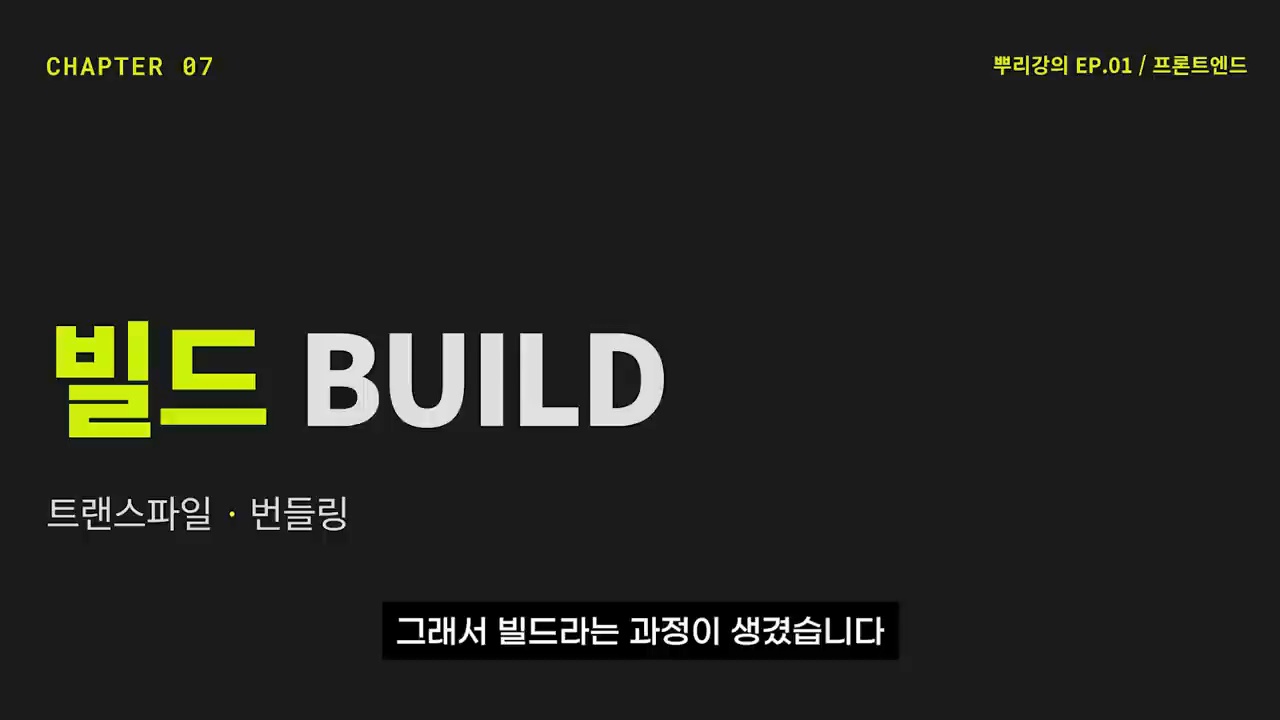
    빌드 과정과 트랜스파일링 번들링을 설명하는 강의 화면
    빌드는 개발자가 작성한 코드를 사용자가 빠르게 볼 수 있는 형태로 정리하는 과정입니다.

    요즘 프론트엔드 프로젝트에는 파일이 많습니다. JavaScript, TypeScript, CSS, 이미지, 폰트, 라이브러리가 함께 들어갑니다. 이 상태 그대로 브라우저에 던지면 비효율적입니다.

    그래서 빌드가 필요합니다. 빌드는 개발자가 작업하기 좋은 코드를 사용자가 빠르게 볼 수 있는 코드로 정리하는 과정입니다.

    대표적인 작업은 다음과 같습니다.

    • 트랜스파일링: 최신 문법을 더 넓은 브라우저가 이해할 수 있게 바꾼다.
    • 번들링: 여러 파일을 적절히 묶는다.
    • 트리쉐이킹: 실제로 쓰지 않는 코드를 덜어낸다.
    • 최적화: 파일 크기를 줄이고 로딩 속도를 높인다.

    AI에게 “빌드 오류를 고쳐 줘”라고만 말하면 범위가 너무 넓습니다. “NPM 패키지 충돌인지, TypeScript 변환 오류인지, 번들링 단계 오류인지 확인해 줘”라고 말하면 훨씬 정확한 답을 받을 수 있습니다.

    8. MPA와 SPA는 페이지를 바꾸는 방식이 다르다

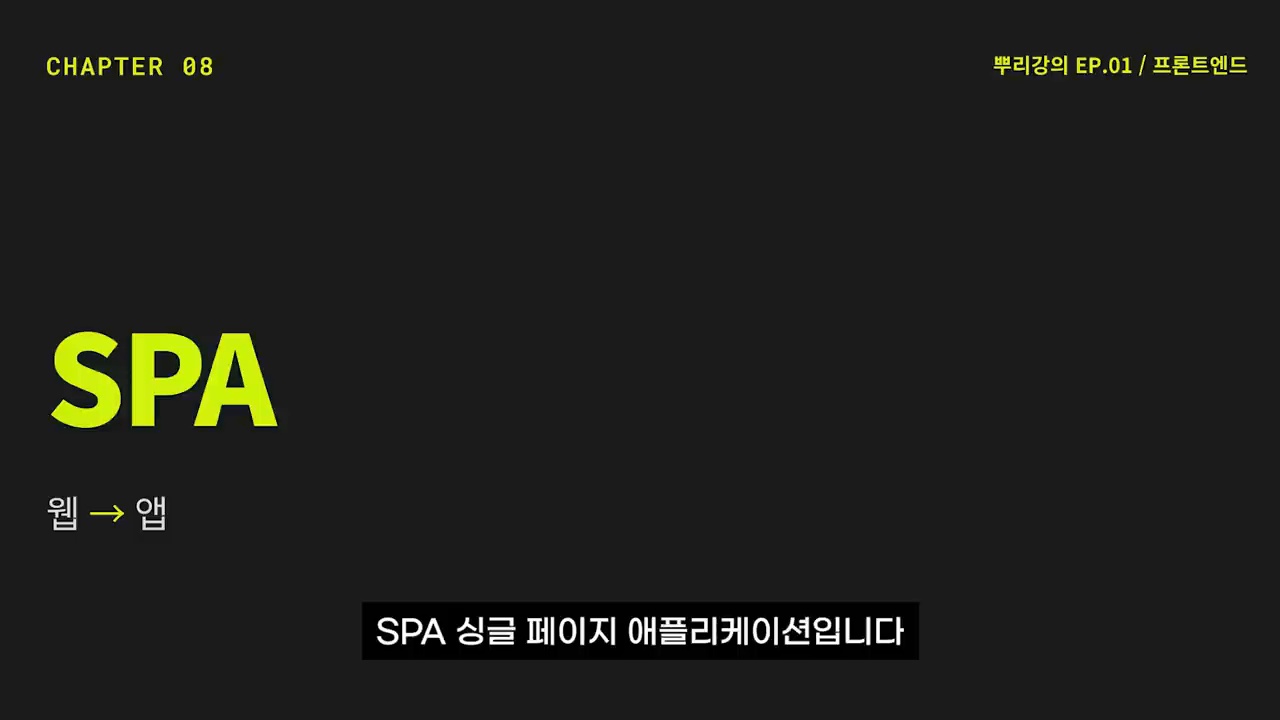
    SPA 개념을 설명하는 프론트엔드 강의 화면
    SPA는 웹사이트가 앱처럼 부드럽게 동작하게 만든 대표적인 흐름입니다.

    전통적인 웹사이트는 페이지를 이동할 때마다 서버에서 새 HTML을 받아왔습니다. 이것을 MPA, 즉 Multi Page Application이라고 부릅니다.

    반면 SPA는 처음에 앱 껍데기를 받아온 뒤, 필요한 데이터만 주고받으며 화면을 바꿉니다. 페이지 전체가 매번 새로고침되지 않기 때문에 앱처럼 부드럽게 느껴집니다.

    둘 중 하나가 무조건 좋은 것은 아닙니다.

    • MPA: 구조가 단순하고 검색엔진이 이해하기 쉽다.
    • SPA: 사용자 경험이 부드럽지만 초기 로딩과 SEO가 어려울 수 있다.

    바이브 코딩으로 웹앱을 만들 때 “왜 화면은 바뀌는데 주소는 그대로인가”, “왜 검색엔진에 잘 안 잡히는가” 같은 문제가 생긴다면 이 차이를 떠올리면 됩니다.

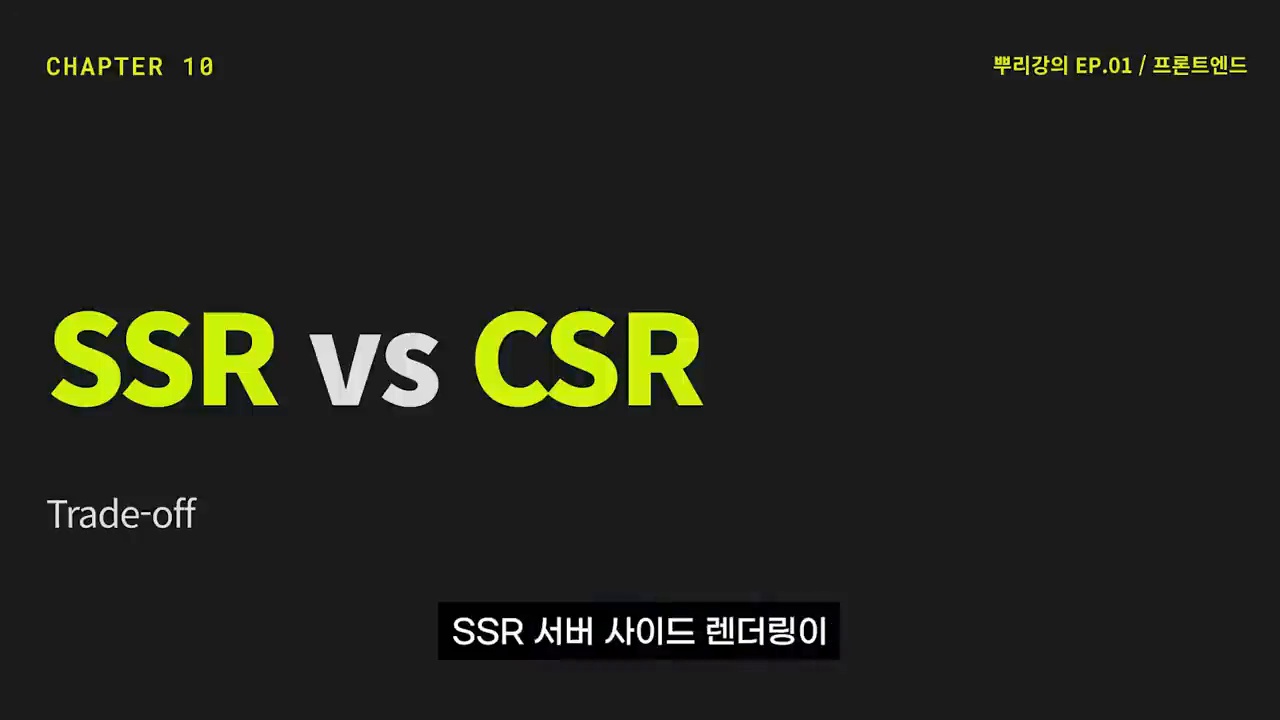
    9. CSR, SSR, 하이드레이션은 ‘누가 먼저 그리느냐’의 문제다

    CSR은 Client Side Rendering입니다. 브라우저가 JavaScript를 받아서 화면을 그리는 방식입니다. 사용자는 처음에 빈 화면을 잠깐 볼 수 있고, 검색엔진도 내용을 늦게 이해할 수 있습니다.

    SSR은 Server Side Rendering입니다. 서버가 미리 HTML을 만들어서 브라우저에 보내는 방식입니다. 첫 화면이 빠르게 보이고 검색엔진에도 유리합니다.

    하이드레이션은 서버가 먼저 그려 준 HTML에 JavaScript 기능을 붙이는 과정입니다. 겉으로 보이는 화면은 이미 있지만, 버튼 클릭이나 상태 변경 같은 상호작용을 나중에 연결하는 것입니다.

    SSR과 CSR 렌더링 방식을 비교하는 강의 화면
    CSR과 SSR은 화면을 어디에서 먼저 그리느냐의 차이입니다.

    Next.js 같은 프레임워크가 주목받는 이유도 여기에 있습니다. 페이지 성격에 따라 CSR, SSR, 정적 생성 같은 방식을 섞어 쓸 수 있기 때문입니다.

    10. API는 프론트엔드와 백엔드 사이의 약속이다

    프론트엔드는 사용자가 보는 화면을 담당합니다. 백엔드는 데이터 저장, 인증, 결제, 권한 같은 뒤쪽 일을 맡습니다. 둘 사이에는 데이터를 주고받는 약속이 필요합니다. 이것이 API입니다.

    예를 들어 사용자가 로그인 버튼을 누르면 프론트엔드는 백엔드에 “이 아이디와 비밀번호가 맞나요?”라고 요청합니다. 백엔드는 결과를 돌려줍니다. 프론트엔드는 그 결과에 따라 화면을 바꿉니다.

    초보자는 API를 “화면과 데이터 창고 사이의 주문서”로 이해하면 됩니다. 어떤 주소로, 어떤 형식의 데이터를 보내고, 어떤 응답을 받을지 정한 약속입니다.

    바이브 코딩 초보자가 기억할 핵심 체크리스트

    프론트엔드 용어가 쏟아질 때는 아래 질문으로 정리하면 좋습니다.

    1. 이 기술은 구조, 디자인, 동작, 데이터 중 무엇을 다루는가?
    2. 이 문제는 브라우저에서 생긴 문제인가, 서버에서 생긴 문제인가?
    3. 화면이 느린 문제인가, 데이터가 안 오는 문제인가, 상태가 꼬인 문제인가?
    4. 지금 필요한 것은 기능 구현인가, 빌드 오류 해결인가, 배포 최적화인가?
    5. AI에게 요청할 때 문제 위치와 기대 결과를 함께 말했는가?

    이 다섯 가지를 구분하면 프롬프트가 달라집니다. “잘 안 돼요”가 아니라 “React 상태가 바뀌었는데 화면이 갱신되지 않습니다. 원인을 찾아 주세요”라고 말할 수 있습니다.

    함께 읽으면 좋은 글

    FAQ

    바이브 코딩을 하려면 프론트엔드를 꼭 배워야 하나요?

    전문 개발자처럼 모든 문법을 외울 필요는 없습니다. 다만 HTML, CSS, JavaScript, API, 렌더링 방식 같은 기본 개념을 알면 AI에게 훨씬 정확한 요청을 할 수 있습니다.

    React와 Next.js는 같은 건가요?

    같지 않습니다. React는 UI를 만들기 위한 라이브러리이고, Next.js는 React를 기반으로 라우팅, 서버 렌더링, 정적 생성, 배포 구조까지 더 넓게 다루는 프레임워크입니다.

    CSR과 SSR은 왜 중요한가요?

    화면을 브라우저가 그리느냐, 서버가 먼저 그려 보내느냐의 차이입니다. 초기 로딩 속도, 검색엔진 노출, 사용자 경험에 영향을 줍니다.

    빌드 오류가 나면 무엇부터 봐야 하나요?

    먼저 오류가 패키지 설치 문제인지, 문법 변환 문제인지, 타입 검사 문제인지, 번들링 문제인지 나눠 봐야 합니다. 그다음 오류 메시지와 실행한 명령어를 함께 AI에게 알려 주면 좋습니다.

    초보자가 가장 먼저 익혀야 할 프론트엔드 개념은 무엇인가요?

    HTML·CSS·JavaScript의 역할, 브라우저 렌더링, 상태, API, 빌드, CSR·SSR의 차이를 먼저 잡는 것이 좋습니다. 이 개념들이 잡히면 React나 Next.js 문서도 덜 낯설게 보입니다.

    참고자료

    프론트엔드는 외울 단어가 많은 분야처럼 보이지만, 실제로는 웹이 겪어 온 문제 해결의 역사에 가깝습니다. 문서를 연결하던 웹이 디자인을 입고, 상호작용을 얻고, 앱처럼 움직이고, 다시 검색성과 속도를 고민하게 된 흐름입니다.

    바이브 코딩 입문자에게 필요한 것도 바로 이 흐름입니다. 흐름을 알면 AI가 만든 코드를 더 잘 읽고, 더 구체적으로 질문하고, 더 안전하게 수정할 수 있습니다.

    이미지 출처: 본문에 사용된 캡쳐 이미지는 원본 YouTube 영상에서 리뷰·해설·교육 목적의 인용 이미지로 사용했습니다. 이미지 저작권은 원저작권자와 해당 채널에 있습니다.
  • 에이전틱 AI 시대, 기업과 개인은 무엇을 바꿔야 살아남을까

    앞선 글에서 AI 시대 기업 혁신의 핵심을 “기존 사업의 재해석”과 “시스템보다 큰 미션”으로 정리했다. 이번 영상은 그 다음 질문을 던진다. 기업이 AI를 붙인다는 것은 구체적으로 무엇을 바꾸는 일일까. 그리고 개인은 어떤 준비를 해야 할까.

    Read in English: In the Agentic AI Era, What Must Companies and Individuals Change to Survive?

    삼성SDS 채널의 「AGI 시대에 살아남는 자들의 필살기」에서 김대식 교수는 꽤 단순하지만 중요한 결론을 말한다. AI는 구경하는 기술이 아니다. 써봐야 안다. 더 정확히 말하면, AI 시대에는 도구를 쓰는 능력보다 일하는 방식과 자기 역할을 다시 설계하는 능력이 중요해진다.

    AI 도구를 쓰는 것과 AI로 일하는 것은 다르다

    많은 기업이 AI 도입을 “ChatGPT 같은 도구를 쓰는 일”로 이해한다. 그러나 기업 현장에서는 그렇게 단순하지 않다. 공개 AI 도구는 인터넷에 공개된 정보를 바탕으로 답한다. 기업의 내부 기술, 고객 데이터, 특허, 조직 역량, 경쟁사의 움직임을 모르면 답은 대체로 막연해진다.

    반대로 내부 정보를 충분히 넣으면 훨씬 좋은 답을 얻을 수 있다. 하지만 그 순간 보안과 신뢰 문제가 생긴다. 신제품 전략, 고객 정보, 기술 자료가 외부 모델로 흘러갈 수 있기 때문이다.

    그래서 기업용 AI의 핵심은 단순 성능만이 아니다. “얼마나 똑똑한가” 못지않게 “믿고 맡길 수 있는가”가 중요하다. 앞으로 기업 AI 시장에서 보안, 권한 관리, 감사 로그, 데이터 거버넌스, 책임 구조가 중요한 이유다.

    기업 AI의 경쟁력은 성능보다 신뢰에서 갈린다

    영상에서 삼성SDS의 패브릭스, 브리티 같은 기업용 AI 서비스가 언급된다. 여기서 중요한 포인트는 특정 제품 홍보가 아니다. 기업 입장에서는 공개 AI보다 조금 덜 화려해 보여도, 내부 데이터를 안전하게 다루고 책임질 수 있는 AI 환경이 더 현실적인 선택일 수 있다는 점이다.

    에이전틱 AI가 들어오면 이 문제는 더 커진다. 단순히 답변만 생성하는 AI라면 틀린 답을 사람이 걸러낼 수 있다. 하지만 AI가 실제 업무를 실행하기 시작하면 이야기가 달라진다. 메일을 보내고, 구매를 진행하고, 코드를 수정하고, 고객 응대를 처리한다면 실수의 비용은 훨씬 커진다.

    결국 기업용 AI의 질문은 이렇게 바뀐다.

    • 이 AI가 어떤 데이터에 접근할 수 있는가?
    • 어떤 행동은 자동으로 하고, 어떤 행동은 승인 후 실행해야 하는가?
    • 실수했을 때 책임과 복구 절차는 어떻게 되는가?
    • 내부 직원은 AI의 판단 과정을 얼마나 확인할 수 있는가?
    • 고객과 파트너에게 설명 가능한 방식으로 운영되는가?

    이 질문에 답하지 못하면 AI 도입은 생산성보다 리스크를 먼저 키울 수 있다.

    에이전틱 AI는 사람을 ‘명령하는 위치’에서 ‘감독하는 위치’로 옮긴다

    생성형 AI 시대에는 사람이 계속 프롬프트를 입력했다. 질문하고, 답을 받고, 다시 고치고, 또 지시했다. 사람은 AI 루프 안에 있었다.

    에이전틱 AI 시대에는 방향이 달라진다. 사람은 큰 목표와 조건을 제시하고, AI가 세부 실행을 맡는다. 예를 들어 “이번 달 식재료 예산은 40만 원이고, 한식 위주로 식단을 짜라”고 말하면 AI가 장보기, 비교, 주문까지 처리하는 식이다.

    기업에서는 더 큰 변화가 생긴다. 업무 요청, 자료 조사, 보고서 초안, 코드 수정, 고객 응대, 일정 조율 같은 일이 하나의 흐름으로 연결될 수 있다. 사람은 모든 단계를 손으로 처리하기보다 목표를 정하고, 중간 결과를 확인하고, 최종 책임을 지는 역할로 이동한다.

    이 변화는 편리함만 뜻하지 않는다. 사람의 역할이 더 선명해져야 한다는 뜻이기도 하다. 무엇을 맡길지, 어디서 멈추게 할지, 언제 사람이 개입할지 정해야 한다.

    과거의 성공 방식은 AI 시대에 발목이 될 수 있다

    영상에서 가장 흥미로운 대목은 “과거의 성공이 발목을 잡는다”는 지적이다. 성공한 기업일수록 자신이 잘해온 방식에 강하게 묶인다. 완벽한 제품, 엄격한 승인, 긴 개발 주기, 세밀한 품질 관리가 과거에는 강점이었다.

    하지만 AI 기술은 너무 빠르게 변한다. 몇 달 동안 완벽한 결과물을 기다리는 동안 시장의 기준이 바뀔 수 있다. 완벽함을 추구하는 문화가 오히려 학습 속도를 늦추는 것이다.

    물론 완성도를 버리자는 말은 아니다. 금융, 의료, 제조, 공공서비스처럼 신뢰가 중요한 분야에서는 안정성이 필수다. 다만 모든 일을 과거의 출시 방식으로만 처리하면 새로운 기술의 속도를 따라가기 어렵다.

    AI 시대의 조직은 두 개의 속도를 가져야 한다. 고객에게 영향을 주는 핵심 시스템은 안전하게 운영해야 한다. 동시에 내부 실험, 프로토타입, 업무 자동화, 고객 경험 개선은 훨씬 빠르게 시도해야 한다.

    바이브 코딩은 개발자만의 이야기가 아니다

    영상에서는 기획자나 디자이너가 AI를 활용해 직접 샘플을 만들 수 있는 시대가 언급된다. 예전에는 “이 기능은 2년 걸립니다”라는 말 앞에서 비전문가는 반박하기 어려웠다. 이제는 다르다. 기획자가 AI로 간단한 화면과 작동 예시를 만들어 보여줄 수 있다.

    이 변화는 개발자를 대체한다는 뜻이 아니다. 오히려 협업의 기준이 바뀐다는 뜻이다. 말로 설명하던 사람이 이제는 작동하는 초안을 가져올 수 있다. 아이디어와 실행 사이의 거리가 줄어든다.

    그래서 앞으로 중요한 역량은 하나의 직무만 고집하는 능력이 아니다. AI의 도움을 받아 여러 일을 연결하고, 빠르게 실험하고, 결과물을 보여주는 능력이다. 기획자는 더 기술적으로 생각해야 하고, 개발자는 더 고객과 경험을 이해해야 한다. 디자이너는 화면을 넘어 흐름과 자동화를 설계해야 한다.

    개인은 먼저 자신의 상황을 냉정하게 분석해야 한다

    김대식 교수는 30~40대 직장인, 개발자, 대표, 자영업자에게 먼저 자신의 능력과 상황을 냉정하게 보라고 말한다. 막연히 불안해하거나 유튜브만 보는 것으로는 방향이 생기지 않는다.

    AI 시대의 준비는 거창한 자격증이나 선언으로 시작하지 않는다. 내가 무엇을 잘하는지, 어떤 일을 하고 있는지, 어디에 시간을 걸어야 하는지 확인하는 데서 시작한다.

    다음 질문을 적어보면 좋다.

    • 나는 반복 업무와 판단 업무 중 어디에 시간을 더 쓰고 있는가?
    • 내 업무에서 AI가 바로 도와줄 수 있는 부분은 무엇인가?
    • 내가 직접 해야만 가치가 생기는 부분은 무엇인가?
    • 고객이나 조직이 나에게 기대하는 진짜 결과는 무엇인가?
    • 앞으로 3개월 동안 AI로 실험해볼 작은 과제는 무엇인가?

    이 질문에 답하면 막연한 두려움이 조금 줄어든다. 불안은 행동하지 않을 때 커지고, 경험은 불안을 정보로 바꾼다.

    AI는 자전거처럼 직접 타봐야 익숙해진다

    영상의 결론은 “일단 해보라”다. AI를 배우는 방식은 자전거와 비슷하다. 책을 읽고 강의를 듣는 것만으로는 자전거를 탈 수 없다. 직접 타보고, 넘어지고, 다시 균형을 잡아야 한다.

    AI도 마찬가지다. 남이 쓰는 장면을 보는 것과 내가 내 일에 적용해보는 것은 완전히 다르다. 프롬프트를 넣어보고, 결과가 틀리는 이유를 보고, 다시 요청하고, 내 업무 자료와 연결해보는 과정에서 감각이 생긴다.

    처음부터 거창한 프로젝트를 할 필요는 없다. 다음처럼 작게 시작하면 된다.

    • 회의 메모를 요약해보기
    • 보고서 목차를 3가지 버전으로 만들기
    • 고객 문의 답변 초안을 만들기
    • 엑셀 데이터를 설명문으로 바꾸기
    • 간단한 랜딩페이지나 앱 화면을 AI로 시제품화하기
    • 매주 반복하는 업무 하나를 자동화해보기

    중요한 것은 “내가 해봤다”는 경험이다. 그 경험이 쌓이면 자신이 AI로 무엇을 잘할 수 있는지 보이기 시작한다.

    AI가 기능을 대신할수록 인간은 경험을 설계해야 한다

    영상 후반부에서 명품 브랜드 이야기가 나온다. 가방의 기능만 보면 몇 천만 원의 가격 차이를 설명하기 어렵다. 물건을 담는 기능은 비슷하다. 그러나 사람들은 기능만 사지 않는다. 기다림, 스토리, 상징, 소속감, 자기만족 같은 경험에 돈을 낸다.

    AI 시대에도 이 점은 중요하다. AI가 기능을 빠르게 평준화할수록 단순 기능만으로는 차별화하기 어렵다. 문서 작성, 이미지 생성, 코드 초안, 고객 응대 같은 기능은 점점 더 쉽게 복제된다.

    그렇다면 기업과 개인은 무엇으로 차별화해야 할까. 답은 경험, 신뢰, 희소성, 인간적 맥락에 있다.

    기업은 단순히 기능을 제공하는 회사를 넘어 고객이 더 편안하고, 더 안전하고, 더 좋은 선택을 했다고 느끼게 만드는 경험을 설계해야 한다. 개인도 마찬가지다. AI가 할 수 있는 일을 흉내 내는 사람이 아니라, AI를 활용해 자신만의 관점과 결과물을 만드는 사람이 되어야 한다.

    이전 글을 보완하면, AI 혁신의 순서는 이렇게 정리된다

    앞선 기업 혁신 글은 “기존 사업을 다시 해석하고, AI와 테크를 붙여야 한다”고 정리했다. 이번 영상은 그 다음 단계를 보완한다. AI를 붙인 뒤에는 조직의 일하는 방식과 개인의 역할까지 바뀌어야 한다.

    정리하면 순서는 이렇다.

    • 기존 사업의 본질을 다시 정의한다.
    • 고객 문제에 AI와 테크를 연결한다.
    • 공개 도구 사용을 넘어 신뢰 가능한 기업용 AI 환경을 만든다.
    • 에이전틱 AI에 맡길 일과 사람이 승인할 일을 구분한다.
    • 조직의 속도를 실험형과 안정형으로 나눈다.
    • 개인은 작은 업무부터 직접 AI를 써보며 감각을 만든다.
    • 기능보다 경험과 신뢰를 설계하는 방향으로 차별화한다.

    이렇게 보면 AI 혁신은 기술 도입 프로젝트가 아니다. 사업 정의, 조직 설계, 일하는 방식, 개인의 커리어 전략이 함께 바뀌는 변화다.

    마무리: AI 시대의 생존 전략은 ‘먼저 경험하고, 다르게 설계하는 것’이다

    에이전틱 AI 시대에는 “AI를 쓸 줄 안다”는 말의 의미가 달라진다. 단순히 프롬프트를 잘 쓰는 수준을 넘어, AI가 실행할 수 있는 일을 구조화하고, 신뢰와 책임의 경계를 설계하고, 인간이 맡아야 할 가치를 더 선명하게 만드는 능력이 필요하다.

    기업은 AI 도구를 도입하는 데서 멈추면 안 된다. 일하는 방식 자체를 바꿔야 한다. 개인도 불안해하며 구경만 해서는 안 된다. 직접 써보고, 넘어지고, 다시 시도해야 한다.

    AI가 기능을 대신할수록 인간은 더 인간적인 것을 설계해야 한다. 경험, 신뢰, 행복, 희소성, 맥락. 결국 AI 시대의 경쟁력은 기술을 얼마나 잘 쓰느냐와 함께, 사람이 왜 나를 선택해야 하는지를 얼마나 분명하게 만들 수 있느냐에 달려 있다.

    함께 읽으면 좋은 글

    참고자료

    FAQ

    에이전틱 AI는 생성형 AI와 무엇이 다른가요?

    생성형 AI는 주로 사람이 질문하면 답을 생성합니다. 에이전틱 AI는 목표와 조건을 받은 뒤 여러 단계를 스스로 계획하고 실행하는 방향으로 발전합니다.

    기업이 공개 ChatGPT만 쓰면 왜 부족한가요?

    기업의 전략과 업무에는 내부 데이터, 기술, 고객 정보, 보안 이슈가 얽혀 있습니다. 공개 도구만으로는 맥락이 부족하고, 내부 정보를 넣으면 유출 위험이 생길 수 있습니다.
    AI 시대에 개인은 무엇부터 시작해야 하나요?

    거창한 공부보다 자기 업무 하나를 정해 직접 AI로 처리해보는 것이 좋습니다. 요약, 초안 작성, 자료 정리, 간단한 자동화처럼 작은 실험부터 시작하면 됩니다.

    AI가 많은 기능을 대신하면 인간의 가치는 어디에 남나요?

    기능만으로는 차별화가 어려워집니다. 대신 경험, 신뢰, 맥락, 감정, 브랜드, 희소성처럼 사람이 선택 이유를 느끼게 만드는 영역이 더 중요해집니다.

    기업은 AI 전환을 어떻게 시작해야 하나요?

    기존 사업의 본질을 다시 정의하고, 고객 문제와 연결되는 작은 AI 실험부터 시작해야 합니다. 동시에 데이터 보안, 권한, 승인, 책임 구조를 함께 설계해야 합니다.


  • AI 시대, 무너지는 기업과 다시 성장하는 기업의 결정적 차이

    AI 시대 기업 혁신은 멋진 신사업 이름을 붙이는 일이 아니다. 더 정확히 말하면, “우리도 AI를 하자”라는 구호만으로는 아무것도 바뀌지 않는다.

    Read in English: The Decisive Difference Between Companies That Collapse and Companies That Grow Again in the AI Era

    SBS 교양이를 부탁해 영상에서 신수정 전 KT 부사장은 기업이 무너지는 이유를 꽤 현실적으로 짚는다. 오래된 기업은 새로운 사업을 못 찾아서만 무너지는 것이 아니다. 기존 사업의 의미를 다시 읽지 못하고, 고객보다 내부 규칙을 더 크게 만들 때 무너진다.

    이 글은 영상 내용을 바탕으로 AI 대전환 시대에 기업이 다시 성장하려면 무엇을 바꿔야 하는지 정리한 글이다.

    다음 S곡선을 준비하지 못하면 잘나가던 기업도 멈춘다

    하나의 사업은 보통 S곡선을 그린다. 처음에는 천천히 출발하고, 어느 순간 빠르게 성장한다. 이후 성숙기에 들어가고, 시간이 지나면 쇠퇴한다.

    문제는 많은 기업이 성장기에 만든 방식으로 성숙기와 쇠퇴기까지 버티려 한다는 점이다. 과거의 성공 방식은 익숙하고 안전해 보인다. 하지만 그 익숙함이 다음 성장을 막는다.

    그래서 기업은 늘 다음 S곡선을 준비해야 한다. 여기서 중요한 것은 “기존 사업을 버리고 완전히 낯선 일을 하라”는 뜻이 아니다. 오히려 출발점은 기존 사업을 새롭게 해석하는 데 있다.

    신사업은 기존 사업을 버리는 것이 아니라 다시 해석하는 일이다

    영상에서 인상적인 대목은 신사업에 대한 관점이다. 많은 기업은 기존 사업이 어려워지면 전혀 다른 신사업을 찾는다. 그런데 그 사이에 누군가는 기존 시장의 빈틈을 새롭게 해석한다.

    통신사가 문자와 커뮤니케이션의 본질을 충분히 다시 읽지 못하는 동안 카카오는 메신저를 키웠다. 금융회사가 송금과 투자 경험을 무겁게 유지하는 동안 토스는 더 가볍고 쉬운 금융 경험을 만들었다.

    마이크로소프트도 비슷하다. 과거의 마이크로소프트는 PC 소프트웨어 회사에 가까웠다. 하지만 사티아 나델라 이후 회사는 자신을 “기업 생산성을 높이는 회사”로 재정의했다. 그러자 워드프로세서뿐 아니라 클라우드, 협업 도구, AI까지 모두 하나의 방향으로 연결됐다.

    월마트도 단순한 오프라인 유통회사가 아니라 고객과 가장 가까운 생활 플랫폼으로 자신을 다시 해석했다. 물건을 파는 장소에서 물류, 생활 서비스, 데이터 기반 유통 플랫폼으로 확장한 것이다.

    핵심은 하나다. 신사업은 생뚱맞은 곳에서 찾는 것이 아니라, 내가 이미 하고 있는 일의 본질을 다시 묻는 데서 시작한다.

    모든 기업은 이제 AI 회사이자 테크 회사가 되어야 한다

    AI 시대에 “우리는 전통 산업이라서 AI와 멀다”는 말은 점점 설득력을 잃고 있다. 제조, 조선, 유통, 화장품, 교육, 물류도 예외가 아니다. 중요한 것은 AI를 따로 떼어 놓고 보는 것이 아니라 기존 사업과 결합하는 방식이다.

    오히려 기존 산업을 가진 기업이 유리할 수 있다. 데이터, 고객 접점, 현장 경험, 물리적 자산이 있기 때문이다. AI는 허공에서 비즈니스를 만드는 도구가 아니다. 현실의 문제와 결합할 때 힘을 낸다.

    예를 들어 조선업은 설계·정비·안전·공정 최적화에 AI를 붙일 수 있다. 유통은 수요 예측, 물류, 개인화 추천에 AI를 붙일 수 있다. 화장품은 피부 데이터, 취향 분석, 제품 개발 속도에 AI를 붙일 수 있다.

    AI 전환의 질문은 “새로운 AI 사업을 만들 것인가?”가 아니다. 더 좋은 질문은 이렇다.

    • 우리 사업의 본질은 무엇인가?
    • 고객이 실제로 불편해하는 지점은 어디인가?
    • AI와 테크를 붙이면 그 불편을 더 빠르고 정확하게 해결할 수 있는가?
    • 기존 조직의 프로세스가 그 변화를 막고 있지는 않은가?

    제로투원은 오래 걸린다, 그래서 대기업은 참기 어렵다

    신사업은 크게 두 단계를 지난다. 첫째는 제로투원이다. 고객이 정말 원하는 상품이나 서비스를 찾는 단계다. 둘째는 원투텐이다. 이미 찾은 모델을 확장하는 단계다.

    원투텐은 운영과 경영의 영역에 가깝다. 하지만 제로투원은 다르다. 정답이 없고, 타이밍과 운도 작동한다. 여러 번 시도하고 버리고 다시 만드는 과정이 필요하다.

    그래서 제로투원은 스타트업에 더 어울리는 경우가 많다. 스타트업은 빠르게 시도하고, 실패하면 방향을 바꿀 수 있다. 반대로 대기업은 속도가 느리고, 작은 성과를 오래 기다리지 못한다.

    신사업 초기 매출은 작다. 1조 원 규모의 본업을 가진 회사에서 1억 원짜리 실험은 초라해 보인다. 그러나 그 작은 싹을 견디지 못하면 다음 사업은 자라지 못한다.

    대기업이 모든 신사업을 직접 하려 하기보다 스타트업에 투자하고, 성장 가능성이 보이면 인수하거나 협력하는 생태계가 중요한 이유도 여기에 있다.

    스타트업은 망치보다 송곳이 되어야 한다

    스타트업이 대기업과 정면으로 싸우면 불리하다. 자본, 인력, 브랜드, 유통망에서 밀린다. 그래서 초기 스타트업은 망치가 아니라 송곳이 되어야 한다.

    송곳 전략은 작지만 뾰족한 시장을 파고드는 방식이다. 대기업이 관심을 두지 않는 틈새에서 시작하고, 그 안에서 고객을 깊이 이해한다. 그리고 충성 고객을 만든 뒤 옆으로 확장한다.

    토스의 출발점도 거대한 종합금융 플랫폼이 아니었다. 간편 송금이라는 작고 구체적인 불편에서 시작했다. 쿠팡도 모든 유통을 처음부터 장악한 것이 아니라 고객 경험을 집요하게 개선하며 락인 효과를 만들었다.

    스타트업이 던져야 할 질문은 “우리가 얼마나 큰 시장을 말할 수 있는가?”가 아니다. 초기에는 오히려 이렇게 물어야 한다.

    • 우리가 가장 잘 해결할 수 있는 작고 날카로운 문제는 무엇인가?
    • 대기업이 아직 진지하게 보지 않는 고객 불편은 무엇인가?
    • 이 문제를 해결하면 고객이 계속 남을 이유가 생기는가?
    • 이 좁은 영역에서 1등이 될 수 있는가?

    관료제는 나쁘기만 한 것이 아니다, 하지만 굳어지면 위험하다

    기업이 커지면 관료제는 어느 정도 생긴다. 책임이 커지고, 리스크 관리가 필요해진다. 승인 절차와 시스템도 필요하다. 고객 수가 많아질수록 대충 빠르게 처리하는 방식은 위험해진다.

    문제는 관료제가 조직의 목적을 삼켜버릴 때다. 고객보다 보고서가 중요해지고, 현장보다 승인 라인이 중요해진다. 구성원은 고객을 위해 판단하기보다 “규정상 안 됩니다”라는 말을 먼저 하게 된다.

    이런 조직이 다시 활력을 찾으려면 세 가지가 필요하다.

    1. 위기의식을 분명히 해야 한다

    조직은 정말 위험하다고 느끼지 않으면 바뀌지 않는다. “혁신합시다”라는 말만 반복해서는 부족하다. 지금 방식으로는 고객을 잃고, 시장을 잃고, 결국 일자리도 흔들릴 수 있다는 현실을 공유해야 한다.

    2. 고객과 현장으로 다시 내려가야 한다

    책상 위 전략만으로는 조직이 살아나지 않는다. 경영진과 리더가 고객을 만나야 한다. 현장의 불편을 들어야 한다. 고객이 무엇을 참아주고 있는지, 무엇 때문에 떠나는지 직접 확인해야 한다.

    3. 혁신하는 사람이 실제로 인정받아야 한다

    조직문화는 포스터 문구가 아니라 생존 방식이다. 구성원은 말보다 보상을 본다. 혁신을 시도한 사람이 실패했다고 밀려나고, 기존 방식만 지킨 사람이 승진한다면 아무도 혁신을 믿지 않는다.

    정말 바꾸려면 혁신을 실행한 사람이 인정받고 승진한다는 신호가 반복적으로 보여야 한다. 단기간 이벤트가 아니라 꾸준한 보상 체계가 되어야 한다.

    시스템은 100%가 아니라 미션과 함께 작동해야 한다

    성장한 기업에는 시스템이 필요하다. 사람이 늘고 일이 복잡해지면 기준과 프로세스가 있어야 한다. 시스템이 없으면 품질도 흔들리고, 책임도 불분명해진다.

    하지만 시스템이 너무 커지면 사람은 일의 본질을 잊는다. 마케팅 담당자는 마케팅 시스템만 보고, 인사 담당자는 인사 규정만 본다. 고객이 어떤 불편을 겪는지보다 내부 절차를 지키는 일이 더 커진다.

    영상에서는 디즈니 사례가 나온다. 디즈니는 철저히 시스템화된 조직이지만, 동시에 미션으로 움직이는 영역을 남긴다. 고객을 즐겁게 하고 만족시키는 목적이 규정 밖 판단을 가능하게 한다는 것이다.

    물론 모든 회사가 같은 비율을 적용할 수는 없다. 항공, 제조, 의료처럼 안전이 중요한 산업은 시스템 비중이 더 커야 한다. 반대로 콘텐츠, IT 서비스, 소프트웨어 영역은 실험의 여지를 더 크게 둘 수 있다.

    중요한 것은 시스템과 미션의 균형이다. 시스템은 일을 안정적으로 만들고, 미션은 시스템이 놓치는 고객의 맥락을 회복하게 한다.

    성공 사례를 베끼지 말고 실패 조건을 배워야 한다

    기업들은 성공 사례를 좋아한다. 넷플릭스의 규칙 없음, 실리콘밸리식 자율문화, 유명 기업의 인사제도, 특정 CEO의 리더십을 따라 하고 싶어 한다.

    하지만 성공 공식은 보편적이지 않다. 어떤 방식은 특정 산업, 특정 시기, 특정 인재 밀도, 특정 경영자의 철학 속에서만 작동한다. 맥락을 빼고 제도만 가져오면 부작용이 생긴다.

    그래서 성공 사례를 볼 때는 “우리도 그대로 하자”가 아니라 “어떤 조건에서 효과가 있었나?”를 물어야 한다. 그리고 더 중요한 것은 실패 조건을 배우는 일이다.

    부정 회계, 고객 이탈을 무시하는 태도, 내부 규칙 우선주의, 작은 실험을 죽이는 문화, 말뿐인 혁신 보상. 이런 것들은 훨씬 명확하게 조직을 망가뜨린다.

    성공을 복제하기는 어렵다. 그러나 실패 확률을 낮추는 일은 가능하다.

    AI 시대 기업 혁신을 위한 5가지 점검 질문

    조직이 정말 변하고 있는지 확인하려면 다음 질문을 던져볼 수 있다.

    • 우리는 기존 사업을 어떤 말로 다시 정의하고 있는가?
    • AI와 테크가 고객 문제 해결에 실제로 연결되어 있는가?
    • 신사업의 작은 성과를 최소 3년 이상 견딜 구조가 있는가?
    • 고객과 현장의 목소리가 의사결정권자에게 직접 전달되는가?
    • 혁신을 말한 사람이 아니라 실행한 사람이 인정받고 있는가?

    이 질문에 답하지 못한다면 AI 전환은 구호에 머물 가능성이 높다.

    마무리: 혁신은 새 사업 이름이 아니라 생존 방식의 변화다

    AI 시대의 기업 혁신은 기술 도입 목록으로 끝나지 않는다. 더 근본적인 질문은 이것이다. 우리 회사는 무엇으로 고객에게 의미가 있는가. 그리고 그 의미를 지금의 기술과 시장 변화 속에서 어떻게 다시 만들 것인가.

    무너지는 기업은 대개 변화를 몰라서 무너지지 않는다. 알아도 바꾸지 못해서 무너진다. 규칙, 보고, 승인, 과거의 성공 방식이 고객보다 커질 때 조직은 천천히 굳어진다.

    다시 성장하는 기업은 다르다. 기존 사업을 새롭게 해석하고, AI와 테크를 고객 문제에 붙인다. 작은 실험을 견디고, 현장으로 내려가며, 혁신하는 사람을 실제로 보상한다.

    결국 기업문화는 말이 아니라 생존 방식이다. AI 시대에도 이 원칙은 달라지지 않는다.

    함께 읽으면 좋은 글

    참고자료

    FAQ

    AI 시대 기업 혁신의 출발점은 무엇인가요?

    기존 사업을 버리는 것이 아니라 기존 사업의 본질을 다시 정의하는 것입니다. 그 다음 AI와 테크를 고객 문제 해결에 연결해야 합니다.

    대기업이 신사업에 실패하기 쉬운 이유는 무엇인가요?

    제로투원 단계의 작은 성과를 오래 기다리지 못하기 때문입니다. 초기 신사업은 매출이 작고 불확실성이 큽니다. 이를 견디는 구조가 없으면 싹이 자라기 전에 사라집니다.

    스타트업은 대기업과 어떻게 경쟁해야 하나요?

    초기에는 넓게 싸우기보다 좁고 뾰족한 문제를 해결해야 합니다. 대기업이 관심을 덜 두는 틈새에서 고객 충성도를 만들고 확장하는 전략이 유리합니다.

    조직의 관료제를 줄이려면 무엇이 가장 중요한가요?

    고객과 현장 중심으로 의사결정을 되돌리고, 혁신을 실행한 사람이 실제로 인정받는 보상 체계를 만들어야 합니다. 말뿐인 혁신 구호는 구성원을 움직이지 못합니다.

    시스템화와 자율성은 어떻게 균형을 잡아야 하나요?

    업종의 위험도와 고객 접점에 따라 다릅니다. 안전이 중요한 산업은 시스템 비중이 높아야 하고, 빠른 실험이 중요한 산업은 미션 기반 자율성을 더 넓게 둘 수 있습니다.


  • 앤트로픽 미토스 쇼크: AI도 전략자산이 된 시대, 한국은 무엇을 준비해야 하나

    앤트로픽 미토스 쇼크: AI도 전략자산이 된 시대, 한국은 무엇을 준비해야 하나

    앤트로픽의 ‘미토스(Mythos)’ 이슈는 새로운 AI 모델이 나왔다는 뉴스로만 보기 어렵습니다. 핵심은 더 차갑습니다. 이제 최상위 AI 모델은 클라우드 서비스이면서 동시에 전략자산입니다.

    반도체 장비나 첨단 GPU처럼, 모델 접근권 자체가 외교와 안보의 대상이 되고 있습니다. 한국도 이 변화를 남의 나라 규제 뉴스로만 넘기기 어렵습니다.

    미토스 이슈의 핵심은 무엇인가

    서울의 전략 상황실에서 AI 모델 접근권과 보안 리스크를 검토하는 장면
    미토스 이슈는 AI 성능 경쟁을 넘어 접근권과 통제권이 국가 전략의 문제가 됐다는 신호다.

    Read in English: Anthropic Mythos Shock: As AI Becomes a Strategic Asset, What Should Korea Prepare?

    앤트로픽은 Claude Mythos 5를 사이버보안과 생물학 연구에 강한 모델로 소개했습니다. Project Glasswing을 통해 핵심 소프트웨어의 취약점을 찾고 방어하는 데 활용하겠다는 구상이었습니다.

    공식 설명에 따르면 초기 파트너들은 Mythos Preview를 활용해 중요 소프트웨어에서 1만 건이 넘는 고위험 또는 치명적 취약점을 찾았습니다. 방어 목적이라면 매우 매력적인 결과입니다.

    문제는 같은 능력이 공격에도 쓰일 수 있다는 점입니다. 취약점을 빨리 찾는 모델은 방어팀의 무기이기도 하지만, 통제가 무너지면 공격자의 무기가 될 수도 있습니다.

    그래서 미토스는 처음부터 제한된 파트너에게만 제공됐습니다. 그리고 미국 정부가 Fable 5와 Mythos 5에 대한 외국인 접근 중단 지침을 내리면서, 이 이슈는 기술 뉴스에서 국가 전략 뉴스로 바뀌었습니다.

    왜 ‘AI도 전략자산’이라는 말이 나왔나

    미국 정부의 지침은 최첨단 AI 모델 접근권이 국가안보 판단의 대상이 될 수 있음을 보여줬습니다. 반도체 수출통제와 비슷한 흐름이 모델 자체로 이동한 셈입니다.

    여기서 중요한 변화가 하나 있습니다. 과거에는 연산자원, 칩, 장비가 병목이었습니다. 앞으로는 모델 가중치, API 접근권, 안전장치 해제 여부, 데이터 보존 조건까지 통제 대상이 될 수 있습니다.

    기업 입장에서는 더 복잡합니다. 어제까지 쓸 수 있던 모델이 오늘 갑자기 막힐 수 있습니다. 공공기관, 금융, 의료, 국방, 연구개발처럼 고위험 영역에서는 이 문제가 단순한 불편을 넘어 운영 리스크가 됩니다.

    한국이 봐야 할 세 가지 위험

    해외 모델 의존 보안 모델 양면성 소버린 AI 현실성을 세 갈래로 검토하는 전략 회의
    한국의 AI 전략은 해외 모델 의존, 보안 AI의 양면성, 소버린 AI의 현실성을 함께 봐야 한다.

    1. 해외 모델 의존 리스크

    한국 기업과 공공기관은 글로벌 AI 모델을 빠르게 도입해 왔습니다. 생산성 측면에서는 자연스러운 선택입니다. 하지만 핵심 업무가 특정 해외 모델에 깊게 묶이면, 공급 중단이나 접근 제한이 곧 업무 중단으로 이어질 수 있습니다.

    특히 행정, 국방, 보안, 의료, 에너지, 금융처럼 국가 기능과 연결된 영역은 별도 기준이 필요합니다. 모든 AI를 국산으로만 쓰자는 뜻은 아닙니다. 다만 끊기면 안 되는 영역은 대체 경로를 갖춰야 합니다.

    2. 보안 모델의 양면성

    사이버 보안 관제실에서 AI 취약점 분석 결과와 패치 우선순위를 검토하는 모습
    강력한 보안 AI는 방어 역량을 높이지만, 통제가 없으면 공격 역량으로도 전용될 수 있다.

    미토스가 보여준 가장 어려운 질문은 이것입니다. “강력한 보안 AI를 넓게 풀수록 세상은 더 안전해질까, 더 위험해질까?”

    취약점 탐지 AI는 방어팀에 큰 힘이 됩니다. 그러나 검증, 공개, 패치 속도가 따라오지 못하면 취약점 목록만 빠르게 쌓일 수 있습니다. 앤트로픽도 취약점 발견 이후에는 검증과 공개, 패치가 병목이 된다고 설명했습니다.

    한국도 AI 보안 역량을 키울 때 탐지 모델만 보면 안 됩니다. 취약점 조정 공개, 패치 책임, 공급망 대응, 사고 대응 훈련이 함께 설계돼야 합니다.

    3. 소버린 AI의 현실성 문제

    소버린 AI는 멋진 구호로 끝나면 안 됩니다. 한국어 모델 하나를 만드는 문제도 아닙니다. 공공 데이터 거버넌스, 국내 컴퓨팅 인프라, 고위험 AI 평가, 산업별 표준, 조달 제도까지 묶여야 합니다.

    한국은 AI 기본법 시행, 국가 AI위원회, AI 안전연구소, 국가 AI컴퓨팅센터 같은 제도와 인프라를 준비하고 있습니다. 방향은 맞습니다. 다만 미토스 이슈는 속도를 더 요구합니다.

    한국의 미래 전략: ‘모델 확보’보다 ‘통제 가능한 AI 체계’가 먼저다

    컴퓨팅 데이터 모델 안전평가 조달 체계를 연결해 통제 가능한 AI 인프라를 설계하는 장면
    핵심은 특정 모델 보유가 아니라 필요할 때 멈추고 바꾸고 검증할 수 있는 AI 운영 체계다.

    한국의 대응은 단순히 “우리도 초거대 모델을 만들자”에서 끝나면 부족합니다. 더 중요한 질문은 “어떤 영역에서, 어떤 수준의 통제권을, 어떤 비용으로 확보할 것인가”입니다.

    첫째, 국가 핵심 영역의 AI 의존도를 분류해야 한다

    공공기관과 기간산업은 사용 중인 AI 서비스를 업무 중요도별로 나눠야 합니다. 단순 문서 작성 도구와 사이버보안·의료·행정 의사결정 보조 도구를 같은 기준으로 볼 수 없습니다.

    핵심 영역에는 최소한 세 가지 조건이 필요합니다. 대체 가능한 모델, 국내 또는 신뢰권역 내 추론 경로, 장애 시 수동 운영 절차입니다.

    둘째, 한국형 AI 안전평가 체계를 실전형으로 바꿔야 한다

    AI 안전평가는 문서 심사로 끝나면 안 됩니다. 사이버보안, 생물학, 금융사기, 허위정보, 개인정보 유출처럼 실제 피해가 큰 영역에서는 레드팀 평가와 반복 테스트가 필요합니다.

    특히 고성능 모델의 경우 “사용 금지”와 “무제한 개방” 사이에 여러 단계가 있어야 합니다. 제한된 파트너 접근, 사용 로그 보존, 고위험 질의 라우팅, 독립 평가, 사고 보고 체계가 함께 움직여야 합니다.

    셋째, 국가 AI컴퓨팅센터는 연구 인프라를 넘어 전략 인프라가 돼야 한다

    정부는 최대 2조 원 규모의 국가 AI컴퓨팅센터 구축을 추진하고 있습니다. 이 인프라는 단순히 GPU를 빌려주는 시설이 아니라, 한국형 모델과 안전평가, 공공 AI 실증을 연결하는 기반이 되어야 합니다.

    중요한 것은 접근성입니다. 대기업만 쓰는 인프라가 되면 산업 전체의 회복력은 커지지 않습니다. 대학, 스타트업, 보안 연구기관, 공공기관이 실제로 쓸 수 있는 구조가 필요합니다.

    넷째, 국제 협력은 하되 ‘차단 시나리오’를 전제로 해야 한다

    한국이 모든 AI 기술을 혼자 만들 수는 없습니다. 미국, 유럽, 일본, 싱가포르 등과의 협력은 계속 필요합니다. 다만 협력은 의존과 다릅니다.

    계약서에는 데이터 위치, 모델 접근 중단, 긴급 패치, 대체 모델 전환, 감사권 조항이 들어가야 합니다. 공공 조달에서도 “성능이 가장 좋은 모델”만 볼 것이 아니라 “위기 때 운영 가능한 모델”을 봐야 합니다.

    기업과 개인은 무엇을 확인해야 하나

    기업은 지금 쓰는 AI 도구를 목록화해야 합니다. 어떤 업무가 어떤 모델에 연결되어 있는지, 데이터가 어디에 저장되는지, 서비스가 중단되면 며칠 안에 대체 가능한지 확인해야 합니다.

    개인은 더 단순하게 볼 수 있습니다. AI를 잘 쓰는 능력은 중요합니다. 하지만 특정 모델의 답을 그대로 믿는 습관은 위험합니다. AI 시대에는 프롬프트보다 먼저 자기 언어와 판단 기준을 갖추는 일이 중요합니다.

    관련해서는 Thinknote의 AI 시대, 프롬프트보다 먼저 배워야 할 것은 ‘나의 언어’다와 AI 시대의 메타인지: 똑똑한 답보다 중요한 ‘내 생각 점검법’도 함께 읽어볼 만합니다.

    AI 에이전트 흐름이 궁금하다면 AI Agent Evolution: What OpenClaw Shows About the Next Step Beyond Chatbots와 AI-Native Workflows도 연결해서 볼 수 있습니다.

    결론: 한국의 AI 전략은 ‘접근권의 정치’를 준비해야 한다

    미토스 이슈가 남긴 메시지는 분명합니다. 앞으로 AI 경쟁은 성능 경쟁만이 아닙니다. 누가 모델에 접근할 수 있는가, 누가 안전장치를 조정할 수 있는가, 누가 장애 상황에서도 서비스를 유지할 수 있는가의 경쟁입니다.

    한국은 글로벌 모델을 쓰되, 핵심 영역에서는 통제 가능한 대안을 가져야 합니다. 소버린 AI는 고립이 아니라 보험입니다. 그리고 그 보험은 모델, 데이터, 컴퓨팅, 안전평가, 조달 제도가 함께 움직일 때만 작동합니다.

    FAQ

    앤트로픽 미토스는 일반인이 쓸 수 있는 AI인가요?

    아닙니다. 앤트로픽은 Mythos 5를 사이버보안과 생물학 연구에 강한 제한 접근 모델로 설명했습니다. 일반 지식 업무용으로는 별도 안전장치를 둔 Fable 5를 공개하려 했지만, 이 모델 역시 미국 정부 지침 이후 접근이 중단됐습니다.

    미토스 이슈가 한국 기업에 바로 영향을 주나요?

    모든 기업에 즉시 영향을 주는 것은 아닙니다. 다만 핵심 업무를 해외 최상위 AI 모델에 의존하는 기업에는 경고 신호입니다. 접근권, 데이터 위치, 대체 모델, 장애 대응 계획을 점검해야 합니다.

    소버린 AI는 해외 AI를 쓰지 말자는 뜻인가요?

    그렇지 않습니다. 소버린 AI의 핵심은 필요한 영역에서 통제권과 선택권을 확보하는 것입니다. 글로벌 AI를 활용하되, 공공·안보·산업 핵심 영역에서는 대체 가능성과 국내 운영 역량을 갖춰야 합니다.

    한국 정부는 이미 무엇을 준비하고 있나요?

    AI 기본법 시행, 국가 AI위원회, AI 안전연구소, 국가 AI컴퓨팅센터 등이 준비되고 있습니다. 특히 국가 AI컴퓨팅센터는 국내 AI 연구와 산업 활용을 위한 핵심 인프라로 추진되고 있습니다.

    개인은 무엇을 준비하면 좋을까요?

    특정 모델 하나에만 의존하지 않는 습관이 중요합니다. 중요한 판단은 여러 출처로 확인하고, AI가 제시한 답을 자기 언어로 다시 설명해보는 훈련이 필요합니다.

    참고자료

  • AI 에이전트 자동화, 클릭 한 번의 환상보다 중요한 것

    AI 에이전트 자동화, 클릭 한 번의 환상보다 중요한 것

    AI 자동화 이야기는 요즘 너무 쉽게 부풀려진다. “AI 에이전트 50개로 회사를 돌린다”, “하루 한 시간만 일한다”, “댓글을 남기면 돈 버는 자동화 레시피를 준다” 같은 문장이 피드에 계속 뜬다.

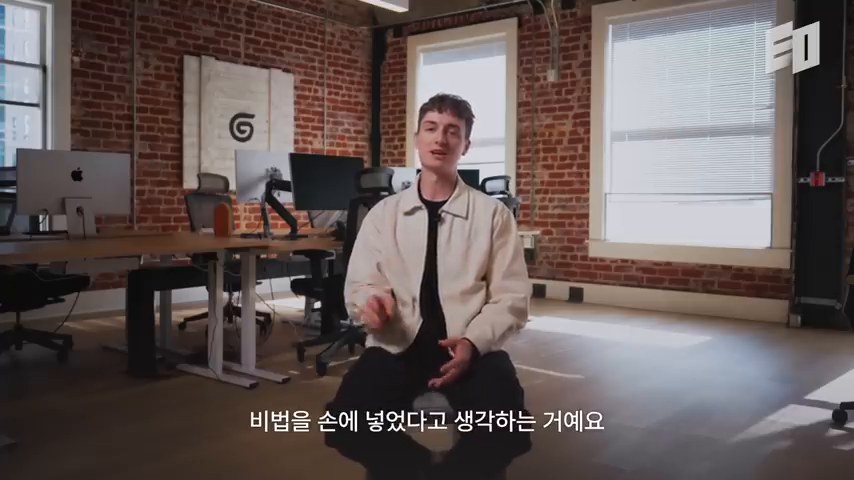
    EO Korea가 공개한 Gumloop 창업자 Max Brodeur-Urbas 인터뷰는 그 흐름에 정면으로 브레이크를 건다. 영상의 주인공은 AI 자동화 플랫폼 회사를 만들고, 대규모 투자를 유치한 창업자다. 그런데 그가 반복해서 말하는 핵심은 의외로 차갑다. AI는 이해를 건너뛰는 지름길이 아니라, 이미 이해한 일을 더 빠르게 실행하게 만드는 도구라는 것이다.

    Gumloop 창업자 Max Brodeur-Urbas가 AI 자동화 과장론을 비판하는 인터뷰 장면

    EO Korea 영상 캡처. 이 글은 영상 내용을 그대로 요약하기보다, Gumloop 사례와 외부 자료를 함께 읽어 AI 에이전트 자동화의 현실 조건을 분석한다.

    AI 에이전트 자동화의 문제는 ‘에이전트 수’가 아니다

    AI 에이전트 자동화를 실행하기 전에 업무 흐름과 승인 지점을 설계하는 모습
    AI 에이전트 자동화는 에이전트 수보다 업무 흐름과 판단 기준을 먼저 정리할 때 성과가 난다.

    영상 초반 Max는 “AI 에이전트가 회사를 다 운영한다”는 식의 주장을 거의 마케팅으로 본다. 그가 비판하는 지점은 AI 자체가 아니다. 문제는 자동화가 마치 이해와 시행착오를 생략해 주는 것처럼 팔리는 방식이다.

    Gumloop의 공식 사이트 문구도 이 관점과 맞닿아 있다. “업무를 이해하는 것이 자동화의 유일한 전제여야 한다”는 메시지를 전면에 내세운다. 즉, 핵심은 개발자가 아닌 사람도 자동화할 수 있게 만드는 것이다. 하지만 그 사람은 최소한 자신이 자동화하려는 업무를 알아야 한다.

    이 차이가 중요하다. AI 에이전트 자동화는 “무엇이든 대신 해주는 비서”에 가깝지 않다. 오히려 여러 도구, 데이터, 승인 절차, 반복 작업을 하나의 흐름으로 묶는 실행 인프라에 가깝다.

    Gumloop 사례가 보여주는 새로운 자동화 시장

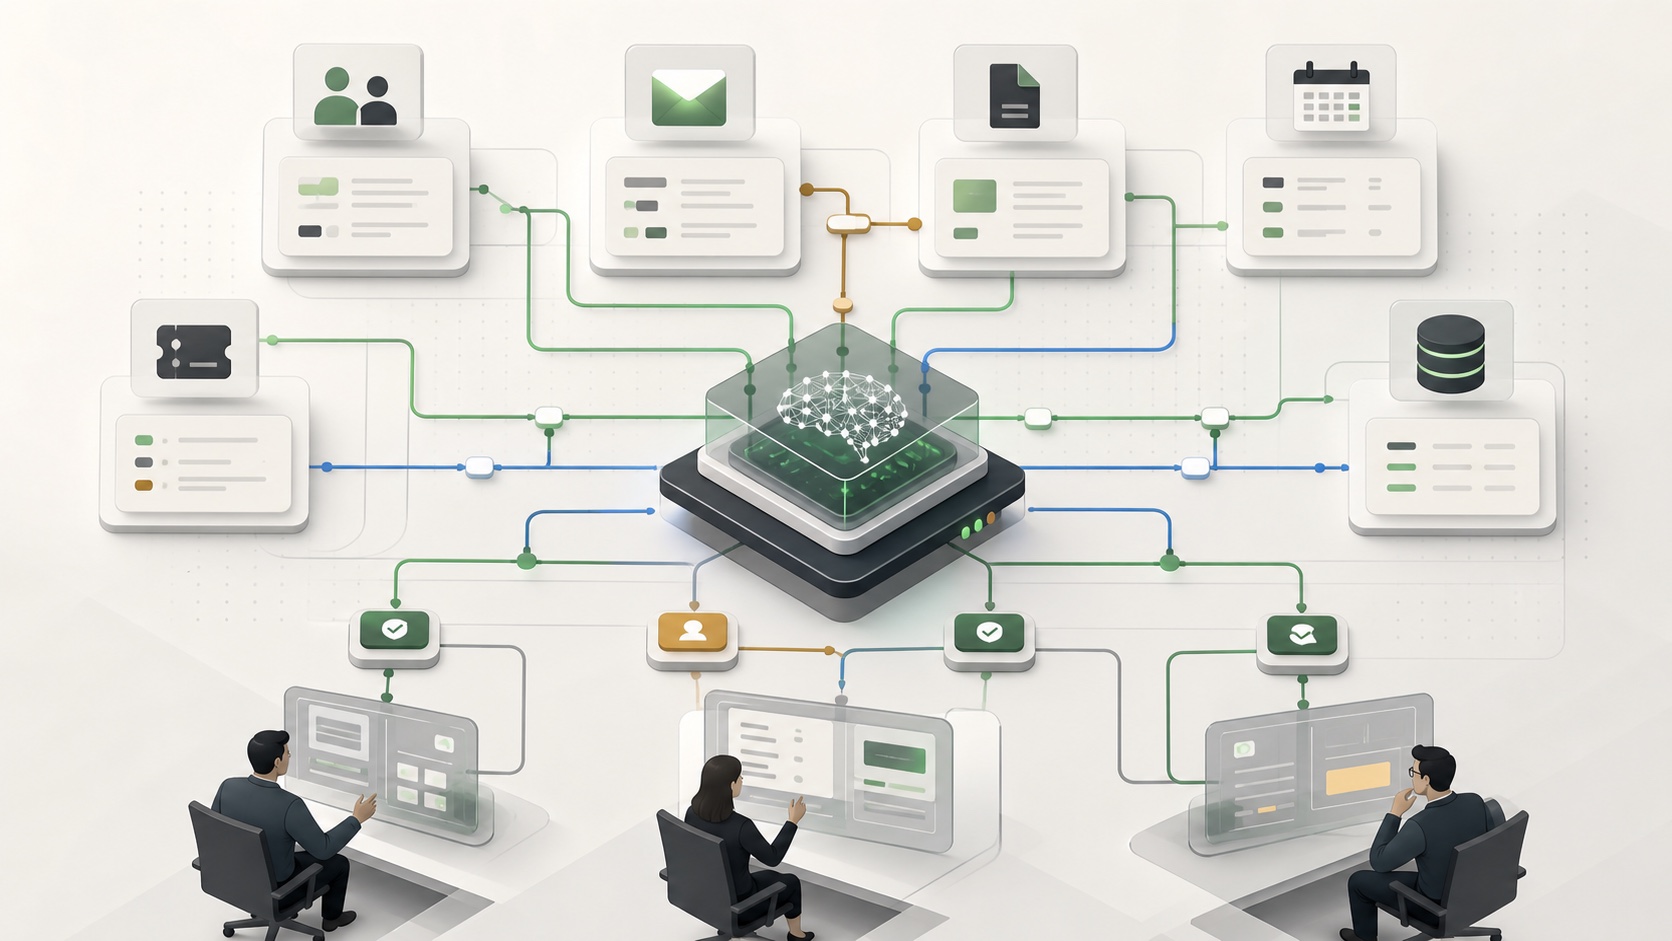
    CRM 이메일 문서 캘린더 데이터베이스가 AI 자동화 흐름으로 연결된 개념도
    기업 AI 자동화 시장의 핵심은 모델 하나가 아니라 여러 데이터와 도구를 운영 가능한 흐름으로 묶는 데 있다.

    YC 회사 페이지는 Gumloop을 “AI로 반복적이고 복잡한 워크플로를 끝까지 자동화하는 플랫폼”으로 설명한다. 사용자는 모듈을 드래그 앤 드롭 방식으로 연결해 자동화를 만든다. 코드 작성보다 빠르게 테스트하고 운영할 수 있게 만드는 것이 목표다.

    EO 기사와 TechCrunch, BetaKit 보도도 비슷한 흐름을 보여준다. Gumloop은 2026년 3월 Benchmark가 주도한 5,000만 달러 규모의 Series B 투자를 유치했고, 누적 조달액은 약 7,000만 달러 수준으로 소개된다. 이 숫자보다 더 중요한 것은 투자자들이 본 시장의 방향이다. 기업 안의 직원이 직접 AI 에이전트를 만들고, 반복 업무를 운영 가능한 형태로 묶는 시장이다.

    Max Brodeur-Urbas가 창업 배경과 제품 방향을 설명하는 인터뷰 장면

    Gumloop이 흥미로운 이유는 “모델 성능 경쟁”만을 이야기하지 않기 때문이다. 공식 사이트는 데이터 분석, 지원 티켓 분류, CRM 관리, 회의 준비, 통화 분석 같은 구체적인 업무 에이전트를 전면에 배치한다. 추상적인 AGI보다 실제 부서의 반복 업무가 앞에 나온다.

    클릭 한 번 자동화가 실패하는 4가지 이유

    AI 에이전트 자동화가 실패하는 이유는 대개 기술 부족 하나로 끝나지 않는다. 영상과 외부 자료를 종합하면 네 가지 조건이 보인다.

    1. 업무를 모르면 자동화할 기준도 없다

    AI가 결과를 내더라도 그 결과가 맞는지 판단할 사람이 필요하다. 영업 리드 분류, 고객 문의 triage, 보고서 작성, 회의 준비는 모두 조직마다 기준이 다르다. 업무 맥락을 모르면 자동화는 빠른 실행이 아니라 빠른 오류가 된다.

    2. 데이터 연결 없이는 에이전트가 빈손이다

    기업 자동화는 챗봇 하나로 끝나지 않는다. CRM, 문서, 이메일, 데이터베이스, 티켓 시스템, 캘린더가 연결되어야 한다. 그래서 Gumloop 같은 플랫폼은 모델보다 연결과 실행 흐름을 강조한다.

    3. 반복 실행에는 통제와 관찰이 필요하다

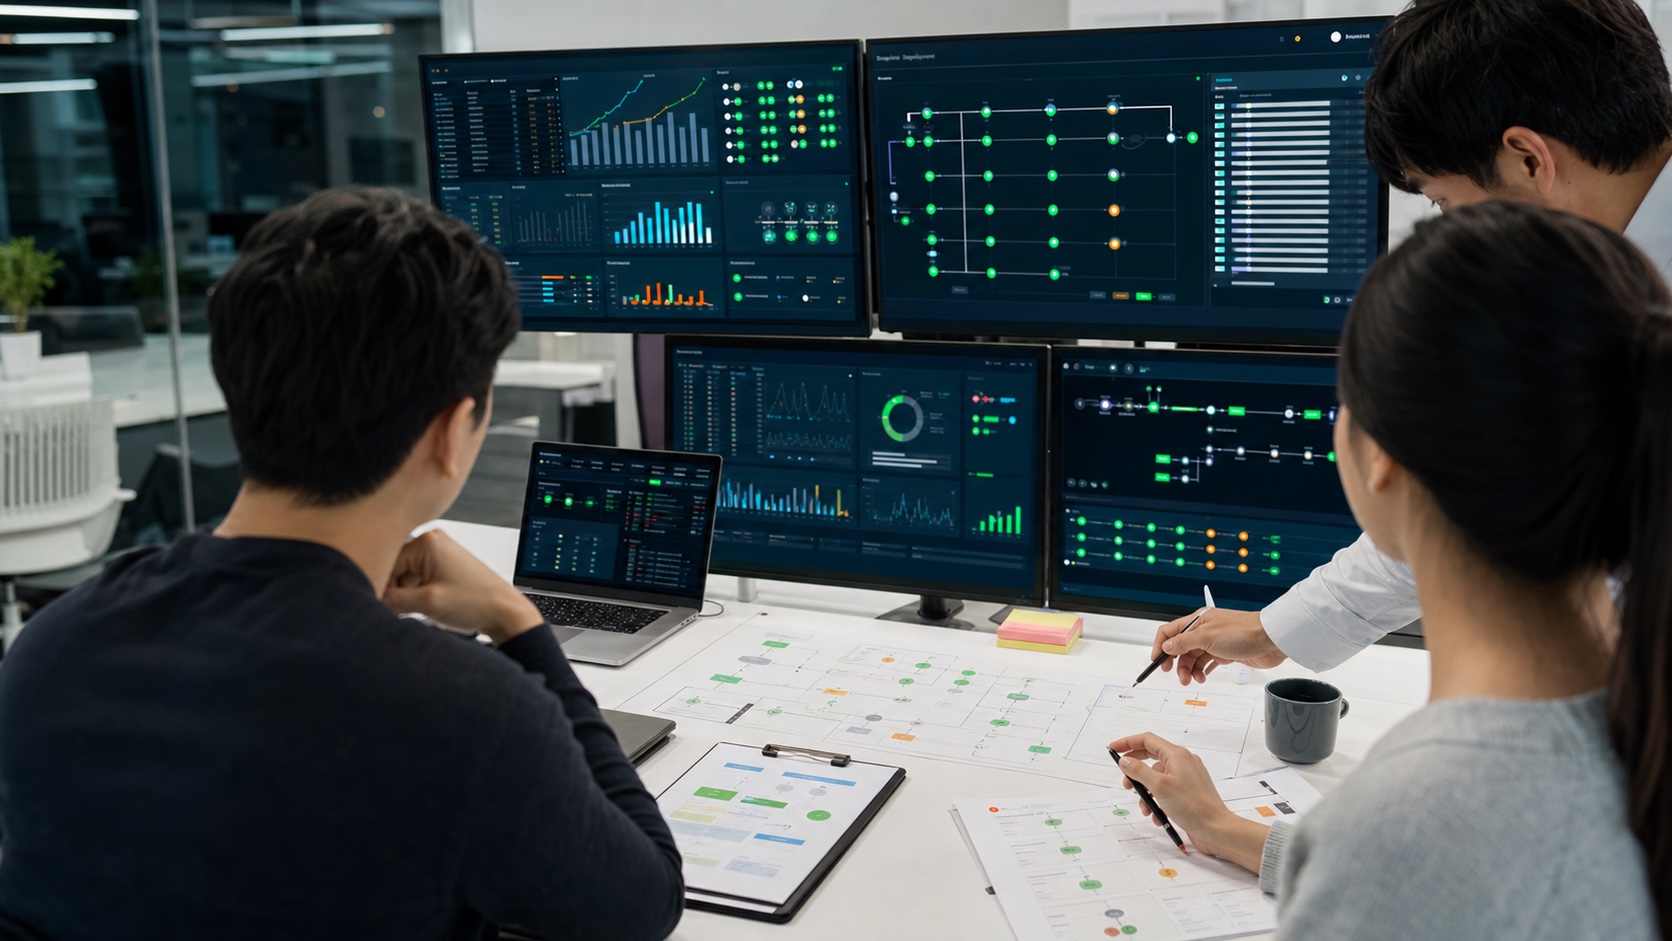
    AI 자동화 워크플로의 실행 상태와 승인 지점을 대시보드로 점검하는 회의 장면
    매일 돌아가는 자동화에는 로그, 승인, 실패 알림처럼 사람이 관찰하고 멈출 수 있는 장치가 필요하다.

    한 번 성공한 프롬프트와 매일 돌아가는 업무 자동화는 다르다. 반복 작업에는 실패 알림, 승인 단계, 로그, 권한 관리가 필요하다. AI 에이전트가 많아질수록 “누가 무엇을 했는지”를 볼 수 있어야 한다.

    4. 자동화는 학습을 대신하지 않는다

    Max는 AI를 학습 도구로 쓰는 것과 이해를 건너뛰는 것을 구분한다. AI가 설명하고 도와줄 수는 있다. 하지만 사용자가 왜 그런 결과가 나왔는지 전혀 모른다면, 자동화는 실력의 확장이 아니라 의존의 확대가 된다.

    비개발자 자동화의 진짜 의미

    Gumloop이 말하는 비개발자 자동화는 “아무나 아무렇게나 만든다”가 아니다. 더 정확히 말하면 업무 담당자가 엔지니어에게 모든 요구사항을 번역해 넘기지 않아도 된다는 뜻이다.

    마케터는 캠페인 리드 흐름을 안다. 영업 담당자는 CRM 업데이트의 귀찮은 지점을 안다. HR 담당자는 반복되는 후보자 커뮤니케이션을 안다. 운영 담당자는 예외 처리가 어디서 터지는지 안다. 이들이 자동화의 설계자가 될 수 있다면, 기업의 AI 도입 속도는 확실히 빨라진다.

    다만 여기에도 조건이 있다. 조직은 자동화 권한을 어디까지 줄지 정해야 한다. 어떤 데이터에 접근할 수 있는지, 어떤 작업은 승인 후 실행해야 하는지, 실패했을 때 누가 책임지는지도 정해야 한다. AI 에이전트 도입은 도구 구매가 아니라 운영 방식의 재설계다.

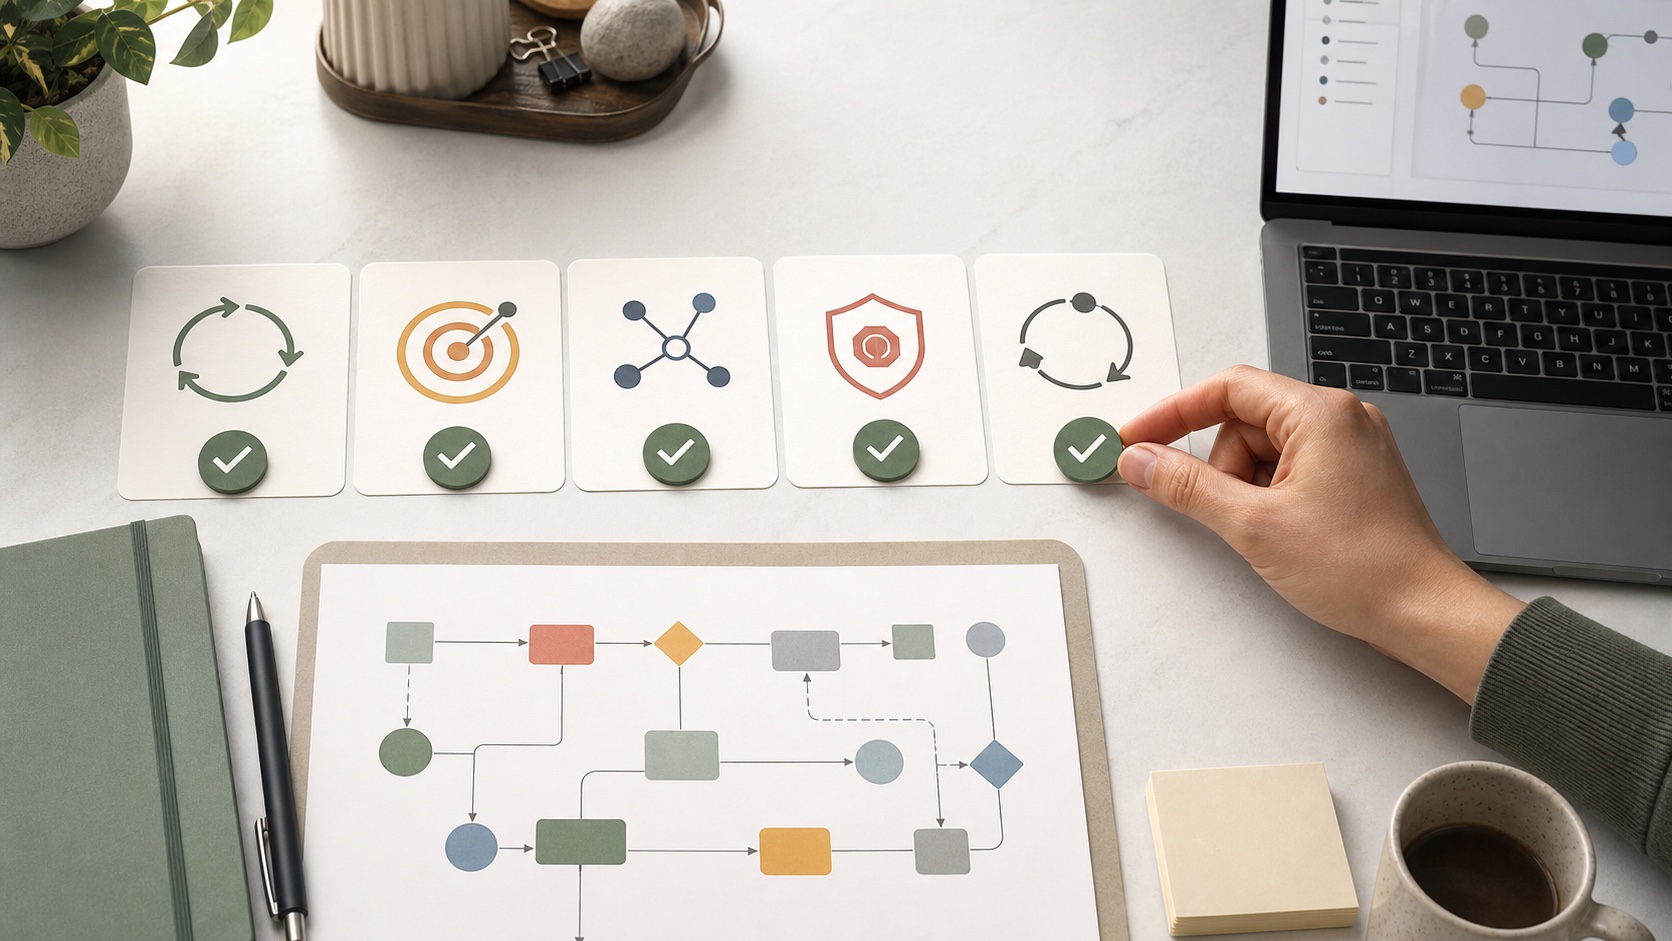
    AI 업무 자동화를 시작할 때 확인할 체크리스트

    반복 업무 성공 기준 데이터 연결 안전 장치 피드백 루프를 점검하는 AI 자동화 체크리스트 이미지
    작은 자동화라도 반복 업무, 성공 기준, 데이터 연결, 안전 장치, 피드백 루프를 먼저 확인해야 한다.

    AI 에이전트 자동화를 도입하려는 개인이나 조직이라면, 먼저 다음 질문을 던지는 편이 낫다.

    1. 반복되는 업무가 실제로 존재하는가?
    2. 그 업무의 성공 기준을 담당자가 말로 설명할 수 있는가?
    3. 필요한 데이터와 도구가 연결 가능한가?
    4. 실패했을 때 멈추거나 검토할 장치가 있는가?
    5. 자동화 결과를 개선할 피드백 루프가 있는가?

    이 다섯 가지가 없다면 에이전트를 늘리는 일은 큰 의미가 없다. 반대로 이 조건이 있다면 작은 자동화 하나도 조직의 일하는 방식을 바꿀 수 있다.

    Max Brodeur-Urbas가 실행과 사람의 중요성을 설명하는 인터뷰 후반 장면

    Thinknote의 AI 에이전트 글과 함께 읽기

    이 글의 관점은 Thinknote의 기존 AI 에이전트 글과도 이어진다.

    결론: AI 에이전트는 ‘대체’보다 ‘운영’의 문제다

    Gumloop 창업자 인터뷰가 던지는 메시지는 단순하다. AI가 모든 일을 알아서 해준다는 약속은 매력적이지만 위험하다. 실제 가치는 자신이 잘 아는 업무를 더 빠르고 안정적으로 실행할 때 나온다.

    그래서 AI 에이전트 자동화의 질문은 “몇 개의 에이전트를 쓰느냐”가 아니다. 더 좋은 질문은 이것이다.

    내가 자동화하려는 업무를 충분히 이해하고 있는가. 그리고 그 자동화가 매일 돌아가도 괜찮을 만큼 검증·권한·피드백 구조를 갖추고 있는가.

    이 질문에 답할 수 있을 때, AI 에이전트는 유행어가 아니라 일하는 방식의 인프라가 된다.

    FAQ

    AI 에이전트 자동화는 무엇인가요?

    AI 에이전트 자동화는 AI 모델을 이용해 반복 업무, 데이터 처리, 도구 간 작업, 알림, 보고, 분류 등을 하나의 실행 흐름으로 묶는 방식입니다. 단순한 챗봇보다 업무 시스템과 연결되는 실행성이 중요합니다.

    Gumloop은 어떤 회사인가요?

    Gumloop은 비개발자도 모듈을 연결해 AI 기반 업무 자동화를 만들 수 있게 하는 플랫폼입니다. YC 회사 페이지와 공식 사이트는 반복적이고 복잡한 워크플로를 AI로 자동화하는 데 초점을 둔다고 설명합니다.

    AI 에이전트가 있으면 업무 이해가 필요 없나요?

    아닙니다. 영상에서 Max Brodeur-Urbas가 강조하듯 AI는 이해를 대체하기보다 이미 이해한 일을 더 빠르게 실행하도록 돕는 도구에 가깝습니다. 결과를 평가하고 개선할 기준은 여전히 사람이 가져야 합니다.

    기업이 AI 자동화를 도입할 때 가장 먼저 볼 것은 무엇인가요?

    반복 업무의 존재, 성공 기준, 데이터 연결 가능성, 권한 관리, 실패 시 검토 체계가 먼저입니다. 도구 선택은 그다음입니다.

    AI 자동화 플랫폼과 일반 챗봇의 차이는 무엇인가요?

    일반 챗봇은 대화와 답변에 초점이 있습니다. AI 자동화 플랫폼은 데이터 소스, 업무 도구, 반복 실행, 승인 단계, 결과 기록까지 포함한 워크플로 운영에 초점을 둡니다.

    참고자료