[작성자:] Saturn

  • PHP R 연동 방법: 웹에서 R 스크립트를 호출하고 결과 받는 법

    PHP R 연동 방법: 웹에서 R 스크립트를 호출하고 결과 받는 법

    1. PHP와 R 코드 연동 실행

    PHP와 R 코드 연동: PHP와 R 코드를 연동해서 실행하는 것은 두 프로그래밍 언어의 장점을 결합하여 복잡한 웹 애플리케이션과 데이터 분석을 함께 처리할 수 있습니다. 하지만 여러 장단점이 존재하기에 개발 목표와 시나리오를 고려해서 PHP와 R 코드를 연동할 것인지 결정해야 합니다.
    Read in English

    php와 R 코드

    1) PHP와 R 코드 연동 장점

    1. 언어 전문성 활용: PHP는 웹 개발에, R은 데이터 분석에 강점을 가지고 있습니다. 두 언어의 각각의 장점을 활용할 수 있습니다.
    2. 코드 재사용: 이미 R로 작성된 데이터 분석 코드나 모델을 웹 애플리케이션에서 쉽게 재사용할 수 있습니다.
    3. 동적인 웹 콘텐츠 생성: PHP에서 R 코드를 실행하면 실시간 데이터 분석 결과를 웹사이트에 동적으로 표현할 수 있습니다.
    4. 복잡한 분석 가능: R은 통계 분석, 머신러닝, 그래프 생성 등 매우 다양한 데이터 분석 기능을 제공합니다.
    5. 시스템 리소스 효율성: 필요한 경우에만 R 코드를 실행하여 시스템 리소스를 효율적으로 활용할 수 있습니다.

    2) PHP와 R 코드 연동 단점

    1. 성능 이슈: PHP에서 R 코드를 실행하는 것은 일반적으로 느릴 수 있고, 대량의 데이터를 다루거나 복잡한 분석을 할 때에는 특히 성능에 문제가 될 수 있습니다.
    2. 보안 취약성: exec나 shell_exec 같은 함수를 사용하면 서버가 취약해질 위험이 있습니다. 이러한 함수를 사용할 때는 신중해야 합니다.
    3. 환경 설정과 관리: R과 PHP를 함께 실행하려면 두 환경을 모두 잘 설정하고 유지해야 하며, 이로 인해 복잡성이 증가할 수 있습니다.
    4. 에러 처리: 두 언어간의 연동에서는 에러 처리가 복잡해질 수 있습니다. PHP와 R 양쪽에서 발생할 수 있는 에러를 모두 캐치하고 관리해야 합니다.
    5. 메모리 사용량: R은 메모리를 상당히 많이 사용하는 언어입니다. PHP 프로세스와 R 프로세스가 동시에 실행되면 메모리 사용량이 크게 증가할 수 있습니다.
    6. 버전 호환성: 시간이 지남에 따라 R 라이브러리나 PHP 패키지가 업데이트되고, 이로 인해 호환성 문제가 발생할 수 있습니다.

    2. exec 함수를 사용하여 PHP에서 R 코드 실행

    PHP의 exec() 함수를 사용하여 R 코드를 실행하는 것은 PHP에서 외부 프로그램을 실행할 수 있는 간단한 방법입니다. 이 방법은 일반적으로 PHP가 실행되는 서버에 R이 설치되어 있어야 하며, exec() 함수가 서버 설정에서 비활성화되지 않았는지 체크해 두세요.

    1) 개념

    exec() 함수는 PHP에서 외부 프로그램을 실행할 때 사용합니다. 이 함수를 사용하여 R 스크립트를 실행하려면, 명령 줄에서 R 스크립트를 실행하는 명령어를 인수로 전달하면 됩니다. 일반적으로 이 명령어는 Rscript입니다.

    exec("Rscript [R 스크립트 경로]", $output);

    2) 예제1

    예제1은 PHP의 exec() 함수를 사용하여 R 스크립트 simple_example.R을 실행하는 매우 간단한 예시입니다.

    R 스크립트 (simple_example.R):

    result <- 1 + 1
    cat(result)

    PHP 코드:

    <?php
    exec("Rscript simple_example.R", $output);
    echo "R output: " . implode("\n", $output);
    ?>

    2) 예제2

    예제2는 PHP에서 R 스크립트를 실행하여 선형 모델을 적합하고, 그 결과를 요약하여 텍스트 파일에 저장하는 과정을 드러납니다. 이후에 PHP 코드는 이 텍스트 파일을 읽어 출력합니다.

    R 스크립트 (linear_model.R):

    x <- c(1, 2, 3, 4, 5)
    y <- c(2, 4, 1, 8, 7)
    fit <- lm(y ~ x)
    summary_str <- capture.output(summary(fit))
    write(summary_str, "summary.txt")

    PHP 코드:

    <?php
    exec("Rscript linear_model.R");
    
    // R로부터 생성된 summary.txt 파일을 읽기
    $summary = file_get_contents("summary.txt");
    echo "R Summary:\n$summary";
    ?>

    3) 예제3

    예제3는 R 스크립트와 PHP가 CSV 파일을 읽고 쓰는 과정을 통해 상호작용하는 방법을 드러납니다. 이 예제에서는 특히 R 스크립트가 명령 줄 인자를 받아 동적으로 처리하는 방법을 설명합니다.

    R 스크립트 (data_processing.R):

    args <- commandArgs(trailingOnly = TRUE)
    input_file <- args[1]
    output_file <- args[2]
    
    data <- read.csv(input_file)
    data$sum <- rowSums(data[, c("col1", "col2")])
    
    write.csv(data, output_file)

    PHP 코드:

    <?php
    $input_file = "input.csv";
    $output_file = "output.csv";
    
    exec("Rscript data_processing.R $input_file $output_file");
    
    // R로부터 생성된 output.csv 파일을 읽기
    $output_data = file_get_contents("output.csv");
    echo "R Output Data:\n$output_data";
    ?>

    주의사항

    • exec() 함수는 서버에서 비활성화되지 않았는지 체크해 두세요.
    • 보안 문제: exec() 함수는 잘못 사용되면 서버의 보안에 문제를 일으킬 수 있으므로 주의가 해야 합니다.
    • 에러 처리: exec() 함수는 기본적으로 실패시에 PHP 경고를 출력하지 않으므로, 별도의 에러 처리 로직을 구현해야 할 수 있습니다.

    3. Rserve 패키지를 사용하여 PHP에서 R 코드 실행

    1) Rserve 개념

    Rserve는 R에서 제공하는 패키지 중 하나로, R을 서버로 운영하게 해주는 패키지입니다. 일반적으로 R은 대화형 통계 계산을 위한 도구로 사용되지만, Rserve를 통해 R을 서버로서 운영하고 다른 애플리케이션(예: PHP, Java, Python 등)에서 R 코드를 실행할 수 있습니다. 이러한 작업은 TCP/IP 프로토콜을 사용하여 이루어집니다.

    • TCP/IP 프로토콜 지원: 다른 언어나 프레임워크와 통신이 쉽습니다.
    • 다중 세션 지원: 여러 사용자가 동시에 R의 서비스를 사용할 수 있습니다.
    • 플랫폼 독립성: 다양한 운영 체제와 언어에서 사용할 수 있습니다.
    • 진입 장벽이 낮음: R에 익숙한 사용자는 비교적 쉽게 Rserve를 사용할 수 있습니다.

    2) 장단

    1. 언어 간의 통합 가능: R만의 특별한 데이터 분석 라이브러리나 기능을 다른 언어에서 쉽게 이용할 수 있습니다.
    2. 성능 최적화: R 작업을 별도의 서버에서 처리하므로 웹 서버의 부하를 줄일 수 있습니다.
    3. 코드 재사용성: 같은 R 코드를 여러 애플리케이션에서 재사용할 수 있습니다.
    4. 동시성: 여러 사용자가 동시에 R 분석을 수행할 수 있습니다.

    3) 단점

    1. 설정 복잡성: R과 Rserve, 그리고 다른 프로그래밍 언어 사이의 인터페이스를 설정해야 하는 복잡성이 있을 수 있습니다.
    2. 디버깅 어려움: R과 다른 언어 간의 연동은 디버깅을 복잡하게 만들 수 있습니다.
    3. 보안 취약성: TCP/IP를 통해 통신하기 때문에, 잘못 구성하면 보안 취약점이 될 수 있습니다.

    4) 기본 사용

    1. R에서 Rserve를 설치합니다:
      install.packages("Rserve")
    2. R에서 Rserve를 시작합니다:
      library(Rserve)
      Rserve()
    3. PHP Rserve 클라이언트를 설치합니다. composer.json 파일을 생성하고 아래 내용을 추가합니다.
      {
          "require": {
              "cturbelin/rserve-php": "^2.1"
          }
      }
    4. 터미널에서 composer instll을 실행하면 vendor폴더가 생성되고 관련 파일이 포함됩니다
    5. PHP 코드에서 R 함수를 호출합니다:
      <?php
      require './vendor/autoload.php';
      define('RSERVE_HOST', 'localhost');
      use Sentiweb\Rserve\Connection;
      use Sentiweb\Rserve\Parser\NativeArray;
      $cnx = new Connection(RSERVE_HOST);
      $r = $cnx->evalString('2+2'
      );
      echo $r;
      ?>
    6. 실행시 에러가 발생된다면 php-mbstring이 올바르게 설치되어 있는지를 체크해 두세요.

    5) 여러 줄 사용

    $r->evalString() 안에 여러 줄의 R 코드를 넣어 실행할 수 있습니다. R 코드를 문자열로 여러 줄에 걸쳐 작성하면 됩니다.

    <?php
    require './vendor/autoload.php';
    define('RSERVE_HOST', 'localhost');
    use Sentiweb\Rserve\Connection;
    use Sentiweb\Rserve\Parser\NativeArray;
    $cnx = new Connection(RSERVE_HOST);
    
    // 여러 줄의 R 코드
    $script = <<<RSCRIPT
    x <- c(1, 2, 3, 4, 5)
    y <- c(2, 4, 1, 8, 7)
    fit <- lm(y ~ x)
    summary_fit <- summary(fit)
    RSCRIPT;
    
    $r->evalString($script);
    
    $summary = $cnx->evalString('capture.output(summary_fit)');
    foreach($summary as $line) {
        echo $line . "\n";
    }
    ?>

    이 예제에서는 R 코드를 HereDoc (<<<RSCRIPT ... RSCRIPT;) 형식으로 작성하여 여러 줄을 포함시켰습니다. 그 후, evalString() 메서드를 호출하여 이 여러 줄의 코드를 한 번에 실행하고 있습니다.

    이렇게 하면 복잡한 R 스크립트도 PHP에서 실행할 수 있습니다.

    3. Rserve 패키지를 사용하여 PHP에서 R 코드 실행

    Rserve는 웹 서버나 다른 애플리케이션에서 복잡한 통계 분석이나 데이터 처리를 필요로 할 때 유용하게 사용될 수 있습니다. 하지만 사용 전에 위에서 언급한 장단점을 충분히 고려해야 합니다.

    R 프로그램을 다운로드하려면 R 프로그램 공식 웹사이트(https://www.r-project.org/)에서 다운로드 링크를 클릭하여 다운로드할 수 있습니다.
    R 프로그램 모두보기 :

    함께 읽으면 좋은 글

  • unnest_tokens 함수 사용법: R 텍스트 마이닝에서 단어로 나누는 방법

    unnest_tokens 함수 사용법: R 텍스트 마이닝에서 단어로 나누는 방법

    unnest_tokens () 함수는 R 프로그래밍 언어의 tidytext 패키지에 포함되어 있는 함수로, 텍스트 데이터를 토큰 단위로 분리합니다. 이 함수는 ‘tidy data’ 형식에 적합하게 텍스트를 처리하므로, 텍스트 마이닝 및 자연어 처리에 유용합니다. 이 함수는 각 토큰을 새로운 행으로 만들며, 텍스트가 포함된 열 외의 다른 열은 그대로 유지됩니다.

    Read in English

    unnest_tokens

    unnest_tokens 함수는 R 텍스트 마이닝에서 문장이나 문서를 단어 단위로 나누는 핵심 도구입니다. 텍스트 자료를 분석하려면 먼저 문장을 토큰으로 쪼개고, 단어 빈도나 감성 분석처럼 다음 단계로 연결할 수 있어야 합니다. 이 글은 tidytext 기반 토큰화 흐름과 unnest_tokens 함수의 사용법을 정리합니다.

    1. unnest_tokens() 개념

    unnest_tokens() 함수는 R의 tidytext 패키지에 포함되어 있으며, 텍스트 데이터를 토큰화(tokenization)하는 데 사용됩니다. 토큰화란 긴 텍스트 문자열을 더 작은 단위, 예를 들어 단어나 문장으로 분해하는 과정입니다.

    이 함수는 텍스트 데이터를 처리하고 분석하기 쉬운 형태로 변환하는 데 유용합니다. 예를 들어, 하나의 문서나 문장을 구성하는 단어들을 분리할 수 있습니다.

    1) 설치와 라이브러리 로딩

    install.packages("tidytext")
    library(tidytext)

    2) unnest_tokens 기본 사용법

    기본적인 함수의 형태는 이렇게 볼 수 있습니다.

    unnest_tokens(data, output_column, input_column, token = "words", ...)
    • data: 토큰화할 데이터 프레임.
    • output_column: 토큰을 저장할 새로운 열의 이름.
    • input_column: 토큰화할 텍스트가 들어있는 열의 이름.
    • token: 토큰의 유형 (기본값은 “words”).

    예제

    library(dplyr)
    library(tibble)
    
    # 예제 데이터
    data <- tibble(id = c(1, 2), text = c("I love R", "Data science is awesome"))
    
    # 단어로 토큰화
    tokenized_data <- data %>%
      unnest_tokens(word, text)
    
    # 결과 확인
    print(tokenized_data)

    이 예제에서는 id 열과 text 열을 가진 tibble 데이터 프레임을 사용했습니다. unnest_tokens() 함수를 적용하여 text 열의 텍스트를 단어 단위로 토큰화했고, 그 결과를 새로운 word 열에 저장했습니다.

    추가 옵션

    • drop : FALSE로 설정하면 입력 열을 결과에 포함합니다.
    • to_lower : FALSE로 설정하면 대/소문자를 구분합니다.
    • strip_numeric, strip_punct, strip_mark, collapse 등: 추가적인 텍스트 클리닝 옵션들.

    이 함수는 매우 유연하므로 다양한 텍스트 데이터에 적용할 수 있습니다. 여러 토큰화 옵션과 다른 tidytext 함수와 함께 사용하여 더 복잡한 텍스트 분석 작업을 수행할 수 있습니다.

    • 토큰(Token): 텍스트를 분석할 때 기본 단위가 되는 것으로, 보통 단어나 구절, 문장 등이 될 수 있습니다.
    • Tidy Text: 각 단어(토큰)가 하나의 행을 이루고, 문서나 다른 식별자와 함께 저장되는 텍스트 데이터 형식을 뜻합니다.

    2. unnest_tokens 매개변수

    unnest_tokens() 함수는 여러 가지 옵션을 가지고 있어 텍스트를 토큰화하는 과정을 세밀하게 조절할 수 있습니다. 아래에 몇 가지 주요 옵션을 설명하겠습니다.

    1) 기본 매개변수:

    1. data: 토큰화할 데이터 프레임.
    2. output_column: 토큰을 저장할 새 열의 이름.
    3. input_column: 토큰화할 텍스트가 들어 있는 열의 이름.
    4. token: 토큰의 유형 (예: “words”, “characters”, etc.)

    2) 추가적인 옵션:

    1. drop: 논리형. 입력 열을 결과에서 제거할지 여부. 기본값은 TRUE.
    2. to_lower: 논리형. 모든 문자를 소문자로 변환할지 여부. 기본값은 TRUE.
    3. strip_numeric: 논리형. 숫자를 제거할지 여부. 기본값은 FALSE.
    4. strip_punct: 논리형. 구두점을 제거할지 여부. 기본값은 FALSE.
    5. collapse: 문자열. 이 문자열로 토큰을 연결할지 여부. 기본값은 NULL.
    [ 예시 코드 ]
    library(dplyr)
    library(tidytext)
    
    # 예제 데이터
    data <- tibble(id = c(1, 2), text = c("I love R", "Data science is awesome"))
    
    # 단어로 토큰화, 원래 열을 유지, 대문자 유지
    tokenized_data <- data %>%
      unnest_tokens(word, text, drop = FALSE, to_lower = FALSE)
    
    # 결과 확인
    print(tokenized_data)

    3) 비고

    • drop = FALSE를 설정하면, 토큰화 후에도 원래의 input_column이 결과에 유지됩니다.
    • to_lower = FALSE를 설정하면, 대/소문자를 그대로 유지합니다.
    • strip_numeric = TRUE로 설정하면, 숫자가 제거됩니다.
    • strip_punct = TRUE로 설정하면, 구두점이 제거됩니다.

    이러한 옵션을 조합하여 토큰화의 정밀도를 높이거나, 전처리 과정을 단순화할 수 있습니다.

    • input: 토큰화할 텍스트가 들어있는 열의 이름입니다.
    • output: 토큰화된 결과를 저장할 새로운 열의 이름입니다.
    • token: 어떤 단위로 토큰화할지 결정하는 옵션입니다. ‘words’, ‘characters’, ‘ngrams’, ‘sentences’, ‘lines’, ‘paragraphs’, ‘regex’ 등이 있습니다.

    4) 생략

    unnest_tokens() 함수에서 input과 output 매개변수는 생략 가능하긴 하지만, 그 경우 함수는 데이터 프레임의 첫 번째 열을 input으로, word를 output 열 이름으로 기본 설정을 사용하게 됩니다. 그래서 다음과 같은 형태로도 사용할 수 있습니다:

    text %>%
      unnest_tokens(token = "sentences")

    하지만 이렇게 할 경우, 어떤 열이 토큰화되는지와 토큰이 어떤 열에 저장되는지 명확하게 코드만으로 이해하기 어려울 수 있습니다. 코드의 가독성과 유지 보수를 위해 명시적으로 input과 output을 지정하는 것이 좋습니다.

    명시적으로 열 이름을 지정해주면 코드를 읽는 사람이나 나중에 코드를 수정할 때 해당 열이 무엇을 의미하는지 더 쉽게 알 수 있기 때문에 추천되는 방식입니다.

    R 프로그램을 다운로드하려면 R 프로그램 공식 웹사이트(https://www.r-project.org/)에서 다운로드 링크를 클릭하여 다운로드할 수 있습니다.
    R 프로그램 모두보기 :

    함께 읽으면 좋은 글

    핵심 확인 체크리스트

    • 분석할 텍스트 컬럼이 명확한가?
    • 문장·단어·n-gram 중 어떤 단위로 나눌지 정했는가?
    • 토큰화 후 불용어 제거와 빈도 분석 계획이 있는가?
    • 한글 텍스트 처리에서 형태소 분석이 필요한지 확인했는가?

    함께 읽으면 좋은 R통계 글

    FAQ

    unnest_tokens 함수는 어떤 역할을 하나요?

    unnest_tokens 함수는 긴 텍스트를 분석 가능한 작은 단위로 나눕니다. 문장, 단어, n-gram 등으로 분리한 결과를 데이터프레임 형태로 만들어 빈도 분석이나 시각화에 활용할 수 있습니다.

    R 텍스트 마이닝에서 토큰화가 왜 필요한가요?

    컴퓨터가 문서 전체를 바로 의미 단위로 분석하기는 어렵습니다. 토큰화는 텍스트를 단어 같은 분석 단위로 나누어 빈도, 공출현, 감성 점수 등을 계산할 수 있게 만드는 전처리 단계입니다.

    unnest_tokens 결과는 단어 빈도 분석과 어떻게 연결되나요?

    토큰화 결과는 보통 한 행에 하나의 단어가 들어가는 형태가 됩니다. 이후 count, group_by, arrange 같은 dplyr 함수를 사용하면 단어 빈도표나 상위 키워드 목록을 만들 수 있습니다.

  • Tibble 이해와 as_tibble() 함수

    Tibble 이해와 as_tibble() 함수

    1. Tibble 이란?

    Tibble 은 R에서 데이터를 다루기 위한 데이터 구조 중 하나로 R의 데이터 프레임(data.frame)을 좀 더 유용하게 확장한 것으로 보면 됩니다.

    Read in English

    tibble

    Tibble 은 tidyverse 패키지의 일부로 제공되며, 데이터 프레임과 호환성이 있습니다. Tibble은 데이터 출력이 보기 좋고, 부분적으로 큰 데이터를 처리할 때 유용하며, 변수 유형이나 변수 이름을 다룰 때 더 간편합니다.

    1) 주요 특징

    • 출력: Tibble은 콘솔에 출력될 때 가독성이 높습니다. 먼저 10개의 행만 보여주고, 전체 열을 보여주지 않을 수도 있습니다.
    • 열 데이터 유형: Tibble은 열 데이터 유형을 더 잘 유지합니다. 예를 들어, 문자형 데이터는 문자형으로 유지됩니다.
    • 열과 행 부분 선택: Tibble은 [[]] 또는 $을 사용할 때도 더 안정적입니다. 예를 들어, 존재하지 않는 열 이름을 요청하면 에러를 반환합니다.

    2) Tibble 생성하기

    Tibble을 생성하는 방법은 여러 가지입니다.

    • tibble() 함수를 사용하여 직접 생성:
    library(tibble) my_tibble <- tibble(x = 1:5, y = 1, z = x ^ 2 + y)
    • 기존의 데이터 프레임을 as_tibble() 함수로 변환:
    my_data_frame <- data.frame(x = 1:5, y = 1, z = x ^ 2 + y) my_tibble <- as_tibble(my_data_frame)
    • tibble() 함수를 사용하여 직접 생성: library(tibble) my_tibble <- tibble(x = 1:5, y = 1, z = x ^ 2 + y)
    • 기존의 데이터 프레임을 as_tibble() 함수로 변환: my_data_frame <- data.frame(x = 1:5, y = 1, z = x ^ 2 + y) my_tibble <- as_tibble(my_data_frame)

    3) Tibble 사용하기

    Tibble은 데이터 프레임과 거의 유사하게 작동하므로, 대부분의 데이터 프레임 함수와 호환됩니다.

    # 열 선택
    my_tibble$x
    # 행 선택
    my_tibble[1:2,]
    # dplyr 사용
    library(dplyr)
    my_tibble %>% filter(x > 2)

    4) Tibble 추가 기능

    Tibble은 또한 몇 가지 추가적인 기능과 옵션을 제공합니다. 예를 들어, 데이터 유형을 강제할 수 있고, 행과 열에 대한 메타 데이터를 추가할 수 있습니다.

    Tibble은 기존의 데이터 프레임보다 다루기 쉽고, 가독성이 높으며, 큰 데이터 셋을 효과적으로 다룰 수 있습니다.

    tibble은 R에서 데이터를 다룰 때 사용되는 데이터 프레임(data.frame)의 하위 클래스입니다. tibble은 tidyverse의 일부로, 다양한 방법으로 데이터 처리를 더 간편하고 효율적으로 해줍니다. as_tibble() 함수는 주어진 데이터 객체를 tibble 객체로 변환해줍니다.

    3) Tibble 데이터 타입 확인

    tibble 데이터 타입을 확인하기 위해서는 tibble 패키지를 설치해야 합니다

    install.packages("tibble")

    tibble 데이터는 is_tibble로 확인하면 된다. class(ti_iris)의 출력값 [1] “tbl_df” “tbl” “data.frame”는 ti_iris 객체가 여러 클래스를 가지고 있다는 것을 나타냅니다. R에서는 하나의 객체가 여러 클래스를 가질 수 있으며, 이는 객체의 상속 구조를 반영합니다.

    1. “tbl_df”: 이는 ti_iris가 tibble 형태의 데이터 프레임임을 나타냅니다. tbl_df는 tibble 패키지에서 정의된 클래스입니다.
    2. “tbl”: 이 클래스는 tbl_df의 상위 클래스로, tbl 객체의 기본적인 특성을 나타냅니다. 이것은 보통 tbl_df와 함께 나타나며, tibble 패키지에서 정의됩니다.
    3. “data.frame”: 이는 ti_iris가 기본적으로 일반적인 R 데이터 프레임이기도 하다는 것을 나타냅니다. data.frame은 R의 기본 클래스 중 하나입니다.
    is_tibble(ti_iris)
    TRUE
    class(ti_iris)
    [1] "tbl_df"     "tbl"        "data.frame"

    2. as_tibble() 함수 이해

    as_tibble() 함수는 다양한 데이터 객체(예: data.frame, matrix 등)를 tibble 형태로 변환합니다. tibble은 데이터 프레임과 유사하지만 몇 가지 중요한 차이점이 있습니다. 예를 들어, tibble은 데이터 출력을 더 깔끔하게 해주고, 변수 유형을 더 유연하게 다룰 수 있습니다.

    as_tibble() 함수는 데이터를 tibble 형태로 변환하는데 사용되며, 다양한 옵션을 지원합니다. 아래는 그 옵션들에 대한 자세한 설명입니다:

    1) x

    첫 번째 인자 x는 변환하려는 데이터입니다. 이것은 벡터, 리스트, 데이터 프레임, 행렬 등 여러 형태를 가질 수 있습니다.

    as_tibble(data.frame(x = 1:3, y = 4:6))

    2) .rows

    .rows 옵션은 불러올 행의 수 또는 범위를 지정합니다. 이를 사용하면 큰 데이터셋에서 일부 행만 선택할 수 있습니다.

    as_tibble(iris, .rows = 1:5)

    3) .name_repair

    .name_repair 옵션은 열 이름을 어떻게 다룰지 지정합니다. 이 옵션은 다음 값을 가질 수 있습니다:

    • “minimal”: 아무런 수정도 하지 않습니다.
    • “unique”: 열 이름을 고유하게 만듭니다.
    • “universal”: 유효한 열 이름으로 변환합니다.
    • “check_unique”: 열 이름이 고유한지 확인하고, 그렇지 않으면 에러를 발생시킵니다.
    as_tibble(data.frame(x = 1, x = 2), .name_repair = "unique")

    4) .col_names (deprecated)

    이 옵션은 이전 버전에서 열 이름을 지정하는 데 사용되었으나 현재는 사용되지 않습니다. 대신 .name_repair을 사용하세요.

    5) … (deprecated)

    이것은 추가적인 인자를 받기 위한 옵션으로, 현재는 사용되지 않습니다.

    예제:

    # .name_repair을 이용한 열 이름 수정
    as_tibble(data.frame(` ` = 1:3, x = c('a', 'b', 'c')), .name_repair = "universal")
    # .rows를 이용한 일부 행만 선택
    as_tibble(mtcars, .rows = 1:5)

    이러한 옵션들을 조합하면 매우 다양한 데이터 변환 작업을 수행할 수 있습니다.

    3. as_tibble() 함수 주요 사용법

    1) 기본 사용법

    • as_tibble(x, …)

    x: 대상 데이터 객체
    ...: 추가적인 옵션 인수

    2) 데이터 프레임을 tibble로 변환

    # tibble 패키지 로드
    library(tibble)
    # 데이터 프레임 생성
    df <- data.frame(name = c("Alice", "Bob", "Carol"),
                     age = c(30, 40, 50))
    # as_tibble로 변환
    df_tibble <- as_tibble(df)
    # 결과 출력
    print(df_tibble)

    3) 행렬을 tibble로 변환

    # 행렬 생성
    mat <- matrix(1:6, nrow = 2)
    # as_tibble로 변환
    mat_tibble <- as_tibble(mat)
    # 결과 출력
    print(mat_tibble)

    4) 리스트를 tibble로 변환

    리스트의 경우, 각 리스트 요소는 tibble의 각 열이 됩니다.

    # 리스트 생성
    lst <- list(name = c("Alice", "Bob"), age = c(30, 40))
    # as_tibble로 변환
    lst_tibble <- as_tibble(lst)
    # 결과 출력
    print(lst_tibble)

    4. as_tibble() 복잡한 예시

    1) 중첩된 데이터

    as_tibble 함수는 리스트의 리스트와 같은 중첩된 데이터 구조도 처리할 수 있습니다.

    # 중첩된 리스트
    nested_list <- list(
      meta = list(name = "sample", version = "1.0"),
      data = list(
        id = 1:3,
        value = c("a", "b", "c")
      )
    )
    # 중첩된 리스트를 tibble로 변환
    nested_tibble <- as_tibble(nested_list)
    print(nested_tibble)

    여기서 nested_tibble은 meta와 data라는 두 개의 열을 가지며, 각 열은 다시 리스트로 이루어져 있습니다.

    2) 데이터 프레임과 리스트의 조합

    데이터 프레임의 일부 열이 리스트로 이루어져 있을 때도 as_tibble 함수가 유용합니다.

    # 리스트를 포함한 데이터 프레임
    df_with_list <- data.frame(
      id = 1:3,
      meta = I(list(
        list(name = "Alice", age = 30),
        list(name = "Bob", age = 40),
        list(name = "Carol", age = 50)
      ))
    )
    # as_tibble로 변환
    tibble_with_list <- as_tibble(df_with_list)
    print(tibble_with_list)

    이렇게 as_tibble 함수는 다양한 옵션과 함께 복잡한 데이터 구조도 유연하게 다룰 수 있습니다. 복잡한 데이터 분석이나 전처리 작업에서 이 함수의 다양한 기능을 활용하면 더욱 효율적인 결과를 얻을 수 있습니다.

    R 프로그램을 다운로드하려면 R 프로그램 공식 웹사이트(https://www.r-project.org/)에서 다운로드 링크를 클릭하여 다운로드할 수 있습니다.
    R 프로그램 모두보기 :

    함께 읽으면 좋은 글

  • 불필요한 공백 제거 str_squish 함수

    불필요한 공백 제거 str_squish 함수

    불필요한 공백 제거를 위해서는 str_squish 함수를 사용합니다. str_squish 함수는 R 프로그래밍 언어의 stringr 패키지에 포함되어 있으며, 문자열에서 앞뒤 및 중간의 공백을 제거하는 기능을 수행합니다. 불필요한 공백 제거를 위해서 str_squish 함수의 개념과 주요 사용법에 대해 확인해 보겠습니다.

    Read in English

    불필요한 공백제거

    1. str_squish의 개념

    str_squish()는 대상 문자열의 시작과 끝에 있는 불필요한 공백을 제거하고, 문자열 내부에 연속된 공백은 하나의 공백으로 줄입니다. 예를 들어 ” Hello World “라는 문자열이 있다면, str_squish() 함수를 적용하면 “Hello World”로 변환됩니다.

    # stringr 패키지 로드
    library(stringr)
    
    # 예제
    str_squish("   Hello   World  ")
    # 출력: "Hello World"

    2. 주요 사용법

    기본 사용법

    • str_squish(string)

    string: 대상 문자열

    1) 벡터에 적용

    str_squish 함수는 문자열 벡터에도 적용할 수 있습니다. 이 경우 각 문자열 요소에 함수가 적용됩니다.

    # 예제
    str_squish(c("   Hello  ", "  World  "))
    # 출력: "Hello" "World"

    2) 데이터 프레임에 적용

    dplyr 패키지와 함께 str_squish 함수를 사용하면 데이터 프레임의 특정 열에 함수를 적용할 수 있습니다.

    # dplyr 패키지 로드
    library(dplyr)
    
    # 예제 데이터 프레임
    df <- data.frame(name = c("  Alice  ", "  Bob  ", "  Carol  "),
                     age = c(30, 40, 50))
    
    # str_squish 적용
    df <- df %>%
      mutate(name = str_squish(name))
    
    # 결과 출력
    print(df)

    3. 마치며

    str_squish() 함수는 텍스트 데이터를 정제할 때 매우 유용한 도구입니다. 이 함수를 활용하면 복잡한 문자열 처리 작업을 간단하게 해결할 수 있습니다. 데이터 분석이나 텍스트 마이닝 작업에서 자주 사용되므로, 이 함수의 활용법을 익혀두면 좋습니다.

    R 프로그램을 다운로드하려면 R 프로그램 공식 웹사이트(https://www.r-project.org/)에서 다운로드 링크를 클릭하여 다운로드할 수 있습니다.
    R 프로그램 모두보기

    함께 읽으면 좋은 글

  • 텍스트 교체 str_replace, str_replace_all 함수

    텍스트 교체 str_replace, str_replace_all 함수

    텍스트 교체(str_replace, str_replace_all) 함수는 문자열 처리에 있어서 매우 유용한 도구입니다. 텍스트 교체 함수는 stringr 패키지에 포함되어 있으며, 특정 문자열을 다른 문자열로 치환하는 작업을 수행합니다.

    Read in English

    텍스트 교체

    1. 텍스트 교체(str_replace, str_replace_all) 함수의 개념

    1) str_replace()

    str_replace() 함수는 문자열 내에서 첫 번째로 나타나는 특정 패턴을 다른 문자열로 치환합니다.

    # stringr 패키지 로드
    library(stringr)
    
    # 예제
    str_replace("apple orange apple", "apple", "banana")
    # 출력: "banana orange apple"

    위 예시에서 “apple”이 첫 번째로 등장할 때만 “banana”로 치환되었습니다.

    2) str_replace_all()

    반면에 str_replace_all() 함수는 문자열 내에서 모든 특정 패턴을 다른 문자열로 치환합니다.

    # 예제
    str_replace_all("apple orange apple", "apple", "banana")
    # 출력: "banana orange banana"

    위 예시에서 “apple”이 모두 “banana”로 치환되었습니다.

    2. str_replace, str_replace_all 함수의 주요 사용법

    기본 사용법

    • str_replace(string, pattern, replacement)
    • str_replace_all(string, pattern, replacement)

    string: 대상 문자열
    pattern: 찾을 패턴
    replacement: 치환할 문자열

    1) 정규 표현식을 사용한 패턴 매칭

    pattern 파라미터에는 정규 표현식을 사용할 수 있습니다. 예를 들어, 모든 숫자를 제거하고 싶다면 다음과 같이 할 수 있습니다.

    # str_replace() 사용 예제
    str_replace("apple1 orange2", "[0-9]", "")
    # 출력: "apple orange2"
    
    # str_replace_all() 사용 예제
    str_replace_all("apple1 orange2", "[0-9]", "")
    # 출력: "apple orange"

    2) 여러 패턴을 한 번에 치환

    str_replace_all() 함수는 여러 패턴을 한 번에 치환할 수 있습니다. 이 때는 pattern과 replacement를 명명된 벡터로 전달합니다.

    # 여러 패턴 치환 예제
    str_replace_all("apple orange pear", c("apple" = "banana", "orange" = "grape"))
    # 출력: "banana grape pear"

    3) 한글, 영문, 그리고 숫자를 제외한 모든 문자 빈 데이터로 치환

    한글, 영문, 그리고 숫자를 제외한 모든 문자를 빈 데이터로 치환하기 위해 str_replace_all 함수를 사용할 수 있습니다. 정규 표현식을 사용하여 이를 적용해보겠습니다.

    아래는 stringr 패키지를 사용한 예시입니다.

    # stringr 패키지 로드
    library(stringr)
    
    # 예제 문자열
    example_str <- "안녕하세요! Hello, 1234!!@@"
    
    # 한글, 영문, 숫자를 제외한 모든 문자를 빈 데이터로 치환
    cleaned_str <- str_replace_all(example_str, "[^가-힣a-zA-Z0-9]", "")
    
    # 결과 출력
    print(cleaned_str)
    #안녕하세요Hello1234

    위의 코드에서 "[^가-힣a-zA-Z0-9]"는 한글(가-힣), 영문(a-zA-Z), 그리고 숫자(0-9)를 제외한 모든 문자를 뜻합니다. 이들을 빈 문자열로 치환하여 결과를 얻을 수 있습니다.

    3. 텍스트 교체 함수 사용법을 마치며

    텍스트 교체(str_replace, str_replace_all) 함수는 텍스트 데이터를 처리할 때 매우 유용한 도구입니다. 이 함수들을 활용하여 복잡한 문자열 처리 작업을 간단하게 해결할 수 있습니다.

    특히, 정규 표현식과 함께 사용하면 더욱 강력한 문자열 처리 능력을 발휘할 수 있습니다.

    R 프로그램을 다운로드하려면 R 프로그램 공식 웹사이트(https://www.r-project.org/)에서 다운로드 링크를 클릭하여 다운로드할 수 있습니다.
    R 프로그램 모두보기

    함께 읽으면 좋은 글

  • R 파이프 연산자 %>% 사용법: 데이터 분석 흐름을 쉽게 읽는 방법

    R 파이프 연산자 %>% 사용법: 데이터 분석 흐름을 쉽게 읽는 방법

    R에서 파이프 연산자(%>%)를 통해 R 프로그래밍 코드의 가독성과 효율성을두 가지 요소를 동시에 증가시킬 수 있습니다.

    Read in English

    파이프 연산자
    파이프 연산자

    R 파이프 연산자는 여러 단계의 데이터 처리 과정을 위에서 아래로 읽을 수 있게 도와주는 문법입니다. 중첩 함수가 많아질수록 코드가 복잡해지는데, 파이프를 사용하면 분석 흐름을 자연스러운 순서로 정리할 수 있습니다. 이 글은 %>%의 기본 구조와 읽는 방법, 데이터 분석에서 자주 쓰는 패턴을 설명합니다.

    본 글에서는 이러한 파이프 연산자가 무엇인지, 왜 필요한지, 그리고 어떻게 활용할 수 있는지에 대해 상세하게 알아보도록 하겠습니다.

    1. 파이프 연산자 %>%란 무엇인가?

    %>% 연산자, 즉 파이프 연산자는 주로 dplyr나 tidyverse 패키지에서 사용됩니다. 이 연산자의 주 목적은 데이터나 결과를 다음 함수로 명확하게 전달하는 것입니다.

    이로써 코드를 더욱 모듈화하고, 각 단계에서 어떤 작업이 이루어지는지 명확하게 파악할 수 있습니다.

    # 간단한 예시
    result <- data %>%
      filter(age > 30) %>%
      select(name, age)

    2. 왜 파이프 연산자 %>%를 사용해야 하는가?

    1) 코드 가독성 향상

    복잡한 데이터 처리 과정을 한 눈에 이해하기 쉽게 만들어 줍니다. 일반적으로 R 코드에서 여러 함수와 연산이 한 줄에 나열되면, 그 코드를 읽는 데 상당한 노력이 해야 합니다.

    하지만 파이프 연산자를 사용하면, 각 단계를 명확하게 구분하여 보다 직관적으로 코드를 이해할 수 있습니다.

    2) 유지보수성 증가

    파이프 연산자를 통해 작성된 코드는 수정이나 확장이 쉽습니다. 특정 단계에 새로운 연산을 추가하거나 삭제해야 할 경우, 해당 부분만을 수정하면 됩니다. 이는 코드의 유지보수를 간편하게 해줍니다.

    3) 직관적인 데이터 처리

    파이프 연산자는 데이터의 흐름을 수직으로 표현합니다. 이는 데이터가 어떻게 변형되는지를 더 직관적으로 이해할 수 있게 도와줍니다.

    3. 파이프 연산자 활용 예시

    %>% 연산자는 파이프 연산자라고도 하며, R에서 특히 dplyr 패키지나 tidyverse 패키지에서 주로 사용됩니다. 이 연산자의 기본적인 역할은 함수의 입력과 출력을 명확하고 읽기 쉬운 방식으로 연결해주는 것입니다.

    파이프 연산자는 데이터를 받아 처리한 후 그 결과를 다음 함수의 첫 번째 인자로 전달합니다. 이로 인해 코드가 훨씬 더 읽기 쉬워지며, 데이터 처리 흐름을 더 명확하게 파악할 수 있습니다.

    예를 들어, dplyr의 filter()와 select() 함수를 사용하는 다음 두 코드는 동일한 작업을 수행합니다.

    파이프 연산자를 사용하지 않는 경우:

    filtered_data <- filter(data, age > 30)
    result <- select(filtered_data, name, age)

    파이프 연산자를 사용하는 경우:

    result <- data %>%
      filter(age > 30) %>%
      select(name, age)

    파이프를 사용한 두 번째 예에서 코드가 데이터(data)로부터 시작해서 어떤 변환(filter, select)을 거치는지 한눈에 볼 수 있습니다. 이런 식으로 파이프 연산자는 코드의 가독성을 높이고 로직을 더 명확하게 표현할 수 있게 도와줍니다.

    1) 파이프 연산자 기본적인 데이터 처리

    먼저 dplyr 패키지를 로드하고, 간단한 데이터 필터링과 선택, 그리고 정렬을 해보겠습니다.

    # dplyr 패키지 로드
    library(dplyr)
    
    # 데이터 필터링
    filtered_data <- mtcars %>%
      filter(mpg > 20)
    
    # 데이터 선택 및 정렬
    sorted_data <- mtcars %>%
      select(mpg, cyl) %>%
      arrange(desc(mpg))

    2) 파이프 연산자 복잡한 데이터 처리 시나리오

    복잡한 데이터 처리도 파이프 연산자를 통해 간결하게 표현할 수 있습니다.

    아래의 예시는 mtcars 데이터를 필터링, 그룹핑, 요약, 정렬하는 과정을 한 번에 표현한 것입니다.

    result <- mtcars %>%
      filter(mpg > 20) %>%
      group_by(cyl) %>%
      summarise(avg_mpg = mean(mpg)) %>%
      arrange(desc(avg_mpg))

    4. 마치며

    파이프 연산자 %>%는 R 프로그래밍에서 데이터를 효과적으로 처리할 수 있는 강력한 도구입니다. 코드의 가독성을 높이고, 유지보수성을 향상시키며, 데이터 처리의 로직을 명확하게 표현할 수 있습니다.

    그래서, R에서 데이터 분석이나 데이터 사이언스 작업을 수행할 때 이 연산자의 활용은 거의 필수적이입니다. %>% 연산자를 통해 더 효율적인 데이터 분석 경험을 가져보세요.

    R 프로그램을 다운로드하려면 R 프로그램 공식 웹사이트(https://www.r-project.org/)에서 다운로드 링크를 클릭하여 다운로드할 수 있습니다.
    R 프로그램 모두보기

    함께 읽으면 좋은 글

    핵심 확인 체크리스트

    • 분석 순서를 위에서 아래로 읽을 수 있는가?
    • 중첩 함수보다 파이프 코드가 더 명확한가?
    • 각 단계의 입력과 출력 데이터가 무엇인지 확인했는가?
    • 필요 이상으로 긴 파이프 체인을 만들고 있지는 않은가?

    함께 읽으면 좋은 R통계 글

    FAQ

    R 파이프 연산자 %>%는 왜 사용하나요?

    여러 함수를 중첩해서 쓰면 코드가 안쪽부터 바깥쪽으로 읽혀 초보자가 이해하기 어렵습니다. 파이프 연산자를 쓰면 데이터 처리 순서를 위에서 아래로 읽을 수 있어 분석 흐름이 명확해집니다.

    파이프 연산자는 기본 R 함수와 어떻게 다른가요?

    기본 R 함수와 역할이 충돌하는 것은 아닙니다. 파이프는 함수 실행 결과를 다음 함수의 입력으로 넘겨주는 연결 방식이며, 기존 함수들을 더 읽기 쉬운 순서로 묶어주는 도구입니다.

    초보자가 파이프 코드를 읽을 때 가장 중요한 순서는 무엇인가요?

    가장 먼저 시작 데이터가 무엇인지 확인하고, 각 줄에서 어떤 변환이 일어나는지 차례대로 보면 됩니다. 중간 결과를 머릿속으로 추적하면 전체 분석 흐름을 이해하기 쉽습니다.

  • Nginx + Php8 설정

    Nginx + Php8 설정

    1. Nginx와 PHP 8 연결

    nginx php8 패키지를 설치했다고 웹서버에서 php파일이 적용되는 것은 아닙니다. nginx가 php8를 서비스할 수 있도록 일부 파일의 수정이 해야 합니다. 설정이 올바르지 않다면 nginx에서 php8이 제대로 작동하지 않습니다. 특히 php파일이 다운로드 되거나 phpinfo 또는 php 코드를 실행시 아무것도 나타나지 않는 문제가 생깁니다.

    지금 확인하는 부분은 nginx와 php8 설정을 통해서 웹서버에서 php가 정상적으로 작동하는데 도움을 줄 것입니다.

    1개의 파일 유무와 3개의 파일을 수정해야 합니다.

    1. /etc/nginx/nginx.conf 파일이 존재하는지
    2. /etc/nginx/fastcgi_params의 fastcig_param 확인 및 추가
    3. /etc/nginx/sites-available/default 설정에서 php script 추가 및 수정
    4. /etc/nginx/nginx.conf의 default_type

    4번째는 수정하지 않는 경우 php파일이 실행되지 않고 다운 받아지는 문제가 생깁니다.

    1) /etc/nginx/nginx.conf 확인

    앞선 설치 및 진행을 따라 했다면 nginx.conf 파일은 존재합니다. 만약 없다면 다음 내용을 복사해서 파일을 생성하면 됩니다. 아래 내용을 복사해서 파일을 만든다면 4번의 단계는 생략해도 됩니다.

    아래에서 php버전에 따라 설정된 user가 다를 수 있습니다. user는 sudo nano /etc/php/8.1/fpm/pool.d/www.conf의 user, group, listen.owner, listen.group 정보와 일치해야 합니다.

    파일을 생성합니다.

    sudo nano /etc/nginx/nginx.conf

    다음 코드를 붙여넣습니다.

    user www-data;
    worker_processes auto;
    pid /run/nginx.pid;
    include /etc/nginx/modules-enabled/*.conf;
    
    events {
            worker_connections 768;
            # multi_accept on;
    }
    
    http {
            ##
            # Basic Settings
            ##
            sendfile on;
            tcp_nopush on;
            types_hash_max_size 2048;
            # server_tokens off;
            # server_names_hash_bucket_size 64;
            # server_name_in_redirect off;
            include /etc/nginx/mime.types;
            #default_type application/octet-stream;
            default_type text/html;
            ##
            # SSL Settings
            ##
            ssl_protocols TLSv1 TLSv1.1 TLSv1.2 TLSv1.3; # Dropping SSLv3, ref: POODLE
            ssl_prefer_server_ciphers on;
    
            ##
            # Logging Settings
            ##
            access_log /var/log/nginx/access.log;
            error_log /var/log/nginx/error.log;
    
            ##
            # Gzip Settings
            ##
            gzip on;
            # gzip_vary on;
            # gzip_proxied any;
            # gzip_comp_level 6;
            # gzip_buffers 16 8k;
            # gzip_http_version 1.1;
            # gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript;
    
            ##
            # Virtual Host Configs
            ##
            include /etc/nginx/conf.d/*.conf;
            include /etc/nginx/sites-enabled/*;
    }
    
    #mail {
    #       # See sample authentication script at:
    #       # http://wiki.nginx.org/ImapAuthenticateWithApachePhpScript
    #
    #       # auth_http localhost/auth.php;
    #       # pop3_capabilities "TOP" "USER";
    #       # imap_capabilities "IMAP4rev1" "UIDPLUS";
    #
    #       server {
    #               listen     localhost:110;
    #               protocol   pop3;
    #               proxy      on;
    #       }
    #
    #       server {
    #               listen     localhost:143;
    #               protocol   imap;
    #               proxy      on;
    #       }
    #}
    

    2) /etc/nginx/fastcgi_params의 fastcig_param 확인 및 추가

    편집기로 /etc/nginx/fastcgi_param을 열고 다음 내용이 없으면 추가합니다.

    sudo nano /etc/nginx/fastcgi_params

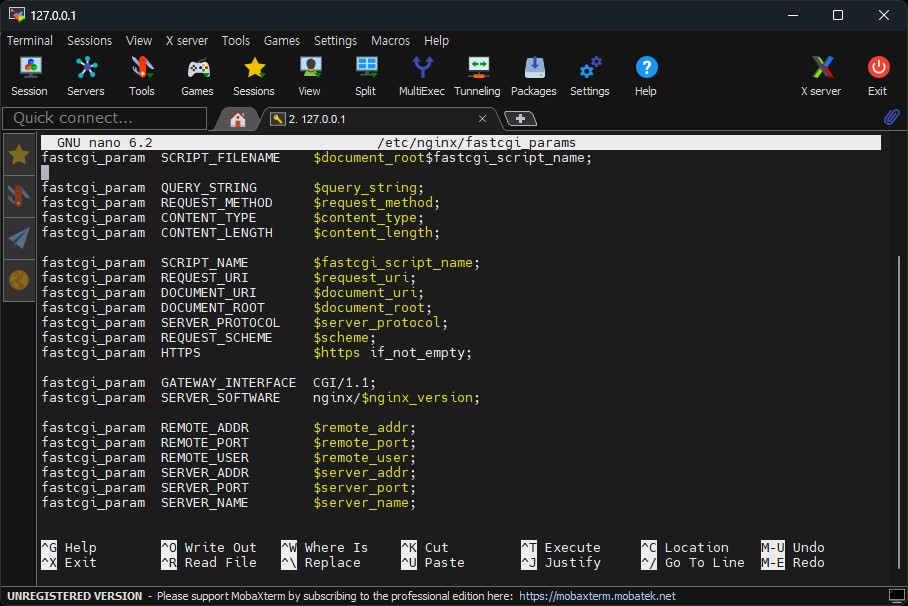
    첫 번째 줄에 다음 코드를 추가합니다.

    fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name;
    [Step 8] fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name; 추가

    Read in English

    3) /etc/nginx/sites-available/default 설정에서 php script 추가 및 수정

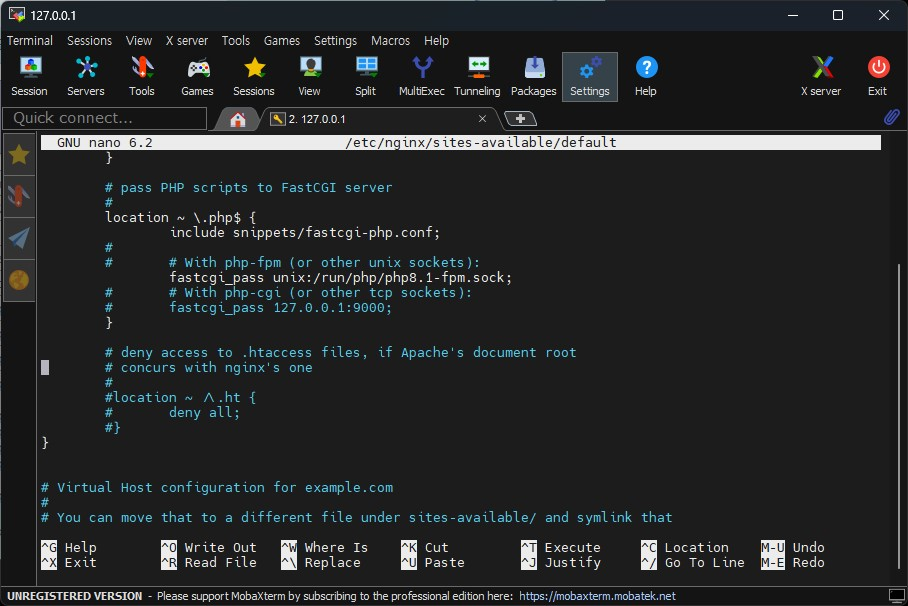
    default 파일을 편집기로 실행하고 location 부분을 다음과 같이 수정합니다. 여기서는 8.1버전을 기준으로 수정합니다. 기존 파일에서 다음 부분을 찾아 변경하면 됩니다.

    # pass PHP scripts to FastCGI server
    
    location ~ \.php$ {
           include snippets/fastcgi-php.conf;
    
           # With php-fpm (or other unix sockets):
           fastcgi_pass unix:/run/php/php8.1-fpm.sock;
    }
    [Step 9] pass PHP scripts to FastCGI server 추가

    Nginx와 php를 모두 재시작 합니다.

    sudo systemctl restart nginx
    sudo systemctl restart php8.1-fpm

    4. PHP 8 실행 및 확인

    php정보를 확인할 파일을 생성합니다. 파일은 web root 에 생성합니다.

    sudo nano /var/www/html/info.php

    php 코드 규칙에 따라 다음 내용을 복사해서 붙여 넣습니다.

    <?php
    phpinfo();
    ?>

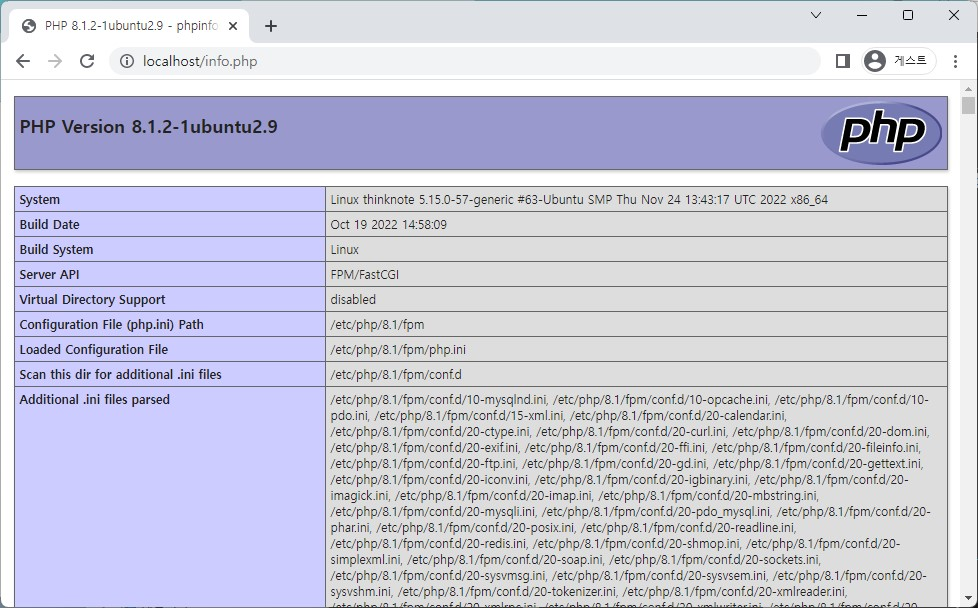
    웹사이트에서 localhost/info.php 또는 주소/info.php로 php 정보를 확인합니다.

    [Step 10] php info 확인

    이 글은 nginx 설치 이후 PHP8 셋팅에 있는 내용 중 문제해결에 대한 부분만 별도로 골라내서 작성된 글로 이전 글과 중복되어 있습니다. nginx 설치에 대해서 자세히 알고 싶다면 다음 링크를 클릭하세요

    Nginx 웹서버 설치(ubuntu) – Thinknote

    ubuntu의 nginx가 설치된 상태에서 php8을 설치하고자 한다면 다음 링크를 클릭하세요. php설치는 wordpress를 설치하기 위한 준비 단계로 진행됩니다.

    PHP 8 설치(ubuntu) – Thinknote

    함께 읽으면 좋은 글

  • PHP 8 설치(ubuntu)

    PHP 8 설치(ubuntu)

    1. PHP 이해 및 특징

    1) PHP 이해

    PHP 8 설치는 Nginx 웹서버와 연동하여 WordPress를 사용하기 위한 목적입니다. 향후 PHP를 활용하여 데이터를 일부 조작하고 PHP 코드를 삽입하는 방법에 대해서도 다루겠지만 그보다는 PHP로 개발된 WordPress를 운영하기 위한 목적에서 설명합니다.

    PHP는 Hypertext Preprocessor의 약자로 동적 웹페이지를 구현하기 위해 설계되었습니다.  PHP로 작성된 코드를 PHP 엔진에서 html 파일과 같이 처리하여 원하는 웹 페이지를 만들수 있습니다. php는 8.x 버전으로 넘어가고 있으며 7.0이후에는 PHP 코드와 HTML을 별도 파일로 분리하여 작성하며 웹서버가 아닌 php-fpm(PHP FastCGI Process Manager)을 통해 실행하는 경우가 늘어나고 있습니다.

     서버 측 오픈 소스 소프트웨어는 PHP로 구현된 경우가 많습니다. PHP에 기반한 대표적인 프로그램으로 워드프레스, 미디어위키, 넥스트클라우드 등이 있습니다. PHP는 텍스트와 HTML의 처리에 강점을 가지고 있어 URL의 파싱이나 폼 처리, 정규 표현식 등을 다양하게 적용할 수 있고 다양한 데이터베이스를 지원합니다.

    자바, 파이썬 등 다양한 프로그래밍 언어가 널리 활용되고 있지만 오픈소스의 영향력에 기반하여 지속적인 개발이 진행되고 있습니다.

    2) PHP 특징

    php는 단순, 능률, 안전, 유연성, 친숙함의 4가지 특징을 갖고 있습니다.

    • PHP는 시스템 기능, 즉 시스템의 파일에서 생성, 열기, 읽기, 쓰기 및 닫을 수 있습니다.
    • PHP는 양식, 즉 파일에서 데이터를 수집하고, 파일에 데이터를 저장하고, 이메일을 통해 데이터를 보내고, 사용자에게 데이터를 반환 할 수 있습니다.
    • PHP를 통해 데이터베이스 내의 요소를 추가, 삭제, 수정합니다.
    • 쿠키 변수에 액세스하고 쿠키를 설정합니다.
    • PHP를 사용하면 사용자가 웹 사이트의 일부 페이지에 액세스하도록 제한 할 수 있습니다.
    • 데이터를 암호화 할 수 있습니다.
    3) PHP 활용

    자바나 C 언어에서 접근하려면 여러 Include 등을 통해야 했던 작업들이 내장함수로 있어서 적은 코드로도 쉽게 구현이 가능합니다. 현재의 PHP는 절차적인 형태에서 ‘객체지향(클래스- Class)’ 프로그램 작성이 가능한 상태로 진화되었습니다.

    • PHP는 동적 페이지 콘텐츠를 생성 할 수 있습니다.
    • PHP는 서버에서 파일을 만들고, 열고, 읽고, 쓰고, 삭제하고, 닫을 수 있습니다.
    • PHP는 양식 데이터를 수집 할 수 있습니다.
    • PHP는 쿠키를 보내고받을 수 있습니다.
    • PHP는 데이터베이스의 데이터를 추가, 삭제, 수정할 수 있습니다.
    • PHP를 사용하여 사용자 액세스를 제어 할 수 있습니다.
    • PHP는 데이터를 암호화 할 수 있습니다

    2. PHP 8 설치

    1) PHP 8 사전 준비

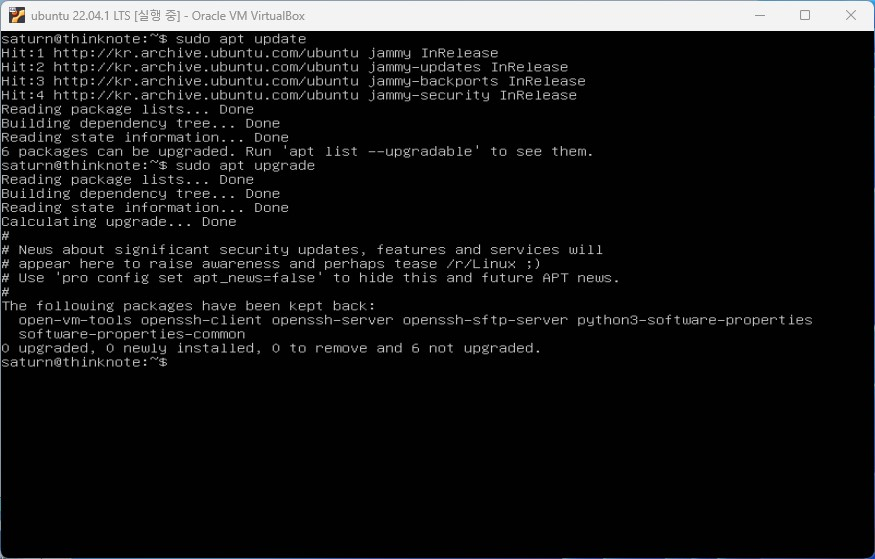
    ubuntu의 패키지를 업데이트 및 업그레이드를 진행합니다.

    sudo apt update
    sudo apt upgrade
    php 8
    [Step 1] 패키지 업데이트

    Read in English

    2) PHP 8 패키지 확인 및 설치

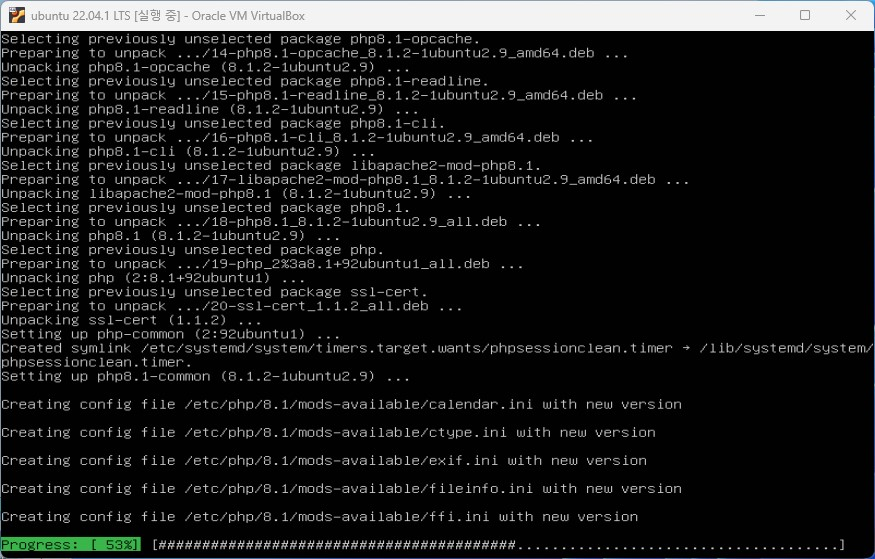
    apt list 명령으로 php와 관련된 항목을 확인할 수 있습니다. 하지만 php관련 패키지가 너무 많기 때문에 무엇을 설치해야 할지 망설여집니다. 특히 php 버전도 다양하기 때문에 기존 프로그램의 개발 환경에 그래서 특정 버전이 필요할 수도 있습니다.

    php 설치의 core는 php-fpm입니다. php 버전에 그래서는 php7.x-fpm, php8.x-fpm 등 버전별로 존재합니다. 특정 버전을 설치하는 방법은 다른 글에서 다루도록 하겠습니다.

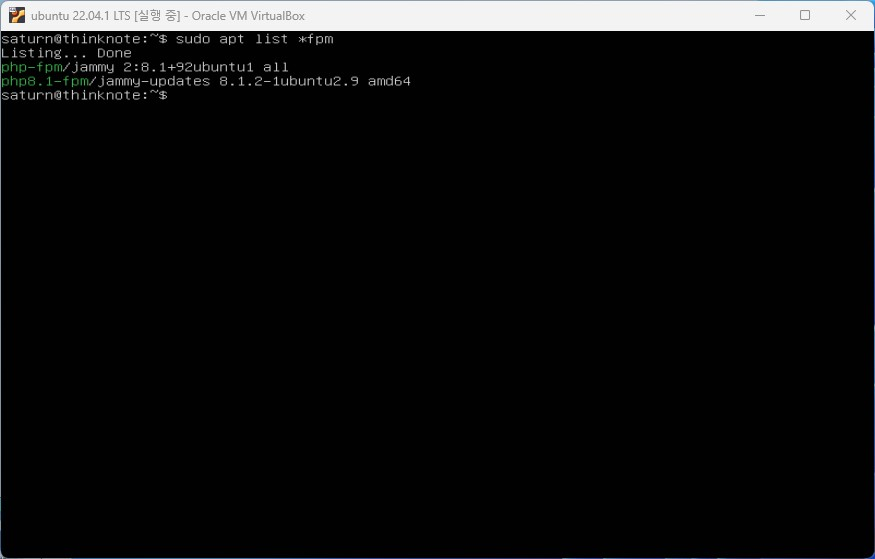
    apt list *fpm으로 php 8 설치의 핵심 패키지를 확인합니다. 여기서는  php-fpm은 8.1버전이고 php-fpm은 8.1.2 버전으로 나옵니다. 최신 버전이 좋을 수도 있지만 호환성에서 문제가 발생될 수 있기 때문에 가장 최신 버전은 피하는 것도 방법입니다.

    sudo apt list *fpm
    php 8
    [Step 2] 패키지 확인

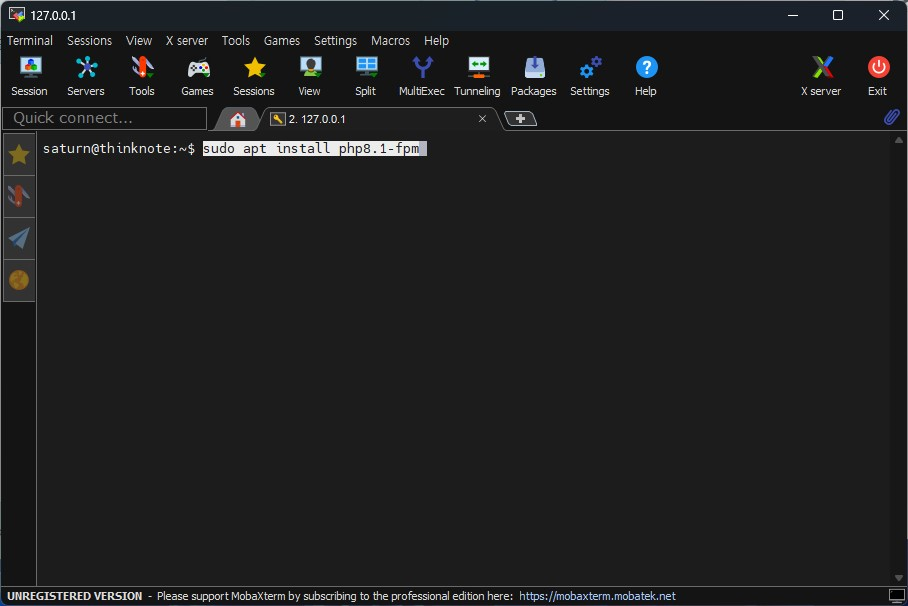
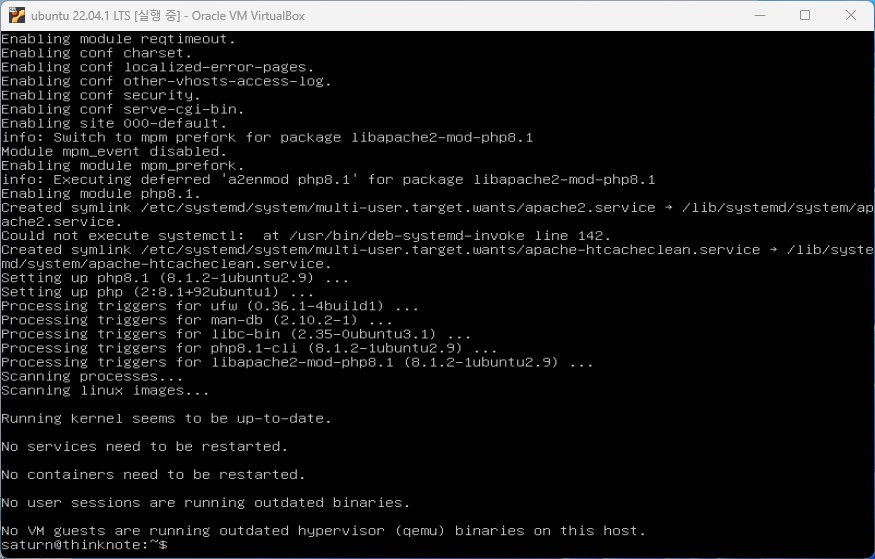
    여기서는 php을 설치합니다.

    sudo apt install php8.1-fpm
    php 8
    [Step 3] php-fpm 설치
    php 8
    [Step 4] php-fpm 설치
    php 8
    [Step 5] php-fpm 설치

    3) PHP 8 상태 확인

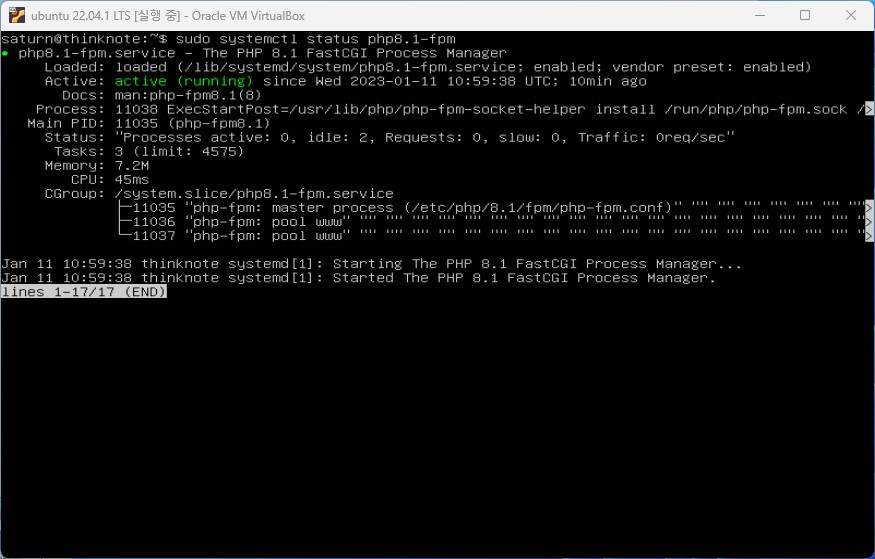
    설치가 완료되고 잘 작동되고 있는지 확인하기 위해서 sudo systemctl status php8.1-fpm 명령어를 실행합니다. 앞서 특정 버전을 설치했다면 php뒤에 버전을 함께 작성해서 확인하면 됩니다.

    sudo systemctl status php8.1-fpm
    php 8
    [Step 6] php 서비스 확인

    서비스가 정상적으로 실행되고 있습니다. 출력된 내용을 보면 서비스는 php8.1-fpm.service로 작동되며 conf 파일은 /etc/php/8.1/fpm/php-fpm.conf 파일입니다.

    4) WordPress를 위한 php 8 패키지 추가 설치

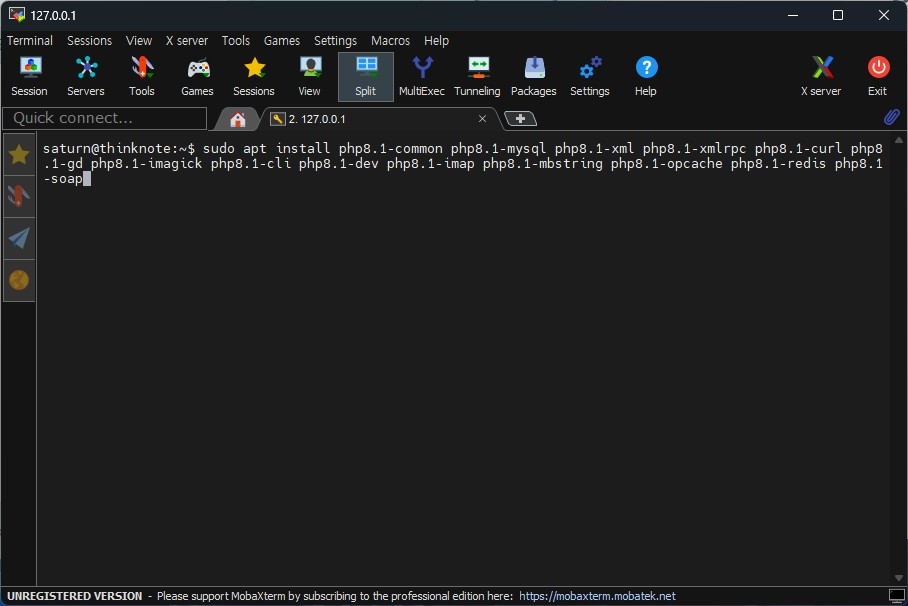
    패키지 중에는 지금 당장 필요하지 않은 패키지도 있습니다. 하지만 미리 설치해도 큰 상관이 없기 때문에 기본적인 패키지는 모두 설치합니다.

    sudo apt install php8.1-common php8.1-mysql php8.1-xml php8.1-xmlrpc php8.1-curl php8.1-gd php8.1-imagick php8.1-cli php8.1-dev php8.1-imap php8.1-mbstring php8.1-opcache php8.1-redis php8.1-soap php8.1-zip
    php 8
    [Step 7] php 추가 패키지 설치

    3. Nginx와 PHP 8 연결

    php 패키지를 설치했다고 웹서버에서 php파일이 적용되는 것은 아닙니다. nginx가 php를 서비스할 수 있도록 일부 파일의 수정이 해야 합니다.

    1개의 파일 유무와 3개의 파일을 수정해야 합니다.

    1. /etc/nginx/nginx.conf 파일이 존재하는지
    2. /etc/nginx/fastcgi_params의 fastcig_param 확인 및 추가
    3. /etc/nginx/sites-available/default 설정에서 php script 추가 및 수정
    4. /etc/nginx/nginx.conf의 default_type

    4번째는 수정하지 않는 경우 php파일이 실행되지 않고 다운 받아지는 문제가 생깁니다.

    1) /etc/nginx/nginx.conf 확인

    앞선 설치 및 진행을 따라 했다면 nginx.conf 파일은 존재합니다. 만약 없다면 다음 내용을 복사해서 파일을 생성하면 됩니다. 아래 내용을 복사해서 파일을 만든다면 4번의 단계는 생략해도 됩니다.

    파일을 생성합니다.

    sudo nano /etc/nginx/nginx.conf

    다음 코드를 붙여넣습니다.

    user www-data;
    worker_processes auto;
    pid /run/nginx.pid;
    include /etc/nginx/modules-enabled/*.conf;
    
    events {
            worker_connections 768;
            # multi_accept on;
    }
    
    http {
            ##
            # Basic Settings
            ##
            sendfile on;
            tcp_nopush on;
            types_hash_max_size 2048;
            # server_tokens off;
            # server_names_hash_bucket_size 64;
            # server_name_in_redirect off;
            include /etc/nginx/mime.types;
            #default_type application/octet-stream;
            default_type text/html;
            ##
            # SSL Settings
            ##
            ssl_protocols TLSv1 TLSv1.1 TLSv1.2 TLSv1.3; # Dropping SSLv3, ref: POODLE
            ssl_prefer_server_ciphers on;
    
            ##
            # Logging Settings
            ##
            access_log /var/log/nginx/access.log;
            error_log /var/log/nginx/error.log;
    
            ##
            # Gzip Settings
            ##
            gzip on;
            # gzip_vary on;
            # gzip_proxied any;
            # gzip_comp_level 6;
            # gzip_buffers 16 8k;
            # gzip_http_version 1.1;
            # gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript;
    
            ##
            # Virtual Host Configs
            ##
            include /etc/nginx/conf.d/*.conf;
            include /etc/nginx/sites-enabled/*;
    }
    
    #mail {
    #       # See sample authentication script at:
    #       # http://wiki.nginx.org/ImapAuthenticateWithApachePhpScript
    #
    #       # auth_http localhost/auth.php;
    #       # pop3_capabilities "TOP" "USER";
    #       # imap_capabilities "IMAP4rev1" "UIDPLUS";
    #
    #       server {
    #               listen     localhost:110;
    #               protocol   pop3;
    #               proxy      on;
    #       }
    #
    #       server {
    #               listen     localhost:143;
    #               protocol   imap;
    #               proxy      on;
    #       }
    #}
    

    2) /etc/nginx/fastcgi_params의 fastcig_param 확인 및 추가

    편집기로 /etc/nginx/fastcgi_param을 열고 다음 내용이 없으면 추가합니다.

    sudo nano /etc/nginx/fastcgi_params

    첫 번째 줄에 다음 코드를 추가합니다.

    fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name;
    [Step 8] fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name; 추가

    3) /etc/nginx/sites-available/default 설정에서 php script 추가 및 수정

    default 파일을 편집기로 실행하고 location 부분을 다음과 같이 수정합니다. 여기서는 8.1버전을 기준으로 수정합니다. 기존 파일에서 다음 부분을 찾아 변경하면 됩니다.

    # pass PHP scripts to FastCGI server
    
    location ~ \.php$ {
           include snippets/fastcgi-php.conf;
    
           # With php-fpm (or other unix sockets):
           fastcgi_pass unix:/run/php/php8.1-fpm.sock;
    }
    [Step 9] pass PHP scripts to FastCGI server 추가

    Nginx와 php를 모두 재시작 합니다.

    sudo systemctl restart nginx
    sudo systemctl restart php8.1-fpm

    4. PHP 8 실행 및 확인

    php정보를 확인할 파일을 생성합니다. 파일은 web root 에 생성합니다.

    sudo nano /var/www/html/info.php

    php 코드 규칙에 따라 다음 내용을 복사해서 붙여 넣습니다.

    <?php
    phpinfo();
    ?>

    웹사이트에서 localhost/info.php 또는 주소/info.php로 php 정보를 확인합니다.

    [Step 10] php info 확인

    참고로 워드프레스를 설치하기 위해서는 php.ini 파일의 수정이 해야 합니다. php 파일 실행 및 php.ini 파일 수정은 wordpress 설치 글에서 다루도록 하겠습니다.

    함께 읽으면 좋은 글

  • Nginx 웹서버 설치(ubuntu)

    Nginx 웹서버 설치(ubuntu)

    1. Nginx 웹서버 Vs Apache 웹서버

    여기서는 Nginx 웹서버 설치를 진행합니다. 리눅스에서 설치되는 웹 서버는 Nginx 웹서버와 apache 웹서버로 나눠지며 다음과 같은 차이점을 갖고 있습니다. 아파치는 오픈 소스 HTTP 서버인 반면 Nginx는 오픈 소스, 고성능 비동기 웹 서버 및 역방향 프록시 서버입니다.

    아파치 HTTP 서버의 개발 및 발전은 전 세계 사용자 커뮤니티(Apache Software Foundation)에서 관리 및 유지되지만 Nginx는 2011년에 설립된 동일한 이름의 회사에서 유지 및 관리 됩니다.

    Apache는 클라이언트 요청 및 웹 트래픽을 처리하는 다양한 다중 처리 모듈을 제공하지만 Nginx는 최소한의 하드웨어 리소스로 여러 클라이언트 요청을 동시에 처리하도록 설계되었습니다.

    아파치에서 단일 스레드는 하나의 연결과 연결되지만 Nginx의 단일 스레드는 여러 연결을 처리할 수 있다. 이 프로세스는 메모리를 적게 소모하여 성능이 향상시킵니다.

    아파치 HTTP Server에는 확장성이 없는 다중 스레드 아키텍처지만 Nginx는 여러 클라이언트 요청을 처리하기 위한 비동기 이벤트 기반 접근 방식을 따릅니다.

    아파치 서버는 기존의 메서드를 사용하여 정적 콘텐츠를 제공하고 웹 서버 자체 내에서 기본적으로 동적 콘텐츠를 처리한다. 반면 Nginx는 동적 콘텐츠를 내부적으로 처리할 수 없고 위해 외부 프로세스에 의존합니다.

    2. Nginx 웹서버 설치

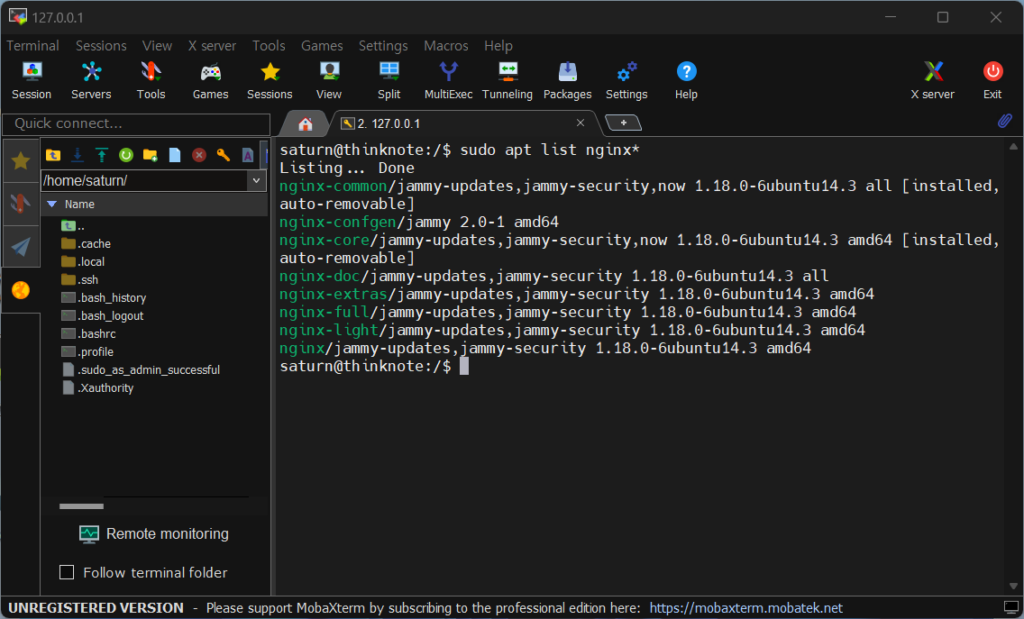
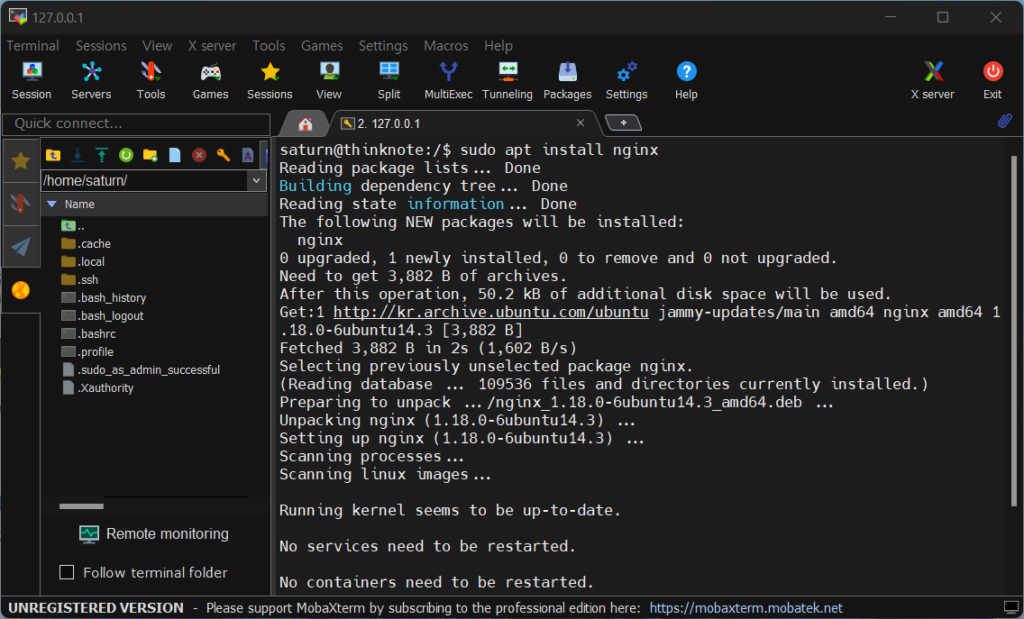
    apt update와 apt upgrade로 패키지 정보를 업데이트 합니다. list 옵션으로 nginx와 관련된 패키지를 확인합니다. nginx 설치 명령어로 nginx 웹서버를 설치합니다.

    • nginx 관련 패키지 정보를 출력하는 명령어입니다.
    sudo apt list nginx*
    nginx ubuntu
    [Step 1] 패키지 정보 확인

    Read in English

    • nginx 설치를 위한 명령어를 실행합니다.
    sudo apt install nginx
    nginx ubuntu
    [Step 2] nginx install
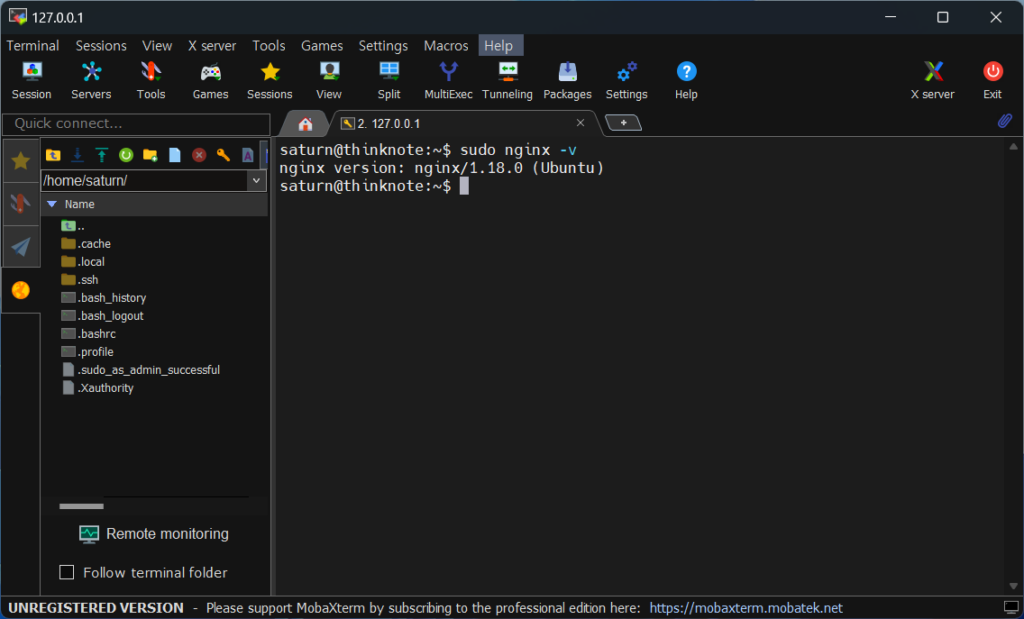
    • 설치된 nginx의 버전을 확인합니다.
    sudo nginx -v
    nginx ubuntu
    [Step 3] nginx 버전 확인
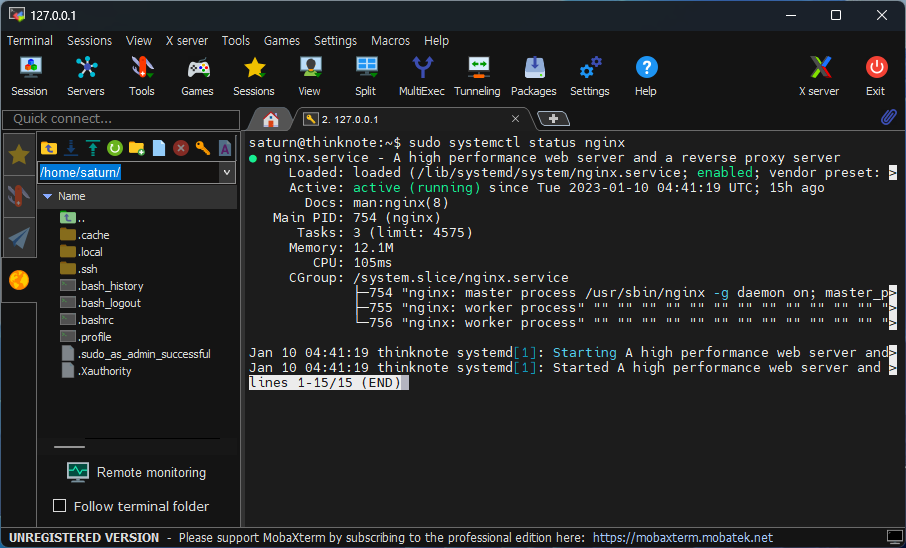
    • nginx 서비스의 상태를 확인합니다.
    sudo systemctl status nginx
    nginx ubuntu
    [Step 4] 패키지 정보 확인

    2. 외부 접속을 위한 포트 설정

    웹서버가 설치되었다고 바로 접속이 가능한 것은 아닙니다. ubuntu가 설치된 환경은 호스트 컴퓨터의 가상 서버로 구성되어 있고 ubuntu 서버는 iptables로 방화벽이 서비스되고 있습니다.

    첫 번째 단계는 ubuntu 서버의 포트를 개방하는 것입니다. iptables에 대한 이해가 필요하다면 다음 글을 통해서 확인할 수 있습니다.

    1) nginx http 포트 허용

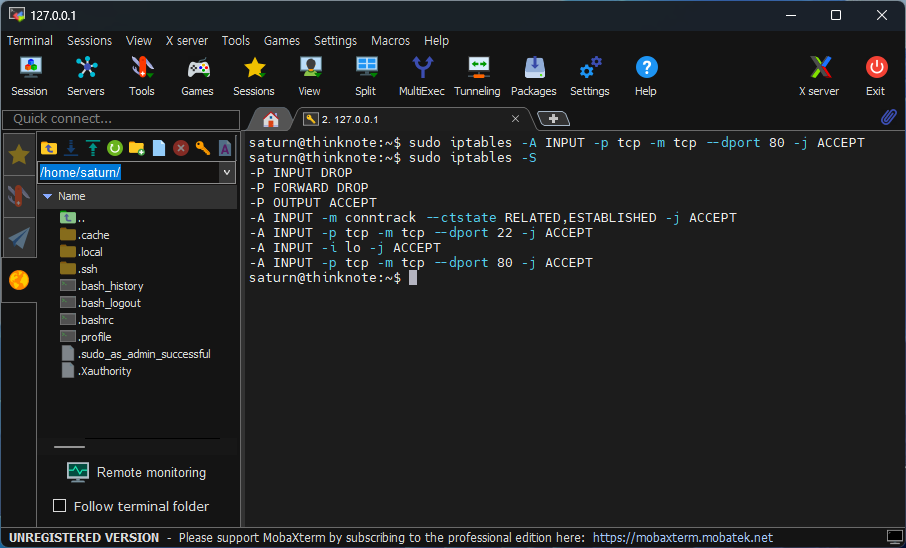
    http 포트는 80을 사용합니다. iptables에서 tcp 80번 포트를 사용하도록 열어주고 iptables에 체인이 등록되었는지 규칙을 출력합니다.

    • -A : 체인에 추가
    • -p tcp : 프로토콜 tcp
    • -m tcp : tcp 일치, 확장일치
    • –dport : 포트번호
    • — j : 대상 점프
    • ACCEPT : 허용
    sudo iptables -A INPUT -p tcp -m tcp --dport 80 -j ACCEPT
    sudo iptables -S
    iptables
    [Step 1] iptables에 80번 포트 추가

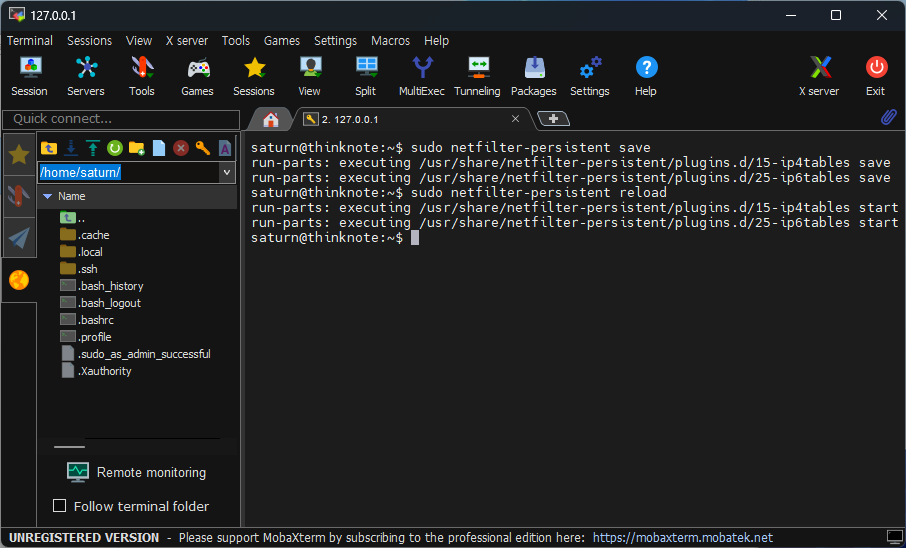
    추가된 규칙을 저장하고 Reload 합니다.

    sudo netfilter-persistent save
    sudo netfilter-persistent reload
    iptables
    [Step 2] iptables 저장 및 reload

    2) VirtualBox 포트 추가

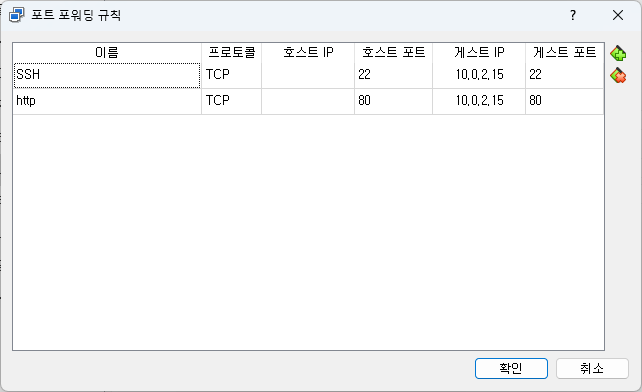
    VirtualBox에 포트를 추가해야 호스트 컴퓨터의 IP 또는 localhost(127.0.0.1)에서 접속이 가능합니다. 그리고 공유기를 사용하고 있다면 공유기의 DMZ기능이나 공유기 포트 포워딩 기능을 사용하면 외부에서도 접속이 가능합니다. 여기서는 공유기의 DMZ 설정에 대해서는 다루지 않습니다.

    VirtualBox의 상세한 절차를 알고 싶다면 아래 링크를 클릭해서 확인할 수 있습니다.

    아래 이미지와 같이 80번 포트에 대한 포워딩을 추가합니다.

    virtualbox 80 port
    [Step 3] VirtualBox 80번 포트 포워딩

    3. Nginx 웹서버 접속 확인

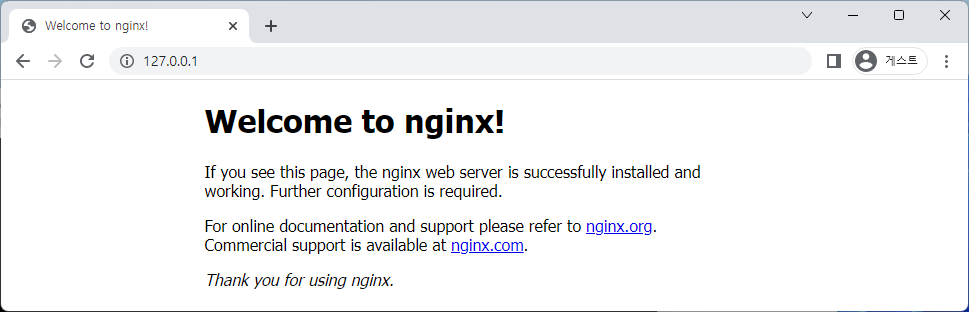
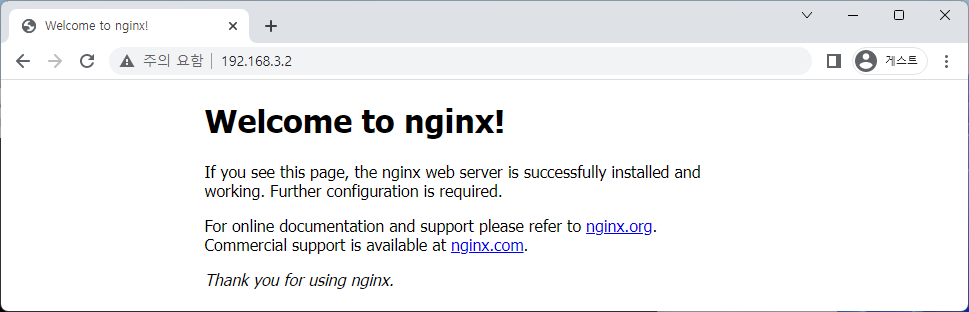
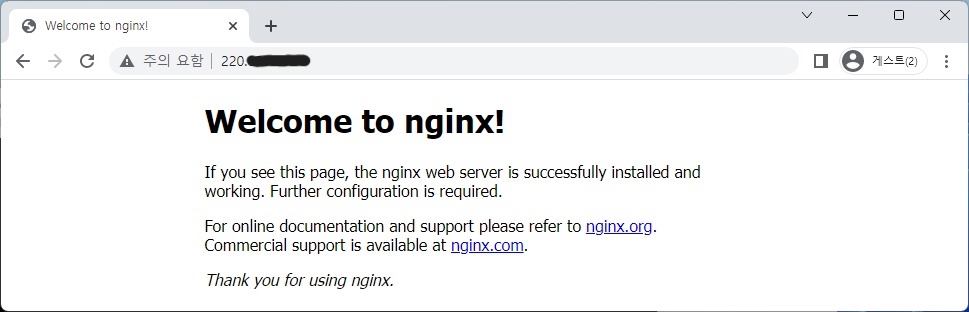
    포트 개방이 완료되고 호스트 컴퓨터의 인터넷 브라우저를 통해 ubuntu 서버의 nginx 웹서버에 접속합니다.

    • localhost 접속(127.0.0.1)
    nginx
    [Step 1] 127.0.0.1
    nginx
    [Step 2] http://localhost
    • 호스트 컴퓨터의 내부 IP로 접속
    nginx
    [Step 2] http://localhost
    • 외부IP로 접속
    nginx
    [Step 2] http://220.xxx.xxx.xxx

    함께 읽으면 좋은 글

  • Ubuntu SSH 포트 설정 및 연결

    Ubuntu SSH 포트 설정 및 연결

    1. Ubuntu SSH 포트 개방

    SSH 포트 개방을 위해서는 2가지 작업을 진행해야 합니다. 첫 번째는 ubuntu iptables에 22번 포트를 개방해야 하고 두 번째는 virtualbox의 포트를 포워드 해야 합니다. 만약 외부 ip를 사용해서 ubuntu를 설치 했다면 첫 번째 작업만 해도 무방합니다.
    만약 호스트 PC가 공유기에 물려 있다면 DMZ 설정 및 포트 포워드로 22번 포트를 호스트 PC에 연결해야 외부에서 접속이 가능합니다.

    1) 기본 환경 구성

    지금부터 시작되는 내용은 다음과 같은 환경을 가정하고 진행합니다.

    • Virtual로 ubuntu가 설치됨
    • 호스트 PC는 내부 공유기로부터 IP를 할당
    • Virtual IP: 10.0.2.15

    2) Iptables SSH 포트 허용

    SSH 포트는 22을 사용합니다. Iptables에서 tcp 22번 포트를 사용하도록 열어줍니다.

    • -A : 체인에 추가
    • -p tcp : 프로토콜 tcp
    • -m tcp : tcp 일치, 확장일치
    • –dport : 포트번호
    • — j : 대상 점프
    • ACCEPT : 허용
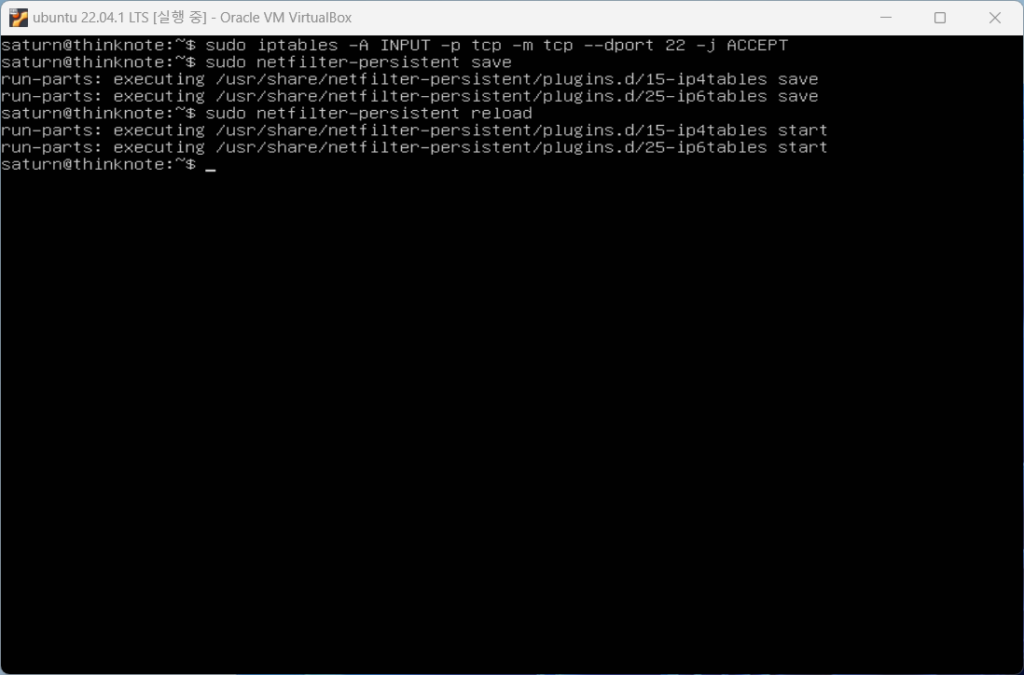
    sudo iptables -A INPUT -p tcp -m tcp --dport 22 -j ACCEPT

    iptables에 체인이 등록되었는지 규칙을 출력합니다. 추가된 규칙을 저장하고 Reload 합니다.

    sudo iptables -S
    sudo netfilter-persistent save
    sudo netfilter-persistent reload
    [Step 1] ubuntu ssh 포트 추가

    Read in English

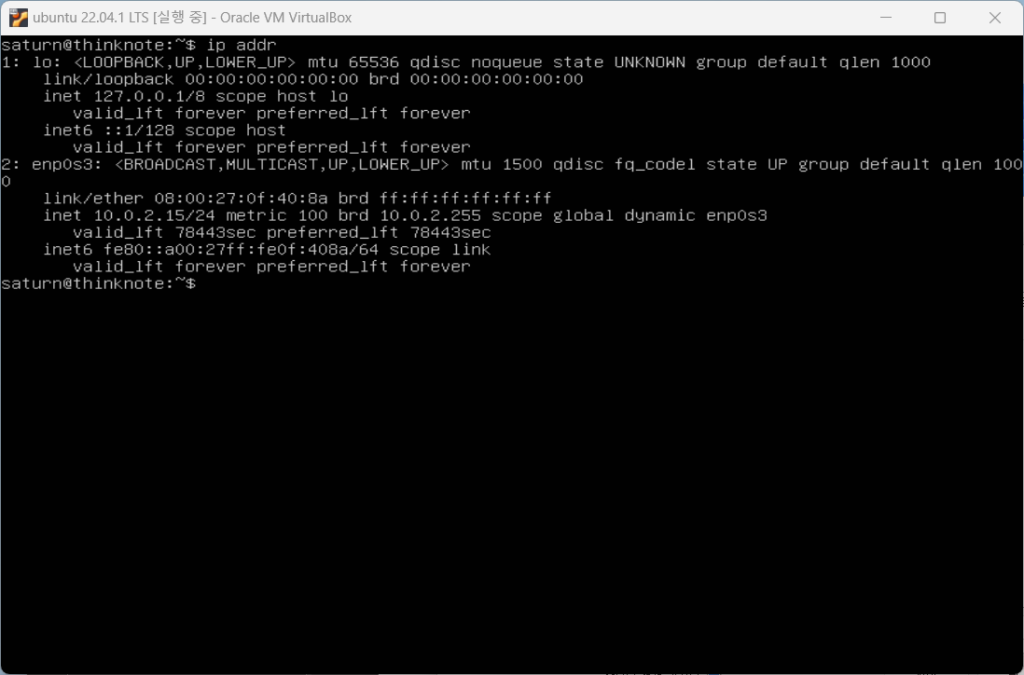
    ubuntu의 IP를 확인하겠습니다. ip addr명령으로 IP를 확인하면 다음과 같이 출력되며 ubuntu의 IP가 10.0.2.15인 것으로 확인됩니다.

    ip addr
    [Step 2] ubuntu ip 확인

    2. VirtualBox의 SSH 포트 포워딩

    ubuntu의 SSH 포트 개방으로 Ubuntu의 연결은 허용되었지만 아직 호스트 컴퓨터에서는 접속을 할 수 없습니다. 호스트 컴퓨터에서 MobaXterm으로 ubuntu에 접속하기 위해서는 VirtualBox에서 포트를 포워딩 해야 합니다.

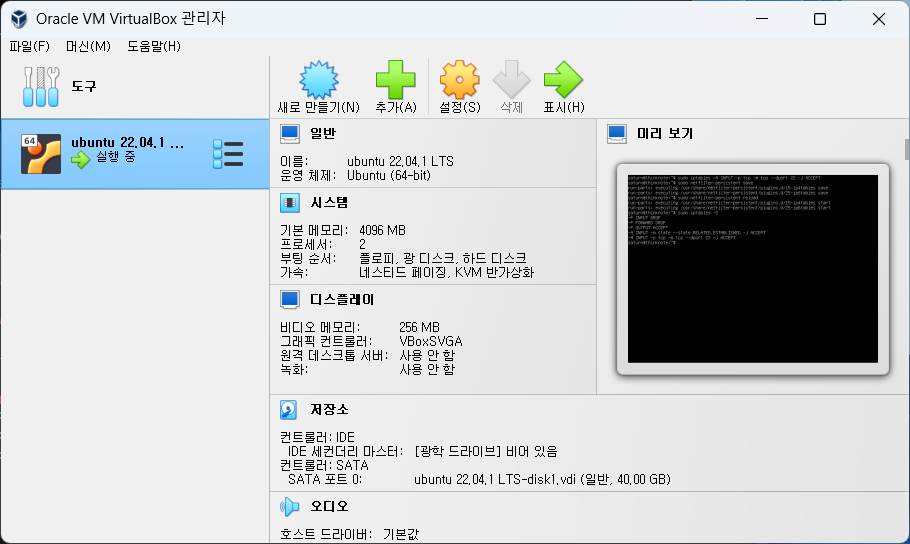
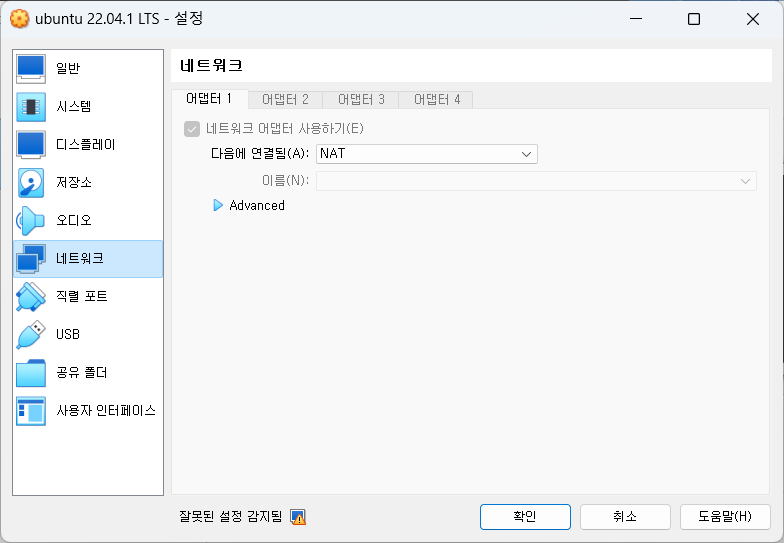
    VirtualBox에서는 가상머신을 종료하지 않고 설정에서 포트 포위딩을 할 수 있습니다. 가상PC 설정의 네트워크를 클릭합니다.

    virtualbox ssh
    [Step 1] virtualbox 관리자 실행
    virtualbox ssh
    [Step 2] virtualbox 네트워크 설정

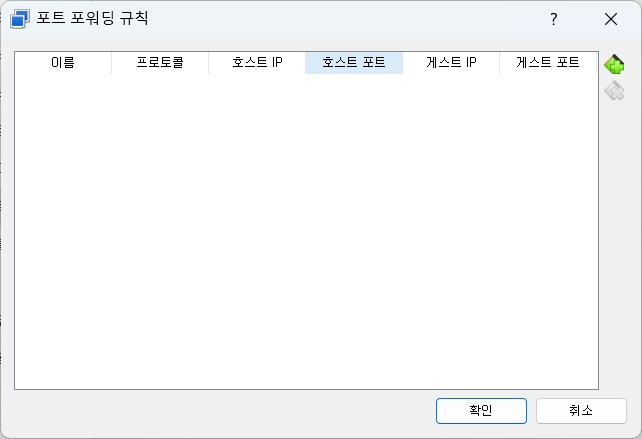
    네트워크 Advanced를 확장하여 포트 포워팅 버튼을 클릭합니다.

    virtualbox ssh
    [Step 3] virtualbox 네트워크 포트 포워딩 추가

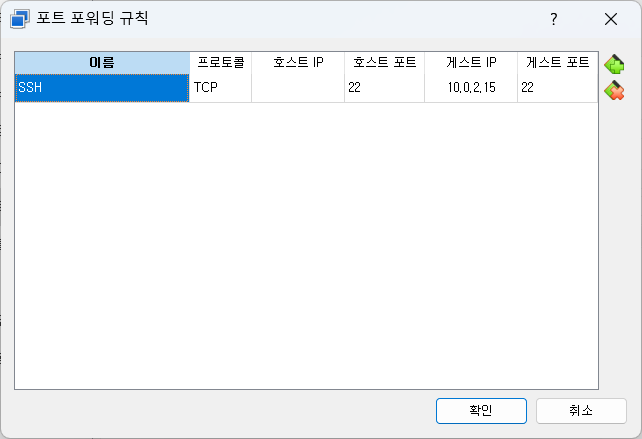
    포트 포워팅 규칙을 추가하기 위해 오른쪽 상단의 플러스 아이콘을 클릭합니다. 이름[SSH], 프로토콜[TCP], 호스트 IP(로컬호스트로 접속하기 때문에 비워두어도 됩니다.)[ ], 호스트 포트[22], 게스트 IP(ubuntu IP는 ip addr 명령으로 확인할 수 있습니다.)[10.0.2.15], 게스트 포트[22]를 입력합니다.

    virtualbox ssh
    [Step 4] virtualbox ssh 포트(22) 포워딩 설정

    3. MobaXterm으로 Ubuntu 터미널 접속

    MobaXterm을 실행합니다. 아직은 등록된 Session이 없기 때문에 새로운 Session을 등록하기 위해 왼쪽 상단의 Session을 클릭합니다.

    mobaxterm ssh
    [Step 1] MobaXterm 실행

    SSH를 사용해서 ubuntu에 접속하기 위해서 왼쪽 상단의 SSH를 클릭합니다.

    mobaxterm ssh
    [Step 2] MobaXterm ssh session

    Remnote Host는 ubuntu IP가 아닌 호스트 PC의 IP를 뜻합니다. Host IP는 cmd명령으로 호스트 PC의 터미널을 실행하고 ipconfig /all 명령으로 확인할 수 있습니다. 여기서는 localhost IP로 접속하기 때문에 127.0.0.1을 입력하겠습니다. OK 버튼을 클릭해서 창을 닫습니다.

    mobaxterm ssh
    [Step 3] MobaXterm ssh session 추가(localhost 및 host IP)

    MobaXterm의 왼쪽 user session 부분에 127.0.0.1 세션이 추가된 것을 확인할 수 있습니다. 해당 세션을 더블 클릭해서 로그인 터미널이 나타나면 포트가 정상적으로 개방된 것입니다.

    mobaxterm ssh
    [Step 3] ubuntu 접속

    함께 읽으면 좋은 글

  • Ubuntu OpenSSH 설치 및 MobaXterm 설치

    Ubuntu OpenSSH 설치 및 MobaXterm 설치

    1.  OpenSSH 개념 및 특징

    1) OpenSSH 개념

    OpenSSH의 개념을 이해하고 OpenSSH 설치 및 MobaXterm 프로그램을 사용하여 Ubuntu에 원격 접속하도록 하겠습니다. SSH 프로토콜은 telnet 및 rlogin에 비해 향상된 보안을 지원합니다. SSH 프로토콜은 SSH1 및 SSH2에서 사용이 가능합니다.

    SSH1 유형은 7.6 release부터는 지원되지 않고 있습니다. SSH2 유형은 RSA와 관련된 특허를 우회하며 CRC 데이터 무결성 문제를 해결하기 위해 발명되었습니다. 또한 SSH2 프로토콜은 대칭 및 비대칭 암호에 대한 다양한 선택 사항과 기능을 지원합니다.

    그래서 OpenSSH는 SSH 프로토콜을 사용한 원격 접속에 가장 이상적인 도구로 봐도 좋습니다. OpenSSH는 도청, 연결 하이재킹 및 기타 공격을 제어하기 위해 모든 드래픽을 암호화 합니다. 그리고 대규모 보안 터널링, 다양한 인증, 정교한 옵션 구성을 제공합니다.

    OpenSSH 제품군은 다음 도구로 구성됩니다.

    • 원격 작업은 ssh , scp 및 sftp 를 사용하여 수행됩니다 .
    • ssh-add , ssh-keysign , ssh-keyscan 및 ssh-keygen 을 사용한 키 관리 .
    • 서비스 측은 sshd , sftp-server 및 ssh-agent 로 구성 됩니다.

    2) OpenSSH 특징

    OpenSSH는 완전한 오픈 소스 프로젝트로 인터넷을 통해 누구나 무료로 사용할 수 있습니다. 코드 재사용 및 코드 검토를 통해 누구나 버그를 찾고 수정할 수 있습니다. OpenSSH는 모든 목적으로 사용할 수 있으며 여기에는 상업적 사용이 포함됩니다. 

    강력한 암호화(AES, ChaCha20, RSA, ECDSA, Ed25519…)는 인증 전에 시작되며 암호나 기타 정보는 암호화되지 않은 상태로 전송됩니다. 다양한 암호 및 키 유형을 사용할 수 있으며 레거시 옵션은 일반적으로 합리적인 시간 내에 단계적으로 제거됩니다.

    X11 전달은 원격 X Windows 트래픽의 암호화를 허용하므로 아무도 원격 xterm을 스누핑하거나 악의적인 명령을 삽입할 수 없습니다. 프로그램은 서버 시스템에서 자동으로 디스플레이를 설정하고 보안 채널을 통해 모든 X11 연결을 전달합니다. 

    포트 포워딩(레거시 프로토콜을 위한 암호화된 채널)을 사용하면 암호화된 채널을 통해 TCP/IP 연결을 원격 시스템으로 포워딩할 수 있습니다. POP와 같은 안전하지 않은 인터넷 응용 프로그램을 보호할 수 있습니다.

    강력한 인증(공개 키, 일회용 암호)은 IP 스푸핑, 가짜 경로 및 DNS 스푸핑과 같은 여러 보안 문제로부터 보호합니다. 일부 인증 방법에는 공개 키 인증, s/key를 사용한 일회용 암호 및 Kerberos를 사용한 인증(-portable에서만)이 포함됩니다.

    에이전트 포워딩은 사용자의 랩탑 또는 로컬 워크스테이션에서 실행되는 인증 에이전트를 사용하여 사용자의 인증 키를 보유할 수 있습니다. OpenSSH는 모든 연결을 통해 자동으로 연결을 인증 에이전트로 전달하며 네트워크의 모든 시스템(사용자 자신의 로컬 시스템 제외)에 인증 키를 저장할 필요가 없습니다. 

    선택적 데이터 압축은 암호화 전에 데이터를 압축하면 느린 네트워크 링크의 성능이 향상됩니다.

    2.  OpenSSH 설치 및 확인

    1) OpenSSH 설치

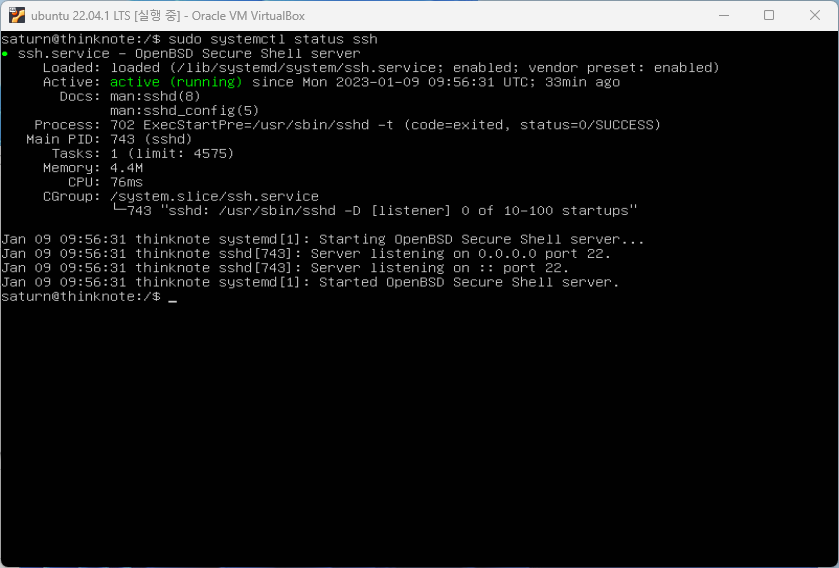
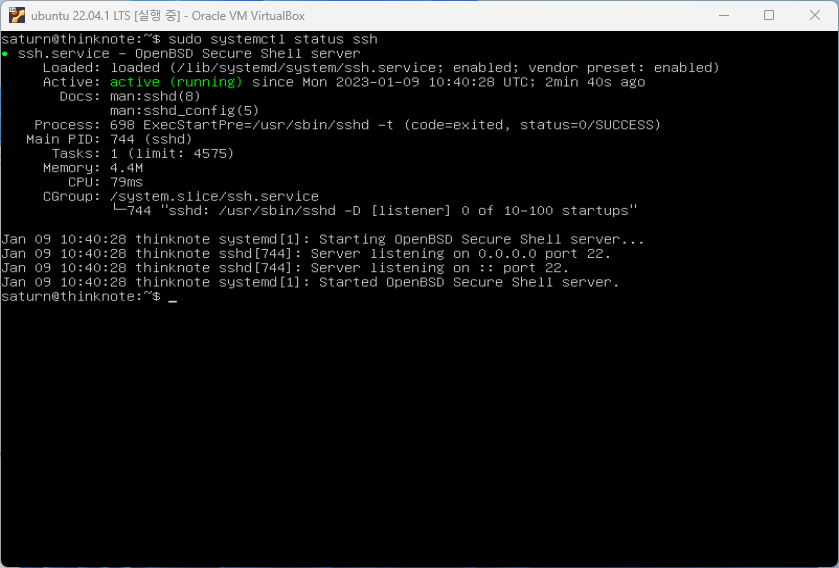
    설치부터 함께 했다면 SSH는 설치되어 있습니다. 터미털에서 현재 상태를 확인하기 위해서 systemctl 명령어로 확인합니다.

    sudo systemctl status ssh
    ssh openssh
    [Step 1] OpenSSH 상태 확인

    Read in English

    OpenSSH를 설치 했지만 서비스는 ssh.service로 작동합니다. 이미지의 Cgroup부분을 면 /system.slice/ssh.service로 나와 있습니다. 실제 설치된 패키지를 확인해 보겠습니다. apt list 명령을 활용해서 openssh와 관련해 설치된 패키지를 확인하면 3개의 패키지가(openssh-client, openssh-server, open-sftp-server) 설치되 있습니다.

    sudo apt list openssh*
    ssh openssh
    [Step 2] ssh.service enable

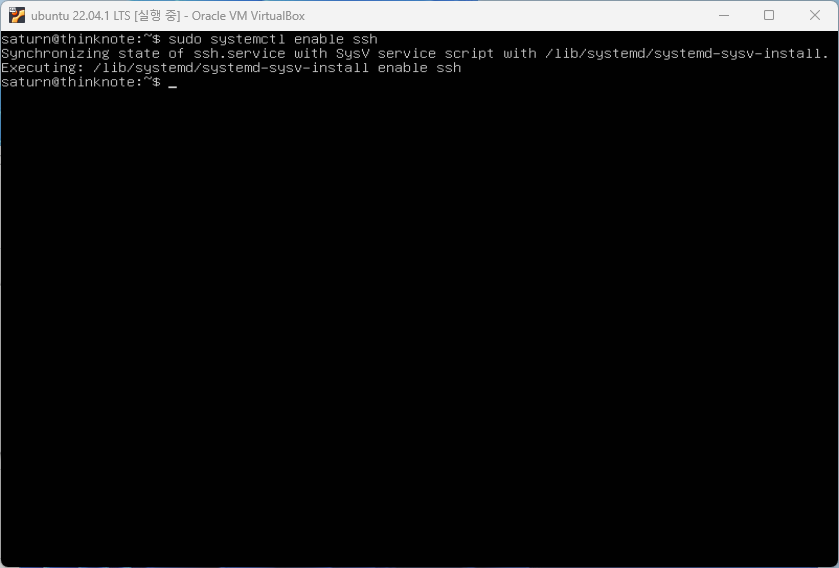
    외부에서 원격으로 접속하기 위해서는 openssh-server가 반드시 설치되어 있어야 합니다. 만약 설치가 되지 않았다면 다음 명령어로 openssh-server를 설치합니다. 그리고 부팅시 자동 실행되도록 enable 합니다.

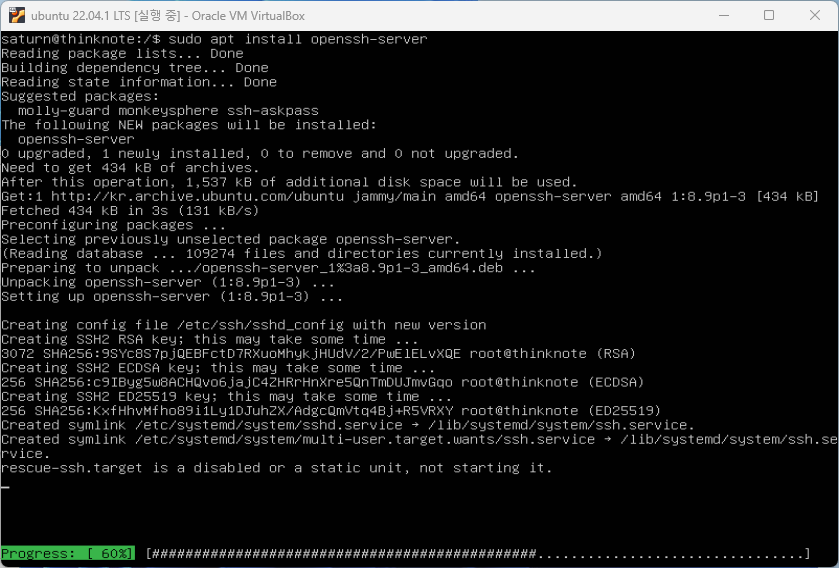
    sudo apt install openssh-server
    ssh openssh
    [Step 3] openssh 설치
    sudo systemctl enable ssh
    ssh openssh
    [Step 4] ssh.service enable

    재부팅 후 ssh가 서비스되고 있는지 확인합니다.

    reboot
    sudo systemctl status ssh
    ssh openssh
    [Step 5] OpenSSH 상태 확인

    3.  SSH 원격 접속을 위한 MobaXterm 설치

    1) MobaXterm 특징

    MobaXterm은 원격 접속 프로그램으로 Windows 응용 프로그램에서 프로그래머, 웹마스터, IT 관리자가 보다 간단한 방식으로 원격 작업을 위해 맞춤화된 많은 기능을 제공합니다.

    MobaXterm은 모든 중요한 원격 네트워크 도구 (SSH, X11, RDP, VNC, FTP, MOSH, …) 및 Unix 명령 (bash, ls, cat, sed, grep, awk, rsync, …)을 Windows 데스크탑에 제공합니다.

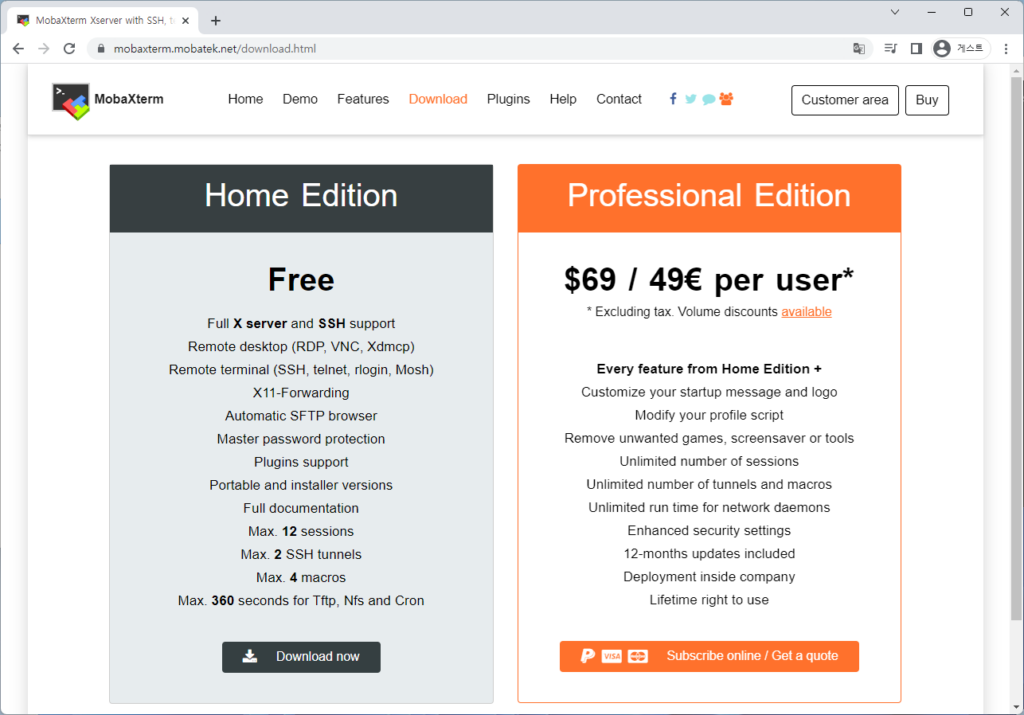
    SSH 를 사용하여 원격 서버에 연결할 때 원격 파일을 직접 편집하기 위해 그래픽 SFTP 브라우저 가 자동으로 팝업됩니다. MobaXterm Home Edition을 무료로 다운로드하여 사용할 수 있습니다. 

    2) MobaXterm 다운로드

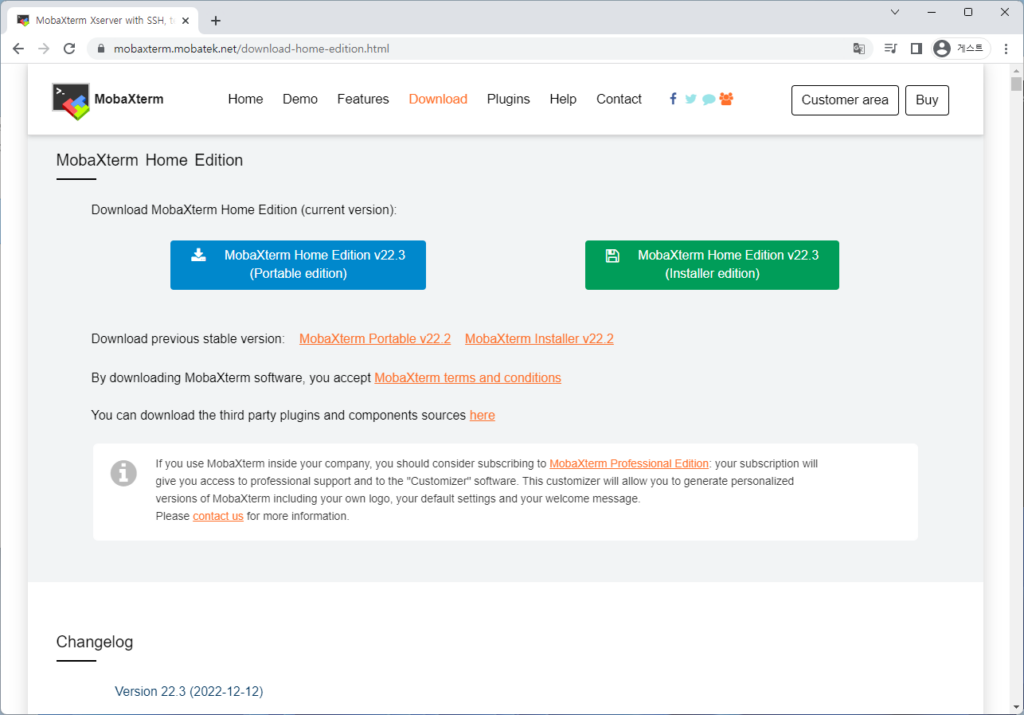
    MobaXterm 웹사이트에 접속하여 설치 파일을 다운로드 합니다.  파일은 installer edition과 portable edition으로 구분되는데 여기서는 installer edition으로 진행하겠습니다.

    웹페이지 : MobaXterm free Xserver and tabbed SSH client for Windows (mobatek.net)

    다운로드 페이지 : https://mobaxterm.mobatek.net/download-home-edition.html

    MobaXterm
    [Step 1] MobaXterm 사이트
    MobaXterm
    [Step 2] Home Edition 선택
    MobaXterm
    [Step 3] Installer edition 다운로드

    3) MobaXterm 설치

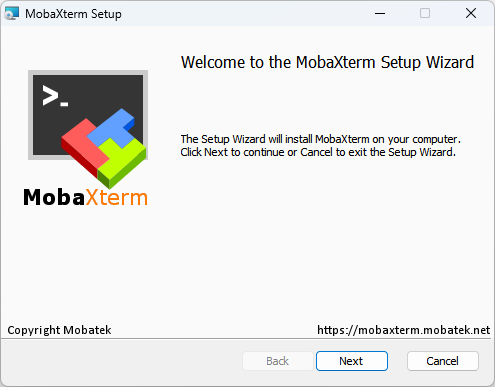
    MobaXterm 압축 파일을 해제하고 설치를 진행합니다.

    MobaXterm
    [Step 4] MobaXtrm 설치 프로그램 실행
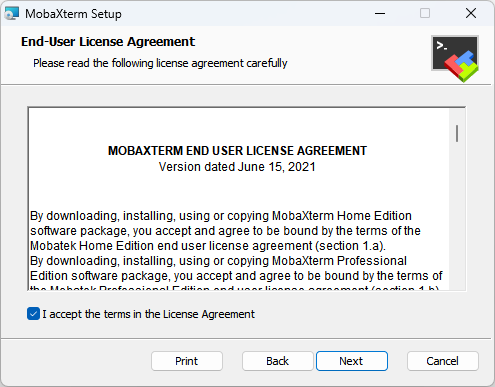
    [Step 5] 동의하고 Next 클릭
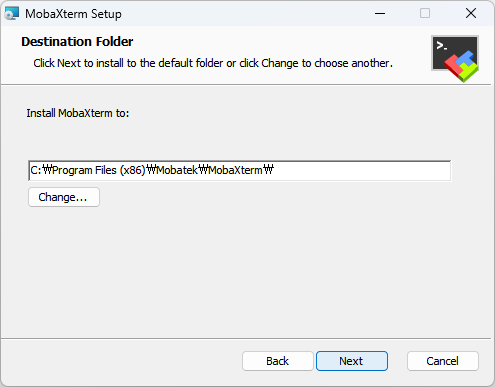
    MobaXterm
    [Step 6] 기본 폴더 선택하고 Next 클릭
    MobaXterm
    [Step 7] Install 클릭
    MobaXterm
    [Step 8] 설치 진행 중
    MobaXterm
    [Step 9] Finish 클릭하여 설치 종료

    4) MobaXterm 실행

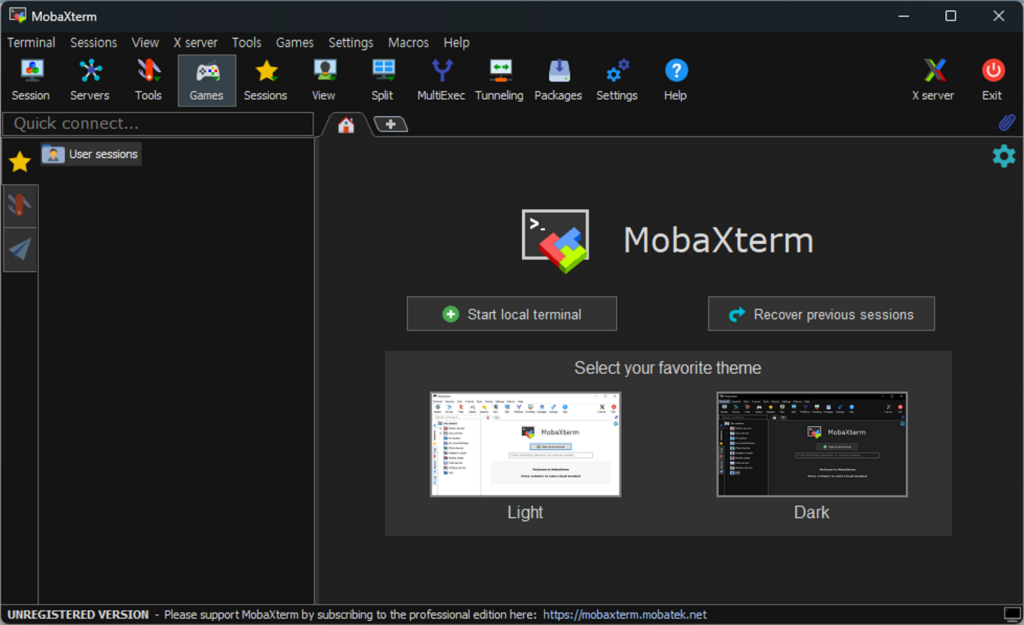
    MobaXterm 실행하면 다음과 같이 프로그램이 실행됩니다. 여기서는 창을 종료하고 접속이 가능하도록 포트 및 방화벽을 설정하도록 하겠습니다.

    MobaXterm
    [Step 10] MobaXtrm 실행 창

    함께 읽으면 좋은 글

  • Ubuntu 방화벽 iptables 설정 및 관리

    Ubuntu 방화벽 iptables 설정 및 관리

    1.  iptables 방화벽 이해 및 설치

    여기서는 Ubuntu 방화벽 iptables 설정 및 관리에 대해 이야기 합니다. 방화벽 관리의 대부분은 네트워크에 트래픽 제한을 적용할 개별 규칙 및 정책을 결정하는 것입니다. 

    Ubuntu는 기본 방화벽으로 ufw를 제공하고 있으나 iptables을 사용하면 규칙이 적용되는 구조적 프레임워크를 상세하게 관리할 수 있습니다.

    우선 ufw 방화벽 사용을 중지하고 iptables 패키지를 활용하여 방화벽을 구성하는 방법으로 진행됩니다. iptables은 합리적인 기본값을 제공하고 확장성을 장려하는 프레임워크를 설정하는 데 중점을 두고 있습니다.

    2. Iptables 설정(초기)

    방화벽은 두 가지 방법 중 하나로 구성할 수 있습니다. 기본 규칙을 설정하여 특정 규칙으로 원치 않는 트래픽을 허용한 다음 차단하거나 규칙을 사용하여 허용된 트래픽을 정의하고 다른 모든 것을 차단할 수 있습니다. 후자는 클라우드 서버에 액세스하려고 시도해서는 안 되는 연결을 반응적으로 거부하지 않고 선제적으로 트래픽을 차단할 수 있으므로 종종 권장되는 접근 방식입니다.

    1) iptables 현재 규칙 확인

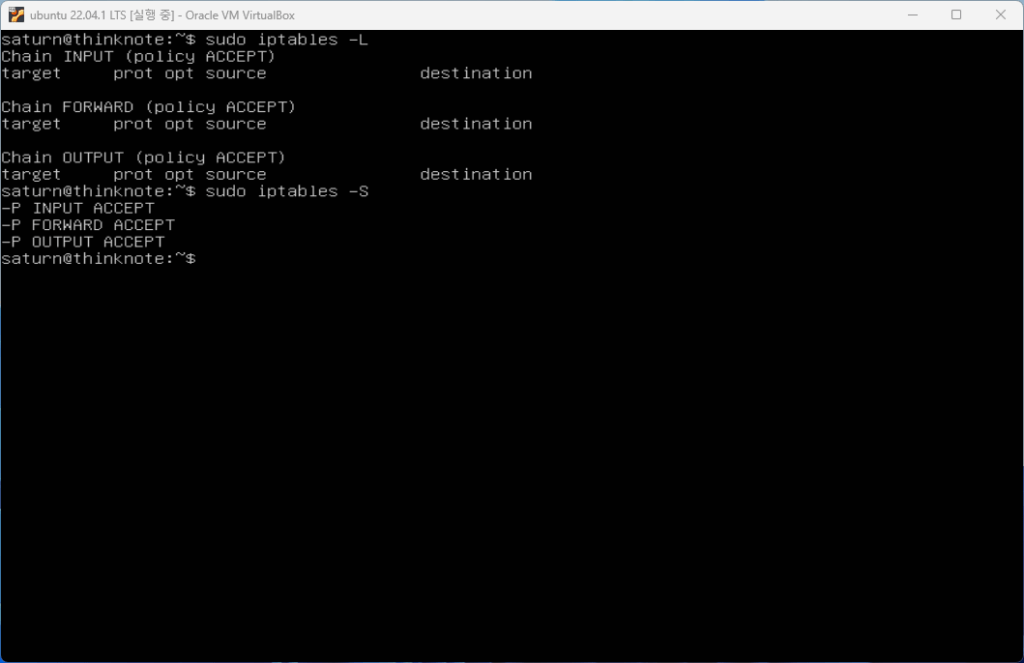
    Ubuntu 서버는 어떠한 제한도 적용되지 않지만 나중에 참조할 수 있도록 현재 iptables 규칙을 확인합니다. 리스트 확인은 -L 옵션 또는 -S옵션으로 확인할 수 있습니다. -L 옵션은 체인에 대한 규칙의 리스트화 하여 보여주는 반면 -S 옵션은 체인을 출력합니다.

    출력하면 input, forward, output의 세가지 체인 목록이 출력됩니다. 체인 이름은 각 목록의 규칙이 적용될 트래픽을 나타내며, 입력은 클라우드 서버로 들어오는 모든 연결입니다. 출력은 외부로 나가는 모든 트래픽이며 통과하는 모든 트래픽에 대한 연결입니다. 또한 트래픽이 특정 규칙과 일치하지 않는 경우 트래픽 처리 방법을 결정하는 정책 설정이 있으며 기본적 설정은 허용입니다.

    • PREROUTING: 패킷들은 라우팅 결정이 만들어지기 전에 이 체인에 포함됩니다..
    • INPUT: 패킷이 로컬상에서 전달될 경우 체인의 규칙을 따릅니다.
    • FORWARD: 라우팅되고 로컬 전달이 아닌 모든 패킷들은 전달됩니다.
    • OUTPUT: 서버에서 보내진 패킷들의 경우 체인의 규칙을 따릅니다.
    • POSTROUTING: 라우팅 결정이 만들어졌을 때, 패킷들은 하드웨어에 보내지기 전에 이 체인에 들어옵니다.
    sudo iptables -L
    sudo iptables -S
    iptables 설정
    [Step 1] 현재 설정 확인

    Read in English

    2) 모든 규칙 삭제

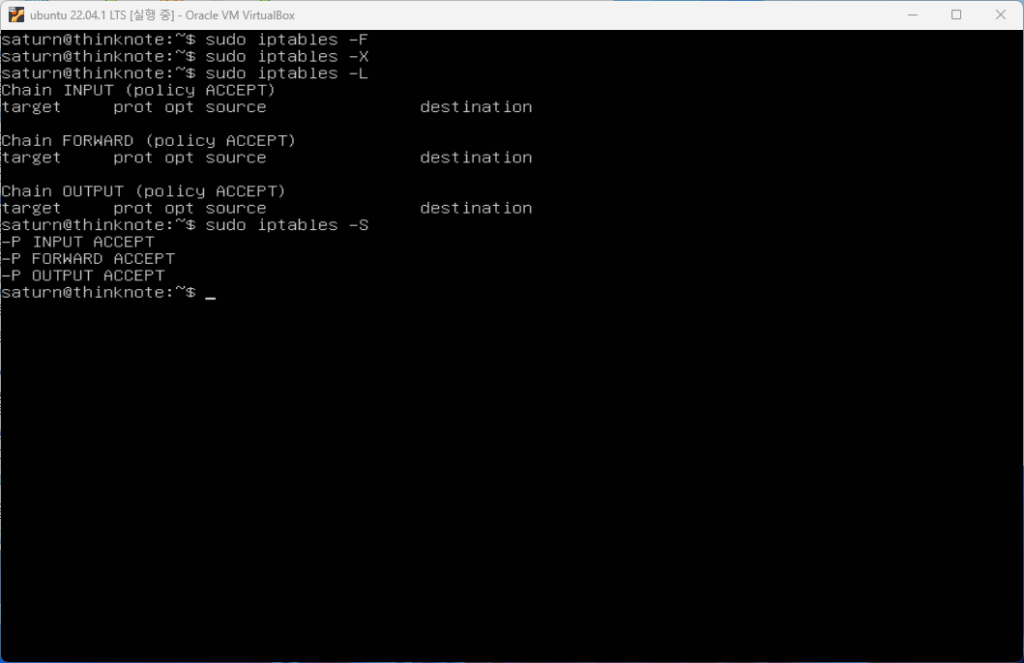
    현재 설정된 모든 규칙을 삭제합니다. -F 옵션은 모든 체인에 포함되어 있는 규칙을 삭제합니다. -X 옵션은 사용자 정의된 체인을 모두 삭제합니다.

    -F 옵션과 -X 옵션으로 모든 체인을 삭제합니다. 모든 규칙을 삭제하고 체인에 연결된 규칙이 있는지 -L 옵션과 -S 옵션으로 확인합니다. 초기 설치 후 명령어를 실행했다면 설정된 규칙이 없기 때문에 출력은 동일합니다.

    sudo iptables -F
    sudo iptables -X
    sudo iptables -L
    sudo iptables -S
    iptables 설정
    [Step 2] 모든 체인 삭제

    3) 로컬 체인 추가

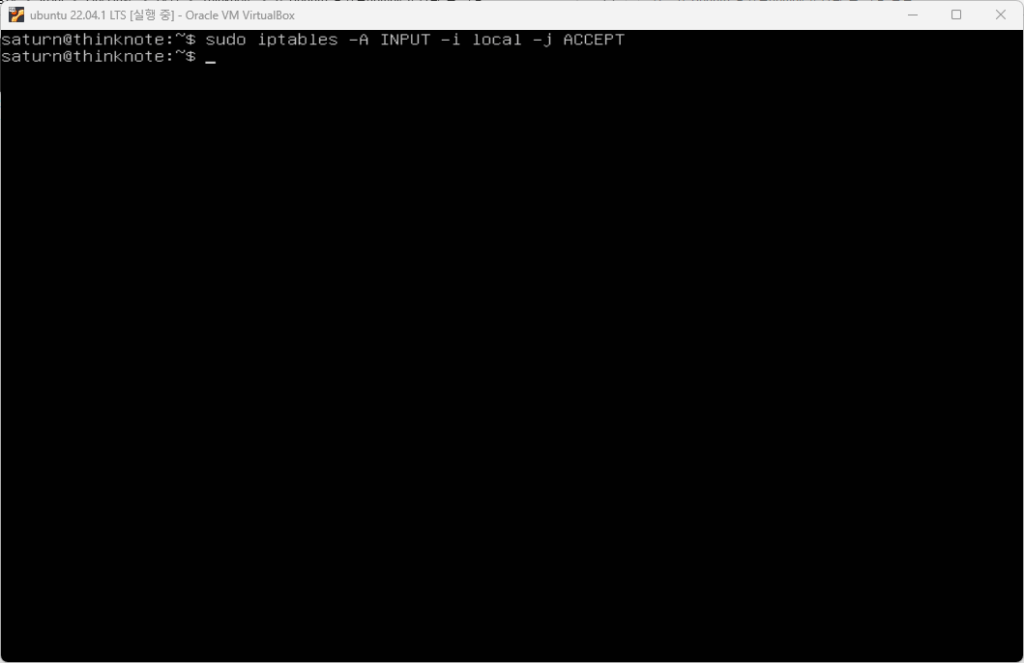
    로컬 네트워크에 접속이 가능하도록 체인을 추가합니다. 체인을 추가 할때는 -A 옵션을 사용합니다. -i 옵션은 네트워크 인터페이스 이름을 지정하는 옵션입니다.

    sudo iptables -A INPUT -i lo -j ACCEPT
    iptables 설정
    [Step 3] 로컬 연결 추가

    4) 인바운드 트래픽 규칙 추가

    iptables 사용을 시작하려면 먼저 필요한 서비스에 대해 허용된 인바운드 트래픽에 대한 규칙을 추가해야 합니다. iptables는 연결 상태를 추적할 수 있으므로 아래 명령을 사용하여 설정된 연결을 계속할 수 있습니다. related, established 패킷의 접속을 허용하는 규칙을 추가하며 이는 필요한 서비스에 대해 허용하도록 설정된 연결입니다.

    sudo iptables -A INPUT -m conntrack --ctstate RELATED,ESTABLISHED -j ACCEPT
    iptables 설정
    [Step 4] 서비스 연결 허용

    5) 규칙 저장 및 재시작

    체인을 추가했다고 바로 반영되는 것은 아닙니다. reload 명령어를 사용해서 저장된 체인이 반영되도록 해야 합니다. 하지만 reload 명령어만 사용하면 재시작 된 이후에는 추가된 체인이 사라지게 됩니다. 그래서 변경한 체인을 저장하고 재시작해야 합니다.

    저장은 service+netfilter-persistent+save 명령어로 실행합니다. netfilter-persistent 명령은 flush, force-reload, reload, restart, save, start ,stop의 실행 명령어로 구성되어 있습니다.

    변경된 체인을 저장하고 반영합니다.

    sudo service netfilter-persistent save
    sudo service netfilter-persistent reload
    iptables 설정
    [Step 5] 설정 저장 및 재시작

    3. Iptables 설정(사용법)

    • iptables – [ACD] 체인 규칙 사양 [옵션]
    • iptables -I 체인 [규칙 번호] 규칙 사양 [옵션]
    • iptables -R 체인 규칙 번호 규칙 사양 [옵션]
    • iptables -D 체인 규칙 번호 [옵션]
    • iptables -[LS] [체인 [규칙 번호]] [옵션]
    • iptables – [FZ] [체인] [옵션]
    • iptables -[NX] 체인
    • iptables -E 이전 체인 이름 새 체인 이름
    • iptables -P 체인 타겟 [옵션]
    • iptables -h 도움말 출력

    5. Iptables 설정(명령어)

    • –append -A chain      :  체인에 추가
    • –check -C chain          :  체인의 규칙 존재 여부 확인
    • –delete -D chain        :  일치하는 체인 규칙 삭제
    • –delete  -D chain rulenum : 체인의 룰 번호로 삭제  
    • –insert  -I chain [rulenum]  :  규칙 번호로 체인에 삽입 (기본값 1 = 첫 번째)
    • –replace -R chain rulenum : 체인에서 규칙 규칙 번호(1 = 첫 번째) 바꾸기
    • –list -L [chain [rulenum]] : 체인 또는 모든 체인의 규칙 나열
    • –list-rules -S [chain [rulenum]] :  체인 또는 모든 체인에서 규칙 인쇄
    • –flush -F [chain] : 체인의 모든 규칙 또는 모든 체인 삭제
    • –zero -Z [chain [rulenum]] : 체인 또는 모든 체인의 제로 카운터
    • –new -N chain : 새 사용자 정의 체인 만들기
    • –delete-chain -X [chain] : 사용자 정의 체인 삭제
    • –policy  -P chain target : 체인에서 대상으로 정책 변경
    • –rename-chain -E old-chain new-chain : 체인 이름 변경(참조 이동)

    6. Iptables 명령어(옵션)

    • –ipv4  -4  :  없음(ip6tables-restore에서 라인이 무시됨)
    • –ipv6  -6  :  오류(iptables-restore에서 라인이 무시됨)
    • –protocol  -p proto  : 프로토콜 번호 또는 이름으로, 예. `tcp’
    • –source  -s : address[/mask][…]   소스 사양
    • –destination  -d : address[/mask][…]   대상 지정
    • –in-interface  -i : 입력 name[+]  네트워크 인터페이스 name ([+] for wildcard)
    •  –jump  -j : 대상, 규칙의 대상(대상 확장 프로그램을 로드할 수 있음)
    • –goto  -g :   체인, 리턴 없이 체인으로 점프
    • –match  -m : 일치 확장 일치(확장 프로그램을 로드할 수 있음)
    • –numeric  -n : 주소 및 포트의 숫자 출력
    • –out-interface  -o : 출력 name[+]  네트워크 인터페이스 name ([+] for wildcard)
    • –table  -t : 테이블, 조작할 테이블 (default: `filter’)
    • –verbose  -v : 자세한 정보 표시 모드
    • –wait  -w [seconds] : 포기하기 전에 xtables 잠금을 획득하기 위한 최대 대기 시간
    • –wait-interval -W [usecs] :xtables 잠금을 획득하기 위한 대기 시간 기본값은 1초
    • –line-numbers : 나열할 때 줄 번호 인쇄
    • –exact  -x : 숫자 확장(정확한 값 표시)
    • –fragment  -f : 두 번째 또는 추가 조각만 일치
    • –modprobe=<command>  : 이 명령을 사용하여 모듈을 삽입
    • –set-counters PKTS BYTES :  삽입/추가 중에 카운터 설정
    • –version   -V : 패키지 버전 출력

    7. Iptables 포트 활용

    1) openssh 포트


    함께 읽으면 좋은 글